Lecture 03 学习讲义
正文
工具
按问题查找
Lecture 03阅读起点

沿问题阅读三条主线

可迁移表示与多模态感知

课堂讲述与解释、算例、研究证据放在同一条阅读线上。下列模拟追问用于备课与自学,不是课堂实录。

本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读

前置解释与共享线索(1)

本页独立阅读

专题选读与后续展开(1)

本页独立阅读
本页独立阅读
本页独立阅读

前置解释与共享线索(1)

专题选读与后续展开(1)

本页独立阅读

前置解释与共享线索(2)

本页独立阅读

前置解释与共享线索(1)

本页独立阅读

专题选读与后续展开(1)

本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读

专题选读与后续展开(1)

本页独立阅读

前置解释与共享线索(1)

本页独立阅读
本页独立阅读

前置解释与共享线索(2)

专题选读与后续展开(4)

本页独立阅读
本页独立阅读

前置解释与共享线索(1)

本页独立阅读

前置解释与共享线索(2)

专题选读与后续展开(3)

本页独立阅读

专题选读与后续展开(1)

本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读

前置解释与共享线索(1)

本页独立阅读

前置解释与共享线索(1)

本页独立阅读

前置解释与共享线索(1)

本页独立阅读
本页独立阅读

前置解释与共享线索(1)

本页独立阅读

专题选读与后续展开(1)

本页独立阅读
本页独立阅读

专题选读与后续展开(1)

本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读

前置解释与共享线索(1)

专题选读与后续展开(1)

本页独立阅读

前置解释与共享线索(1)

本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读
本页独立阅读

专题选读与后续展开(2)

I · 学习信号与表示

什么变化应该忽略,训练目标怎样让表示保留我们需要的信息?

训练留下什么,训练答案又从哪里来?

训练留下什么,训练答案又从哪里来?

学习信号与表示训练留下什么,训练答案又从哪里来?

训练保存参数,输入才产生表示

解释、算例与证据

P01 · 训练结束后,网络留下了什么?

先把第二讲的训练闭环收成可复用对象:参数、当前表示、类别头。由此引出本讲为何讨论训练信号和新任务。

P01 学习表示机制图,状态 2P01 学习表示机制图,状态 2同一场景是什么?杯子 · 书在哪里?哪一只?书左边的红杯杯身与杯柄的边界学习信号区域与像素语言与任务

红蓝两杯与书的同一底图,类别标签逐步增加两个杯框和语言指代。

  • 同一场景
  • 是什么?
  • 杯子 · 书
  • 在哪里?哪一只?
  • 书左边的红杯
  • 杯身与杯柄的边界
  • 学习信号
  • 区域与像素
  • 语言与任务
红蓝两杯与书的同一底图,类别标签逐步增加两个杯框和语言指代。 查看对应图解状态
查看完整图解

课堂讲述

上一讲,我们把网络拆开,看它怎样组织计算、怎样根据误差改变参数。今天把训练过程先停下来,留下已经训练好的网络。我要问的是:它到底给我们留下了什么?是一张类别对照表,还是一种可以继续使用的看图方式? 看这张桌面照片。说出“有杯子”只是一个问题;找到杯子的位置,把杯子的像素分出来,再根据“书左边的杯子”找到目标,是另外几个问题。我们不希望每换一个问题,就把过去学到的东西全部作废。 今天沿三步往前走:先看这些表示还能怎样学,再看它怎样支持区域和像素,最后看语言怎样加入。每一步都追问同一件事:什么留下来,什么必须重新学习。

训练留下参数;一次输入才产生表示

独立阅读

训练时,我们不断用图像、目标和损失修改参数 θ\theta。训练结束后保存的是参数文件;把新图 xx 送入它,才得到表示 h=fθ(x)h=f_\theta(x)。这两样东西不能混叫“特征”:前者是可复用的计算规则,后者是某个输入在这套规则下的输出。

分类头把 hh 变成类别分数 a=Wh+ba=Wh+b。换成“哪一只杯子在左边”时,原分类头的类别名单往往无用,但前面识别轮廓、纹理和部件的计算可能仍有用。这就是移除原头、保留编码器的起点。它提出了一个可检验的假设:旧任务塑造的中间计算,能降低新任务学习的困难。

看当前图时,先指向“图像→表示”,再指向“表示→类别”。本讲第一部分改变前一段怎样学习,第二部分改变后一段要交付什么;不要求把所有问题塞进同一个输出向量。

沿这个问题继续

读“训练留下参数”后,尝试给自己的科研输入、编码器与输出各写一个实例;暂不运行实验。

图示条件与公式约定

复用现有两杯一书原创场景;没有在画面中添加不存在的零件。框及文字为教学标注,不是模型输出。

这条线索的展开与后续阅读

学习信号与表示训练留下什么,训练答案又从哪里来?

换掉分类头,为新问题留下什么

解释、算例与证据

P02 · 类别答案,不等于中间表示

本页拆开最终类别判断和中间表示,避免把“预测对了一个类别”当成已经回答了所有问题。

P02 学习表示机制图,状态 1P02 学习表示机制图,状态 1视觉网络 f中间表示 h原类别头杯子 / 书 / …新任务头新标签 + 训练 + 评价也可继续调整原网络保留视觉计算与参数,是迁移的起点;新任务的答案仍需学习。

图片经过视觉网络得到空间特征,中间表示分别连接原类别头和新任务头;虚线示意继续调整网络。

  • 视觉网络 f
  • 中间表示 h
  • 原类别头
  • 杯子 / 书 / …
  • 新任务头
  • 新标签 + 训练 + 评价
  • 也可继续调整原网络
  • 保留视觉计算与参数,是迁移的起点;新任务的答案仍需学习。
图片经过视觉网络得到空间特征,中间表示分别连接原类别头和新任务头;虚线示意继续调整网络。 查看对应图解状态
查看完整图解

课堂讲述

回到我们已经认识的分类器。图片经过网络,先得到中间特征,再由最后的分类部分给出分数。训练时,它们一起为类别预测服务,但训练后,这两个部分的用途可以不同。 最后一层很贴近原来的类别集合。中间特征却可能同时包含边缘、纹理、部件以及它们的组合。我们可以保留这些计算和参数,为新任务训练新的读出部分,也可以继续调整原网络。这就是迁移的起点。 这里先把一个容易混淆的概念说清:有监督训练也能得到可迁移表示。今天接着讲自监督,不是因为监督表示不能迁移,而是要问:得到这些表示,是否必须始终依赖逐张图片的人工类别答案?

丢掉分类头,究竟还剩下什么?

独立阅读

一个十分类头可以把 32 维表示压成十个分数。最高分只保留最终决策,完整分数还保留类别间相对偏好;但两者都经过了为原任务学习的投影。若新任务需要原十类名单之外的区分,直接使用这些分数未必合适。

以数字为例,源任务是 0–9 十分类,新任务是“数字是否大于等于5”。最简单的做法可以先识别数字再合并类别,也可以在中间表示上另学二分类头。这两种使用方式的误差来源不同:前者受原十分类错误约束,后者可以重新组合中间特征。LAB01 采用后者,并明确丢弃原十分类头。

“中间表示更通用”是值得检验的经验判断,不是说它保存了原图的一切。后面的颜色例子会展示,训练目标也可能让中间表示放弃未来有用的差异。

沿这个问题继续

接读LAB 01固定32维特征的定义,再到P23看同一特征如何接两种读出。

这条线索的展开与后续阅读

学习信号与表示训练留下什么,训练答案又从哪里来?

标签粒度改变,成本与答案一起改变

解释、算例与证据

P03 · 图片已经很多,答案从哪里来?

在增加数据之前先确认答案粒度。这个问题会在P25以类别、框、像素和实例四种输出再出现。

P03 学习表示机制图,状态 1P03 学习表示机制图,状态 1原始图片适合当前任务的答案类别:杯子、书框:类别 + 位置轮廓:像素归属类别定义标注判断歧义处理质量检查数据量增加,不会自动给出可靠的类别、框和轮廓。

桌面遮挡底图及其对应框、实例轮廓教学标注,显示类别、框和像素归属三种答案。

  • 原始图片
  • 适合当前任务的答案
  • 类别:杯子、书
  • 框:类别 + 位置
  • 轮廓:像素归属
  • 类别定义
  • 标注判断
  • 歧义处理
  • 质量检查
  • 数据量增加,不会自动给出可靠的类别、框和轮廓。
桌面遮挡底图及其对应框、实例轮廓教学标注,显示类别、框和像素归属三种答案。 查看对应图解状态
查看完整图解

课堂讲述

现在把数据量扩大。收集一批图片,和得到一批适合训练的数据,不是一回事。类别需要定义,有歧义的图片需要处理;换成框和细轮廓,人的工作又变了。 所以“我们还有更多图片”并没有自动解决监督来源的问题。对于你们的科研,这个矛盾可能很具体:仪器已经保存了很多观测,但能可靠判定类别、病灶或结构的人并不多。 如果每增加一次训练机会,都必须先请专家给出一个新答案,训练规模就受这条链约束。接下来会出现两种不同的努力:一种是把人的判断组织得更好,另一种是重新设计问题,让已有数据自己提供一部分训练答案。

标签预算取决于要回答什么

独立阅读

同一张桌面照片可以有“室内”的整图类别、两个杯子的矩形框、杯体的像素掩码,或“左侧红杯”的语言描述。这些答案并不是一份标签自动细化而来。类别没有给位置,框内还可能有桌面,掩码也没有自动说明哪个杯子是关系句的目标。

因此“有一百万张图”只描述了输入规模;要估计监督供给,还要问标什么、粒度多细、类别如何定义、模糊样本怎样仲裁。粗标签合并不会凭空产生细标签。一个写成“杯子”的样本,不能同时证明其颜色、材质、遮挡边界都标对了。

可以做一个小预算表:假设整图判断每张10秒、框标注30秒、像素检查120秒,则1000张分别需要约2.8、8.3、33.3工时。这是说明粒度成本的假设算例,不是行业测速;真实成本还取决于工具、复核和返工。下一页介绍组织人的判断,随后转向从数据本身构造部分训练答案。

沿这个问题继续

先用自己的数据估计一种标签的取得与复核成本,再读P4;假设工时只用来比较,不作行业结论。

图示条件与公式约定

本页使用现有桌面遮挡场景及其对应的框/实例教学标注,三者来自相同底图。未把未遮挡版本的标注叠到遮挡版本。框与轮廓不是模型实测。

这条线索的展开与后续阅读

学习信号与表示训练留下什么,训练答案又从哪里来?

组织人工判断,也能重设计训练题目

解释、算例与证据

P04 · 同一个瓶颈,两种研究与产业选择

人工判断的组织和数据自带目标是对监督供给的两种回应。本页提供研究与产业选择的共同背景。

P04 学习表示机制图,状态 1P04 学习表示机制图,状态 12016 · YC 同期访谈Scale:把人工任务组织成可调用服务Lucy Guo · Alexandr Wang任务请求人员组织 / 质量控制数据抽取 · 电话 · 分类监督供给的两种选择改善人的判断供给从已有数据构造部分目标可以结合

2016年Scale的请求、人员组织与质量控制、人工任务结果流程,下方并列人工供给和数据自构目标。

  • 2016 · YC 同期访谈
  • Scale:把人工任务组织成可调用服务
  • Lucy Guo · Alexandr Wang
  • 任务请求
  • 人员组织 / 质量控制
  • 数据抽取 · 电话 · 分类
  • 监督供给的两种选择
  • 改善人的判断供给
  • 从已有数据构造部分目标
  • 可以结合
2016年Scale的请求、人员组织与质量控制、人工任务结果流程,下方并列人工供给和数据自构目标。 查看对应图解状态
查看完整图解

课堂讲述

Scale 的早期故事可以放在这个问题里理解。2016 年对 Alexandr Wang 和 Lucy Guo 的同期访谈,谈的是把人工任务组织成可以调用的服务。这里面不是只有“找人做标注”,还有任务怎样拆、质量怎样管、需求怎样被接住。 另一条路线则在问:能不能改变学习目标,少依赖专门为这次任务逐条制作的答案?这两条路线并不互相取消。自监督预训练以后,我们仍可能需要人工标注来适配任务、检查错误,或者形成更高质量的数据。 这个故事值得记住的不是公司后来值多少钱,而是一个研究问题的现实来源:当某种学习方式遇到瓶颈,我们既可以改善生产过程,也可以改变学习问题本身。

监督供给的两种回应

独立阅读

一条回应是改善人工判断的组织:把任务拆分,提供一致界面,路由给合适人员,再做质量检查。2016年的 Scale 同期访谈介绍了通过接口组织人工任务的服务思路;这里用这个公开事实说明监督不仅是算法输入,也是一项生产过程。

另一条回应是改变训练题目。例如原文已有下一个词,图像已有被遮住的像素,同一原图可以产生两种视图。这些目标无需逐项写新的类别答案,但任务设计、数据选择和数据产生本身仍有人类投入。

两条路线可以并存:自监督先学可复用表示,再用少量精确标注适配检测或分割;人工数据也可以帮助评价自监督表示。这里不需要推断企业创始人的个人动机,更不使用估值来论证方法价值。真正的问题是:哪些答案仍需人来定义,哪些训练约束可以由数据结构提供?

沿这个问题继续

读2016年同期访谈的服务机制即可;随后读P5的具体文本例子,无须扩展企业估值。

这条线索的展开与后续阅读

学习信号与表示训练留下什么,训练答案又从哪里来?

把同一句话变成两种有答案的题

解释、算例与证据

P05 · 文字演示了一种答案来源

借同一句话构造next-token与masked-token题,核心是答案来源和可见条件,不是语言架构课。

P05 学习表示机制图,状态 1P05 学习表示机制图,状态 1原文:红色杯子放在桌上预测后续:只用前文红色文字预测器目标:杯子预测缺失:使用允许看到的两侧内容红色 [遮挡] 放在桌上目标:杯子此处把“杯子”当一个教学用文字单位;不是指定某个 tokenizer 的切分。

同一句红色杯子放在桌上,前文预测杯子与中间遮挡预测杯子两种可见性规则。

  • 原文:红色杯子放在桌上
  • 预测后续:只用前文
  • 红色
  • 文字预测器
  • 目标:杯子
  • 预测缺失:使用允许看到的两侧内容
  • 红色 [遮挡] 放在桌上
  • 目标:杯子
  • 此处把“杯子”当一个教学用文字单位;不是指定某个 tokenizer 的切分。
同一句红色杯子放在桌上,前文预测杯子与中间遮挡预测杯子两种可见性规则。 查看对应图解状态
查看完整图解

课堂讲述

看这句话。把后面的内容暂时挡住,就能用前面的文字预测接下来出现的文字单位;把中间一部分遮掉,又能用其余内容预测缺失部分。训练用的答案就在原文中,不需要标注者为每个位置再写一次。 两种构造并不相同:预测后续时,只能利用允许看到的前文;预测被遮住的部分时,可以利用另一种可见上下文。这里先不研究内部怎样组织长序列,我们只看输入、目标和反馈从哪里来。 这对视觉研究的启发是:不额外给类别标签,仍然可以有明确的预测任务和误差。文本本来也是人写出来的,“没有额外逐条标注”不是“没有人的知识”。那么,对图像,我们能构造什么样的预测或对应关系?

同一句原文怎样生成两种预测题

独立阅读

用教学单位切分 The / red / cup / is / on / the / table / .。从左到右预测的一题是:输入 The red cup,正确目标是 is。遮词预测的一题是:输入 The red [MASK] is on the table .,目标是被取走的 cup。答案都从原文取得,但模型可见条件不同:前者不能偷看未来,后者可以使用遮词两侧。

训练时原文目标已知。若模型给正确词概率0.25,这一位置的负对数损失是 −ln⁡0.25≈1.386-\ln0.25\approx1.386;提高到0.5后是0.693。这个反馈足以更新参数,不需要先把整句话人工标成“描述桌面”。

本页只借文字说明目标来源。实际 tokenizer 可能把单词分成多个单位,预测器也有不同架构;这些细节不影响这里的闭环:隐藏一部分信息→用可见条件预测→拿原文作答案。架构、完整注意力和循环状态留后续课程。

沿这个问题继续

手算正确词概率0.25与0.5的损失,回到P6区分目标来源、输出任务和损失。

图示条件与公式约定

“红色 / 杯子 / 放在 / 桌上”只作词语级教学切分,未声称对应任何 tokenizer。内部序列机制不在本页展开。

这条线索的展开与后续阅读

学习信号与表示训练留下什么,训练答案又从哪里来?

分开答案来源、预测任务和惩罚方式

解释、算例与证据

P06 · 没有类别标签,不等于没有学习目标

把“自监督、分类、交叉熵”放回不同维度,后面才不会用方法名替代完整学习链。

P06 学习表示机制图,状态 1P06 学习表示机制图,状态 1有监督分类人工类别答案预测类别视图对应指定视图配对选择对应隐藏内容预测原图隐藏像素预测像素自监督说信号从哪里来;对比与重建说任务怎样构造。

分类图片、同图两裁剪、遮挡网格三种输入分别连接人工类别、指定配对和原图像素目标。

  • 有监督分类
  • 人工类别答案
  • 预测类别
  • 视图对应
  • 指定视图配对
  • 选择对应
  • 隐藏内容预测
  • 原图隐藏像素
  • 预测像素
  • 自监督说信号从哪里来;对比与重建说任务怎样构造。
分类图片、同图两裁剪、遮挡网格三种输入分别连接人工类别、指定配对和原图像素目标。 查看对应图解状态
查看完整图解

课堂讲述

把刚才的问题整理一下。有监督分类使用人工类别答案;自监督则从数据中构造目标,例如判断两个视图是否对应,或者预测被隐藏的内容。它们仍然可以使用分类式或回归式的损失,仍然通过误差来调整参数。 因此,自监督说的是监督信号怎样获得;对比学习说的是怎样比较样本;重建说的是预测什么。这几个词不在同一个分类维度上,不能排成互相替代的三个版本。 今天先沿两条路线走深:利用视图对应关系学习,以及利用缺失内容预测学习。我们要看到的不只是它们不用类别标签,还要看到研究者怎样通过任务设计,要求表示保留某些区别、忽略另一些变化。

监督来源、预测任务与损失要分开

独立阅读

“自监督”说明目标怎样取得;“分类”说明输出怎样组织;“交叉熵”说明怎样惩罚预测。这是三个维度,不是互斥方法名。人工类别标签可以训练softmax分类,从同图视图身份构造的标签也可以训练softmax分类;两者都能用交叉熵。

对比学习的一题是“候选中哪一个和查询同源”;遮挡重建的一题是“这个隐藏位置原来是什么像素”。它们都从数据构造目标,却要求保留不同结构。目标不是“没有答案”,只是答案不是额外写下的类别名称。

判断一个实验时,依次写出输入、目标的取得过程、模型输出、损失和最终评价。若只写“用了自监督”,还不知道它学到了什么;若写出完整链条,就能发现有没有把隐藏真值意外送入输入,或把训练损失当成另一项任务的成绩。

沿这个问题继续

选LAB 06或LAB 08之一,标出输入、目标来源、输出、损失、读出;不需要两本同时完成。

按问题回查的讲解与短练习(1)

这条线索的展开与后续阅读

学习信号与表示训练留下什么,训练答案又从哪里来?

训练目标还要落到一次可执行的更新

解释、算例与证据

P07 · 目标可以扩展,训练还要做得出来

资源约束在本讲是方法选择的一个条件;真正需要回访它的是批内候选、MoCo缓存与MAE可见块。

P07 学习表示机制图,状态 1P07 学习表示机制图,状态 1学习目标训练什么数据供给拿到什么计算条件算得起什么一起决定可行的实验当前批次:更多图片历史字典:复用特征可见图块:减少编码

目标、数据、计算三个相连节点,以及当前批次、历史特征、可见图块三个具体计算取舍。

  • 学习目标
  • 训练什么
  • 数据供给
  • 拿到什么
  • 计算条件
  • 算得起什么
  • 一起决定可行的实验
  • 当前批次:更多图片
  • 历史字典:复用特征
  • 可见图块:减少编码
目标、数据、计算三个相连节点,以及当前批次、历史特征、可见图块三个具体计算取舍。 查看对应图解状态
查看完整图解

课堂讲述

找到可扩展的目标以后,训练也不会变成免费的。更多数据、更大的网络、更长的训练,仍然需要存储、计算和时间;设备之间合作,也有额外代价。 但这不是一页“模型很烧钱”的背景介绍。资源条件会影响方法怎么设计:候选特征能不能从历史批次复用?被遮住的图块是不是也要送进昂贵的编码器?这些选择会改变一次实验能够使用多少材料。 我们先记住这几个具体问题,后面看 MoCo 和 MAE 时就能回到它们。至于扩展定律、多设备分片和通信细节,属于后续系统展开的内容。今天只需要理解:好的学习目标,还需要一种可实现的计算组织。

训练目标也在分配计算

独立阅读

扩大目标供给后,还要把训练真正做出来。当前批内对比会同时保留多张图两种视图的前向和反向状态;保存历史key的MoCo用特征缓存减少重复编码,但必须处理旧特征的一致性;MAE让较重编码器只处理可见图块,把补全位置的工作放到较轻解码器。

所以计算条件会参与方法设计,而不只是最后购买多少设备。我们可以先画资源账:本步编码多少新图,保留多少激活,缓存多少旧向量,下步需要重复什么。这个账足以理解接下来的batch、队列与可见块取舍。

本讲不在此展开并行算法、显存公式或分片通信。它们保留为第六讲预备阅读;这里带走的是同一个原则:需要更多比较对象,不一定等于同时反传更多图片;需要预测更多位置,也不一定等于让昂贵编码器看见所有位置。

沿这个问题继续

先读本页计算接口,直接进入P8;多设备与分片算例是L06预备选读。

按问题回查的讲解与短练习(1)

这条线索的展开与后续阅读

视图关系怎样成为学习目标,又会牺牲什么?

视图关系怎样成为学习目标,又会牺牲什么?

学习信号与表示视图关系怎样成为学习目标,又会牺牲什么?

同源视图的答案来自取样过程

解释、算例与证据

P08 · 同一张图,可以给出两个相关视图

从同一底图产生两种观察,明确正例身份由数据管线提供,再讨论这种任务可能留下什么共有结构。

P08 学习表示机制图,状态 1P08 学习表示机制图,状态 1同一底图 x视图 a固定裁剪 1杯身 + 桌面视图 b固定裁剪 2仍包含同一杯子两个视图共享原图,不额外需要类别名裁剪坐标由代码固定;不是两张独立生成的图片。

一张红杯底图按固定坐标裁出两个仍包含杯子的视图,来源箭头保留。

  • 同一底图 x
  • 视图 a
  • 固定裁剪 1
  • 杯身 + 桌面
  • 视图 b
  • 固定裁剪 2
  • 仍包含同一杯子
  • 两个视图共享原图,不额外需要类别名
  • 裁剪坐标由代码固定;不是两张独立生成的图片。
一张红杯底图按固定坐标裁出两个仍包含杯子的视图,来源箭头保留。 查看对应图解状态
查看完整图解

课堂讲述

看这两个局部视图。像素不完全一样,但我们知道它们从同一张原图产生。这件事不需要额外的类别标签,只需要保存我们做过的变换。 可以据此要求网络:这两个视图的表示应当相互接近,而不是只因为亮度或裁剪不同就完全分开。这里我们还没有告诉模型“这是什么杯子”,只提供了一个关系。 不过,关系并非天然正确到可以随意使用。如果一个裁剪只剩桌面,另一个只剩杯子,或者原图里有多个不同物体,这对视图到底共享多少内容,就要重新检查。增强不是数据清洗之后的附属选项,它开始参与定义模型要学习的东西。

同源视图为什么能当作正例?

独立阅读

先固定一张原图,再独立采样两次变换,得到 v=t(x)v=t(x) 与 v+=t′(x)v^+=t'(x)。知道它们来自同一个 xx,是数据管线提供的身份信息;它不是模型事先认出了杯子。训练目标要求两张观察在表示空间仍能互相找到。

若两张裁剪分别改变背景和亮度,但都保留杯身,完成配对就可能需要抓住跨视图共有的轮廓和部件,而不能只记某个像素位置。这是视图训练有机会产生可迁移特征的理由。

但正例规则也施加了假设:如果一张只剩杯子、另一张只剩无关书本,我们仍知道它们同源,却未必给出了理想的语义一致性任务。增强不是越强越好;要问它留下了哪些共有证据,又要求模型忽略哪些差异。

沿这个问题继续

指认两张视图共同保留的物体部分;去LAB 06看实际输入图,先读图再读代码。

图示条件与公式约定

使用现有 concept-red-cup-a.png 同一文件;两个 SVG viewBox 分别为 [145,120,980,980] 与 [280,180,850,850]。裁剪为确定性显示变换,未独立生成两幅正例。本页将稿件中的“零件”替换为“杯子”,不改变论证。

这条线索的展开与后续阅读

学习信号与表示视图关系怎样成为学习目标,又会牺牲什么?

同源关系与同类关系可以不同

解释、算例与证据

P09 · “正例”说的是关系,不是类别

把同源关系与语义同类拆开。负例的定义要相对于训练题,不能直接等同于类别不同。

P09 学习表示机制图,状态 1P09 学习表示机制图,状态 1查询 q指定正例 k⁺其他图像 k₁其他图像 k₂也是杯子,却不同实例正例是构造出的对应关系;候选中的其他图像不保证语义类别不同。

红杯查询及同底图裁剪正例;另一红杯实例与法兰构成其他候选,标明同类也可能是负项。

  • 查询 q
  • 指定正例 k⁺
  • 其他图像 k₁
  • 其他图像 k₂
  • 也是杯子,却不同实例
  • 正例是构造出的对应关系;候选中的其他图像不保证语义类别不同。
红杯查询及同底图裁剪正例;另一红杯实例与法兰构成其他候选,标明同类也可能是负项。 查看对应图解状态
查看完整图解

课堂讲述

在这类实例级对比任务中,“正例”通常表示训练指定的对应视图,“负例”表示拿来比较的其他样本。它们并不自动等同于“同类别”和“不同类别”。 如果另外一张图片拍的恰好是同类杯子,训练时仍可能把它当作另一个实例。这说明目标对数据作了近似,而不是提前拥有全部语义关系。 为什么这样的近似仍值得尝试?因为大量不同视图的对应能够迫使网络寻找一些跨变换稳定的线索,而不是只记某一张图片的像素。真正的问题不是一句“负例有噪声,所以方法不行”,而是:这种构造最后能否得到对新图片、新任务有用的表示。

同源、同类与负例不是同一回事

独立阅读

设A1、A2是同一红杯照片的两种裁剪,B1来自另一只红杯。实例对比通常把A1–A2配为正例,把B1作为A1的其他候选。即便A和B都属于“杯子”,取样过程也没有给它们同源身份。

这解释了“假负例”:在训练的实例身份题中,B确实不是A;在下游语义分类题中,B却可能应该与A接近。两种题目的答案并不矛盾,但会对表示施加不同压力。

本页不要求学生寻找一条永远正确的相似度。先写清关系:同一原图、同一对象、同一类别、同一语句含义是不同层次。以后CLIP用图文配对时,也要重新问正例来自哪一种数据关系,不能沿用“看起来相似就是正例”的模糊定义。

沿这个问题继续

画A1、A2、B1三个候选,分别标同源与同类,再去P10计算一次选择。

图示条件与公式约定

另一杯子用独立的 concept-red-cup-b.png,只用来示意另一个实例;不把其差异宣称为单变量控制。所有候选身份为教学构造。

学习信号与表示视图关系怎样成为学习目标,又会牺牲什么?

从三个候选算出一次选择损失

解释、算例与证据

P10 · 一次对比,就是一次有答案的选择

这一页把相似关系变成可优化的概率与损失。分数、温度、softmax和负对数必须能对上同一组数。

P10 学习表示机制图,状态 2P10 学习表示机制图,状态 2三候选教学算例 · 指定第 1 项为正例相似度 s除以温度 τ = 0.5归一化概率 pk⁺120.665k₁0.510.245k₂000.090pⱼ = exp(sⱼ / τ) / Σₗ exp(sₗ / τ)L = −ln p⁺ = 0.408

三候选相似度1、0.5、0经过温度0.5缩放成2、1、0,概率0.665、0.245、0.090,指定正项损失0.408。

  • 三候选教学算例 · 指定第 1 项为正例
  • 相似度 s
  • 除以温度 τ = 0.5
  • 归一化概率 p
  • k⁺
  • 1
  • 2
  • 0.665
  • k₁
  • 0.5
  • 1
  • 0.245
  • k₂
  • 0
  • 0
  • 0.090
  • pⱼ = exp(sⱼ / τ) / Σₗ exp(sₗ / τ)
  • L = −ln p⁺ = 0.408
三候选相似度1、0.5、0经过温度0.5缩放成2、1、0,概率0.665、0.245、0.090,指定正项损失0.408。 查看对应图解状态
查看完整图解

课堂讲述

现在用三个候选算一次。我们设它们与查询的相似度分别是 1、0.5、0,第一项是正例。经过温度缩放和归一化,模型给正例的概率约为 0.665。训练希望这个指定对应获得更高的相对分数。 这里的“答案”不是狗或猫,而是:这一组候选里,哪一项与查询对应。负对数损失把这个选择变成可以优化的数值。温度会改变分数差距转换成概率后的尖锐程度,并进一步影响梯度。 不需要把公式背下来,但要能够指着图回答:谁是查询,谁是正例,谁进入比较,误差从哪里来。这四件事清楚以后,对比学习就不再只是散点图上“拉近一点、推远一点”的动画。

把对比损失算成一道选择题

独立阅读

设查询的三个候选logit为2、1、0,第一项是已知正例。这些是温度缩放后的分数,不是三个原始余弦值。softmax分母为 e2+e1+e0≈11.107e^2+e^1+e^0\approx11.107,概率约为 (0.6652,0.2447,0.0900)(0.6652,0.2447,0.0900),正例损失 −ln⁡0.6652≈0.4076-\ln0.6652\approx0.4076。

一般式为 L=−log⁡{exp⁡(s+/τ)/∑jexp⁡(sj/τ)}L=-\log\{\exp(s_+/\tau)/\sum_j\exp(s_j/\tau)\},分母包含正例。提高正例相对分数会降低损失;把所有分数同时加一个常数不会改变概率,所以目标关注相对选择而非绝对分数大。

实际训练中分数由图像经编码器算出,损失反传到参数。手算这一行只解释目标,不是模型实验。接到LAB 07时,应沿真实图像→两视图→向量→logit→loss→参数变化逐项找到对应对象。

图示条件与公式约定

教学设定 s=[1,.5,0],τ=.5,logits=[2,1,0];p=[.6652409558,.2447284711,.0900305732];−ln p+=.4076059644。分母含三个候选,不含查询自身;非模型输出。降低温度提高当前最高分的尖锐程度,并非对所有样本一概增大梯度。

这条线索的展开与后续阅读

学习信号与表示视图关系怎样成为学习目标,又会牺牲什么?

温度改变概率和梯度,不改变原始排序

固定另一组相似度(.8,.4,.2),把温度当唯一变化量。

温度改变什么,不改变什么?

独立阅读

固定相似度为 (0.8,0.4,0.2)(0.8,0.4,0.2),第一项是正例。温度1、0.5、0.1时,正例概率分别约0.4506、0.5713、0.9796。排序完全不变,但概率越来越集中。若正例分数低于最强负例,低温度也会更尖锐地放大错误选择。

梯度能解释其作用:∂L/∂s+=(p+−1)/τ\partial L/\partial s_+=(p_+-1)/\tau,负例为 pj/τp_j/\tau。温度既改变分母中的尺度,也改变概率。因此“温度越低,梯度越大”并不总成立:正例已经几乎确定时,1−p+1-p_+也会接近零。

把温度调低造成的loss下降,不能当作表示已经改善。温度是训练条件,最终仍用固定读出协议评价。课堂上可以让学生先预测哪一项概率增加,再计算;避免同时改相似度、候选数和温度,使原因无法辨认。

沿这个问题继续

先算画面2、1、0,再读温度块;LAB 07开头只做数值热身即可,真实训练另读后段。

学习信号与表示视图关系怎样成为学习目标,又会牺牲什么?

代入常量表示,检查目标的平凡解

解释、算例与证据

P11 · 为什么不能把所有图片都映射成同一个向量?

先代入常量函数检查目标的平凡解,说明仅有一致性不够,也为教师方法留下合理选读入口。

P11 学习表示机制图,状态 1P11 学习表示机制图,状态 1全部映成同一向量能区分指定对应k⁺1/30.665k₁1/30.245k₂1/30.090q 与 k⁺其他候选L = ln 3 ≈ 1.099L ≈ 0.408分数全部相同,选择任务无法完成;此图比较目标值,不是训练曲线。

坍塌表示的三候选均分1/3与可区分候选并排,损失ln3约1.099对比0.408。

  • 全部映成同一向量
  • 能区分指定对应
  • k⁺
  • 1/3
  • 0.665
  • k₁
  • 1/3
  • 0.245
  • k₂
  • 1/3
  • 0.090
  • q 与 k⁺
  • 其他候选
  • L = ln 3 ≈ 1.099
  • L ≈ 0.408
  • 分数全部相同,选择任务无法完成;此图比较目标值,不是训练曲线。
坍塌表示的三候选均分1/3与可区分候选并排,损失ln3约1.099对比0.408。 查看对应图解状态
查看完整图解

课堂讲述

一个看似省事的办法是:所有输入都输出同一个向量。这样同图的两个视图当然相同,但任何其他图也相同,模型已经没有办法选择对应项。 在这个三候选算例中,所有分数相同,正确项只有三分之一的概率,损失约为 1.099;能区分对应关系时,损失可以更低。这个比较解释了为什么单纯要求“两视图一样”不够,而带有区分任务的目标还提出了另一项要求。 不要由此推成“只要有负例,训练就一定成功”。我们现在只是看见平凡表示为什么不能很好完成这个选择任务。没有负例的方法怎样避免坍塌,是另一组设计问题,已经保留在补充材料,今天不再展开一套教师网络。

常量表示为什么不解决对比任务?

独立阅读

若只最小化两视图间距离,f(x)=cf(x)=c 对任何图都输出同一向量,配对距离就是零。它满足一致性,却让杯子与书无法区分。加入候选竞争后,如果所有单位向量相同,各候选得分也相同,K个候选的正例概率只能是1/K,损失是 ln⁡K\ln K;例如三项时约1.099。

这说明对比目标没有把“全部一样”当成一个好的区分结果。但仅凭这个算例,不应宣布任何网络或优化过程都不可能停在退化状态。真正检查还包括样本间方差、表示秩以及下游读出。

没有显式负例的方法也能成功:它们组合教师目标、预测器、停止梯度和分布处理等设计。下面的教师补充块解释这些组件各自负责什么,不把一条EMA箭头当成防坍塌的充分证明。

图示条件与公式约定

三候选同分:p+=1/3,L=ln3=1.0986122887。图上的向量与条形为机制示意,没有训练曲线或成功保证。

这条线索的展开与后续阅读

学习信号与表示视图关系怎样成为学习目标,又会牺牲什么?

在 z 上比较,梯度仍然改变 h

解释、算例与证据

P12 · 训练时比较 z,使用时读取 h

解释训练空间与使用空间可以不同,同时明确投影头不截断梯度,也不保证保存一切。

P12 学习表示机制图,状态 2P12 学习表示机制图,状态 2使用:冻结编码器,训练受限读出编码器 f · 冻结h投影头 gz线性读出 · 可训练新标签监督读出h 是下游可以检查的表示;“投影头之前”本身不是信息保留保证。

图像、编码器f、h、投影g、z及对比损失路径;第二状态从冻结h接出可训练线性读出。

  • 使用:冻结编码器,训练受限读出
  • 编码器 f · 冻结
  • h
  • 投影头 g
  • z
  • 线性读出 · 可训练
  • 新标签监督读出
  • h 是下游可以检查的表示;“投影头之前”本身不是信息保留保证。
图像、编码器f、h、投影g、z及对比损失路径;第二状态从冻结h接出可训练线性读出。 查看对应图解状态
查看完整图解

课堂讲述

SimCLR 在视觉编码器后面增加一个投影头。编码器得到 h,投影头把它变成 z,对比损失作用在 z 上;用于下游任务时,可以取投影头之前的 h。 这就给两个位置不同的分工可能:z 更直接服务于当前的视图比较,h 可能保留一些下游还用得上的变化。原工作通过实验比较了投影头的设计,这不是只为了多加几层。 但请注意,“提供这种可能”和“保证这种分工”不是一回事。损失仍然会通过投影头影响前面的编码器。我们不能看到这张结构图,就宣布某种颜色、边界或者其他细节一定安全地保存在 h 里。接下来用你们的问卷例子检查这个推论。

在 z 上比较,为什么 h 仍会学习?

独立阅读

训练路径是 x→fθ→h→gϕ→z→Lx\to f_\theta\to h\to g_\phi\to z\to L。投影头不是一道截断墙:链式法则中 ∂L/∂θ=(∂L/∂z)(∂z/∂h)(∂h/∂θ)\partial L/\partial\theta=(\partial L/\partial z)(\partial z/\partial h)(\partial h/\partial\theta),梯度穿过g更新f。迁移时读取h,是选择另一个使用接口。

考虑一个可行构造:h=(u,c)h=(u,c)分别含形状与颜色,g(h)=ug(h)=u。两视图颜色不同但形状相同,那么z可以满足颜色不变性,而h仍有位置放颜色。这解释了投影头为什么可能缓和“训练要忽略”与“未来要保留”的冲突。

这个构造不保证网络一定学成这样。LAB 06的真实换色训练中,h的颜色5NN读出也接近机会水平(不等于所有读出都无法取得颜色);有时z的形状读出反而优于h。正面理解是投影头提供了分工空间,实证问题则是训练后哪一层对哪项任务更有用。

图示条件与公式约定

f 是视觉编码器,g 是投影头。预训练的损失经 g 传播到 f;读出时冻结 f 并训练线性头。采用 h 不构成特定属性保留保证。

这条线索的展开与后续阅读

学习信号与表示视图关系怎样成为学习目标,又会牺牲什么?

先确定任务,再判断颜色变化是否合理

解释、算例与证据

P13 · 该忽略颜色,还是该保留颜色?

用颜色任务将“什么变化应被忽略”落到可观察干预,避免把增强强度当普遍优劣。

P13 学习表示机制图,状态 2P13 学习表示机制图,状态 2任务 B:识别涂装颜色红 · 明红 · 暗蓝 · 明蓝 · 暗标签随红蓝改变红 → 红类蓝 → 蓝类问卷 1 · 使用 h 而非 z,不能保证颜色仍可读出。换色不保持任务标签

同形状法兰的红蓝和明暗四条件;切换形状任务与涂装任务改变标签判定。

  • 任务 B:识别涂装颜色
  • 红 · 明
  • 红 · 暗
  • 蓝 · 明
  • 蓝 · 暗
  • 标签随红蓝改变
  • 红 → 红类
  • 蓝 → 蓝类
  • 问卷 1 · 使用 h 而非 z,不能保证颜色仍可读出。
  • 换色不保持任务标签
同形状法兰的红蓝和明暗四条件;切换形状任务与涂装任务改变标签判定。 查看对应图解状态
查看完整图解

课堂讲述

先看任务,而不是先选一个流行增强。如果我要识别零件的形状,红色变蓝色也许不影响答案;如果我要区分涂装,红蓝本身就是答案。类似的颜色变化,对两个任务有不同意义。 所以问卷第一题真正检查的是:不能因为下游使用 h、不使用 z,就放心把训练中的颜色关系随意改掉。h 可能保留,也可能没有保留;即使保留了,给定读出方式和标签预算,能不能用起来还要检查。 这里最有用的行动不是简单说“强增强好”或“颜色增强坏”,而是先标出哪些变换保持任务标签,再比较这些条件下的表示和读出。问题一旦具体到红蓝零件,原先看似抽象的表示讨论就有了可检验的对象。

颜色应被忽略,还是应被保留?

独立阅读

如果任务是识别杯子形状,轻微光照变化不应改变答案;如果任务是分拣红杯与蓝杯,颜色正是答案来源。增强的含义必须相对于任务判断。“颜色增强”也不是单一操作:亮度缩放可能保留红蓝关系,通道交换却直接改变它。

受控比较应从同一图像出发,固定几何、背景、数据划分和训练预算,只改变预定的颜色操作。独立生成两张不同照片,再声称“只改了颜色”,会混入姿态、纹理和背景。

对照读出时,分别测形状和颜色,而不只给一个总准确率。若形状更好、颜色变差,我们学到的是一种用途取舍;不能把后者掩盖成“更强的表示”。本页问卷可以先投判断,课后在LAB 06用真实训练检验。

图示条件与公式约定

红/蓝来自现有确定性颜色变体;明暗来自现有变体及 SVG 亮度显示变换。四格属于教学条件,不是本轮训练或模型性能结果。

这条线索的展开与后续阅读

学习信号与表示视图关系怎样成为学习目标,又会牺牲什么?

先读 LAB06:形状改善伴随颜色可用性下降

把上一页的预测带到已保存图像训练结果;先看表示层与读出协议,再比较数字。

已有图像训练给出了一次明确的取舍

独立阅读

当前LAB 06保留了600张训练、240张保留的16×16合成RGB图像训练。卷积编码器产生48维h,投影头产生24维z;训练用InfoNCE,类别标签仅在冻结评价时使用。两个训练臂固定初始化、批次与预算,预定变化是视图是否以50%概率交换红蓝通道。

保存的2026-09-22基准中,保留颜色增强后的h,形状5NN为47.50%、颜色100%;换色增强后的h,形状85.83%、颜色49.17%。换色z的形状5NN为95.42%。因此这次实验观察到:迫使颜色线索不可靠后,形状更易读,而颜色信息的可用性下降。

这是当前Notebook中的历史运行记录,本轮文字整理没有重新训练。它有图像、可学习模型和保留评价,已超出手填向量热身;但仍是一个种子的小型受控任务,不支持给SimCLR与MoCo排通用名次。读出方法也重要:同一个换色h的线性形状读出为98.75%,与5NN问的并非完全同一件事。

沿这个问题继续

推荐LAB 06作为第一部分主实验:先看两种视图与历史结果,再只改一个颜色条件。

怎样增加候选,同时让历史表示仍可比较?

怎样增加候选,同时让历史表示仍可比较?

学习信号与表示怎样增加候选,同时让历史表示仍可比较?

先看轴身份,再数每行的候选

解释、算例与证据

P14 · 比较更多候选,代价在哪里?

从同一个视图列表指认查询、自身和正例:4×4 到 6×6,每行候选从 3 项到 5 项。随后再把候选来源转为计算组织问题,为 MoCo 队列做铺垫。

P14 同一视图列表的 6×6 对比矩阵:自身排除、同源正例与其他候选两轴同列 A1、A2、B1、B2、C1、C2,共 6 个视图。每行查询自身所在的灰色斜线格排除;同源另一个视图为绿色正例。A1 行排除 A1,正例为 A2,其余 4 项为 B1、B2、C1、C2;每行共 5 个候选。完整矩阵为 6×6。右侧历史键字典是下一方法 MoCo 的资源取舍,不是直接给本批 SimCLR 添加旧键。全部来自当前批次能否复用历史特征?3 张原图 → 6 个视图原图 AA1A2原图 BB1B2原图 CC1C2两轴使用同一个视图列表;行表示查询A1+A2+B1+B2+C1+C2+A1A2B1B2C1C2固定查询 A1A1:自身,排除A2:同源正例B1、B2、C1、C2:其余候选每行:1 + 4 = 5 项自身排除同源正例2N−2 个其余候选当前编码 6 个视图;完整比较矩阵 6 × 6(随 2N 平方增长)。下一方法:MoCo 的取舍先问能否保存已算的 key复用旧向量,减少本轮编码候选数与当前批次能否解耦?旧键还足够可比吗?

当前批次从原图 A、B 的 A1/A2/B1/B2 四视图(4×4)扩为 A、B、C 的六视图(6×6)。矩阵两轴使用同一视图列表,灰色斜线主对角为自身并排除;每行只有同源的另一个视图为绿色正例,其余 2N−2 个为其他候选。A1 行显示全部候选身份。右侧将复用历史 key 作为下一方法 MoCo 的资源取舍。

  • 全部来自当前批次
  • 能否复用历史特征?
  • 3 张原图 → 6 个视图
  • 原图 A
  • A1
  • A2
  • 原图 B
  • B1
  • B2
  • 原图 C
  • C1
  • C2
  • 两轴使用同一个视图列表;行表示查询
  • A1
  • +
  • A2
  • +
  • B1
  • +
  • B2
  • +
  • C1
  • +
  • C2
  • +
  • A1
  • A2
  • B1
  • B2
  • C1
  • C2
  • 固定查询 A1
  • A1:自身,排除
  • A2:同源正例
  • B1、B2、C1、C2:其余候选
  • 每行:1 + 4 = 5 项
  • 自身排除
  • 同源正例
  • 2N−2 个其余候选
  • 当前编码 6 个视图;完整比较矩阵 6 × 6(随 2N 平方增长)。
  • 下一方法:MoCo 的取舍
  • 先问能否保存已算的 key
  • 复用旧向量,减少本轮编码
  • 候选数与当前批次能否解耦?
  • 旧键还足够可比吗?
当前批次从原图 A、B 的 A1/A2/B1/B2 四视图(4×4)扩为 A、B、C 的六视图(6×6)。矩阵两轴使用同一视图列表,灰色斜线主对角为自身并排除;每行只有同源的另一个视图为绿色正例,其余 2N−2 个为其他候选。A1 行显示全部候选身份。右侧将复用历史 key 作为下一方法 MoCo 的资源取舍。 查看对应图解状态
查看完整图解

课堂讲述

我们先给格子里的对象起名字。A 和 B 是两张原图,每张各取两个视图,所以两轴都列 A1、A2、B1、B2。固定看 A1 这一行:它和自己比较的格子排除;A2 是我们指定的正例;B1、B2 是另外两个候选。现在每行有三个候选。 把原图增加到三张,得到六个视图,每行就有五个候选。更多候选可以提供比较,但也要付本轮编码与比较的成本;完整矩阵的格子数从 4×4 变为 6×6。我们不把大批次推广成所有对比方法的普遍规律,而是借这张图看见 SimCLR 的一项资源约束。 下一步问,能否复用先前已经算出的键,让候选数量和当前批次分开?这不是向刚才的 SimCLR 矩阵直接加入旧键,而是转向 MoCo 的设计问题。以前算出的向量,和今天正在变化的编码器,是否还处在足够一致的表示空间中?

批内候选数为什么和 batch 绑在一起?

独立阅读

SimCLR 从 N 张原图产生 2N 个视图。P14 的两轴使用同一个视图列表,行是查询、列是候选。两张原图 A、B 对应 A1、A2、B1、B2;矩阵是 4×4。固定查询 A1,A1 自身排除,A2 是同源正例,B1、B2 是其余候选,所以每行比较 3 项。三张原图再加 C1、C2,矩阵成为 6×6,每行比较 5 项。一般地,每行排除自身后有 2N−1 项:1 个同源正例、2N−2 个其他候选。

主对角用灰色斜线排除,绿色格表示同一原图的另一个视图。若采用“两组不同视图分别作为两轴”的另一种排法,正例可以在对角;不能离开轴身份,仅凭绿色位置判断矩阵的含义。

这些候选都由当前参数编码,彼此处于同一轮表示空间;代价是本步要处理更多图像与反向传播状态,完整的两两比较矩阵随视图数平方增加。增大 N 也会改变优化行为,并不只是免费加几个负例。

MoCo 的提问是:能否复用前几批已经算好的 key,让候选数超过当前 batch?这是下一方法的资源取舍,不是在 SimCLR 这一次比较中直接把旧键塞进矩阵。保存向量通常比保存整个图像计算图轻,但旧向量来自旧参数。下一页的队列解决“从哪里拿更多候选”,再下一页的 EMA 处理“拿来的旧候选是否仍可比较”。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:绿色格为什么不在主对角?

教师:因为本图两轴用的是同一个视图列表,主对角是同一个视图与自身。正例是同一原图的另一个视图。若两轴分别排两组不同视图,绿色可以在对角;判断要先看轴身份。

沿这个问题继续

用N=3画出配对与自身屏蔽;随后读P15,暂不展开多设备通信。

图示条件与公式约定

两轴同列同一组 2N 个视图,行是查询、列是候选。主对角是同一视图与自身,排除;同源另一个视图是唯一指定正例,其余 2N−2 项为其他候选。N=2 时 4×4,每行 3 项(1 正例、2 其他项);N=3 时 6×6,每行 5 项(1 正例、4 其他项)。当前视图越多,本轮编码也越多;完整两两比较矩阵随视图数平方增长。历史键字典是引入下一方法 MoCo 的问题,不表示 SimCLR 本次直接混入旧键。

学习信号与表示怎样增加候选,同时让历史表示仍可比较?

队列保留向量原值,同时更新成员

解释、算例与证据

P15 · MoCo:字典里保存的是特征

指认历史key的身份、加入与离开,先理解缓存到底存了什么,再问它是否仍一致。

P15 学习表示机制图,状态 2P15 学习表示机制图,状态 2容量 4 · 本轮新键 k₅、k₆ · FIFO 教学队列当前图像 → key 编码器k₅k₆入队的是特征原图只说明来源k3k4k5k6最旧最新k₅、k₆ 入队k₁、k₂ 退队队列中的旧键保持原值;更新编码器不会追溯重算它们。

四槽FIFO从k1—k4变为k3—k6;新键为已算向量,最旧两键移出。

  • 容量 4 · 本轮新键 k₅、k₆ · FIFO 教学队列
  • 当前图像 → key 编码器
  • k₅
  • k₆
  • 入队的是特征
  • 原图只说明来源
  • k3
  • k4
  • k5
  • k6
  • 最旧
  • 最新
  • k₅、k₆ 入队
  • k₁、k₂ 退队
  • 队列中的旧键保持原值;更新编码器不会追溯重算它们。
四槽FIFO从k1—k4变为k3—k6;新键为已算向量,最旧两键移出。 查看对应图解状态
查看完整图解

课堂讲述

MoCo 把对比学习看成查询字典。当前查询要在一组键中找到对应项,字典中的其他键可以来自前面的批次。 先看队列这一半。它保存的是已经计算出来的特征,不是每次都重新跑一遍网络的原图。本页容量为 4,旧队列是 [k1,k2,k3,k4];本轮有两个新键 k5、k6。每个查询先与自己的本轮正键和更新前的旧队列比较,再把两个新键按序加入,同时移走最旧的 k1、k2。下一批看到的字典是 [k3,k4,k5,k6]。P17 为便于跟完一整步,只用一个新键,所以只退一个旧键;两页的队列规则相同,示意批大小不同。 这样当前批次可以较小,候选字典仍然较大。数量问题有了办法,但假如编码器每步变化很快,队列里早些时候的特征和新特征就可能不太可比。旧键保存原值,不会自动刷新。MoCo 的另一半设计,正是控制生成键的那个编码器如何变化。

队列保存的是带历史身份的 key

独立阅读

沿本页的双样本示意,队列容量为 4,当前保存旧键 [k1,k2,k3,k4]。本轮两张图产生两个新键 k5、k6;每个查询先与自己的本轮正键及更新前的旧队列比较。比较完成后,将 k5、k6 按序加入,并移除最旧的 k1、k2;下一批使用的字典于是变为 [k3,k4,k5,k6]。这是“容量 4、每批 2 个新键”的教学设置。P17 为便于逐项跟踪,改用每批 1 个新键,得到 [k2,k3,k4,k5];入队和出队遵守相同的先进先出规则。

每个槽保存的是当时算好的向量。k2不会因为查询编码器更新,就自动变成今天重新编码的k2;也没有保存一条可以反传回早先图像的完整计算图。队列的身份标签帮助我们看清“新信息进入、旧信息退出”,向量值则用于相似度计算。

容量更大可以提供更多比较对象,也使最旧条目来自更早的步骤。容量、batch大小和编码器变化速度因此互相影响。课堂图只画4个槽便于指认,不能把4当作MoCo论文的配置。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:为什么这张图一次移走两个旧键,P17 却只移走一个?

教师:本页一批放入 k5、k6 两个新键,所以容量不变时退掉最旧的 k1、k2,得到 [k3,k4,k5,k6]。P17 用 k5 一个新键跟完一整步,所以只退掉 k1,得到 [k2,k3,k4,k5]。队列规则没有改变,示意的批大小不同。

沿这个问题继续

用4槽字典手推两步;LAB 07的trace是对应代码入口,不需要重训就能先理解对象。

图示条件与公式约定

容量 4、本轮 2 个新键仅为便于观察的教学队列,不是原论文超参数。比较使用本轮更新前队列;示意下一批的维护结果为 [k3,k4,k5,k6]。 P17 改用每批 1 个新键跟完一次学习,因而只移出 k1,下一批字典为 [k2,k3,k4,k5];两页示意批大小不同,先进先出规则相同。

这条线索的展开与后续阅读

学习信号与表示怎样增加候选,同时让历史表示仍可比较?

梯度和 EMA,更新的是不同对象

解释、算例与证据

P16 · 两个编码器,不同的更新方式

两种参数更新解决不同任务:query学当前选择,key维持较平滑的编码规则。

P16 学习表示机制图,状态 2P16 学习表示机制图,状态 2查询视图查询编码器 θqq对比损失键视图键编码器 θkk⁺梯度更新键分支停止梯度参数 EMAθk ← m θk + (1−m) θq0.9 × 1 + 0.1 × 2 = 1.1这里的平均对象是网络参数;m = 0.9 仅用于教学算例。

query分支接受损失梯度,key分支停止梯度且参数由EMA跟随;算例0.9×1+0.1×2=1.1。

  • 查询视图
  • 查询编码器 θq
  • q
  • 对比损失
  • 键视图
  • 键编码器 θk
  • k⁺
  • 梯度更新
  • 键分支停止梯度
  • 参数 EMA
  • θk ← m θk + (1−m) θq
  • 0.9 × 1 + 0.1 × 2 = 1.1
  • 这里的平均对象是网络参数;m = 0.9 仅用于教学算例。
query分支接受损失梯度,key分支停止梯度且参数由EMA跟随;算例0.9×1+0.1×2=1.1。 查看对应图解状态
查看完整图解

课堂讲述

查询编码器用梯度学习;键编码器不直接通过这条对比损失反向更新,而是用查询编码器参数的移动平均来跟随。 例如只看一个参数分量,旧的键参数是 1,当前查询参数是 2,平均系数取 0.9,那么键参数会变成 1.1,而不是立刻跳到 2。真实网络是对所有参数作这样的更新,这个小数字只是帮助我们看清“缓慢跟随”是什么意思。 这里的 momentum 平均的是网络参数,不是优化器里累积梯度的动量。较慢变化的键编码器,让跨批次保存的键更一致,但旧特征依然不是被神奇地刷新为今天的结果。队列和参数平均,分别回应“大”和“相对一致”两个要求。

梯度更新和 EMA 更新作用在不同地方

独立阅读

query编码器从当前损失接收梯度,例如 θq←θq−η∇θqL\theta_q\leftarrow\theta_q-\eta\nabla_{\theta_q}L。key编码器不沿当前loss反传,而通过参数移动平均跟随query:θk←mθk+(1−m)θq\theta_k\leftarrow m\theta_k+(1-m)\theta_q。

令旧key参数为(0,2),当前query参数为(2,4),m=0.9,则key变为(0.2,2.2)。若query下一次仍不变,再更新得到(0.38,2.38)。平均的是网络参数,不是历史队列向量;也不同于优化器保存的梯度动量。

较慢的key变化减轻历史向量的坐标系漂移。它并不把历史key全部校正为新参数下的值,也不保证任意队列容量都合适。m=0立即追上query,m=1彻底冻结;这两个极端帮助理解时间尺度,但通常不是希望采用的默认方案。

沿这个问题继续

手算两次EMA,并在图上指出梯度箭头与EMA箭头的落点;再到P17串完整一步。

图示条件与公式约定

EMA 算例 m=.9、旧 θk=1、当前 θq=2,结果1.1。真实网络对参数张量更新;这不是优化器梯度动量。

这条线索的展开与后续阅读

学习信号与表示怎样增加候选,同时让历史表示仍可比较?

沿着一个 key,走完当前步与下一步

解释、算例与证据

P17 · 把一次学习完整走通

本页把前两页对象放回一条可追踪过程。纸面步骤与Notebook时序有细微差异,说明已明确标注。

P17 学习表示机制图,状态 3P17 学习表示机制图,状态 3同一输入视图 a视图 bquery 编码器key 编码器qk⁺ = k₅L = −ln p⁺比较用旧字典k₁ … k₄q 与所有候选比较k⁺ 是本轮正确项梯度 → θqEMAk₅ 入队;k₁ 退队k₂ k₃ k₄ k₅下一批的字典按原文算法 1:更新 query,再平均 key 参数并维护下一批的字典。

一对同源视图、query/key编码、正键与旧字典、损失、query梯度、key EMA和下一批字典在同图逐步接齐。

  • 同一输入
  • 视图 a
  • 视图 b
  • query 编码器
  • key 编码器
  • q
  • k⁺ = k₅
  • L = −ln p⁺
  • 比较用旧字典
  • k₁ … k₄
  • q 与所有候选比较
  • k⁺ 是本轮正确项
  • 梯度 → θq
  • EMA
  • k₅ 入队;k₁ 退队
  • k₂ k₃ k₄ k₅
  • 下一批的字典
  • 按原文算法 1:更新 query,再平均 key 参数并维护下一批的字典。
一对同源视图、query/key编码、正键与旧字典、损失、query梯度、key EMA和下一批字典在同图逐步接齐。 查看对应图解状态
查看完整图解

课堂讲述

现在把刚才拆开的部件接起来。同一图片产生两个视图,分别形成查询和正键;再加上队列中的其他键,构成这次需要区分的候选。 比较产生损失,损失通过查询分支改变参数。键编码器按自己的平均规则跟随,新的键进入队列,旧键离开。下一批数据到来时,网络参数和字典内容都已经不是上一批的状态。 请沿着箭头看:视图关系提供答案,损失提供更新方向,字典组织提供更多比较对象,慢编码器支持跨步复用。我们不需要在课堂手写整个训练框架,但要能够说明每个部件解决什么问题。否则拿掉一个部件以后,连实验在检验哪项假设都说不清楚。

把一次学习走通,也读清实现顺序

独立阅读

沿当前图逐项走:本批原图产生两视图;query/key编码器分别给出q、k⁺;q与k⁺及旧队列比较;loss更新query;key按EMA跟随;本次已经算出的k⁺入队、最老key出队。旧队列不因本步更新重算。

主讲画面按原论文Algorithm 1排列。当前LAB 07教学代码则在计算本批key之前执行EMA,再计算loss和query更新。这是训练步内的时序约定差异,读代码时必须跟着实际顺序,不要声称逐行相同。两者共享的关键机制是:query接受梯度、key停止梯度并平滑跟随、队列复用历史特征。

LAB 07另外在队列保存源图ID,屏蔽同源旧key,避免同一图片再次出现时成为自己的负例;不同源图仍可能属于同一类别。它没有论文的分布式ShuffleBN,训练15轮的效果也不用于论文排名。学生完成本节后,应能指出一条key何时生成、何时用于比较、何时离开。

模拟问答:旧 key 还能比较吗?

独立阅读

以下为备课用模拟对话,不是实际课堂记录。

学生:“你说是前面算过的特征,图上到底哪几个?”

教师:“队列里的k1到k4是本步开始前就存在的。正在两视图分支里生成的k5是这次的新key。比较结束后k1离开,k5进入;你看下一批字典仍有k2、k3、k4。”

学生:“编码器已经变了,它们为什么还能比?”

教师:“这是设计需要处理的困难。query可以随梯度更新,key参数用EMA缓慢跟随,减少相邻批之间的变化。旧向量没有重算,所以只能说缓和漂移,不能说完全一致。队列越长,最旧条目越老,取舍就更明显。”

学生:“那EMA是不是改了队列里面的数?”

教师:“没有。看箭头:EMA连的是两套网络参数,FIFO操作连的是向量槽位。把这两条箭头分开,整步就清楚了。”

沿这个问题继续

先读模拟对话并指着图回答,再读LAB 07真实训练函数;检查key无梯度、FIFO和源图ID屏蔽。

图示条件与公式约定

本图按 MoCo 原文 Algorithm 1 理解一次循环:两分支编码并对 key 停止梯度,使用旧字典计算损失,反传更新 query,EMA 更新 key 参数,再将本批键入队并移除最旧键。本页单样本教学循环:正键k+=k5,新字典为[k2,k3,k4,k5],只移出k1。P15另用双样本说明入队批量,二者规模明确区分。字典旧向量不被追溯重算。

学习信号与表示怎样增加候选,同时让历史表示仍可比较?

把方法拆成可组合的设计选择

解释、算例与证据

P18 · 方法不是一条封闭的家谱

收束对比路线:方法组件可以组合,是否有用还要看下游证据。由此转向不同目标的重建路线。

P18 学习表示机制图,状态 1P18 学习表示机制图,状态 12019.11MoCo2020.02SimCLR2020.03MoCo v2队列 + 慢编码器非线性投影头 + 增强设计汇合比较的不只是名字:目标、增强、头、字典、评价协议。课堂先讲 SimCLR 便于理解;发表顺序与教学顺序不同。

MoCo 2019.11、SimCLR 2020.02、MoCo v2 2020.03时间带;队列/EMA与投影头/增强两路汇合。

  • 2019.11
  • MoCo
  • 2020.02
  • SimCLR
  • 2020.03
  • MoCo v2
  • 队列 + 慢编码器
  • 非线性投影头 + 增强
  • 设计汇合
  • 比较的不只是名字:目标、增强、头、字典、评价协议。
  • 课堂先讲 SimCLR 便于理解;发表顺序与教学顺序不同。
MoCo 2019.11、SimCLR 2020.02、MoCo v2 2020.03时间带;队列/EMA与投影头/增强两路汇合。 查看对应图解状态
查看完整图解

课堂讲述

刚才为了讲明白计算取舍,我们先用了 SimCLR 的图。这不是历史发表顺序:MoCo 的预印本在 2019 年,SimCLR 在 2020 年,之后的 MoCo v2 明确吸收了 SimCLR 中的非线性投影头和增强设计。 MoCo 原文还比较了多项检测与分割迁移任务,而不只报分类读出的结果。这使“不依赖逐图类别标签也能获得可用视觉表示”有了下游证据。 这是一个很好的研究案例。持续的问题是怎样学习可迁移表示,但一个框架不必只沿着自己的名字演化;别的工作发现的有效设计,可以被吸收进去,再看它在新的组织方式下是否成立。 所以读论文时,不只看方法缩写。把目标、增强、投影头、字典组织和评价协议拆开,才能看见到底换了什么。何恺明及合作者在这里提供的是持续追问问题的线索,不是一份把所有方法归到同一人名下的作品目录。

方法是可组合的设计,不是封闭家谱

独立阅读

MoCo突出历史字典与动量编码器,SimCLR突出批内两视图比较及投影头等设计。它们不是互相排斥的整套身份:后续方法可以把一方有效的组件放入另一种计算组织中。

这种看法更有助于阅读论文。把一套方法拆成数据与增强、表示网络、目标、候选组织、更新规则、评价协议六个部分,再问新论文究竟改了哪一部分。若同时改了增强、训练时长、模型和loss,最终提高可以是有效工程组合,但不能直接把全部提高归给一个名字。

正面进展也应看清:这些设计使没有人工类别目标的图像学习成为可迁移起点。下一块用MoCo原论文的检测微调结果展示这件事,随后转到另一条不同目标路线——预测缺失像素。

图示条件与公式约定

原始 arXiv 首次提交:MoCo 2019-11-13;SimCLR 2020-02-13;MoCo v2 2020-03-09。v2 明确采用 MLP 投影头与更多增强。本页不展示论文性能表或未核实提升数字。

学习信号与表示怎样增加候选,同时让历史表示仍可比较?

在固定检测协议下检验预训练起点

比较同一下游检测器的两种预训练起点,而不是要求冻结编码器直接输出框。

MoCo 的表示怎样支持检测迁移?

独立阅读

MoCo原论文Table 2(b)在同一Faster R-CNN、ResNet-50-C4设置下比较预训练起点:

预训练 box AP AP50 AP75
ImageNet-1M 人工类别监督 53.5 81.3 58.8
ImageNet-1M MoCo 55.9 81.5 62.6

两者均在VOC trainval07+12检测标注上全层微调24k次,评价为VOC test2007,取5次实验平均;AP是COCO式多IoU阈值指标,AP50/AP75是指定阈值。MoCo相对提高2.4 AP,说明视图对比学出的参数在这套下游协议下提供了有效起点。

这不是冻结模型直接会检测:检测头与主干都用检测监督适配。它也不把所有预训练和下游总算力配平。相同论文的另一种主干结构收益不同,因此结论应保留具体模型与协议。

限制可见信息,怎样构成可验证的重建任务?

限制可见信息,怎样构成可验证的重建任务?

学习信号与表示限制可见信息,怎样构成可验证的重建任务?

先限制输入,重建才不只是复制

解释、算例与证据

P19 · 另一条路线:根据可见内容预测缺失

重建不是简单复制;瓶颈、破坏或遮挡为学习增加约束,和视图关系形成另一类目标。

P19 学习表示机制图,状态 1P19 学习表示机制图,状态 1完整原图只藏一小块藏住四分之三图像存在局部冗余邻近颜色可能已足够更需要跨区域线索可见内容 → 预测隐藏内容这里只显示输入与目标遮挡;没有把绘制出来的补图冒充模型重建。

同一图的完整、单块遮挡和75%遮挡并列,不展示模型重建结果。

  • 完整原图
  • 只藏一小块
  • 藏住四分之三
  • 图像存在局部冗余
  • 邻近颜色可能已足够
  • 更需要跨区域线索
  • 可见内容 → 预测隐藏内容
  • 这里只显示输入与目标遮挡;没有把绘制出来的补图冒充模型重建。
同一图的完整、单块遮挡和75%遮挡并列,不展示模型重建结果。 查看对应图解状态
查看完整图解

课堂讲述

刚才的目标要求两个视图建立对应。另一条路线不先问“它和谁相同”,而是问“只看到一部分,能否预测没看到的部分”。视觉补全和重建研究并不是 MAE 才出现,MAE 是在这条线上重新选择任务难度与计算组织。 图像局部经常有冗余。缺一个很小的块,模型可能靠邻近颜色纹理就完成得不错;隐藏更多内容,预测会需要利用更大范围的结构,但任务也可能过难。 所以不能只把语言里的遮挡形式搬过来,就认为视觉问题已经解决。要具体决定遮多少、编码器看什么、解码器做什么,以及最后拿什么评价表示。下面用同一张图把 MAE 的这几个选择连起来。

重建需要什么限制,才不只是在复制?

独立阅读

如果把原图完整交给一个足够强的模型,再要求原样输出,复制就能得到零误差。重建作为表示学习目标,需要规定信息怎样通过:离散词典限制代码只能是一个索引,PCA限制在线性低维子空间,去噪自编码器限制只能看被破坏输入,MAE限制只看到部分位置。

这些限制迫使模型利用数据规律。反过来,跳连若把目标原样送到输出,或输入预处理意外泄漏被遮像素,就可能完成重建却绕过了希望训练的表示。

本讲不要求先学完所有自编码器。沿“输入可见什么→中间表示允许什么→在哪些位置算误差”即可比较它们。LAB 05保留真实patch词典拟合,CLS 05给PCA与去噪推导,LAB 08再把重建和冻结读出接到同一图像实验。

图示条件与公式约定

遮挡图由同一原图与固定网格生成。小遮挡仅隐藏位置9;大遮挡保留位置0、3、9、14。不绘制、也不宣称本轮有 MAE 重建输出。

这条线索的展开与后续阅读

学习信号与表示限制可见信息,怎样构成可验证的重建任务?

重建误差最小,未必保留任务所需差异

用四个确定点,把重建目标与未来分类目标分开。

保留最大方差,不等于保留任务答案

独立阅读

取四点 (2,0),(−2,0),(0,1),(0,−1)(2,0),(-2,0),(0,1),(0,-1)。均值为零,按四个样本取平均的协方差为diag(2,0.5)。PCA只保留一维时选择横轴:前两点不变,后两点投影为原点。平均平方重建误差为 (0+0+1+1)/4=0.5(0+0+1+1)/4=0.5;若选纵轴,则为2。

在“尽量重建输入”这个题目下,横轴合理。但若任务要区分纵坐标正负,两点落在原点后就无法再区分。问题不在PCA算错,而在重建目标和未来用途不完全一致。

这个反例同样提醒我们理解深层重建:低像素误差是一个有意义的成绩,却不是所有语义任务的替代指标。需要另外检验表示能否支持类别、颜色或空间读出。

学习信号与表示限制可见信息,怎样构成可验证的重建任务?

平方误差为什么偏好可能模糊的平均值

固定可见条件,让隐藏值有0和1两种等可能答案,再比较三个确定预测。

为什么缺失处可能被补得模糊?

独立阅读

假设可见条件完全相同,而某个隐藏像素等概率为0或1。总输出0时,平均平方误差是0.5;总输出1也为0.5;输出0.5时,两种情况误差都是0.25,因此平均更小。

一般地,平方损失的最佳确定性预测是给定可见输入的条件均值。存在多种合理补全时,均值可能看起来模糊,即使模型已很好地优化这项损失。这与“完全没学到结构”不是同一个判断。

LAB 08里应把恢复的主要笔画、错误补全和误差图一起读。到第四讲再问:如果我们希望产生某一种合理样本,而不是平均多个可能,训练目标和输出过程应怎样改变?图像描述也已在生成文本,后续生成课将把条件多解作为更一般的问题。

学习信号与表示限制可见信息,怎样构成可验证的重建任务?

只编码四个可见块,同时保留原始位置

解释、算例与证据

P20 · 十六个图块,只有四个进入编码器

固定16块与4个可见位置,让编码器输入可以逐项指认;计算节省与隐藏比例的关系留在本页说明。

P20 学习表示机制图,状态 2P20 学习表示机制图,状态 2MAE 教学网格 · 16 块中保留 0、3、9、1401234567891011121314154 块可见,12 块隐藏块 0位置 0块 3位置 3块 9位置 9块 14位置 14编码器只处理这 4 块隐藏位置不送入 mask token4 / 16 是输入块数量;并不等于整个系统必然加速 4 倍。

4×4共16块,固定可见0、3、9、14四块携位置进入编码器,12个隐藏块不输入。

  • MAE 教学网格 · 16 块中保留 0、3、9、14
  • 0
  • 1
  • 2
  • 3
  • 4
  • 5
  • 6
  • 7
  • 8
  • 9
  • 10
  • 11
  • 12
  • 13
  • 14
  • 15
  • 4 块可见,12 块隐藏
  • 块 0
  • 位置 0
  • 块 3
  • 位置 3
  • 块 9
  • 位置 9
  • 块 14
  • 位置 14
  • 编码器只处理这 4 块
  • 隐藏位置不送入 mask token
  • 4 / 16 是输入块数量;并不等于整个系统必然加速 4 倍。
4×4共16块,固定可见0、3、9、14四块携位置进入编码器,12个隐藏块不输入。 查看对应图解状态
查看完整图解

课堂讲述

为便于观察,把这张图分成十六个图块,遮掉十二个,也就是四分之三。编码器只处理剩下四块,而不是把全部十六个位置都送进去再告诉它哪些是空的。 每个可见图块变成向量,并保留位置线索。这里我们只需要把编码器理解成将可见块组织成表示的网络,不在今天打开 Transformer 内部。 这个结构同时回应学习与计算:任务要求根据少量可见内容推测隐藏部分;昂贵的编码器又少处理了很多输入。注意,十六变四不代表整个系统必然加速四倍,其他计算仍然存在。现在先看清信息流,再看缺失位置怎样回到解码端。

16 块中,编码器真的只看见 4 块

独立阅读

当前图把原图切为4×4网格,位置编号0–15,可见集合固定为{0,3,9,14},其余12块隐藏。原图仍由数据管线保存,供损失比较;它不作为完整输入偷偷进入编码器。

可见patch转换成向量,并带着原始位置线索进入编码器。这里的位置不能压成“现在队列中的第1、2、3、4项”:位置0与位置14在原图的含义不同。输出表示还要能够放回原来的空间位置。

4/16是课堂上说明75%遮挡的简单图。随机遮挡会让训练中的可见集合变化;当前固定集合是便于逐项追踪的一个样本。原MAE的非对称设计关键在于让较重编码器只处理可见项,而不是在完整图编码之后才把12块涂黑。

少看图块为何省计算,又为何不是固定加速比

独立阅读

16块只保留4块,编码器处理的项数变为四分之一。一些逐项计算随项数下降;涉及两两位置的计算从16²降为4²,是原来的1/16。这可以解释为什么高遮挡率有计算价值,但不需要在本讲展开注意力算法。

整个训练还包含patch转换、其他网络层、解码器、损失和硬件调度。解码器重新处理完整位置,因此端到端耗时不等于某个二次项的比值。课堂上“16倍”只可描述这个构造的两两项数变化,不能宣称实际训练快16倍。

当前LAB 08用稠密卷积网格加mask通道,仍处理完整8×8图像;它能教遮挡目标与评价,但不能复现原MAE可见token编码器的计算节省。方法机制与教学模型的对应范围应这样逐项标清。

沿这个问题继续

对照LAB 08最后的原MAE比较表,明确教学ConvAE仍处理稠密网格;不要拿它测原MAE加速。

图示条件与公式约定

块索引按从左到右、从上到下的0至15。可见集合={0,3,9,14},隐藏比例=12/16=.75。现实预训练随机采样,此处固定采样结果以便追踪。

这条线索的展开与后续阅读

学习信号与表示限制可见信息,怎样构成可验证的重建任务?

逆排列先恢复位置,像素答案仍然未知

解释、算例与证据

P21 · 解码器补位置,目标来自原图

解码阶段恢复位置,再预测内容;目标从原图来,误差只在隐藏集合比较。

P21 学习表示机制图,状态 2P21 学习表示机制图,状态 2解码端:所有位置加入 pᵢ;隐藏位置共用一个 mask 向量 Mh0+p0M+p1M+p2h3+p3M+p4M+p5M+p6M+p7M+p8h9+p9M+p10M+p11M+p12M+p13h14+p14M+p154 个 h + 12 个 M轻量解码器ŷ0ŷ1ŷ2ŷ3ŷ4ŷ5ŷ6ŷ7ŷ8ŷ9ŷ10ŷ11ŷ12ŷ13ŷ14ŷ15各位置的像素预测(符号示意)原图目标 xL = (1/12) Σ隐藏块 MSE(ŷᵢ, xᵢ)橙框:12 个计入 loss 的位置预训练后留下编码器;重建用解码器不必进入下游系统。

4个编码结果和12个共享mask加位置线索进入解码器;输出是16个符号像素预测,橙框只标隐藏位置,原图小图为目标。

  • 解码端:所有位置加入 pᵢ;隐藏位置共用一个 mask 向量 M
  • h0+p0
  • M+p1
  • M+p2
  • h3+p3
  • M+p4
  • M+p5
  • M+p6
  • M+p7
  • M+p8
  • h9+p9
  • M+p10
  • M+p11
  • M+p12
  • M+p13
  • h14+p14
  • M+p15
  • 4 个 h + 12 个 M
  • 轻量解码器
  • ŷ0
  • ŷ1
  • ŷ2
  • ŷ3
  • ŷ4
  • ŷ5
  • ŷ6
  • ŷ7
  • ŷ8
  • ŷ9
  • ŷ10
  • ŷ11
  • ŷ12
  • ŷ13
  • ŷ14
  • ŷ15
  • 各位置的像素预测(符号示意)
  • 原图目标 x
  • L = (1/12) Σ隐藏块 MSE(ŷᵢ, xᵢ)
  • 橙框:12 个计入 loss 的位置
  • 预训练后留下编码器;重建用解码器不必进入下游系统。
4个编码结果和12个共享mask加位置线索进入解码器;输出是16个符号像素预测,橙框只标隐藏位置,原图小图为目标。 查看对应图解状态
查看完整图解

课堂讲述

来到解码阶段,编码结果和缺失位置的占位向量一起形成完整的位置集合。解码器根据这些信息预测像素,训练时拿原图中被隐藏的内容作目标。 于是答案的来源很清楚:我们先把它挡住,再让模型预测,不需要另外请人标“这是一只猫”。原始 MAE 的损失计算在被遮住的图块上,不能只靠复制已经看见的部分完成任务。 更重要的是,预训练结束后,我们关心的是留下的编码器表示;为重建服务的解码器不必成为后续分类或检测系统的一部分。这也解释了为什么编码端和解码端可以承担不同重量。接下来要问:重建完成得好,是否就说明留下的表示什么都适合?

补回位置与补回像素,是两件事

独立阅读

用4个位置缩小算例。原位置是[0,1,2,3],随机顺序为[2,0,3,1],取前两项进入编码器。得到[z2,z0]后,解码阶段先加两个mask项:[z2,z0,M,M]。逆排列为[1,3,0,2],按它取值后成为[z0,M,z2,M]。

这时我们只是恢复了“谁在什么位置”。位置1和3仍未知,M不是正确像素;解码器要结合可见内容及各位置线索作预测,再与原图相应位置比较。

如果忘了逆排列,模型可能把正确形状放到错误坐标,loss也会对错位置。LAB 08的索引热身正好检查这个对应关系;后面的卷积重建才包含参数学习。不要把数组重排成功写成模型学会了补图。

图示条件与公式约定

M 为共享学习向量,各位置还需位置线索;h 为相应可见块的编码结果(进入解码前可投影维度)。ŷ_i 是预测像素向量的符号占位,图中的原图小图是监督目标而不是重建结果。展示未归一化像素MSE;原论文亦比较逐块像素归一化目标。loss 的求和与平均仅在隐藏位置。

学习信号与表示限制可见信息,怎样构成可验证的重建任务?

只评价隐藏位置,别让已知真值稀释误差

已知位置、未知内容和用于比较的原图,是三种不同对象。

只在隐藏位置算损失,分母也要一致

独立阅读

令隐藏集合为 M\mathcal M,每个patch含P个像素值。一个清晰的口径是先在patch内平均,再在隐藏patch间平均:L=∣M∣−1∑i∈MP−1∑p=1P(x^ip−xip)2L=|\mathcal M|^{-1}\sum_{i\in\mathcal M}P^{-1}\sum_{p=1}^{P}(\hat x_{ip}-x_{ip})^2。16块中隐藏12块时,外层分母就是12。

若把已知可见像素直接拼回预测图,它们误差天然为零。此时对整图平均会使指标更小,却没有改善隐藏预测。图像面板可以为方便阅读拼回可见真值,但必须说明;数值则继续评价隐藏集合。

原论文还讨论对每个patch的像素做归一化后作为目标。比较不同实验时,要同时核对预测位置、像素缩放及归一化;同样叫“MSE”的数,分母和目标一变就未必可比。

模拟问答:不知道的地方为何还有位置?

独立阅读

以下为备课用模拟对话,不是实际课堂记录。

学生:“遮住的地方没有像素,为什么解码器还有16项?”

教师:“我们不知道内容,但知道问题要问哪个位置。可见位置放编码表示,隐藏位置放共同的mask占位,再给每项自己的位置线索。占位不是答案,位置告诉模型答案该落在哪儿。”

学生:“既然原图有答案,为什么不直接把它送进去?”

教师:“原图由损失端保存。若把隐藏像素作为输入,模型就可能复制,遮挡任务被取消了。看图时把编码器入口和损失比较端分开。”

学生:“补得像原图,就算学会分类了吗?”

教师:“那说明重建这件事做得更好。下一页再冻住编码器,另用标签做读出;只有测到那份结果,才能说明表示对分类有用。”

沿这个问题继续

先手算四位置逆排列与分母,再读模拟问答。理解位置后才进入LAB 08重建与误差图。

学习信号与表示限制可见信息,怎样构成可验证的重建任务?

读 LAB08:重建和读出各交一份成绩

解释、算例与证据

P22 · 能补图,不等于每项任务都读得好

重建结果与表示用途分开评价,并给出真实正面研究结果和课程小模型结果各自的身份。

P22 学习表示机制图,状态 1P22 学习表示机制图,状态 1重建训练预训练编码器形状读出能否分出零件类型?颜色读出红蓝是否仍可区分?重建误差下游任务结果两种证据,分别测量

遮挡预训练编码器分别连接形状与颜色任务,重建误差与下游成绩明确分开。

  • 重建训练
  • 预训练编码器
  • 形状读出
  • 能否分出零件类型?
  • 颜色读出
  • 红蓝是否仍可区分?
  • 重建误差
  • 下游任务结果
  • 两种证据,分别测量
遮挡预训练编码器分别连接形状与颜色任务,重建误差与下游成绩明确分开。 查看对应图解状态
查看完整图解

课堂讲述

重建好,是关于重建任务的证据。它可能利用了有价值的结构,也可能将很多能力花在纹理和局部统计上;我们还不能由一幅看起来不错的补图,推出所有语义任务都已经解决。 反过来也一样:一种表示不容易被简单分类头读出,不等于它完全没有相关信息。评价方法在限定我们允许怎样使用表示。 因此,要把预训练成绩和下游用途分开。对比学习、遮挡重建、有监督分类,都应该送进你真正关心的任务,检查在相同数据和训练条件下能做什么。我们要的不是一个抽象的“最好表示”称号,而是清楚知道某种表示以什么方式帮助了当前问题。

能补图与能识别,需要两张成绩单

独立阅读

重建评价比较预测像素与原图,冻结读出则固定编码器,用有标签参考集或新头预测类别。前者回答模型是否利用可见结构恢复缺失,后者回答这份表示能否支持指定用途。

当前LAB 08的历史基准用1257张训练、540张保留的8×8数字图。去噪ConvAE的全像素MSE从直接使用破坏图的0.06244降至0.03217;清洁输入h的冻结5NN则从相同架构随机起点84.26%提高到95.00%。遮挡ConvAE的对应读出从88.52%到92.04%。这里是两份独立测量共同支持有用性。

原图先切分,再生成噪声和mask;标签不进入重建损失。结果来自已保存运行,本轮没有重训;当前Notebook另记有旧云端复核。它不是原ViT MAE复现,也没有写作者分组,不能据此声称跨写作者泛化。

这条线索的展开与后续阅读

学习信号与表示限制可见信息,怎样构成可验证的重建任务?

MAE 的正面证据,也要说清使用接口

原论文的端到端微调、最后块微调和线性读出,允许改变的计算不同。

MAE 的正面证据也依赖评价接口

独立阅读

MAE论文Table 3使用ImageNet-1K图像作自监督预训练,再端到端微调分类。ViT-L/16在224输入的top-1为85.9%;同表从零训练实现为82.6%。这里的结果支持:遮挡像素目标可以为较大视觉模型提供有效起点。它不是只看重建图好不好看。

论文Figure 9进一步指出,同一ViT-L表示的线性读出为73.5%,只微调最后一个块即可到81.0%。因此线性读出低,并不自动意味着这份表示不适合适配;评价允许改变多少计算,会影响判断。

这些是论文在明确训练与评价条件下的结果,不是本课程LAB 08的数字。阅读时区分三层:MAE原论文、当前教学卷积模型、页面里的16块索引图。它们分别提供研究实证、可运行学习链和透明机制。

怎样判断表示支持了哪种使用方式?

怎样判断表示支持了哪种使用方式?

学习信号与表示怎样判断表示支持了哪种使用方式?

先说明允许哪些参数改变,再比较结果

解释、算例与证据

P23 · 冻结读出和微调,在问不同的问题

把第一部分的方法转为使用与评价:冻结读出问现成表示,微调问适配起点,二者应各有协议。

P23 学习表示机制图,状态 1P23 学习表示机制图,状态 1线性读出编码器 · 冻结线性头 · 可训练现有特征能否读出?微调适配编码器 · 可训练任务头 · 可训练适配后能到哪里?空间迁移空间特征 · 按协议检测 / 分割头位置与边界可用吗?共同写明:新数据切分 · 标签预算 · 训练参数范围 · 任务指标

冻结编码器的线性读出、可训练编码器的微调和空间任务三种协议,训练范围与数据条件并列。

  • 线性读出
  • 编码器 · 冻结
  • 线性头 · 可训练
  • 现有特征能否读出?
  • 微调适配
  • 编码器 · 可训练
  • 任务头 · 可训练
  • 适配后能到哪里?
  • 空间迁移
  • 空间特征 · 按协议
  • 检测 / 分割头
  • 位置与边界可用吗?
  • 共同写明:新数据切分 · 标签预算 · 训练参数范围 · 任务指标
冻结编码器的线性读出、可训练编码器的微调和空间任务三种协议,训练范围与数据条件并列。 查看对应图解状态
查看完整图解

课堂讲述

第一种检查,冻结编码器,只训练一个线性读出。这在问:在这种受限的读出方式下,已经得到的特征有多可用? 第二种检查,允许部分或全部参数继续学习。这在问:以已有参数为起点,适配新任务能够达到什么结果?成功可能来自原有表示,也可能包含适配过程中重新学到的能力。 第三种,是把表示放进检测或分割,检查空间任务。它们需要的信息和训练接口又不同。所以报告“迁移很好”时,至少要补上迁移到哪里、训练哪些参数、使用多少标签、怎样切分新数据。对科研实践来说,这比只记一个 ImageNet 分数更有用。

冻结读出与微调分别在问什么?

独立阅读

冻结读出把 fθf_\theta 固定,只学习新头 Wh+bWh+b。它问“当前表示中,答案能否被这个受限读出取出?”kNN甚至不拟合新网络,但仍用训练标签建参考库,并依赖距离、归一化和k。微调允许编码器改变,问“这个起点经过给定适配后能做到什么?”

公平比较首先固定目标任务、原图划分、标签预算和评价规则。按原图先划分再生成视图,避免同一原图的两个裁剪分别进入训练和测试。超参数和停点用验证集选择,测试集用于最终报告。已经看过的保留结果可供探索,却不再是未知验收题。

冻结参数还不自动冻结所有状态。含BatchNorm时,运行统计可能在train模式改变;eval()、no_grad()与requires_grad_(False)控制不同对象。LAB 02保留这项实现选读,主讲先抓住“哪些参数可动,答案用在哪里”。

图示条件与公式约定

线性读出:冻结编码器,仅训练线性头;微调:注明解冻部分或全部;空间任务也须注明骨干训练范围。不能由一种协议结果替代另一种。

这条线索的展开与后续阅读

学习信号与表示怎样判断表示支持了哪种使用方式?

四点 XOR:信息存在,不等于一条直线能读出

把表示中的任务信息、输入身份和读出函数类分开,避免用单一失败作过强结论。

信息还在,与一条直线能读出是两件事

独立阅读

四点 h 为 (−1,−1)、(−1,+1)、(+1,−1)、(+1,+1),同号标签 0、异号标签 1。每一点都不同,标签由 h 完全确定;但两类位于对角,无法用一条直线完全分开。

左图四个 h 坐标:同号两角为标签 0、异号两角为标签 1;右图 z=h1h2 数轴,两个标签 1 输入都落在 −1,两个标签 0 输入都落在 +1,阈值为 0。每个数轴位置对应两个输入。
放大查看四点图 ↗ · 精确构造的四点读出:左图保留输入身份,右图用乘积改变可读形式。图中位置和标签由数据表确定,并非训练输出。

左图每个输入都有独立坐标,标签也完全由坐标确定;但同类占据对角,不能用一条直线把两类完全分开。右图只保留乘积 z=h1h2z=h_1h_2:两个异号输入都落在 −1,两个同号输入都落在 +1。现在一个零阈值 z<0z<0 就能正确读取标签;每个数轴位置合并了两个输入,图中不通过抖动伪造不同的 z 值。

h1 h2 标签 y z=h1h2
−1 −1 0 +1
−1 +1 1 −1
+1 −1 1 −1
+1 +1 0 +1

这个变换没有增加标签信息,并且合并了原来不同的输入身份。它是四点上的精确构造,不是某次训练得到的表征,也不能证明任意压缩都会改善读出,或少量训练样本一定能学出这个变换。

以下是备课用模拟追问,不是课堂实录。

学生:“既然左图不能画一条分界线,是不是标签信息已经丢了?”

教师:“先看数据表,每个 h 都仍唯一确定标签;失败的是单一直线这类读出。换一个乘积坐标后,一条阈值就足够。可是只看 z,你已不能恢复原来是哪一个同号角点。这正好把‘某任务的信息’‘原输入身份’和‘读出函数能否使用’分开。”

因此低维不必等于丢掉任务信息,线性失败也不必等于信息全无。LAB18 同时报告 XOR 读出与离散 bit 算例;把结论限定在明确的输入、标签和函数类上,比笼统说“表示越压缩越好”更准确。

沿这个问题继续

读h=(u,c)构造,再看LAB 06的实际h/z表;需要区分信息与线性可读时读XOR块。

按问题回查的讲解与短练习(2)

学习信号与表示怎样判断表示支持了哪种使用方式?

读 LAB01:固定表示,只改变预算与读出

编码器始终不动,先固定标签预算比较读出,再固定读出比较预算。

同一表示,增加标签与改变读出是两种干预

独立阅读

LAB 01使用一个已有有监督CNN的32维表示,目标为MNIST数字是否≥5。640个目标样本与源模型训练/验证索引分离,目标再分256训练、128验证、256保留;图像统一右移2像素。

保存结果中,标签32→256时,kNN保留准确率从0.7148到0.9492;固定C=10的线性逻辑回归从0.6133到0.8359。编码器从头到尾未变,所以差别来自标签预算与读出使用方式,而不是编码器重新学了一次。

这提供一个很具体的学习动作:先固定预算比较两种读出,再固定读出比较预算。不要把这组结果误读成“自监督胜过监督”;源CNN本来就是监督训练的。也不要据单次差距断言表示中没有某种信息——正则强度和读出函数类都是竞争解释。

学习信号与表示怎样判断表示支持了哪种使用方式?

读 LAB02:按预定规则,接受迁移没有获胜

共享起点与数据顺序,比较head、late、all以及scratch,按最低验证CE选择。

解冻更多参数,不保证更好

独立阅读

LAB 02从同一十分类CNN出发比较head、late、all,并加入随机起点scratch。新任务仍是数字是否≥5;head只更新新头,late更新后部,all更新全网。三种迁移共享源checkpoint、新头初始化、数据顺序和训练轮数。

已有默认协议是256训练、128验证、4轮、Adam学习率0.002。保存的最低验证交叉熵为head 1.906、late 0.877、all 0.849、scratch 0.611。按预先确定的“最低验证CE”规则,这一次应选择scratch,而不是因为课程在讲迁移就偏爱迁移模型。

这个负结果有教学价值:迁移是一种可检验起点优势,不是身份保证。相同轮数并不等算力,相同学习率也未必给每种范围公平的调优机会。可进一步只改标签预算或位移,再事先确定新的验证协议;不能反复看同一测试集直到挑出喜欢的结果。

沿这个问题继续

基础路线选LAB 01;需要参数迁移再做LAB 02。XOR与域变化是解释某种失败时才打开的分支。

按问题回查的讲解与短练习(4)

学习信号与表示怎样判断表示支持了哪种使用方式?

新域失败与负迁移,需要不同参照

先比较源域与目标域,再在同一目标预算下比较适配与从零,避免混用两种差值。

新域失效与负迁移不能混为一谈

独立阅读

设源域中背景与标签强相关,目标域把这条关系翻转。一个使用背景的模型可以在随机源域保留集很好,到目标域却失败。这说明源域评价没有覆盖所需环境变化;还不能单独说明“用了预训练反而更坏”。

负迁移需要在同一目标任务和标签预算下比较预训练起点与合理基线,例如从零训练。当前LAB 22用两维解析输入训练逻辑回归,明确区分源域保留、目标零样本、32标签适配与32标签从零。历史输出中适配准确率0.9922,高于零样本0.0762;但从零为1.0,因此适配收益和相对从零优势不是同一数。

这是受控特征实验,不是视觉模型从照片自动发现因果。它帮助学生设计下一次真正研究:哪些环境被留出,哪些线索稳定,少量目标标签能修正什么?

学习信号与表示怎样判断表示支持了哪种使用方式?

下一步:把表示接到区域、像素和对象身份

解释、算例与证据

P24 · 学到表示之后,新任务提出了什么要求?

总结表示学习的选择与评价,再引入空间任务:输出要求变了,已有整图答案不能直接交付位置和实例。

P24 学习表示机制图,状态 1P24 学习表示机制图,状态 1人工类别视图对应隐藏内容可复用的视觉表示类别:有什么区域:在哪里像素 / 实例身份下一步:把空间信息变成任务能够使用的答案。

人工类别、视图对应、隐藏内容三路汇入视觉表示,再连接类别、区域、像素及实例身份。

  • 人工类别
  • 视图对应
  • 隐藏内容
  • 可复用的视觉表示
  • 类别:有什么
  • 区域:在哪里
  • 像素 / 实例身份
  • 下一步:把空间信息
  • 变成任务能够使用的答案。
人工类别、视图对应、隐藏内容三路汇入视觉表示,再连接类别、区域、像素及实例身份。 查看对应图解状态
查看完整图解

课堂讲述

第一部分现在可以收起来了。监督分类、视图对比、遮挡重建,用不同信号塑造表示;它们不是“有用”和“没用”的简单对立,也不能只凭训练目标判断迁移能力。 我们已经有了可以复用的网络。下一步不再增加一种预训练方法,而是把它送进更具体的视觉任务。还是这张图,我不仅要说有杯子,还要找到每只杯子的位置,分出杯柄和边缘,并区分相邻两个同类对象。 这些要求会让原来容易忽略的空间信息成为中心。下面先回到分类预训练迁移到检测的历史案例,再看区域计算、像素预测和实例掩码怎样汇合。课堂顺序这样安排,是为了看清问题;历史上,它们并不是等现代自监督成熟才开始。

从表示到空间输出:下一部分新增了什么?

独立阅读

第一部分回答怎样获得表示,以及怎样判断它对新任务有用。第二部分不重新挑选一套更响亮的预训练名称,而是改变答案格式:整图类别变成对象框、像素类别与实例身份。

整图向量可以告诉我们“有杯子”,但若位置已经被平均掉,后面再加复杂读出也未必能找回哪只在左。保留空间网格以后,还要决定怎样提出区域、给区域分配类别与框、让mask对应到具体对象。训练目标和输出结构必须一起适配。

历史上的R-CNN使用监督分类预训练;它不以MoCo为前提。这里的连接是问题层面的:一份可迁移起点怎样接到新任务,而不是把方法硬排成单线进化史。带着这一问题读P25的同场景四种答案,才能看见为何下一部分需要新的监督与接口。

沿这个问题继续

读P25四种输出作为下一段起点;若对源域成功目标域失败感兴趣,再选LAB 22。

按问题回查的讲解与短练习(2)

图示条件与公式约定

回到已有两杯一书同一底图,第一部分结束不引入新预训练方法;进入监督预训练迁移的历史案例也不意味着自监督先于早期检测。

这条线索的展开与后续阅读

表示学习的选读问题

哪些细节需要进一步对照?

学习信号与表示表示学习的选读问题

选读:模型提供软目标,为什么仍须检查坍塌

把固定教师和EMA教师分开;同一组logits改变温度,先看软目标表达了什么。

教师模型提供的是哪一种答案?

独立阅读

固定教师蒸馏让学生拟合一个已有模型的概率分布;EMA教师则来自学生参数的历史平均。这两种教师都不是天然正确的类别真值,也不必比学生更大。

以logits(4,2,0)为例,温度1的概率约(0.8668,0.1173,0.0159),温度2约(0.6652,0.2447,0.0900)。软目标除最大类外,还表达其他类别的相对接近。学生可以用交叉熵拟合它,但也可能继承教师的背景捷径。

BYOL、DINO说明不显式使用负例也能学表示;它们采用的不对称预测、停止梯度、教师更新及输出分布处理应整体理解。当前LAB 17训练的是解析输入上的固定线性教师蒸馏,再单独算EMA,不是DINO视觉复现。这里适合作为理解“目标从模型取得”的选读分支,阅读后回到P18。

沿这个问题继续

用K=3手算常量对比loss;想追问无负例学习,再选LAB 17,不必先学整个DINO。

沿这个问题继续

先读MoCo检测证据表及协议;教师目标为选读,随后直接进P19。

按问题回查的讲解与短练习(2)

学习信号与表示表示学习的选读问题

选读:结构和重建目标需要共同检验

比较ConvNeXt V1/V2与监督/FCMAE两列,先保留训练预算和证据范围。

选读:结构与遮挡目标为什么要共同设计

独立阅读

把原MAE目标直接搬到卷积网络,并不意味着所有结构假设仍成立。ConvNeXt V2将遮挡图看成稀疏空间输入,用FCMAE组织学习,并引入GRN改善通道响应的多样性。这提供了一个正面研究例子:目标与网络结构可以一起设计。

原论文Table 3的Base比较(ImageNet-1K top-1,%):

架构 监督训练 FCMAE预训练后微调
V1-Base 83.8 83.7
V2-Base 84.3 84.6

FCMAE列先预训练800轮再微调,不能称等总预算。V1中换目标为−0.1,V2中为+0.3;这提示组合值得研究,却不能仅凭四个数识别一个严格因果交互。这里是论文证据,和LAB05的patch词典拟合不是同一实验。读完回到P22的用途评价,不再另开主讲章节。

沿这个问题继续

CLS 05提供连续推导;想做最透明优化选LAB 05,想做图像模型选LAB 08,二选一即可。

按问题回查的讲解与短练习(1)

沿这个问题继续

在LAB 08对照清洁、破坏、预测、误差四列,再读冻结5NN表;不把两种指标相互替代。

按问题回查的讲解与短练习(1)

学习信号与表示表示学习的选读问题

第六讲预备阅读:同一次更新怎样分给多设备

此页保存等大小与不等大小批次的梯度合并算例,不进入本讲默认顺序。

第六讲预备阅读:怎样把一次更新分给多设备

后续课程预备或按需选读,不列为本讲必讲内容。

独立阅读
课堂上下文:从哪个问题来

资源约束在本讲是方法选择的一个条件;真正需要回访它的是批内候选、MoCo缓存与MAE可见块。

本段是后续课程预备阅读,不属于Lecture03当堂必讲。它承接“训练目标要能实施”,帮助有需要的学生定位旧材料,而不是要求理解MoCo前先学分布式训练。

最小例子:两个设备从同一参数(1,2)开始,等大小本地批次给平均梯度(2,4)和(6,0)。合并梯度为(4,2),学习率0.1,所有副本都更新为(0.6,1.8)。若本地样本数2:6,就应按样本数加权,得到梯度(5,1)、参数(0.5,1.9)。关键是所有设备执行同一全局目标的一次更新,而不是各自学成不同模型。

进一步的状态分片讨论谁保管权重、梯度和优化器状态,通信讨论计算前怎样取齐需要的数据。这些旧算例仍有价值,放在后续阅读入口,避免和本讲“训练答案从哪里来”的主问题混在同一默认顺序中。

继续阅读与实验

II · 区域、像素与实例

从一个类别变成框、像素与实例,需要改变哪些计算与监督?

任务究竟要求留下什么信息?

从类别到框、像素与实例,输出要求怎样改变表示的读取?

区域、像素与实例任务究竟要求留下什么信息?

在同一场景里比较四种答案

解释、算例与证据

P25 · 同一张图,四种不同的答案

先看同一张图要交付什么:类别存在性、对象框、逐像素类别和实例身份。四幅图保持底图相同,变化的是答案结构;框与 mask 是教学标注。课后从这里进入两个真正学习任务,才能把“更精细”落实为目标与评价的变化。

Lecture 03 课堂图解 P25分类:图中有什么杯子 · 书检测:每个对象在哪里类别 + 框两只杯子一册书语义:每个像素是什么颜色 = 类别杯子书实例:属于哪一个对象颜色 = 实例 ID杯子 #1杯子 #2同一底图;框与可见轮廓为教学标注。输出结构不同,所需监督也不同。

同一双杯书本底图的分类、检测、语义分割与实例分割四联图;语义颜色编码类别,实例颜色编码对象 ID。

  • 分类:图中有什么
  • 杯子 · 书
  • 检测:每个对象在哪里
  • 类别 + 框
  • 两只杯子
  • 一册书
  • 语义:每个像素是什么
  • 颜色 = 类别
  • 杯子
  • 书
  • 实例:属于哪一个对象
  • 颜色 = 实例 ID
  • 杯子 #1
  • 杯子 #2
  • 同一底图;框与可见轮廓为教学标注。输出结构不同,所需监督也不同。
同一双杯书本底图的分类、检测、语义分割与实例分割四联图;语义颜色编码类别,实例颜色编码对象 ID。 查看对应图解状态
查看完整图解

课堂讲述

把同一组杯子和书换成书本遮住部分杯身的场景。下面四种答案都用这张固定底图。 先别急着看网络。请看我们要交付什么答案。分类只需报告图中有什么;检测要对多个对象给出类别和位置;语义分割要给每个像素指定类别;实例分割还要区分这些像素分别属于哪一个对象。 如果两只杯子紧挨着,语义分割可以都标成“杯子”,但这还没有告诉我们哪部分属于左边那只、哪部分属于右边那只。检测框区分了两个对象,却没有给出杯柄的精确轮廓。 所以这几类任务不是精度高低的一条刻度。它们要求不同的输出结构,也要求不同的标注和错误检查。接下来每改一次方法,都先回到这张图:这次究竟增加了哪一种要求?

同一场景中,究竟多交付了什么信息?

独立阅读

在这张双杯与书的图里,分类的答案可以写成“有杯子、有书”;这两个词没有给出杯子数量,也没有把词语放到图中的位置。检测把答案改成一组对象记录,每项有类别、分数与框。语义分割交付与图像对应的类别地图;实例分割再保存每个对象的身份。

输出 双杯场景中的一项答案 做不到的逆推
类别存在性 杯子、书 仅凭类别列表不能恢复左右杯位置
检测 杯子 #1 的矩形框 外接框不能恢复杯把空洞
语义类别图 这个像素是杯子 同类颜色不记录杯一与杯二的分界
实例图 这个像素属于杯子 #1 可见轮廓不定义被书遮住的完整背面

可以把实例 ID 映射为类别,得到语义图;反过来一般没有唯一答案。两只紧挨杯子的许多实例划分,都可能对应同一张“杯子”类别图。因此四种输出不是一条从粗糙到高级的单轴刻度,而是为不同用途保存不同信息。做面积测量需要像素集合,做计数需要对象身份,快速提示操作者位置可能只需要框。

本页轮廓与框是同一底图上的教学标注,帮助定义答案;它们不是模型预测。LAB03 可以直接改变选中对象并查看局部窗口,LAB10 和 LAB11 才分别提供学习得到的框与像素输出。

图示条件与公式约定

同一底图与原有手工标注;语义颜色编码类别,实例颜色编码实例 ID。仅标可见轮廓,不预测被书遮住的杯子部分。

这条线索的展开与后续阅读

区域、像素与实例任务究竟要求留下什么信息?

先辨认空间地址,再读取通道

解释、算例与证据

P26 · 位置还在特征图里吗?

把特征图读成“空间地址+通道向量”。步长不是感受野,通道也不是预先指定的类别;池化前是否保留网格,是把分类表示迁到空间任务时的关键接口选择。与 P44 的均值碰撞配读,可以避免凭张量大小断言信息是否存在。

Lecture 03 课堂图解 P26图像中的位置空间特征 F保留网格 → 定位 / 像素全局汇总 → 整图向量空间位置与通道共同承载信息;示意格值不对应某个训练模型的激活。

两只杯子的位置从图像对应到空间特征;保留网格与全局向量两条出口。

  • 图像中的位置
  • 空间特征 F
  • 保留网格 → 定位 / 像素
  • 全局汇总 → 整图向量
  • 空间位置与通道共同承载信息;示意格值不对应某个训练模型的激活。
两只杯子的位置从图像对应到空间特征;保留网格与全局向量两条出口。 查看对应图解状态
查看完整图解

课堂讲述

分类网络中间通常不是一直只有一个向量,它会保留有空间布局的特征图。不同位置的向量描述相应区域及其上下文,再经过后续处理形成整图答案。 如果任务要找位置,就不能只盯着最终类别分数。我们要考虑在什么层读取特征、保留什么空间结构,再怎样组织预测。这里空间位置和通道共同承载信息,并不是每一个通道都被指定成一个物体类别。 这一点把第二讲的网络结构,变成了今天的任务设计问题:相同的骨干计算可以被复用,但输出要求不同,读取位置和预测部分就不能原样照搬。先看一个最直接的思路:把整张图的问题拆成候选区域的问题。

特征图上的地址、通道与感受野

独立阅读

设骨干网络给出 F∈RC×H′×W′F\in\mathbb R^{C\times H'\times W'}。选定一个网格位置 (u,v)(u,v),得到的是一个 C 维向量 F[:,u,v]F[:,u,v]。网格索引保留“从哪里读”,通道则保存学到的多种响应。某个通道可能对边缘、纹理或更复杂组合敏感,但我们通常没有事先把第 17 通道指定为“杯子”。

步长说明相邻特征位置相对原图的间隔,感受野说明该位置可以受多大输入区域影响,两者不同。步长 16 的特征点可能受比 16×16 更大的区域影响。图上画一个格子对应杯沿,只是在标读取位置,不能理解成这个向量只看了那一个小方块。

全局平均池化沿空间求均值,使分类头方便读取整图统计;若任务要定位,我们常在池化前读取网格。也不能只凭“一个向量”断言全部位置必丢:通道可能编码位置统计。P44 的反例之所以能证明无法区分,是它明确规定了编码器只取均值,而不是因为它长得像粗网格。

这给迁移增加一个具体选择:除决定冻结多少层,还要决定在何处取表示,以及输出头能否访问位置。

沿这个问题继续

先读本页解释与图,再到 LAB03 · 空间信息:表示、采样与掩码 改一个坐标或对象。

出处:FCN (2015)

图示条件与公式约定

特征图颜色为结构示意,不是模型激活。最终全局向量可能保存某些位置统计,此页不声称全局汇总后一定失去所有位置。

多个区域怎样复用同一份视觉计算?

从逐区域编码到共享整图特征,哪些计算被保留,哪些接口必须重建?

区域、像素与实例多个区域怎样复用同一份视觉计算?

让预训练网络读取一个区域

解释、算例与证据

P27 · R-CNN:让已经会看图的网络看一个区域

历史上 R-CNN 将监督分类预训练用于区域检测,支持了“先学表示,再适配新任务”的正面判断。按区域提取特征、学习前景/背景和位置修正三个动作都需要具体输入。它不是 MoCo 或 MAE 的历史后继。

Lecture 03 课堂图解 P27候选区域 → 裁出并缩放红杯候选预训练 CNNImageNet 分类权重区域类别:杯子位置:相对框修正Girshick · Donahue · Darrell · Malik迁移参数,还要学习检测任务R-CNN · 2013 预印本 / CVPR 2014。课堂顺序不是历史发生顺序。

同一场景的候选框、红杯裁剪、ImageNet 预训练 CNN 与区域类别和框修正。

  • 候选区域 → 裁出并缩放
  • 红杯候选
  • 预训练 CNN
  • ImageNet 分类权重
  • 区域类别:杯子
  • 位置:相对框修正
  • Girshick · Donahue · Darrell · Malik
  • 迁移参数,还要学习检测任务
  • R-CNN · 2013 预印本 / CVPR 2014。课堂顺序不是历史发生顺序。
同一场景的候选框、红杯裁剪、ImageNet 预训练 CNN 与区域类别和框修正。 查看对应图解状态
查看完整图解

课堂讲述

R-CNN 的重要启发,是把分类预训练得到的视觉计算用于检测。先提出一批可能包含物体的区域,把区域裁出来,送进网络,再判断类别和位置。 这里迁移的是视觉网络及其参数,不是 ImageNet 原来的答案列表。它还要面向检测作适配,学习前景、背景以及定位任务。这个结果让“在大数据上先学,再用到别的任务”成为很具体的做法。 原始 R-CNN 是 Ross Girshick、Jeff Donahue、Trevor Darrell 和 Jitendra Malik 的工作。今天我们从自监督接到它,是在整理表示与任务的关系;它本来的重要背景是分类预训练,不要把历史改写成它先使用了 MoCo 或 MAE。

R-CNN 迁移的是已学会的视觉计算

独立阅读

R-CNN 先产生可能包含对象的区域,将每个区域变换为 CNN 接受的图像大小,再用 CNN 特征作区域分类与框修正。分类预训练提供的是卷积网络的参数;检测适配需要新的区域样本、前景/背景关系和位置目标。原始实现包含多个训练阶段,因此课堂画面中简洁的两项输出,不应被误读成原论文从一开始就是一个统一损失的端到端系统。

为什么把区域当作一张小图很有力量?因为原来“整图里有什么”的视觉计算,现在可在许多局部窗口上复用。杯子只占整图一小部分时,候选区域让它占据输入的大部分,分类网络就能在更合适的尺度查看它。代价是裁剪、缩放与逐区域计算;区域边缘的上下文也会改变。

原论文摘要报告 VOC 2012 检测 mAP 为 53.3%,相对之前最好结果提高超过 30%。这个同期结果支持“分类预训练与检测适配能够产生有竞争力的检测器”,不是自监督预训练的实验。作者是 Girshick、Donahue、Darrell、Malik;此处从 MoCo/MAE 接到 R-CNN,是课程按问题重组,不能反写历史先后。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:这里为什么又用了有标签的预训练?

教师:可迁移不是自监督专属。我们比较了学习信号,现在看已成立的监督迁移案例;逻辑连接不要求伪造历史先后。

沿这个问题继续

沿 CLS07 的公式定位疑问,再选 LAB09 解析练习或 LAB10 完整训练。

出处:R-CNN (2014)

图示条件与公式约定

原始 R-CNN 使用监督分类预训练,并进行检测适配;不将教学叙述顺序误写成自监督方法的历史后继。此图省略原始多阶段训练实现。

这条线索的展开与后续阅读

区域、像素与实例多个区域怎样复用同一份视觉计算?

先检查候选有没有覆盖对象

解释、算例与证据

P28 · 候选区域不是已经识别出的物体

候选集合应覆盖对象,但其中可以有局部、背景与多对象框。先看漏掉对象是候选完全没有覆盖,还是后级没有选中;两种失败需要不同改动。训练分配与评价匹配的规则留在下方算例,不把 proposal 当已识别对象。

Lecture 03 课堂图解 P28候选 = 值得进一步检查的区域完整目标希望被覆盖半只杯子 / 背景仍需筛选两个对象共同框仍需拆分与修正

完整杯子、半只杯子、背景和两杯共同框四种候选叠加于同一图片。

  • 候选 = 值得进一步检查的区域
  • 完整目标
  • 希望被覆盖
  • 半只杯子 / 背景
  • 仍需筛选
  • 两个对象共同框
  • 仍需拆分与修正
完整杯子、半只杯子、背景和两杯共同框四种候选叠加于同一图片。 查看对应图解状态
查看完整图解

课堂讲述

为什么先产生很多候选?因为直接在所有位置和大小上寻找对象,搜索空间很大。候选阶段先尽量把真目标覆盖住,后续再筛选与修正。 所以 proposal 不是最终物体答案。这个框只含半只杯子,那个框主要是桌面,还有一个框同时包住两个对象;它们都可能进入候选集合。我们希望候选不要漏掉真对象,却不能因为候选很多就说检测很好。 训练也因此多了新内容:哪些区域算前景,哪些算背景,怎样与人工标注的目标对应。这里先抓住任务分工,不逐条展开所有阈值。下一页看这条朴素路线的计算代价:大量相近的区域,究竟重复算了什么?

候选区域先追求覆盖,再由检测头作判断

独立阅读

proposal 的含义是“值得进一步检查的区域”。它可以覆盖完整杯子,也可以只有半只杯子、包含桌面,或把两只杯子一起框住。候选阶段尚未交付最终的类别、数量与精确边界。

设某张图有两只杯子。若候选集合里完全没有接近右杯的框,后面的区域分类再强,也很难在当前流程中找回它。因此可以先看 proposal recall:在某个 IoU 门槛下,有多少真值对象至少被一个候选覆盖。候选很多可能提高这个召回,却增加计算与重复;后续分类和框回归再筛去背景、校正近似位置。

训练时,“这是不是前景”和“它应该往哪移动”也分开。一个背景区域有分类目标,却没有应当回归到某只杯子的唯一位置目标。具体的正负阈值、强制匹配和忽略区间随方法而异;不要把课堂上一组示例阈值视为所有检测器的定义。

可以先在图上指出一只完全漏掉的杯子,再问该改候选覆盖还是区域分类。这个定位比笼统地说“网络不够强”更能指导实验。

沿这个问题继续

沿 CLS07 的公式定位疑问,再选 LAB09 解析练习或 LAB10 完整训练。

出处:R-CNN (2014)

图示条件与公式约定

框是教学候选,不是外部区域方法的实际输出。原始 R-CNN 使用 Selective Search 等候选来源;不把 proposal 当作已识别对象。

区域、像素与实例多个区域怎样复用同一份视觉计算?

把重复卷积移到共享的整图特征

解释、算例与证据

P29 · 许多重叠区域,为什么要重复卷积?

同一个 CNN 权重处理多个裁剪,仍可能重复计算共同像素。整图共享改变的是一次推理的计算组织,与预训练参数迁移分开。共享之后每个区域仍需要自己的坐标和读出;计算重排并不保证与原来的裁剪路线数学等价。

Lecture 03 课堂图解 P29先裁区域:重叠内容反复编码CNNCNN先算全图:再按区域读取预训练复用的是过去学到的参数;这里复用的是当前图片已经算出的特征。

左侧两个重叠红杯候选分别经过 CNN;右侧同一全图一次编码后读取两份区域特征。

  • 先裁区域:重叠内容反复编码
  • CNN
  • CNN
  • 先算全图:再按区域读取
  • 预训练复用的是过去学到的参数;这里复用的是当前图片已经算出的特征。
左侧两个重叠红杯候选分别经过 CNN;右侧同一全图一次编码后读取两份区域特征。 查看对应图解状态
查看完整图解

课堂讲述

看两个相邻候选,它们覆盖的大部分像素相同。如果每个区域分别跑一次卷积,很多共同内容就被反复计算。 于是可以调换组织顺序:先对整张图计算特征,再按区域从特征图中提取表示。这样我们复用的不仅是训练得到的参数,也复用了同一张图的计算结果。 这两种复用不要混在一起。预训练回答“过去学到的知识能否帮助新任务”;共享特征回答“这一张图中哪些计算不必重复”。两个问题合在一起,才能把检测做成可用系统。换顺序后又有新要求:大小不同的区域,怎样得到后续预测器可以处理的表示?

参数复用与一次前向结果的复用

独立阅读

两张重叠裁剪都使用同一个 CNN,已经共享了参数,但仍分别执行卷积。假如它们都包含杯沿和桌面,这些像素会参与两次运算。SPP-net 和 Fast R-CNN 的路线把较重的卷积移到整图:先计算 F=fθ(I)F=f_\theta(I),每个候选再用自己的框 bib_i 读取 ri=R(F,bi)r_i=R(F,b_i)。

这里有两种复用。预训练让新的任务借用过去学到的参数;整图共享则让同一次推理中的多个区域借用已算出的中间结果。前者减少从头学习的需要,后者减少重复工作,不能用同一个“迁移”概念含糊带过。

若有 N 个候选,逐区域成本近似为 N 次卷积加区域预测;共享方式近似为一次整图卷积加 N 次轻量读取与预测。这是计算组织的估算,不是实测加速倍数,因为整图与裁剪的分辨率不同,内存、候选产生和预测头也占时间。

先裁再编码与先编码再读取不严格相等:前者改变对象尺度并裁去上下文;后者的感受野可能跨出 RoI。方法的贡献是在这样的取舍下找到能训练、有效率的共享接口。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:两个框共用同一 CNN,不是已经共享了吗?

教师:已经共享参数,仍可能分别计算。此页进一步复用同一张图已经得到的特征结果,这两种共享发生在不同层面。

沿这个问题继续

沿 CLS07 的公式定位疑问,再选 LAB09 解析练习或 LAB10 完整训练。

图示条件与公式约定

先裁图再编码与先编码再读区域不严格等价:上下文与几何变换不同。此处比较计算组织,不提供未测加速倍数。

这条线索的展开与后续阅读

区域、像素与实例多个区域怎样复用同一份视觉计算?

从同一矩阵读出两份 2×2 结果

解释、算例与证据

P30 · 不同大小的区域,怎样读成固定结构?

照着 6×8 矩阵实际取两个区域的 2×2 最大值,确认固定输出形状不等于相同内容。SPP 的不同分格层保存不同相对布局。当前整数例故意避开边界量化,P41 再解释真实连续区域的难点。

Lecture 03 课堂图解 P30不同大小的 RoI · 每格取最大值01201210123124310252354213410261012013420010012021432534固定 2 × 2 布局各格汇总自身区域位置是相对的区域范围仍需保留SPP-net 也可以组合多种分格尺度1×1 · 2×2 · 3×3(分格示意)

6×8 可核对数值矩阵上的两个 RoI,各按 2×2 分箱取最大值;下方显示多层空间分格。

  • 不同大小的 RoI · 每格取最大值
  • 0
  • 1
  • 2
  • 0
  • 1
  • 2
  • 1
  • 0
  • 1
  • 2
  • 3
  • 1
  • 2
  • 4
  • 3
  • 1
  • 0
  • 2
  • 5
  • 2
  • 3
  • 5
  • 4
  • 2
  • 1
  • 3
  • 4
  • 1
  • 0
  • 2
  • 6
  • 1
  • 0
  • 1
  • 2
  • 0
  • 1
  • 3
  • 4
  • 2
  • 0
  • 0
  • 1
  • 0
  • 0
  • 1
  • 2
  • 0
  • 2
  • 1
  • 4
  • 3
  • 2
  • 5
  • 3
  • 4
  • 固定 2 × 2 布局
  • 各格汇总自身区域
  • 位置是相对的
  • 区域范围仍需保留
  • SPP-net 也可以组合多种分格尺度
  • 1×1 · 2×2 · 3×3(分格示意)
6×8 可核对数值矩阵上的两个 RoI,各按 2×2 分箱取最大值;下方显示多层空间分格。 查看对应图解状态
查看完整图解

课堂讲述

SPP-net 等工作让区域读取成为明确的计算模块。区域可以大,也可以小,但可以按相对位置划分成固定数量的格子,在每格汇总特征,得到固定结构的输出。 这不是把不同物体强行说成一样大,而是在为后面的预测器提供统一接口。后续仍然需要知道区域来自哪里,并预测它的类别或位置。 这里有一个值得保留的研究积累:空间聚合并不是深度学习时代凭空出现的主意,新的卷积特征让原有的空间组织经验获得了新用途。需要注意,先裁图再编码和先编码再取区域并不严格相同,它们看到的上下文和几何变换不同;共享计算是取舍,不是无条件等价变形。

同样是 2×2 输出,读到的内容可以不同

独立阅读

区域大小不一,后面的固定形状预测头却希望得到一致长度的输入。把每个区域按相对位置分成 2×2 四格,再对每格取最大值,就能对每个通道得到四个数。若有 C 个通道,输出是 C×2×2,而非一律变成四个类别。

本页 6×8 教学矩阵提供两个整齐对齐的 RoI。橙色区域选择前两行末四列,四格最大值为 [[2,1],[4,3]];青色区域选择第 2–5 行前四列,读出 [[2,5],[3,4]]。两份结果有相同形状,数值不同,且各自仍与原来的框配对。

空间金字塔进一步使用 1×1、2×2 等多个分格层。1×1 捕捉整区域统计,2×2 保留相对位置;把结果拼接后,原区域有多大都能得到固定长度。这里统一的是接口,不是抹掉区域之间的差异。

本页特意用整数边界,先隔离“大小不同却可用统一头”的想法。真实 RoI 边界不总落在格点;分箱取整带来的位置偏差,到 P41–43 再处理。

沿这个问题继续

先读本页解释与图,再到 LAB03 改一个坐标或对象。

图示条件与公式约定

F 是 6×8 教学矩阵。橙色 RoI 取前两行末四列,按每格最大值产生 [[2,1],[4,3]];青色 RoI 取第2–5行前四列,产生 [[2,5],[3,4]]。这是整齐对齐的简化分格,不模拟历史库的边界取整。

类别与位置怎样成为可学习的区域目标?

候选、训练匹配和框偏移分别承担哪一步?

区域、像素与实例类别与位置怎样成为可学习的区域目标?

让多个区域共同训练共享骨干

解释、算例与证据

P31 · Fast R-CNN:把区域放回共享计算中

Fast R-CNN 的改动包括共享卷积、区域读取和类别/位置反馈共同训练。图上的多个区域仍各有答案,合并的是可共用计算。先指出损失从哪里回到同一骨干,再理解为什么外部候选成为下一项瓶颈。

Lecture 03 课堂图解 P31共享卷积特征RoI Pool类别框修正类别框修正两项任务反馈到共享骨干

整图特征、两个不同位置的 RoI Pool、各自类别及框输出;第二状态显示任务反馈到共享骨干的路径。

  • 共享卷积特征
  • RoI Pool
  • 类别
  • 框修正
  • 类别
  • 框修正
  • 两项任务反馈到共享骨干
整图特征、两个不同位置的 RoI Pool、各自类别及框输出;第二状态显示任务反馈到共享骨干的路径。 查看对应图解状态
查看完整图解

课堂讲述

Fast R-CNN 把整图特征、区域读取以及类别和框回归组织在同一个较紧凑的训练流程里。图片主要计算一次,候选区域在共享特征上读取,然后各自产生预测。 学生容易只记住“更快”两个字。真正应该看到的是:系统把原来重复的计算搬到了共同部分,同时让区域任务的反馈回到共享表示。训练怎样组织,和速度怎样改善,在这里是连在一起的。 但此时的候选区域仍然需要产生。当前面主要计算变得更高效,原来相对不显眼的步骤就可能变成新的瓶颈。接下来研究者问的不是再给这个网络起一个更快的名字,而是:候选本身能不能也从共享特征中学出来?

共享特征怎样收到每个区域的训练反馈

独立阅读

从整图特征取到每个 RoI 后,分类分支判断类别或背景,框分支预测相对位置修正。设某个区域属于杯子,损失一部分来自“杯子”概率是否足够大,另一部分来自中心、宽高偏移是否接近匹配目标。背景区域参与分类,通常不承担指向某个对象的位置回归。

把一批区域的损失相加后,梯度沿各自的区域读出回到共享骨干。共享的参数会收到来自不同区域、不同任务的反馈;它并不要求所有区域有相同答案。正如同一把尺子测不同物体可以得到不同长度,同一个预测器处理不同区域特征也会给出不同结果。

Fast R-CNN 保留了外部候选来源,但把共享卷积、RoI 读取、分类和框回归组织进更紧凑的训练流程。卷积不再为每个重叠区域重复做,候选提取的时间便更加突出。下一步自然不是继续增加分类头,而是让候选也从这张 F 中学习。

理解这一页时,能够在图上指出“两个区域各自的输出”和“同一个被共同更新的骨干”,就已经抓住它的机制。历史多阶段实现细节与训练采样放在 CLS07,而不加回主讲页。

沿这个问题继续

沿 CLS07 的公式定位疑问,再选 LAB09 解析练习或 LAB10 完整训练。

图示条件与公式约定

主图展示共享特征、区域读出及类别/回归的联合训练思想,候选仍来自外部方法。反馈线表示总损失更新共享计算,不表示多个区域同一个答案。

区域、像素与实例类别与位置怎样成为可学习的区域目标?

分开参考框、候选框与最终检测框

解释、算例与证据

P32 · Faster R-CNN:让候选区域也成为预测

按“参考框→RPN 候选→最终框”给图中的矩形分配身份,并把人工真值单独留在监督侧。RPN 让候选变为可学习预测。LAB10 采用共享原理的一阶段教学变体,不应把它说成原版 Faster R-CNN。

Lecture 03 课堂图解 P32共享 FRPN前景分数 + 框偏移区域读出分类 + 最终框修正候选框 → 供后级使用参考框参考几何 → 预测候选 → 最终检测框

共享 F 分为 RPN 和区域预测;RPN 产生候选并供后级使用,参考框与偏移后的候选用不同颜色表示。

  • 共享 F
  • RPN
  • 前景分数 + 框偏移
  • 区域读出
  • 分类 + 最终框修正
  • 候选框 → 供后级使用
  • 参考框
  • 参考几何 → 预测候选 → 最终检测框
共享 F 分为 RPN 和区域预测;RPN 产生候选并供后级使用,参考框与偏移后的候选用不同颜色表示。 查看对应图解状态
查看完整图解

课堂讲述

Faster R-CNN 增加了区域建议网络,也就是 RPN。它在共享特征上判断一些参考框是否像前景,并预测位置修正,形成后面使用的候选。 请区分图上的三个对象:参考框是我们提供的几何起点,候选框是这一步的预测,最终检测框是后续处理后的结果。训练时,还要根据真实标注定义哪些参考框负责哪些对象。 至此,从外部产生区域、反复编码区域,到共享卷积、再学习候选,瓶颈被一段段重新组织。这条路线有跨团队与合作者的汇合,不能把原始 R-CNN、SPP-net 和 Faster R-CNN 都归给一个人。它们相连的是具体问题与可复用的计算。

参考框、候选框与最终检测框

独立阅读

RPN 在共享特征图上铺一组参考框。参考框由网格位置、预设尺度和长宽比决定;它们在看图之前就可生成,不能当成检测结果。网络为每个参考框输出物体性分数和四个偏移,经解码、筛选后形成 proposals,再交给区域头作更具体的类别判断和位置修正。

因此画面中的三个矩形有不同身份:anchor 是几何起点,proposal 是 RPN 的预测,最终 box 是整个检测流程交付的结果。训练真值是第四种对象,它负责给预测规定目标,并不在推理时送进模型告诉它答案。

同一张 F 可同时供 RPN 与后级区域头使用。它把“在哪里值得再看”从外部算法变成从图像特征学习的任务。这是 Faster R-CNN 与 Fast R-CNN 相比发生改变的具体一段,不能只记一个更快的名字。

LAB10 采用单层锚框直接分类与回归的一阶段教学检测器,不是原版两阶段 RPN。它与本页共享锚框、匹配、位置损失等原理,保留了可运行的学习闭环;读实验时应辨明哪些流程共用、哪些结构不同。

图示条件与公式约定

参考框是几何起点,RPN 输出 objectness 与偏移形成 proposals,后级再预测类别与框。图省略 NMS、采样与正负匹配阈值,它们在补充材料中保留。

这条线索的展开与后续阅读

区域、像素与实例类别与位置怎样成为可学习的区域目标?

给正例、背景和忽略项分配任务

先明确训练分配,才能知道哪一项预测拥有位置目标。

为什么要有正例、背景和忽略项

独立阅读

给定参考框与真值的 IoU 矩阵,匹配规则把参考框变成训练样本。例如课堂教学阈值若设正例至少 0.7、背景小于 0.3,则 IoU 为 0.8、0.4、0.1 的三个框分别是正例、忽略、背景。只有正例有对应的框回归目标。忽略的用途是暂不把模糊覆盖强行当正或负,而不是悄悄改成背景。

真实 LAB10 使用另一组公开写明的阈值:正例至少 0.45,背景低于 0.25,中间忽略;再用逐次最大 IoU 为每个真值保留一个不同 anchor,避免某个对象完全收不到位置监督。强制匹配服务于学习,评价时不能为了“每个对象都匹配一次”照搬这条规则。

空图同样是有效训练输入。所有参考框都应学背景,回归项没有正例便归零。如果只训练总有物体的图片,模型可能从未被要求学会空输出。

负例远多于正例时,本实验选难负例参与分类损失,最多正例数的三倍、每图至少十二个。阅读代码时应看 loss 的掩码与归一化,而不只看 L=Lcls+λLboxL=L_{cls}+\lambda L_{box} 这一行总公式。

区域、像素与实例类别与位置怎样成为可学习的区域目标?

把目标框编码,再原样解码回来

解释、算例与证据

P33 · 位置怎样成为可学习的目标?

把“位置回归”算到四个具体目标:.2、−.1、ln1.2、0;再逆变换回目标框。归一化、坐标格式与尺度因子必须成对。下方匹配说明哪些参考框具有位置目标,背景和忽略项为什么不能照样回归。

Lecture 03 课堂图解 P33参考框与目标框(连续坐标,无 +1)01020304050607080参考 (20,20,60,60)中心 (40,40) · 宽40 · 高40目标 (24,16,72,56)中心 (48,36) · 宽48 · 高40tₓ = (48−40)/40 = 0.2tᵧ = (36−40)/40 = −0.1t_w = ln(48/40) ≈ 0.1823t_h = ln(40/40) = 0本课程坐标算例;展示常见框参数化,不代表所有检测器。

连续坐标网格上的参考框 (20,20,60,60) 与目标框 (24,16,72,56),中心位移和四项回归目标逐项对应。

  • 参考框与目标框(连续坐标,无 +1)
  • 0
  • 10
  • 20
  • 30
  • 40
  • 50
  • 60
  • 70
  • 80
  • 参考 (20,20,60,60)
  • 中心 (40,40) · 宽40 · 高40
  • 目标 (24,16,72,56)
  • 中心 (48,36) · 宽48 · 高40
  • tₓ = (48−40)/40 = 0.2
  • tᵧ = (36−40)/40 = −0.1
  • t_w = ln(48/40) ≈ 0.1823
  • t_h = ln(40/40) = 0
  • 本课程坐标算例;展示常见框参数化,不代表所有检测器。
连续坐标网格上的参考框 (20,20,60,60) 与目标框 (24,16,72,56),中心位移和四项回归目标逐项对应。 查看对应图解状态
查看完整图解

课堂讲述

类别可以用一个标签训练,框的位置怎样训练?先看这两个具体框。参考框中心是四十、四十,宽高都是四十;目标框中心是四十八、三十六,宽变成四十八,高不变。 网络可以学习相对这个起点的修正:中心往右多少、往上多少,宽高怎样改变。横向移动八个单位,相对于原宽度就是零点二;纵向移动负四个单位,相对于原高度就是负零点一。宽高常用比例的对数来表示,完整计算放在说明里。 这页只要把抽象的“回归”落到对象上。网络并不是突然输出一个完美矩形,而是在明确坐标约定和监督目标下学习几何关系。类别正确但位置错误,因而完全可能发生。

框回归的四个数怎样编码与还原

独立阅读

用中心和宽高记参考框 a=(40,40,40,40)a=(40,40,40,40),目标框 g=(48,36,48,40)g=(48,36,48,40)。采用不加额外缩放因子的约定:

tx=(gx−ax)/aw=0.2,ty=(gy−ay)/ah=−0.1, t_x=(g_x-a_x)/a_w=0.2,\quad t_y=(g_y-a_y)/a_h=-0.1, tw=log⁡(gw/aw)=log⁡(1.2)≈0.18232,th=0. t_w=\log(g_w/a_w)=\log(1.2)\approx0.18232,\quad t_h=0.

中心偏移除以参考框宽高,把绝对位移变为相对比例。宽高用对数比值,则放大和缩小可以由正负实数表示;解码通过指数确保宽高为正。将四个数还原:中心 40+40×0.2=4840+40\times0.2=48、40−4=3640-4=36,宽 40elog⁡1.2=4840e^{\log1.2}=48,高 40。

由中心宽高变回连续 xyxy,参考框是 (20,20,60,60),目标是 (24,16,72,56)。这一来一回检查的是坐标约定相容。网络实际输出只是对四个目标数的估计,偏移接近也不代表每个小目标的 IoU 同样好。

有些实现对偏移再乘 10 或 5 等尺度系数;应同时阅读 encode 与 decode。LAB10 的成对函数没有这些额外系数,不能从另一教材复制半套公式混用。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:为什么宽度不用减法,而要用对数?

教师:对数比值描述相对缩放,逆变换指数保证正宽度。它是明确的参数化选择;关键是编码、损失与解码使用同一约定。

沿这个问题继续

沿 CLS07 的公式定位疑问,再选 LAB09 解析练习或 LAB10 完整训练。

按问题回查的讲解与短练习(1)

图示条件与公式约定

使用 xyxy 连续边界,无像素端点 +1。参考宽高40、40,中心40、40;目标宽高48、40,中心48、36。tx=.2、ty=−.1、tw=ln1.2=.1823215568、th=0。解码可精确恢复 (24,16,72,56)。

这条线索的展开与后续阅读

检测分数很高,错误究竟在哪里?

怎样从错误图走到 IoU、排序匹配与已有检测实验?

区域、像素与实例检测分数很高,错误究竟在哪里?

整理重复预测时还没有看到真值

解释、算例与证据

P34 · 三个框,并不代表三只杯子

三个重叠预测可能对应一只杯子。NMS 用预测之间的分数与重叠整理重复,评价匹配则使用真值,二者不是同一操作。先看三框算例,再看同一真实教学检测器放宽 NMS 后召回和精度的相反变化。

Lecture 03 课堂图解 P34保留 A;B、C 与它过度重叠教学分数 / IoU 阈值 0.5A 0.90 保留B 0.80 抑制C 0.60 抑制另一只杯子仍然保留拥挤对象也可能互相压制按同类别分数排序,抑制 IoU > 0.5 的重叠预测;分数是教学设定。

红杯上的 A、B、C 框分数为 0.90、0.80、0.60。IoU(A,B)≈0.90、IoU(A,C)≈0.88;阈值0.5时保留A、抑制B和C。蓝杯独立框与A不重叠,继续保留。

  • 保留 A;B、C 与它过度重叠
  • 教学分数 / IoU 阈值 0.5
  • A 0.90 保留
  • B 0.80 抑制
  • C 0.60 抑制
  • 另一只杯子仍然保留
  • 拥挤对象也可能互相压制
  • 按同类别分数排序,抑制 IoU > 0.5 的重叠预测;分数是教学设定。
红杯上的 A、B、C 框分数为 0.90、0.80、0.60。IoU(A,B)≈0.90、IoU(A,C)≈0.88;阈值0.5时保留A、抑制B和C。蓝杯独立框与A不重叠,继续保留。 查看对应图解状态
查看完整图解

课堂讲述

同一个对象可能被多个候选检测到,于是系统交付了多个重叠框。不能把这些框直接解释成多个物体。 常见的处理是先保留高分框,再抑制与它过度重叠的重复预测,这就是非极大值抑制的基本直觉。它不是重新训练表示,而是在整理已经产生的候选结果。 现在指着图里的 C:它也围着红杯,与 A 的 IoU 约为 0.88,所以阈值 0.5 时同样去掉;右边蓝杯的框是另一个对象,不是这里的 C。 如果两个真实对象非常靠近,过强的抑制也可能误删目标。于是检测效果不是只由骨干网络决定,候选、类别分数、位置和后处理都会影响交付。我们不在这里比较所有 NMS 变体,只看清一个系统事实:怎样组织输出,也是方法的一部分。

NMS 不看真值,评价匹配必须看真值

独立阅读

NMS 从预测框中整理重复。按类别与分数排序,保留最高分框 A,再抑制与 A 的 IoU 大于阈值的同类低分框,然后继续。输入只有预测框、分数和类别,不需要人工真值。

回到 P34 同一杯子上的三个框。A、B、C 的教学分数分别为 0.90、0.80、0.60;IoU(A,B)≈0.90,IoU(A,C)≈0.88。按分数先保留 A,在 NMS 阈值为 0.5 时,B 和 C 都与 A 过度重叠,因此都被抑制。蓝杯的另一个框与 A 不重叠,仍然保留。这里比较的是预测框彼此之间的重叠,还没有使用真值。

若把阈值放宽到 0.90,在本例原始坐标下,IoU(A,B)=0.8950778、IoU(A,C)=0.8774870,都没有超过阈值;重复框便可能继续留下。因此判定应使用未四舍五入的 IoU,图中 0.90 只是显示精度。下一步评价才用真值判断它们是在补漏检还是重复命中。

若两只真实杯子互相遮挡,两个正确框也可能高度重叠。将 (0,0,2,2) 与 (.5,0,2.5,2) 当作两只对象的框,交集 3、并集 5,IoU=.6;NMS=.5 就可能删掉较低分的真对象。它以几何重叠近似重复,没有直接知道对象身份。

评价再用保留下来的框与人工对象对应。重复命中同一真值只允许一次计为 TP,其余是 FP;漏掉的对象降低 recall。模型预测、后处理、评价三层分开,就能解释为什么“放宽 NMS 得到更多框”既可能补召回,也可能伤精度。

图示条件与公式约定

分数为教学设定。A=(177,238,390,351)、B=(190,246,390,351)、C=(161,252,410,352),此处框写作 xywh;IoU(A,B)=.8950778368≈.90,IoU(A,C)=.8774869809≈.88。同类 greedy NMS,阈值.5。没有报告模型或论文性能。

这条线索的展开与后续阅读

区域、像素与实例检测分数很高,错误究竟在哪里?

在同一场景里辨认四类检测错误

解释、算例与证据

P35 · 检测错在哪里,要分开看

从错类、漏检、框偏和重复四项错误读结果。IoU 把位置偏差变成可比较几何量,AP 再加入分数排序与对象唯一匹配。沿下方积分例走完分数排序、精确率与召回率计算,再用 LAB10 的结果辨认这些错误。

Lecture 03 课堂图解 P35漏检没有报告蓝杯错类别红杯 → “花瓶”偏位重复面积各 4 · 交集 2IoU = 2 / (4 + 4 − 2) = 1/3类别分数高,不会自动修正位置检测错误要分开检查;完整匹配、阈值和 AP 协议在补充阅读。
漏检
真值对象没有得到匹配的预测,召回会降低。
错类别
框覆盖对象,但类别不符,不能当作正确检测。
框偏位
类别对了,位置仍可能过不了 IoU 阈值。
重复预测
一个真值最多匹配一次;后来的重复框计作假阳性。

IoU 算例:两个框面积各为4,交集为2;并集=4+4−2=6,IoU=2/6=1/3。类别分数高不会自动修正位置。

同一场景的四种检测错误,以及面积各 4、交集 2 的框对,算得 IoU=1/3。 查看对应图解状态
查看完整图解

课堂讲述

现在检验系统,不能只问它有没有认出“杯子”。这个结果漏了一只,那个类别错了,这个位置偏了,另一个把同一只报了两次。这些错误需要分别观察。 位置常用交并比描述:相交面积除以覆盖的总面积。例子中两个框面积都是四,交集为二,交并比就是三分之一。类别分数高,不会自动把这个位置变得准确。 完整评价还要说明预测怎样与真值匹配,怎样处理重复和阈值。今天不手推整套 AP,但要留下这项判断:当你说某个预训练表示改善了检测,必须知道改善体现在哪种任务错误,而不只看一列总分。这也为接下来的像素任务准备了不同的检查方式。

图示条件与公式约定

IoU 面积算例使用两个 2×2 连续方框,横向错开1,交集2、并集6,IoU=1/3。四种错误是教学构造,不是本轮推理。

这条线索的展开与后续阅读

区域、像素与实例检测分数很高,错误究竟在哪里?

同样偏移一个单位,为什么小框损失更大?

从框偏这一类错误开始,把交集、并集和对象尺度放进同一计算。

同样移动一个单位,小框为什么更吃亏

独立阅读

两个面积均为 4 的框,交集为 2,并集为 4+4−2=64+4-2=6,所以 IoU=1/3,而不是 1/2。分母必须是覆盖总面积,不能只用真值面积。连续坐标的宽写作 x2−x1x_2-x_1,不要混入“整数像素含两端”的加一规则。

把两个同样大小的正方形横向错开 d,边长为 w 且 0≤d<w0\le d<w。交集面积 (w−d)w(w-d)w,并集 (w+d)w(w+d)w,于是 IoU=(w−d)/(w+d)(w-d)/(w+d)。错开一个单位时,边长 10 的框 IoU=9/11,边长 2 的框却只有 1/3。绝对坐标误差相同,几何质量不同。

检测检查还要分清错类、漏检、框偏和重复。分数只说明模型的相对确信程度,不能直接把偏掉的框变准。若同一模型 AP50 很好而 AP75 明显下降,说明它能覆盖不少对象,但更严格位置要求暴露了问题;还应查看具体预测,才能知道误差来自偏移、大小还是同类拥挤。

区域、像素与实例检测分数很高,错误究竟在哪里?

沿三个预测算出 AP=5/6

位置是否合格只是一步;按分数处理预测时还要为对象保留唯一匹配。

三个预测怎样变成 AP=5/6

独立阅读

固定一个类别、一张图里两个真值对象,IoU 合格门槛为 .5。三个预测按分数递减处理,身份依次是“命中对象 A”“重复命中 A”“命中 B”。同一真值不能用两次,因此 TP/FP 序列是 TP、FP、TP。

已处理预测数 累计 TP 累计 FP precision recall
1 1 0 1 1/2
2 1 1 1/2 1/2
3 2 1 2/3 1

采用本课程实验的 all-points precision-envelope 积分:从右向左取后续 precision 的最大值,于是包络为 1、2/3、2/3。recall 只有两次增加,各增加 1/2,所以 AP=(1/2)×1+(1/2)×(2/3)=5/6(1/2)\times1+(1/2)\times(2/3)=5/6。把第二项重复框排到最后,先后成为 TP、TP、FP,包络积分会变为 1;这说明分数排序有实际意义。

这里的 AP 是指定 IoU 下的一类积分;LAB10 对两个前景类分别算,再平均,分别报告 AP50 与 AP75。COCO 还有不同 IoU、recall 采样和面积等约定,不能给这个小算例贴“COCO AP”的名称。LAB09 提供与代码一致的匹配规则,遇到一个预测接近多个真值时,要按该实现的最大 IoU 对应顺序判断。

区域、像素与实例检测分数很高,错误究竟在哪里?

进入 LAB10:先读失败图,再解释高分

把错误分类、IoU 和 AP 带回已保存的图像到框学习记录。

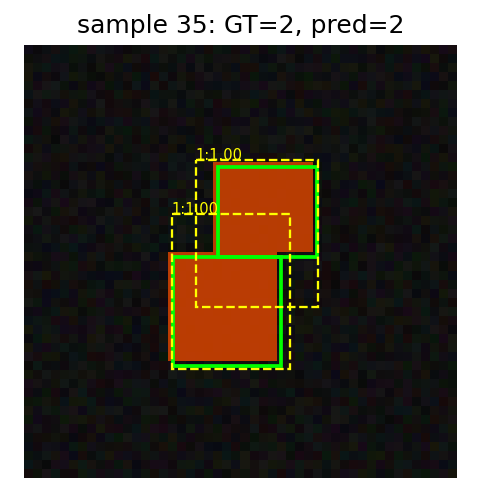
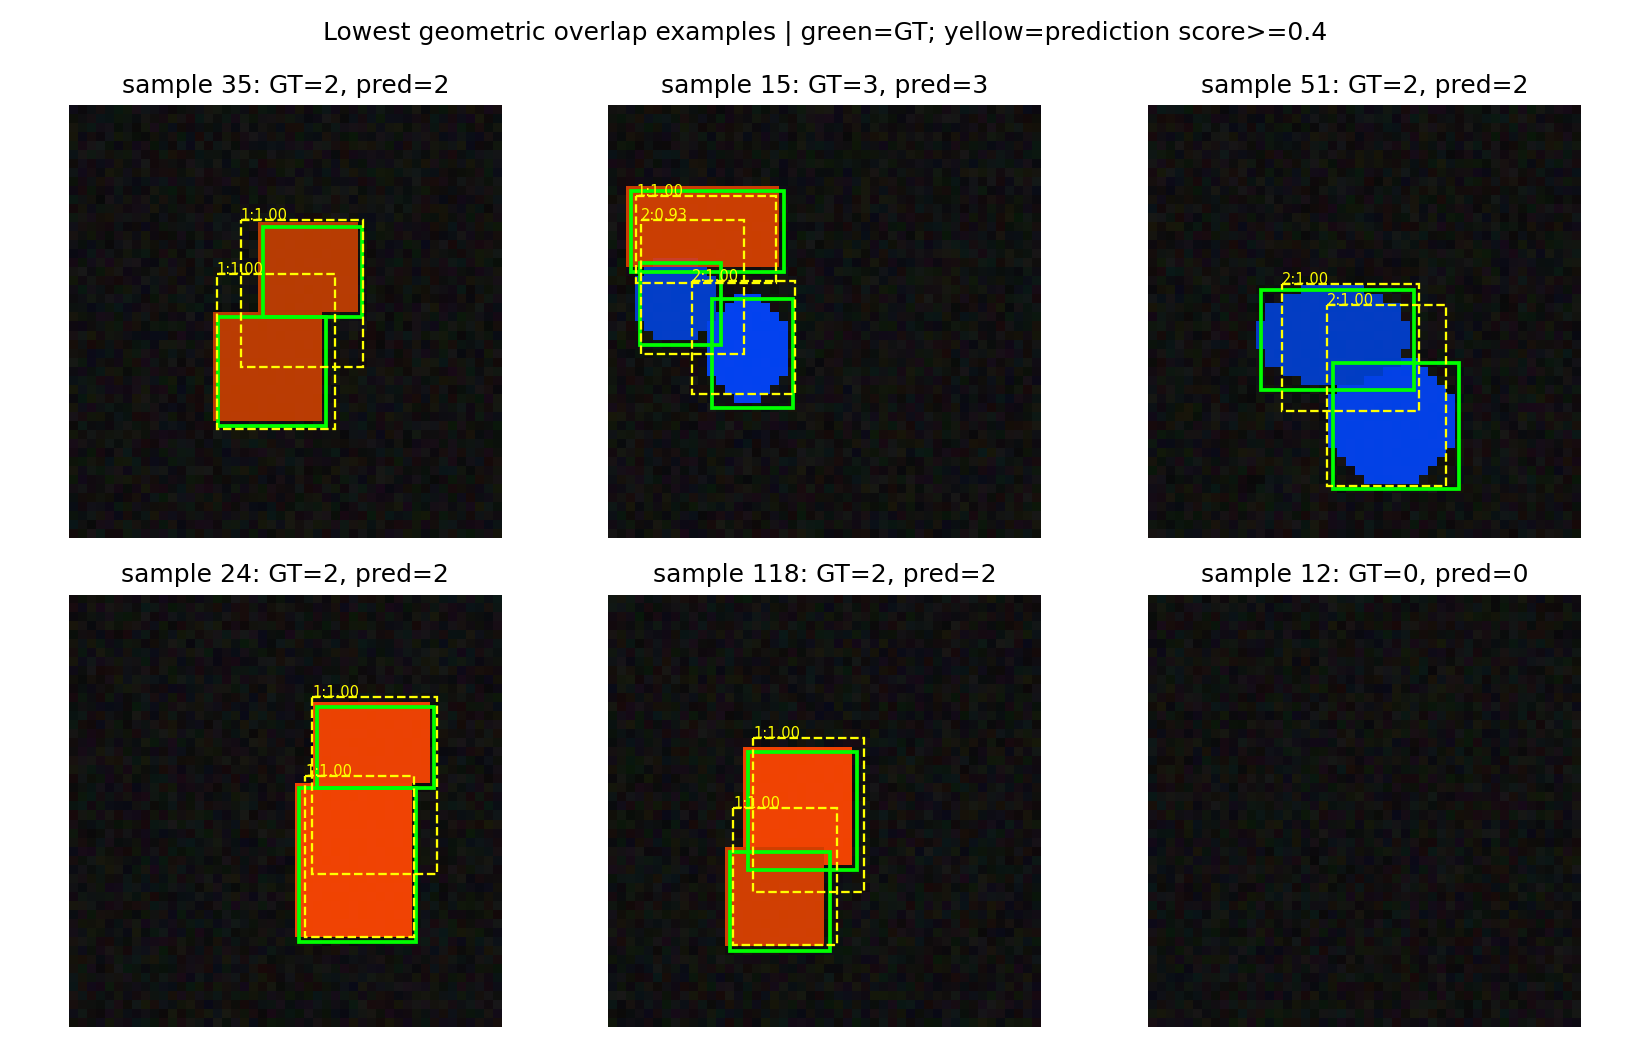
LAB10 原失败图的样本35完整面板,绿色为真值,黄色为分数至少0.4的预测
已有实验记录的样本35面板:绿色框为真值,黄色框为分数至少0.4的预测。样本35的真值与预测各有两个框,但边界没有正确对应两个相邻对象。样本按几何失败选取,不能代表全部样本的错误比例。查看完整失败图

从 RGB 到框:当前 LAB10 已经具备完整闭环

独立阅读

当前 LAB10 的主实验输入是真正的 48×48 RGB 合成图,目标是零至三个对象的类别与归一化框。卷积骨干生成 12×12 网格,每格两个参考框,共 288 个;两个头输出 [B,288,3] 类别 logits 与 [B,288,4] 偏移。图像进入 model(images),坐标只参与监督与评价。

保留的 2026-09-22 本地完整运行用 768 张训练图、96 张验证图、192 张保留图,训练 28 epoch。它以 TinySSD 的锚框检测闭环为起点,采用单特征层、两种参考尺度,不能称为 D2L 全部多尺度结构的复现。

条件 AP50 AP75
随机初始化 .00746 .00003
训练后原尺度 .97303 .70367
同权重,仅对象尺寸减半 .61490 .17987

这些是已有运行记录,本轮内容整理没有重跑实验。原分布明显改善,且存在多对象与空图,支持“模型学习到了图像到对象位置的映射”。更严格位置门槛与小尺度条件仍显著下降,帮助定位下一步研究问题。红色与矩形、蓝色与椭圆相关,因此不能据此宣称自然图像泛化。

读者可先看同一行的 RGB、真值框、预测框和失败图,再看匹配与损失,最后按需运行。原四维逻辑回归保留在热身位置,它说明分类更新,不承担检测证据。

区域、像素与实例检测分数很高,错误究竟在哪里?

只改变 NMS,检查新增框究竟是什么

已有模型让我们能够固定输入与权重,只检查后处理带来的取舍。

同一检测器改变 NMS,召回为何变好而精度变差

独立阅读

LAB10 已保存一组更接近真实使用的对照:输入与训练后权重保持不变,只把 NMS IoU 阈值从 .35 放宽到 .65。展示/工作点的分数门槛固定 .4。

NMS IoU recall@工作点 precision@工作点 AP50
.35 .98311 .94175 .97303
.65 1.00000 .41926 .95866

放宽后,一些原来被抑制的候选重新出现,补到了最后少数对象;同时大量同一对象的重复框留在输出,所以 precision 大降。AP 的变化比这个固定工作点的 precision 小,因为 AP 汇总整个分数排序,而工作点只看分数至少 .4 的输出。

这组已有本地结果不是本轮新运行。它的价值是把 P34 的两种效应落实到同一模型:预测数量增加本身没有确定好坏,必须看新增的是哪个对象、是否重复,以及部署时怎样使用阈值。选阈值应使用验证集与任务成本;不能反复挑保留集最漂亮的数字再称泛化结果。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:为什么同一杯子上的 C 也要抑制,而蓝杯的框保留?

教师:C 围着红杯,与 A 的 IoU 约为0.88,超过0.5。蓝杯框是另一个框,与A不重叠,所以这轮保留。若把阈值提高到0.90,要用原始IoU计算,不能拿显示成0.90的近似数作严格大于判断。

沿这个问题继续

沿 CLS07 的公式定位疑问,再选 LAB09 解析练习或 LAB10 完整训练。

按问题回查的讲解与短练习(1)

怎样直接学习一张像素类别地图?

从区域对象集合转向逐像素目标,监督和指标如何对应?

区域、像素与实例怎样直接学习一张像素类别地图?

另起像素路线:整图直接预测类别地图

解释、算例与证据

P36 · FCN:另一条路线,直接为像素作预测

FCN 从逐像素类别图出发,独立于区域检测路线。将 [B,C,H,W] logits 与 [B,H,W] 标签一一对应,理解分割损失和 ignore 像素。LAB11 从图像预测 mask;已知 mask 的缩放练习只检验采样,不检验视觉预测。

Lecture 03 课堂图解 P36区域路线与像素路线,目标不同R-CNN → Fast → Faster一组对象:类别 + 框FCN · 每位置类别分数语义类别地图Long · Shelhamer · Darrell,2014 预印本 / CVPR 2015FCN 是密集像素预测路线,不是 Faster R-CNN 的下一代。

区域检测路线与 FCN 像素路线分开;全图到空间特征再到语义 mask,署名 Long、Shelhamer、Darrell。

  • 区域路线与像素路线,目标不同
  • R-CNN → Fast → Faster
  • 一组对象:类别 + 框
  • FCN · 每位置类别分数
  • 语义类别地图
  • Long · Shelhamer · Darrell,2014 预印本 / CVPR 2015
  • FCN 是密集像素预测路线,不是 Faster R-CNN 的下一代。
区域检测路线与 FCN 像素路线分开;全图到空间特征再到语义 mask,署名 Long、Shelhamer、Darrell。 查看对应图解状态
查看完整图解

课堂讲述

前面以区域为单位组织检测。另一个问题是:能不能直接为整张图上的每个位置给出类别?这就是语义分割的像素预测路线。 FCN 把分类网络中的计算改造成适合密集输出的形式,让空间位置对应到类别预测。它不是 Fast 或 Faster R-CNN 后面的自然“下一代”,而是有独立目标的一条路线。Long、Shelhamer 和 Darrell 的工作,要在这个问题里理解。 请把两种输出摆在一起看:检测输出一组对象,语义分割输出一张类别地图。如果我们的科研任务关心组织、地表或材料区域的归属,后者就是直接的任务接口。接下来真正困难的是:网络深层的空间网格通常已经变粗,怎样交付像素级结果?

FCN 直接学习一张类别地图

独立阅读

如果用途是给组织切片的每个像素指定类别,先列一组外接框可能并不是自然起点。FCN 从空间网格出发:把分类网络改成可对不同输入大小输出空间分数图的计算,接受逐像素标签训练,再恢复到目标分辨率。

一个 C 类分割模型可以交付 [B,C,H,W] logits,每个像素有 C 个实数;目标 [B,H,W] 保存该像素的整数类别。类别维 softmax 决定“同一位置是哪类”,空间维则保留“这个判断在哪里”。如果把所有空间位置先平均成一个类别向量,就改了任务。

FCN 与区域检测是两条并行问题线:前者组织像素类别,后者组织对象集合。两条线都能利用分类预训练,却不能把 FCN 描述为 Faster R-CNN 的后继版本。原始 2014/2015 FCN 摘要报告 VOC 2012 的 mean IU 为 62.2%;2016 扩展版本有不同数字,引用时需区分版本。

最值得带回科研任务的是这个接口改变:表示能迁移,并不意味着原输出头能直接交付新答案。标注的单位变成像素,损失与评价也须随之改变。

图示条件与公式约定

FCN 是 Long、Shelhamer、Darrell 的独立密集预测路线。不要把课堂先讲 Faster 的顺序理解成 FCN 历史上后继于 Faster。

这条线索的展开与后续阅读

区域、像素与实例怎样直接学习一张像素类别地图?

让 logits、标签和有效像素一一对应

先建立像素坐标与类别标签的对应,再解释损失和忽略位置。

每个有效像素提供一项监督

独立阅读

对目标类别为 yuvy_{uv} 的像素,交叉熵是 −log⁡pyuv,u,v-\log p_{y_{uv},u,v}。若有效像素集合为 Ω,平均损失写成

L=−1∣Ω∣∑(u,v)∈Ωlog⁡pyuv,u,v. L=-\frac{1}{|\Omega|}\sum_{(u,v)\in\Omega}\log p_{y_{uv},u,v}.

三类 logits [B,3,H,W] 与整数目标 [B,H,W] 相配;不要把类别 ID 当成连续数直接算回归平方误差。二类分割也可只预测一个前景 logit,用 sigmoid 与二元交叉熵,这时标签与输出接口跟三类方案不同。

未标注位置常用 ignore=255。它表示“不在这里计算监督和指标”,不表示第四类,也不等于背景。LAB11 的损失和混淆矩阵都排除这些位置;否则模型可能因为迎合不存在的背景标签而产生错误梯度。

图像翻转、裁剪或缩放时,目标地图必须接受同一几何变换。RGB 图能用连续插值,离散 mask 通常用最近邻;把类 1 与类 3 插出“类 2”没有语义依据。先保证一处图像像素仍对应同一处目标,训练曲线才有解释价值。

区域、像素与实例怎样直接学习一张像素类别地图?

把粗网格放大时,先看输入有没有变

解释、算例与证据

P37 · 输出变细,不意味着信息自动变多

比较增加输出格子与增加输入证据。最近邻和双线性只规定怎样利用现有数值;离散标签与连续 logits 的插值又不同。8×8 算例清楚给出前景 IoU、背景 IoU、mIoU 和像素准确率,避免同一个小数换四个名字。

Lecture 03 课堂图解 P37已有 4 × 4 数值最近邻 · 16 × 16双线性 · 16 × 16唯一的数值来源复制邻近值过渡更平滑两种放大都只读原来的 16 个值,没有重新读取图像。二值数值场的插值算例;不是视觉模型预测。双线性按输出像素中心映射,边界夹取。

同一个 4×4 二值数值场放大到 16×16,最近邻和双线性并排;两者的计算输入完全相同。

  • 已有 4 × 4 数值
  • 最近邻 · 16 × 16
  • 双线性 · 16 × 16
  • 唯一的数值来源
  • 复制邻近值
  • 过渡更平滑
  • 两种放大都只读原来的 16 个值,没有重新读取图像。
  • 二值数值场的插值算例;不是视觉模型预测。双线性按输出像素中心映射,边界夹取。
同一个 4×4 二值数值场放大到 16×16,最近邻和双线性并排;两者的计算输入完全相同。 查看对应图解状态
查看完整图解

课堂讲述

把一个粗网格放大很容易。最近邻复制数值,双线性利用邻近位置作平滑过渡;它们可以给出更多输出位置,但没有额外读取原图。 如果深层表示中仍保存着相关差异,合适的解码和上采样能帮助利用它;如果两种不同边界已经被编码成完全一样的表示,单纯放大不会知道原来是哪一种。 所以像素预测不仅需要“把图片尺寸变回来”,还需要检查表示中保留的空间信息、解码时的读取和训练监督。不要把转置卷积叫成一般意义上的逆卷积,也不要把画面更平滑等同于边界更正确。下面看怎样把不同层次的信息结合起来。

图示条件与公式约定

同一 4×4 二值数值场,最近邻 floor(outindex×4/16);双线性按 (outindex+.5)×4/16−.5 映射并对边界夹取。可比较插值,不称为从图像预测 mask 的训练实验。

这条线索的展开与后续阅读

区域、像素与实例怎样直接学习一张像素类别地图?

用同一张 8×8 mask 核对四种指标

已知 mask 的缩放练习隔离采样;相同错误要按明确口径计数。

0.667 是前景 IoU,0.75 才是本例两类 mIoU

独立阅读

已知 8×8 真值 mask:前景 16、背景 48。平均降到 4×4,再最近邻还原并以 ≥.5 阈值化后,预测前景 24,其中 16 个正确、8 个误把背景当成前景;没有漏掉真前景。因此 TP=16、FP=8、FN=0、TN=40。

口径 分子与分母 结果
前景 IoU 16/(16+8+0) 2/3
背景 IoU 40/(40+0+8) 5/6
两类 mIoU,含背景 (2/3+5/6)/2 .75
像素准确率 (16+40)/64 .875

这个过程的输入就是已知 mask,因此它隔离的是采样与阈值,不是看 RGB 图像做分割。当前 LAB11 已将名称修正,并保留最近邻与双线性两个分支。双线性分支的两类 mIoU 为 .77564,前景 IoU 仍为 2/3;平滑改变的是错误的位置和类别组成,不是自动保证每项指标都变好。

读一项 mIoU 时至少应知道平均哪些类、是否含背景、空并集怎样处理,以及先累计整份混淆矩阵还是逐图计算再平均。这些口径会改变数字;具体口径比多显示小数位更重要。

哪些信息真的改善了像素预测?

细支路、简单基线和输入干预分别能证明什么?

区域、像素与实例哪些信息真的改善了像素预测?

给预测模块接入另一份细位置信息

解释、算例与证据

P38 · 让细位置与深层语义重新配合

较细支路给解码器另一份可能保留位置线索的输入,但不保证边界正确;应在同一任务比较错误图与逐类 IoU。现有实验中,RGB 简单基线在原条件下胜出,FCN 在模糊后更稳健。对照两种条件,判断结构何时实际有用。

Lecture 03 课堂图解 P38同一图像较细位置较大上下文对齐后融合组合两层线索学习像素类别分数从像素监督学习像素输出接口示意原图局部参考检查空洞与边界轮廓为教学标注特征格为结构示意;照片不进入融合终点,右下掩码不是模型实测。

同一图像分别通向较细位置与较大上下文两张示意特征图,经坐标对齐融合、像素预测模块连接到掩码输出接口。下方杯柄照片单独作为空洞与边界参考,用虚线对应掩码;特征格与掩码均为教学示意,非模型实测。

  • 同一图像
  • 较细位置
  • 较大上下文
  • 对齐后融合
  • 组合两层线索
  • 学习像素类别分数
  • 从像素监督学习
  • 像素输出
  • 接口示意
  • 原图局部参考
  • 检查空洞与边界
  • 轮廓为教学标注
  • 特征格为结构示意;照片不进入融合终点,右下掩码不是模型实测。
同一图像分别通向较细位置与较大上下文两张示意特征图,经坐标对齐融合、像素预测模块连接到掩码输出接口。下方杯柄照片单独作为空洞与边界参考,用虚线对应掩码;特征格与掩码均为教学示意,非模型实测。 查看对应图解状态
查看完整图解

课堂讲述

浅层或较细分辨率的特征保留更直接的局部位置,较深层特征则整合了更大范围的内容。FCN 的跨层融合,让这些信息有机会一起参与像素预测。 请看右下方的杯柄照片,它是原图局部,用来检查我们关心哪条边界。上面的细特征与下面的粗特征先在坐标上对齐,再交给预测模块共同使用。输出的是每个位置的类别分数或掩码。粗层提供较大范围的上下文,细层提供另一份可能保留杯柄位置的线索;它们都不是现成的正确答案,怎样组合仍要从像素监督中学习。 以后你们看到 U-Net、特征金字塔等结构,可以继续追问同一个问题:它在什么分辨率上保留和组合信息?这一点比把所有跳跃连接都叫成 ResNet 更重要。操作相似,不代表它们首先解决的是同一个问题。

上采样改变读数位置,跨层连接提供额外证据

独立阅读

从 12×12 分数图恢复到 48×48,可以用最近邻复制,也可以用双线性按邻域加权。输出格子多了,是为了在原图坐标上作决定;运算本身没有再次看原图。若细边界的信息已被编码成相同数值,单独放大同一张图不能判断它原来在哪。

但低分辨率并不意味着一切细节必丢。通道、相位与邻域响应可能保留可用线索,训练出的解码器可以利用它们;真正的判断是“差别有没有进入 F”,而不只是 F 的宽高。因此 P37 既不许诺放大恢复真实细节,也不否定学习上采样的价值。

跨层连接做了一件不同的事:把较细层的特征另行送进预测模块。它提供的不是同一粗特征的复制,而是另一份尚可能保留位置细节的输入。深层上下文可帮助识别这是杯子,较细响应可帮助定位杯柄与窄缝;二者仍需通过任务训练学习怎样组合。

转置卷积是可学习的线性运算形式,不是一般意义上可还原任意输入的“逆卷积”。是否保留细节,应通过同源输入、目标、预测与错误图观察。

P38 的杯柄照片只是原图参考:细、粗特征先做坐标对齐,再由预测模块学习组合,交付像素类别分数或掩码,而不是还原那张 RGB 照片。图中的特征格为结构示意,轮廓为教学标注;是否减少空洞和边界错误,要另看模型预测与目标的比较。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:双线性更平滑,是不是边界就更准?

教师:平滑只描述输出变化。是否更准要对照目标轮廓与同一指标;当前已知 mask 热身中,前景 IoU 并没有因双线性变好。

沿这个问题继续

沿 CLS08 的像素目标与指标阅读,再选 LAB11 查看已有预测和错误图。

出处:FCN (2015)

图示条件与公式约定

两路特征先对齐再融合,交给从像素监督学习的预测模块。杯柄照片来自同一原图,只是局部参考,不是特征图或预测结果。特征格是结构示意;像素输出接口所画轮廓是教学标注。此页不把浅层叫“真实位置答案”、深层叫“真实类别答案”。

这条线索的展开与后续阅读

区域、像素与实例哪些信息真的改善了像素预测?

选读:沿计算图比较 FCN、U-Net 与 FPN

先问细信息来自哪里、怎样对齐和组合,再比较结构名称。

选读:FCN、U-Net、FPN 的连接究竟送来了什么

独立阅读

把“有跳连”当成一个共同名字,容易遮住任务差异。FCN 的跳接把较细层的空间线索与粗语义预测结合,服务于逐像素输出;U-Net 的编码—解码路径将高分辨率特征接到相应解码层;FPN 自顶向下融合与横向连接,形成可供不同尺度对象使用的特征层级。

观察点 应在计算图里找什么
较细信息从哪里来 原图或编码器哪个中间层,而非只看上采样箭头
怎么对齐 两条支路的步长、尺寸、坐标约定
怎样组合 相加或拼接,组合后是否再有可学习预测
服务哪个目标 单张类别图、多尺度框、局部实例 mask

如果原图中 4×4 像素的目标进入 stride16 网格,其连续跨度只有 1/4×1/4 格;这使位置读取困难,但不能仅据小于一格断言信息必全丢,通道仍可能记录响应。更细输入或跨层特征带来新的观测机会,是否改善要在指定任务上检查。

保留这份比较,是为学生读到结构名时有判断坐标;本轮主讲不再把它拆为几个平行论文段落。

区域、像素与实例哪些信息真的改善了像素预测?

进入 LAB11:保留简单基线再看条件变化

有了机制假设,再用已有同条件结果判断额外结构的实际作用。

同一组分割实验里,简单模型为何值得留下

独立阅读

当前 LAB11 同时训练逐像素 RGB 线性读出和小型 FCN。输入 48×48 RGB,标签是背景、红矩形、蓝椭圆;384 张训练图与 128 张保留图按场景种子分开。FCN 用粗分数与细分支融合,RGB 基线则只用 Conv2d(3,3,1),共 12 个参数,不能看邻域。

已有 2026-09-22 本地完整运行中,原始合成图的 RGB 基线三类 mIoU=1,FCN=.99041;对输入做 5×5 模糊后,二者变为 .84996 与 .92397。原分布上简单模型胜出说明颜色已足够决定类别;模糊使边缘颜色混合,FCN 利用邻域在该干预下更稳健。两项观察共同说明为什么需要基线:它既暴露任务太容易的地方,也帮助找出复杂结构实际增加能力的条件。

同一 FCN 参数,推理时仅把双线性改为最近邻,mIoU 变成 .91180。这检验训练/推理采样约定的敏感性,没有分别重训两种网络,不能当成插值方式的普遍排名。

本轮整理只复用已有记录,没有重跑。完整学习证据在 RGB→模型→logits→mask 链条;P37 的已知 mask 缩放热身则解释采样,二者都保留,作用分清。

沿这个问题继续

沿 CLS08 的像素目标与指标阅读,再选 LAB11 查看已有预测和错误图。

按问题回查的讲解与短练习(1)

出处:FCN (2015)
区域、像素与实例哪些信息真的改善了像素预测?

把总体准确率拆回目标与边界错误

平均数会被面积分布影响;回到逐类结果和错误像素才能定位问题。

像素准确率很高,为什么小对象仍可能很差

独立阅读

一张大部分为背景的图,只要把背景判对,整体像素准确率就会很高。假设 10000 个像素里只有 100 个属于目标,全部预测背景就有 99% 准确率,但目标 IoU 为零。这个算例说明面积不平衡如何隐藏感兴趣类别的失败。

LAB11 的同权重尺度 ×.45 对照更具体:像素准确率 .99816,而蓝椭圆 IoU 为 .85763、红矩形 .97613、背景 .99812。按三类等权平均得到 .94396。蓝对象与背景窄缝更细,发生少量像素错误就显著影响目标的比例。

查看失败图时要把输入、真值和错误像素并排。若杯把空洞消失,可能是原观测不清、特征混合、读出不对齐或任务头没学好;单看总数不能定位原因。可以先冻结其余条件,改变输入尺度或采样方式,再追踪错误是否沿边界集中。

本页连接细/粗特征的目的不是保证某个结构胜出,而是让我们可以问一个可测问题:增加细分支是否在同一输入和训练协议下,实际减少了所关心的窄缝错误?已有实验提供起点,完整架构对照仍需另设。

怎样让每一份轮廓属于一个明确对象?

类别地图还缺哪种身份,区域 mask 如何补上它?

区域、像素与实例怎样让每一份轮廓属于一个明确对象?

从同类像素中分出两份对象身份

解释、算例与证据

P39 · 两个同类对象,需要两份身份

同类像素与同一实例是两个概念。实例到类别的映射可多对一,连通块也不可靠地等于对象数。此页提出掩码必须随对象身份分别组织,为区域路线与像素路线的汇合提供具体理由。

Lecture 03 课堂图解 P39同一底图,只改变标注问题语义:两只都属于“杯子”实例:#1 与 #2 分开同色编码类别不同色编码对象 ID可见轮廓、杯柄孔洞和书遮挡保留;同类像素正确,还不等于交付了实例身份。

同一底图并排叠加语义和实例 mask,杯柄孔洞和书遮挡保留;颜色分别编码类别和实例 ID。

  • 同一底图,只改变标注问题
  • 语义:两只都属于“杯子”
  • 实例:#1 与 #2 分开
  • 同色编码类别
  • 不同色编码对象 ID
  • 可见轮廓、杯柄孔洞和书遮挡保留;同类像素正确,还不等于交付了实例身份。
同一底图并排叠加语义和实例 mask,杯柄孔洞和书遮挡保留;颜色分别编码类别和实例 ID。 查看对应图解状态
查看完整图解

课堂讲述

现在看两只相邻的杯子。即使所有杯子像素都判对了,系统若只交付“杯子”这一类别,也还没有告诉我们每个像素属于哪一个对象。对语义类别来说,这未必是主要错误;对实例任务来说,答案就不够了。 实例分割要保留“这是哪一个对象”的身份。不能只把所有同类像素放进一个桶,也不能只提供外接框。 这让区域路线和像素路线有了自然的汇合点:先用区域组织不同对象,再在每个区域内部预测属于这个实例的像素。我们前面花时间讲区域表示和空间预测,到了这里就不再是两段独立知识。Mask R-CNN 把这两种要求放到了一套结构中。

从实例到类别容易,反过来不唯一

独立阅读

把像素标为杯子类别,只声明“这里属于杯子集合”。实例标注还声明“这里属于杯一,那里属于杯二”。两只杯子即使同色、接触甚至相互遮挡,实例任务仍需给出两份对象身份。

考虑一行标签 [1,1,2,2],其中 1、2 是两只杯子的实例号。将它们都映射到类别杯子=1,就得到 [1,1,1,1]。另一个实例划分 [1,2,2,2] 经同样映射也得到同一类别行。因此类别图不能唯一反推出实例边界。

连通域可以在“每个对象互不接触”的特定条件下帮忙计数,但一旦两只杯子相接,一个连通块可含两个对象;反过来同一被遮挡的对象还可能产生不连通的可见部分。对象身份不是连通性规则自动保证的属性。

区域路线给每个候选一份身份,像素路线给精细轮廓。把它们结合,就可以在“这个候选对象”之内预测局部 mask。这是进入 Mask R-CNN 的具体需求,而不是为了再增加一种模型名称。

图示条件与公式约定

原底图两杯相邻但没有相接,因此讲稿开头改成“现在看两只相邻的杯子”。它们若接触时语义同类与实例身份的差异仍成立,此页不假装底图已经接触。

区域、像素与实例怎样让每一份轮廓属于一个明确对象?

用二维区域特征预测当前实例的掩码

解释、算例与证据

P40 · Mask R-CNN:区域内部,也保留二维结构

一个 RoI 的类别、框与局部 mask 有不同输出形状和监督。mask 分支需要二维布局,并以当前实例为目标,框中另一个同类对象不该被顺便选中。P41–43 接着检验区域读出与目标坐标是否真的一致。

Lecture 03 课堂图解 P40原图 + 当前 RoI共享 FRoI 读取二维区域特征 F_RoI类别:杯子框:位置修正原图局部:仅用于对应对象实例二值 mask教学目标示意 · 非模型预测三项任务读取共享 F 中的区域特征;照片仅作参考,mask 保持二维局部布局。

同源场景标出红杯RoI;整图计算共享特征F,再按RoI读取蓝色二维区域特征F_RoI,连接类别、框修正与实例mask三项分支。下方RGB裁剪独立标为对象参考,掩码标为教学目标示意。

  • 原图 + 当前 RoI
  • 共享 F
  • RoI 读取
  • 二维区域特征 F_RoI
  • 类别:杯子
  • 框:位置修正
  • 原图局部:仅用于对应对象
  • 实例
  • 二值 mask
  • 教学目标示意 · 非模型预测
  • 三项任务读取共享 F 中的区域特征;照片仅作参考,mask 保持二维局部布局。
同源场景标出红杯RoI;整图计算共享特征F,再按RoI读取蓝色二维区域特征F_RoI,连接类别、框修正与实例mask三项分支。下方RGB裁剪独立标为对象参考,掩码标为教学目标示意。 查看对应图解状态
查看完整图解

课堂讲述

Mask R-CNN 沿用刚才的区域检测思路:先对整张图计算共享特征,再按这个 RoI 读取一份小的二维特征图。请看中间的 F_RoI,它来自共享特征,不是把下方的原始杯子照片重新送进分类网络。这个区域既要判断类别和修正位置,也要在局部坐标中预测当前实例的掩码。 这不是多写一个标签。掩码分支需要保留区域内部的二维布局,才能回答哪里是对象、哪里是背景。类别与局部掩码的预测方式也不同,不能把语义分割的所有像素类别竞争原样套过来。 图中同一杯子对应一份区域表示,三项输出都能追踪到它。现在有个容易被忽略的问题:区域的边界和特征图的采样位置未必落在整数网格上。如果区域提取时把坐标对齐关系弄歪,后面就可能在错误位置上努力预测轮廓。

一个 RoI 的三项输出,为什么不是三个类别标签

独立阅读

同一 RoI 可以给出类别、四个框偏移和一个二维掩码。前两项可以汇总为短向量;mask 却需要保留“区域左上、右下分别是什么”的空间关系。把区域特征完全摊成不带布局的统计,会给逐像素对应增加负担。

画面中原图局部只帮助我们指认对象。真正进入区域任务头的是从共享特征 F 读取的区域特征;其空间格子保存相对位置,每格还可以有多个通道。后两页检验这一读取怎样保持连续坐标对应。

Mask R-CNN 的掩码分支在 RoI 内预测固定大小的二值图。原论文的默认实现对每个类别各预测一张 sigmoid mask,训练时只计算真值类别对应的掩码损失;区域分类分支负责决定类别。因此掩码像素回答的是“是否属于本实例”,不是让所有对象类别在每个 RoI 像素上再次竞争。

用杯子的例子理解:RoI 已对应杯一,框里即使还露出杯二的一部分,杯一的目标 mask 仍只标杯一。两个区域可以都被分类为杯子,分别交付各自的二值轮廓。这种分工让实例身份与像素预测接在一起。

本课程并没有在 LAB11 训练完整 Mask R-CNN;LAB11 是三类语义分割。Mask R-CNN 的训练证据来自原论文,坐标、局部目标和插值机制则可由 LAB03 的小算例独立检验。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:为什么前面刚说不必反复裁图,这里又是一张杯子的裁剪图?

教师:照片只让你看清对应的是哪只杯子。参与计算的是旁边的F_RoI特征格,它从已经算出的共享F中读取。区域身份相同,原始像素和区域特征是两种不同对象。

沿这个问题继续

沿 CLS08 的像素目标与指标阅读,再选 LAB11 查看已有预测和错误图。

图示条件与公式约定

依据原始 Mask R-CNN:三个任务头读取从共享F提取的区域特征F_RoI,RGB照片只作对象对应参考。mask预测保持二维结构,原论文按类二值mask,训练只使用真值类别对应的mask loss。显示手工教学目标轮廓而非模型预测结果。

这条线索的展开与后续阅读

区域采样怎样保住几何对应?

从坐标、四邻插值到局部目标,再检查论文中的同条件证据。

区域、像素与实例区域采样怎样保住几何对应?

先算 35/16,再判断取整改变了什么

解释、算例与证据

P41 · 三个像素的偏移,为什么会伤到轮廓?

先固定简单坐标约定 x/stride,再看 35→2.1875→取整 2 所造成的位置变化。真实库的像素中心与边界设置必须另核对;本页的三个像素误差是指定算例,不是所有实现的固定偏差。

Lecture 03 课堂图解 P41约定:原图 x ÷ 16 → 特征坐标原图 x01632486435连续位置35/16 = 2.187532取整后2 × 16 = 32读的位置变了 3 个原图像素坐标示意,不模拟各框架的半像素约定;RoIAlign 避免相关坐标量化。

原图坐标轴上的 x=35 映射到 stride16 特征坐标 2.1875;量化到 2 时对回 x=32,明确三像素偏移。

  • 约定:原图 x ÷ 16 → 特征坐标
  • 原图 x
  • 0
  • 16
  • 32
  • 48
  • 64
  • 35
  • 连续位置
  • 35/16 = 2.1875
  • 32
  • 取整后
  • 2 × 16 = 32
  • 读的位置变了 3 个原图像素
  • 坐标示意,不模拟各框架的半像素约定;RoIAlign 避免相关坐标量化。
原图坐标轴上的 x=35 映射到 stride16 特征坐标 2.1875;量化到 2 时对回 x=32,明确三像素偏移。 查看对应图解状态
查看完整图解

课堂讲述

用一个小坐标例子看。特征图相对原图的步长是十六,原图横坐标三十五对应特征坐标二点一八七五。如果简单变成整数二,就相当于换到了原图三十二附近的位置。 识别“大概是什么”时,这样的偏差可能不太显眼;但在杯柄或细边界上,几个像素就会改变哪些位置应该属于对象。 这里不是说所有取整都造成同样大小的错误,而是指出一种信息通路问题:我们希望读取这个区域,却在离散化过程中改变了它的几何对应。RoIAlign 的关键,就是在区域提取中避免相关量化,并用连续位置采样。下一页让这个采样变成能算出来的东西。

35 除以 16 之后,为什么不应急着取整

独立阅读

本页采用教学约定 (u=x/s),不额外加入像素中心偏移。原图 x=35、特征步长 s=16,得到 u=2.1875。若立即取整为 2,读到的位置就相当于原图 x=32;对分类可能仍包含相似内容,但细杯柄边缘已偏了三个像素。

这不表示所有实际库都直接使用 x/s。具体实现还可能约定像素中心、半像素偏移、对齐端点及边界外采样。对照库输出时必须先统一这些约定,不能把差异都归结为数值误差。课堂算例选择简单坐标,是为了单独看清连续位置与量化的差别。

RoI 提取不只涉及框起点,还要把框划成固定数量 bins,并在每个 bin 中选择采样位置。若框边界或 bin 边界被取整,细小移动可能完全不改变读数,跨过阈值又会突然跳变。保留连续几何,再通过邻域插值得值,便能把这些连续变化传到区域读出。

到 P42 我们真正算一个点;到 P43 再把点值放回局部二维目标。一次插值算对,是理解组件,不等于已经完成整套实例分割。

沿这个问题继续

先读本页解释与图,再到 LAB03 改一个坐标或对象。

按问题回查的讲解与短练习(1)

图示条件与公式约定

教学坐标假设图像边界坐标/stride,无半像素偏置。35/16=2.1875,取整2对回32。仅用于解释量化误差,不声称还原 torchvision 等具体框架全部坐标约定。

这条线索的展开与后续阅读

区域、像素与实例区域采样怎样保住几何对应?

从四个邻点实际算出 2.5

解释、算例与证据

P42 · 连续位置的数值,怎样从四个邻点得到?

对 0、2、4、6 四邻值,按横向 1/4、纵向 1/2 算出 2.5。两步插值与四项加权是同一运算。读完算例后,接着看原论文的对照:对齐改善了哪些指标,区分“使用双线性插值”和“保持坐标对齐”的作用。

Lecture 03 课堂图解 P42F = [[0,2],[4,6]];x 向右,y 向下0246(.25, .5)xy上行:¾×0 + ¼×2 = 0.5下行:¾×4 + ¼×6 = 4.5再取两行中间值½×0.5 + ½×4.5 = 2.5四邻点权重:⅜,⅛,⅜,⅛权重和 = 1;结果 = 2.5一个连续采样点的双线性算例;完整 RoIAlign 还要组织分格、多个采样点与汇总。

F=[[0,2],[4,6]] 的四邻点与 (.25,.5) 采样点,横向两次插值和纵向一次插值连接到 2.5。

  • F = [[0,2],[4,6]];x 向右,y 向下
  • 0
  • 2
  • 4
  • 6
  • (.25, .5)
  • x
  • y
  • 上行:¾×0 + ¼×2 = 0.5
  • 下行:¾×4 + ¼×6 = 4.5
  • 再取两行中间值
  • ½×0.5 + ½×4.5 = 2.5
  • 四邻点权重:⅜,⅛,⅜,⅛
  • 权重和 = 1;结果 = 2.5
  • 一个连续采样点的双线性算例;完整 RoIAlign 还要组织分格、多个采样点与汇总。
F=[[0,2],[4,6]] 的四邻点与 (.25,.5) 采样点,横向两次插值和纵向一次插值连接到 2.5。 查看对应图解状态
查看完整图解

课堂讲述

这四个相邻位置的值分别是零、二、四、六。我们要读的位置在横向四分之一、纵向一半处,不正好落在其中任何一个整数点上。 先在上面一行按横向位置插值,得到零点五;下面一行同样插值得到四点五;再在两行的中间取值,得到二点五。也可以一次写成四个邻点的加权和,结果相同。 这段计算不是让你背四个权重,而是看清连续采样没有创造一张新图:它在已有特征之间,按指定位置构造读出。RoIAlign 会在区域的分格中组织这类采样与聚合。保持坐标对应,对需要细轮廓的任务就特别重要。

四个邻点如何读出 2.5

独立阅读

把左上、右上、左下、右下值依次记为 0、2、4、6。要读取的点相对左上角横向走了 α=1/4、纵向走了 β=1/2。上排插值为 (1−α)0+α2=.5(1-α)0+α2=.5,下排为 (1−α)4+α6=4.5(1-α)4+α6=4.5,再纵向插值得 (1−β).5+β4.5=2.5(1-β).5+β4.5=2.5。

也可直接写四点加权和:

v=(1−α)(1−β)F00+α(1−β)F10+(1−α)βF01+αβF11. v=(1-α)(1-β)F_{00}+α(1-β)F_{10}+(1-α)βF_{01}+αβF_{11}.

对应权重为 3/8、1/8、3/8、1/8,总和为 1。代入得 0+2/8+12/8+6/8=2.50+2/8+12/8+6/8=2.5。离左边更近,所以两项左邻的总权重是 3/4;纵向正好一半,上下各占 1/2。这些比例直接来自几何,而不是学出来的四个自由参数。

RoIAlign 在每个 bin 内组织多个这种连续采样点,再按实现聚合。它用原有特征构造位置相关读数,没有查到原图中的隐藏真值。改变特征图分辨率、RoI 或采样数量时,应重新计算位置;不能沿用旧邻点却声称只是换了 stride。

读完算例后,接着看原论文的对照:对齐改善了哪些指标,区分“使用双线性插值”和“保持坐标对齐”的作用。

图示条件与公式约定

四点为左上0、右上2、左下4、右下6,x=.25,y=.5,权重依次3/8、1/8、3/8、1/8,值2.5。它是单点插值,不是完整 RoIAlign。原论文每 RoI bin 内4个规则采样点后 max/average 聚合;图43进一步连接局部区域目标。

这条线索的展开与后续阅读

区域、像素与实例区域采样怎样保住几何对应?

同一杯子换了区域,局部目标也要变

解释、算例与证据

P43 · 同一只杯子,换一个区域就换一份局部目标

同一个对象在两个 RoI 中的局部位置不同,因此训练 target 必须与区域坐标同步。这里连接实际 mask 对应与原论文的 RoIAlign 实证;接下来固定 F 的问卷反例改变了实验条件,不否定这个正面结果。

Lecture 03 课堂图解 P43同一只杯子,两份 RoIRoI A:更紧局部目标占比更大RoI B:更宽轮廓更小,位置也改变同一可见轮廓映射到不同局部坐标;区域范围、采样与 mask 目标必须一致。

同一红杯两个精确坐标 RoI,映射到相同大小的局部 mask 网格后呈现不同占比与位置。

  • 同一只杯子,两份 RoI
  • RoI A:更紧
  • 局部目标占比更大
  • RoI B:更宽
  • 轮廓更小,位置也改变
  • 同一可见轮廓映射到不同局部坐标;区域范围、采样与 mask 目标必须一致。
同一红杯两个精确坐标 RoI,映射到相同大小的局部 mask 网格后呈现不同占比与位置。 查看对应图解状态
查看完整图解

课堂讲述

区域掩码是在局部坐标里预测的。同一个对象,区域取大一些或偏一些,映射到局部网格之后,目标轮廓的位置和比例也会变化。 所以区域、采样和掩码目标必须对得上。不能把一份 mask 贴在另一份不相符的区域上,然后期待网络从错误监督中学出准确边界。 这也是为什么原论文会专门比较不同的区域提取方式:掩码任务对空间对应提出了更强的要求。对我们自己的问题,关键启发是沿信息流找错误发生在哪一段,不是边界一差就直接换更大的骨干。现在再问一个更根本的问题:如果表示本身已经把两种输入混成相同数值呢?

同一只杯子换了 RoI,局部标签也要跟着换

独立阅读

原图位置 (x,y)(x,y) 在框 b=(x0,y0,w,h)b=(x_0,y_0,w,h) 内,可写成相对位置 ((x−x0)/w,(y−y0)/h)((x-x_0)/w,(y-y_0)/h)。杯子本身不动,框变宽后,杯子占局部窗口的比例会变小;框向右偏,杯子在局部窗口中会向左移动。

因此局部 mask 不只取决于对象轮廓,还取决于当前 RoI。训练时须将匹配实例的真值 mask 按同一框裁取并映射到目标网格;推理时再把局部预测映回该框的原图位置。若错把杯一的局部标签贴到杯二框上,网络收到的监督关系已经错了,增加参数不能补救这个对应错误。

本页显示同一杯子的两个区域,帮助区分“图像里的对象坐标”与“区域里的归一化坐标”。LAB03 的局部窗口是教学裁剪,可检查框的身份;它没有对预训练特征真正调用二维 RoIAlign。

这也是原论文需要对齐消融的理由:实例 mask 对空间对应提出更严格要求。正面实验说明正确读取有实用收益;它与 P44 的均值碰撞不矛盾,因为两个实验固定的条件不同。

图示条件与公式约定

统一使用原桌面红杯,题目随之从“椅子”改为“杯子”。RoI A=(177,238,390,351),RoI B=(135,210,510,420),均为 xywh。对同一可见轮廓作不同局部坐标投影,没有更改底图或补画遮挡后轮廓。

这条线索的展开与后续阅读

区域、像素与实例区域采样怎样保住几何对应?

在同一设置下比较 RoIPool、RoIWarp 与 RoIAlign

计算说明组件怎样工作;论文同条件对照再检验它是否改变任务表现。

原论文的对照:对齐改善了哪些指标

独立阅读

Mask R-CNN v3 的 Table 2 使用 COCO trainval35k 训练、minival 测试;表中未另说明时报告 mask AP。以下固定 ResNet-50-C4、stride 16,并选同为 max 聚合的行:

区域读取 是否保留对齐 是否双线性 mask AP mask AP75
RoIPool 否 否 26.9 26.4
RoIWarp 否 是 27.2 27.1
RoIAlign 是 是 30.2 31.8

RoIAlign 相比 RoIPool 的 AP 增加 3.3 点,AP75 增加 5.4 点。RoIWarp 也插值却没有同样改善,支持“保持坐标对应”这一机制判断。平均聚合的 RoIAlign 行是 AP30.3/AP75 31.5,引用时不能把不同聚合行混在一个对照里。Table 2(d) 换成 C5、stride32,mask AP 从 23.6 到 30.9;这是另一组设置。

这些是训练完整模型的论文结果,不是本课程重跑。它们说明读取位置值得修复,尤其严格定位受益;P44 则把输入 F 固定成完全相同,讨论任何确定性读出都无法创造差别。方法有效与构造例中的信息限制,可以同时成立。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:四点加权是不是已经把丢掉的像素补出来了?

教师:它按指定位置读取现有特征,不知道被删去的真实像素。图上 2.5 来自这四个数和坐标;如果甲乙给它同样四个数与坐标,它们的结果仍相同。

沿这个问题继续

先读本页解释与图,再到 LAB03 改一个坐标或对象。

按问题回查的讲解与短练习(1)

瓶颈是读错位置,还是差别根本没有保留?

怎样把信息碰撞的构造例与区域对齐的正面证据放在同一判断中?

区域、像素与实例瓶颈是读错位置,还是差别根本没有保留?

固定相同表示,推导为什么无法区分左右

解释、算例与证据

P44 · 两种布局,如果已经变成同一个数

本页结论来自题设明确规定的相同表示、相同框和不能回看原图。确定性后处理收到相同输入只能产生相同输出。将其与论文训练对照并排,才能区分“读取已有差别”和“创造已不存在的差别”。

Lecture 03 课堂图解 P44A:亮在左列1010B:亮在右列0101整体均值(1+0+1+0)/4整体均值(0+1+0+1)/40.50.5同一个 F同一个区域同一种读取不能区分 A / B

A=[[1,0],[1,0]] 与 B=[[0,1],[0,1]] 分别取整体均值,汇入相同 0.5 后由同一后端处理。

  • A:亮在左列
  • 1
  • 0
  • 1
  • 0
  • B:亮在右列
  • 0
  • 1
  • 0
  • 1
  • 整体均值
  • (1+0+1+0)/4
  • 整体均值
  • (0+1+0+1)/4
  • 0.5
  • 0.5
  • 同一个 F
  • 同一个区域
  • 同一种读取
  • 不能区分 A / B
A=[[1,0],[1,0]] 与 B=[[0,1],[0,1]] 分别取整体均值,汇入相同 0.5 后由同一后端处理。 查看对应图解状态
查看完整图解

课堂讲述

左边的亮像素都在左列,右边都在右列;如果任务要分辨左右,两种输入的答案不同。可是我们用整体均值作表示,两个结果都是零点五。 现在冻结这个表示。下游拿到的 F 相同,区域也相同,只依赖这些信息的同一个确定性处理,就不可能知道原来是哪一种布局。多加几个输出格子,或者换一种插值,仍然是在处理同样的输入。 这就是问卷第二题的核心。它不是在证明 RoIAlign 没用,而是在分清两个问题:读取位置错了,可以改读取;区别已经没保存,必须回到表示、输入或额外信息。相同输出不一定都来自同一种错误。

两个输入一旦碰撞,确定性读出为何无法分开

独立阅读

令甲 A=[[1,0],[1,0]]A=[[1,0],[1,0]],乙 B=[[0,1],[0,1]]B=[[0,1],[0,1]]。如果编码器只取整体均值,f(A)=f(B)=.5f(A)=f(B)=.5。进一步固定框坐标、其他特征与读出参数,且读出不能再访问原图,那么对任何确定性函数 g,都有 g(f(A),b)=g(f(B),b)g(f(A),b)=g(f(B),b)。

这不是凭直觉说“分辨率低所以不行”,而是直接用相同输入必得相同输出。把 .5 复制为 4×4,或给同一个数做插值,都是对同样输入施加同样函数;结果仍无法告诉我们亮在左边还是右边。

若允许随机性,同样条件下也只能得到相同的输出分布。偶尔猜对其中一个,并没有建立随输入布局变化而变化的判断。要系统地区分,就要重新提供差别:改变编码器保留的信息、引入另一层特征、允许回看原图,或给出不同的外部条件。

题设没有证明真实粗特征普遍只等于均值,更没有推翻 RoIAlign 的完整模型结果。它是在迫使我们说清:性能瓶颈究竟是“已有信息读错位置”,还是“需要的信息根本没有保留”。

图示条件与公式约定

构造的不可辨识例:固定确定性后端 g(F,RoI),F 与 RoI 均相同,则 g 输出相同。随机后端的条件输出分布也相同。不能从此推出 RoIAlign 没有价值。正式 Tally 不变。

这条线索的展开与后续阅读

区域、像素与实例瓶颈是读错位置,还是差别根本没有保留?

加一项左右差统计,检查什么因此可分

解释、算例与证据

P45 · 多一个通道,和多几个像素不是同一回事

保持 1×1 网格,增加左右差通道即可让甲乙从同为 .5 变成 [.5,+1] 与 [.5,−1]。这说明信息不只由空间尺寸决定,也说明新通道只保证当前任务所需区别,并没有恢复任意原图。

Lecture 03 课堂图解 P45增加输出格点0.50.50.50.50.5相同数值被重复保存一个新通道:左均值 − 右均值10100101A = [0.5, +1]方向:1 − 0 = +1B = [0.5, −1]方向:0 − 1 = −1更密 ≠ 更多区别分辨率与信息量不是同一件事构造说明“可以编码这项区别”,不是保证真实网络会自动学到它。

左侧 0.5 重复成四格;右侧新增左列均值减右列均值通道,A=[.5,+1]、B=[.5,−1]。

  • 增加输出格点
  • 0.5
  • 0.5
  • 0.5
  • 0.5
  • 0.5
  • 相同数值被重复
  • 保存一个新通道:左均值 − 右均值
  • 1
  • 0
  • 1
  • 0
  • 0
  • 1
  • 0
  • 1
  • A = [0.5, +1]
  • 方向:1 − 0 = +1
  • B = [0.5, −1]
  • 方向:0 − 1 = −1
  • 更密 ≠ 更多区别
  • 分辨率与信息量不是同一件事
  • 构造说明“可以编码这项区别”,不是保证真实网络会自动学到它。
左侧 0.5 重复成四格;右侧新增左列均值减右列均值通道,A=[.5,+1]、B=[.5,−1]。 查看对应图解状态
查看完整图解

课堂讲述

要恢复刚才的区别,不一定只能提高空间分辨率。也可以让表示多保存一种统计:左列均值减右列均值。于是一个输入得到正一,另一个得到负一,下游就能够区分。 这个例子说明,网格大小和信息量不能简单画等号。更粗的网格加上合适通道,可能保存某种细节;更密的输出格子,也可能只是重复同一个数。 回到真实网络,要靠训练、结构和监督决定它保留什么。我们已经有了一个更有用的诊断顺序:先检查输入差异是否进入表示,再检查区域和采样是否对齐,最后看预测头怎样使用它。三件事都明确,分割错误才不再只是一个笼统的“模型不够强”。

一个空间格子也能保存左右差异

独立阅读

继续用甲、乙两张 2×2 图。第一通道取均值 .5,第二通道取左列均值减右列均值。甲得到 1−0=+11-0=+1,乙得到 0−1=−10-1=-1,因此表示分别为 [.5,+1][.5,+1] 与 [.5,−1][.5,-1]。空间大小都是 1×1,却已经有了可区分输入。

一个简单读出只需看第二通道符号,就可判断亮列在左还是右。与 P44 相比,成功不来自输出图画得更密,而来自编码器在压缩时额外保存了一项与任务有关的统计。

也不要因此推断两个通道足以恢复任意 2×2 图案。四个像素有更多自由度,均值与左右差只保存两种统计,仍可能有别的图案碰撞。表示的价值应围绕任务判断:如果只要左右,这项统计够用;若还要区分上下,就需要保留额外差别。

真实网络的通道是训练学到的,通常不是这样手写。因此下游 probe、迁移任务与可控干预仍然重要。张量有多少格、多少通道,提供的是容量线索,不是任务信息已被利用的证明。

图示条件与公式约定

新增通道为左右列均值之差,A:+1,B:−1。它说明存在一种保存方向的编码,不保证真实网络或增加通道数量就会自动学到。

这条线索的展开与后续阅读

区域、像素与实例瓶颈是读错位置,还是差别根本没有保留?

把对齐收益与信息限制放回各自条件

这段模拟追问帮助核对两类实验的固定条件,不作为已发生课堂对话。

备课推演:对齐有用,为什么问卷里又不能恢复?

独立阅读

以下是备课用的模拟追问,不是已发生的课堂对话或学习效果记录。

学生: 论文说 RoIAlign 更准确,这里却说换采样没用,是不是自相矛盾?

教师: 先把两个输入条件指出来。论文比较不同区域读取方式训练的模型,特征里有可以利用的空间线索;正确坐标让它读得更好。现在图上甲乙都被我们规定为同一个 .5,框也相同,读取器没有得到任何左右差别。它不是读取错了地方,而是没有不同内容可读。

学生: 那我先把 .5 放大成很多像素呢?

教师: 指着甲乙放大的第一行看,它们是不是还一样?增加输出位置没有改变函数的输入。再看下一页,我们增加左右差通道,甲是 +1、乙是 −1。这次确实提供了新信息,所以同一个读出可以给出不同答案。

学生: 实际分割不好,我怎么知道是哪种情况?

教师: 先检查标注与坐标能否对上,再固定模型做采样对照;若疑似特征不区分,可以尝试接入较细层,或设计有针对性的 probe。一次失败可能有多处原因,不能从一张模糊 mask 直接断言。

沿这个问题继续

先读本页解释与图,再到 LAB03 改一个坐标或对象。

按问题回查的讲解与短练习(1)

沿这个问题继续

先读本页解释与图,再到 LAB03 改一个坐标或对象。

沿这个问题继续

先读本页解释与图,再到 LAB03 改一个坐标或对象。

提示怎样指定这一次要分的区域?

点、框和已有表示怎样结合,提示能力又从哪里学来?

区域、像素与实例提示怎样指定这一次要分的区域?

一个正点可能指局部,也可能指整体

解释、算例与证据

P46 · SAM:把“分哪一块”交给提示

点和框指定本次目标,但一个点仍可能同时指向局部与整体。SAM 的可复用图像表示和轻量提示解码使交互更方便;当前 LAB16 是透明规则对照,应准确区分规则输出、教学标注和真正模型输出。

Lecture 03 课堂图解 P46增加框和杯身正点整只杯子新增提示缩小目标歧义正点:要求包含负点:要求排除由提示约束希望分出的区域点、框等提示指定分割区域;图示掩码为教学标注。

同一图像杯柄正点对应整杯和杯柄两个教学掩码;增加框与杯身正点以约束整体目标。

  • 增加框和杯身正点
  • 整只杯子
  • 新增提示
  • 缩小目标歧义
  • 正点:要求包含
  • 负点:要求排除
  • 由提示约束希望分出的区域
  • 点、框等提示指定分割区域;图示掩码为教学标注。
同一图像杯柄正点对应整杯和杯柄两个教学掩码;增加框与杯身正点以约束整体目标。 查看对应图解状态
查看完整图解

课堂讲述

前面主要把任务写成固定的训练输出。SAM 带来另一种使用接口:先给图像,再通过点、框等提示指定当前关心的区域,模型返回符合提示的掩码。 一个点未必只有一个正确解释。它落在杯柄上,我们可能关心杯柄,也可能关心整只杯子。增加提示是在减少这类歧义,而不是仅仅提高一个类别分数。 因此,可提示分割和自动把所有物体检测出来、给它们命名,不是完全相同的任务。这个接口让模型更容易被复用于不同操作,但使用者仍要说清想分什么。接下来再看,这种能力怎样与前面讲过的预训练连接起来。

SAM 的提示回答“这次要哪一块”

独立阅读

在杯柄上给一个正点,并不唯一规定目标是杯柄、整只杯子还是更大的对象组合。提示式分割的任务是根据图像与提示返回合理 mask;提示增加信息,但不必天然消除所有歧义。

几何提示可以分工:正点表示希望包含的位置,负点表示希望排除的位置,框给出大致区域,已有 mask 可以作为进一步修正的输入。它们不是人工直接提供完整答案,却约束了本次想处理的对象。模型须结合图像线索填出边界。

原始 SAM 将图像编码、提示编码和 mask 解码分开。同一图像的较重表示可缓存,用户改点、改框时重复较轻的后半段。它也能为模糊提示给出多个 mask 与估计质量,从而容纳“部分还是整体”的不同解释。

本页教学图显示提示与目标的对应关系;若要评价模型,应保存真正返回的 mask,并先约定期望的对象粒度。用户给一个点后显示手工真值,不能替代推理证据。LAB16 目前保留的是确定性颜色/连通域规则,适合比较接口,不冒充 SAM 权重推理。

图示条件与公式约定

原始 SAM 主流程以几何提示训练,单点允许整体/部件歧义,模型设计支持多个候选掩码。此处是任务标注,不是本轮运行。原论文另有 text-to-mask 探索;此图不展开,也不把组合 grounding 能力归给本图接口。

这条线索的展开与后续阅读

区域、像素与实例提示怎样指定这一次要分的区域?

分开预训练起点、任务学习与使用时复用

解释、算例与证据

P47 · 可复用表示,还要经过任务训练

把三个阶段分开:MAE 初始化视觉编码器,提示式 mask 训练建立任务能力,使用时缓存同图表示。具体训练目标和数据组织使提示能够起作用;这座桥把第一部分的表示来源与第二部分的空间接口连接起来。

Lecture 03 课堂图解 P47训练:初始化 ≠ 完整分割能力MAE 预训练提供图像编码器起点分割任务训练SA-1B 掩码 + 提示监督SAM图像 / 提示 / 掩码模块使用:图像编码可复用图像表示新点提示 → 一个掩码新框提示 → 另一个掩码

上层 MAE 初始化到 SA-1B 掩码和提示任务训练;下层一次图像表示服务多个提示。

  • 训练:初始化 ≠ 完整分割能力
  • MAE 预训练
  • 提供图像编码器起点
  • 分割任务训练
  • SA-1B 掩码 + 提示监督
  • SAM
  • 图像 / 提示 / 掩码模块
  • 使用:图像编码可复用
  • 图像表示
  • 新点提示 → 一个掩码
  • 新框提示 → 另一个掩码
上层 MAE 初始化到 SA-1B 掩码和提示任务训练;下层一次图像表示服务多个提示。 查看对应图解状态
查看完整图解

课堂讲述

SAM 给我们一个很清楚的连接:原始方案的图像编码器使用 MAE 预训练初始化,但分割能力还依赖后续的大规模掩码数据与任务训练。 所以不能说“MAE 会补图,于是自然就会 Segment Anything”。预训练提供起点,分割训练学习提示与区域之间的关系,使用时再复用图像编码来处理不同提示。 至此,两条主线在同一个系统里接上了:第一部分回答表示怎样学,第二部分回答它怎样被适配成空间能力。下一步,提示能不能不只是点和框,而是“书左边的红杯”这样的自然语言?要做成这件事,我们又需要新的对应关系。

MAE 提供起点,掩码任务训练学会怎样响应提示

独立阅读

原始 SAM 的图像编码器使用 MAE 预训练初始化。这连接了第一部分的表示学习,但“遮挡重建”目标并没有直接提供“某个正点应对应哪个对象 mask”的全部监督。后续还要进行提示式分割训练。

训练样本包含图像、目标 mask 与模拟提示。模型预测后,可以从错误区域追加正点或负点,再要求它修正;原论文训练模拟每个 mask 的多轮交互,掩码损失组合 focal 与 dice。这样,推理时的“改点、改框”对应训练中学过的任务,而不是凭空获得一个通用按钮。

数据组织也属于能力来源。SA-1B 来自模型辅助标注、半自动补充、全自动生成的逐步演进,最终收集约 1100 万张图像与 11 亿个 mask。这里的数据单位是区域轮廓,并非现成的图文语句对。

预训练参数、任务监督和使用接口可以分别复用:先以自监督表示为起点,再学习图像/提示到掩码,使用时缓存同图表示。如果只说“MAE 会补图所以自然会分割”,就跳过了任务训练这一关键桥梁。注意此处是原始 SAM;文字提示在论文中有另行探索,不等于公开几何提示 checkpoint 默认已具备任意语言理解。

图示条件与公式约定

原论文§3明确 MAE 预训练图像编码器,§8强调大规模分割任务训练对能力的重要性。SA-1B 属于分割掩码数据,不是 CLIP/LAION。使用阶段每图编码一次,多提示复用。

区域、像素与实例提示怎样指定这一次要分的区域?

选读:用透明规则检查点、框与容差

规则对照让每项变化可解释,同时保留与 SAM 权重推理的身份区别。

LAB16:颜色连通域让提示的作用变得透明

独立阅读

当前 LAB16 输入 48×64 RGB 图像,含红色外壳、深红内部零件与蓝物体。代码从正点像素取颜色,选择颜色距离在容差内的像素,再保留与正点四邻连通的部分。负点排除与负点颜色太相似的位置;框只限制允许区域。

已有本地输出的面积为:紧容差 110,宽容差 837,增加外壳负点后 110,加框后 156。紧容差选择内部零件,宽容差把整个外壳纳入;框的面积 156 也可能截断物体。这些变化能直接从规则解释。

因此它适合回答“提示和算法假设共同怎样改变结果”,不能回答“SAM 学会了什么”。它确实读入像素并输出 mask,但没有可学习参数,没有加载 SAM checkpoint,也没有语义泛化证据。保留这项透明练习,比给它错误模型身份更有教学价值。

读完可以把同一个正点移到蓝物体,预测容差和负点的作用;或对照官方 SAM predictor 的输入输出接口,标明哪些步骤仍需真实权重推理。此处不把未来模型运行写成已经完成。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:给一个正点,模型为什么会给多个 mask?

教师:正点可能落在局部与整体的共同位置。多个合理候选表达这种歧义;再给负点或框,才有额外条件帮助选定想要的粒度。

沿这个问题继续

先区分提示接口与训练来源;LAB16 作为规则对照选读,原始 SAM 机制按原论文核对。

沿这个问题继续

先区分提示接口与训练来源;LAB16 作为规则对照选读,原始 SAM 机制按原论文核对。

选读:输出组织与训练分配还可以怎样改变?

在已掌握区域、像素和实例后,按问题阅读结构与匹配扩展。

区域、像素与实例选读:输出组织与训练分配还可以怎样改变?

一阶段检测简化哪一段,保留哪些问题?

回查 LAB10 实现时,用这一页辨认它与两阶段路线共有和不同的部分。

选读:一阶段检测保留了哪些相同问题

独立阅读

一阶段检测不先为每个 proposal 再做一套区域分类,而是在一个或多个特征网格上直接预测类别与位置。这个改变简化了输出路径,却没有消除参考几何、目标匹配、正负不平衡、重复预测与定位评价。

若 16×16 网格每格有 4 个参考框,共 1024 项;每项预测含背景的 3 类 logits 与 4 个偏移,就有 7168 个输出数。这些数还是结构化候选,需按同一位置顺序与参考框配对,随后解码并整理。张量 reshape 顺序错误时,模型的偏移可能被贴到另一个 anchor 上。

D2L TinySSD 在多尺度特征上构造参考框与预测。当前 LAB10 为保持 CPU 可运行,用 12×12 单层网格、每格两个尺寸,共 288 项;它保留图像输入到框输出的学习链,但不等于多尺度模型的全部能力。

本条作为从主讲移出的深入阅读:理解它有助于读实验代码,不要求课堂再开 SSD 全章。FPN 关注怎样形成不同尺度的表示,SSD 关注怎样在特征上预测;两者都出现多尺度,不意味着同一机制。

沿这个问题继续

沿 CLS07 的公式定位疑问,再选 LAB09 解析练习或 LAB10 完整训练。

按问题回查的讲解与短练习(1)

区域、像素与实例选读:输出组织与训练分配还可以怎样改变?

把难例权重与对象匹配分成两件事

一种训练调整影响样本权重,另一种先确定预测与目标的对应。

选读:难例权重和对象匹配不是一件事

独立阅读

大量背景参考框已经很容易分类,却可能因数量占优而贡献大量总损失。focal loss 在基本交叉熵外乘 (1−pt)γ(1-p_t)^\gamma。取 γ=2,正确类概率 .9 的样本权重 .01,概率 .5 的权重 .25,后者相对贡献更大。这是在调整哪些样本值得继续关注,不直接增加空间信息,也不指定哪项预测负责哪只对象。

对象匹配回答另一件事:当真值是一组无序对象,预测槽位该怎样对应它们?给两预测、两真值的代价矩阵 [[2,.3],[.4,2]],对角总代价 4,交叉 .7,所以选择交叉。交换标注数组顺序不该改变对象集合本身,匹配用于消除这个任意顺序。

LAB20 从类别概率、框 L1 与 IoU 实际构造成本,再穷举 2! 分配;它是足够透明的解析练习。这里没有图像编码器学习,也不是完整 DETR。主讲保留对象身份的必要性,这些损失组织细节进入选读即可,不必为保持课程丰富而重新开一章。

区域、像素与实例选读:输出组织与训练分配还可以怎样改变?

选读 LAB20:沿真实输入核对交叉匹配

用已保存的小算例落实上一页的对应问题,检查成本与数组顺序。

LAB20 的两个槽位为何应交叉匹配

独立阅读

当前 LAB20 的第一项预测框在右侧,类别概率更支持第二类;第二项预测在左侧,更支持第一类。真值数组却按左、右保存。如果不考虑内容,直接让槽位 0 学真值 0,就人为制造了位置和类别冲突。

代码按教学定义 Cij=−log⁡pi(cj)+2∥bi−gj∥1+(1−IoU)C_{ij}=-\log p_i(c_j)+2\lVert b_i-g_j\rVert_1+(1-IoU) 构造成本,得到约 [[5.0971,.4509],[.4779,5.6026]]。对角总代价 10.6997,交叉 .9288,因此最佳分配为槽位 0→真值 1、槽位 1→真值 0。只交换标注或预测数组的排列,最小内容对应仍然不变。

此处的负对数分类项、IoU 与系数是教学选择;官方 DETR matcher 使用其明确的分类、L1、GIoU 成本,不应声称公式逐项一致。匹配找到最低代价也不意味着检测正确:即使两项预测都很差,算法仍会选一个较便宜分配。检测质量仍要用保留数据与定位/类别标准评价。

本册另一小算例把 16 像素目标映到不同 stride 的连续跨度,属于尺度读取,与集合匹配不同。导航中把二者标为两项可单独读的短练习,学生无需为找一句机制解释穿过全部实验。

沿这个问题继续

先读本页解释与图,再到 LAB03 改一个坐标或对象。

按问题回查的讲解与短练习(2)

带着空间接口,怎样进入实验与语言任务?

先选择需要交付的答案,再选择一个完整学习过程。

区域、像素与实例带着空间接口,怎样进入实验与语言任务?

从框住一个区域转向表达一个任务

解释、算例与证据

P48 · 从物体位置,走向可以说出来的任务

区域、像素、实例与提示已经提供可组合的空间部件。自然语言还要把对象、属性、参照物和关系连接起来;下一部分研究语言怎样成为输出、学习信号和任务条件。课后从学习路径中选一个完整实验,不必机械刷所有 Notebook。

Lecture 03 课堂图解 P48区域 + 轮廓 + 对象身份“书左边的杯子”文字条件视觉区域 × 文字条件需要学习两者的对应下一步:描述、匹配、指代、问答区域表示提供空间接口;语言再指定当前需要哪一个对象、哪一项信息。

同一桌面实例图与文字条件“书左边的杯子”连接到视觉区域 × 文字条件的接口。

  • 区域 + 轮廓 + 对象身份
  • “书左边的杯子”
  • 文字条件
  • 视觉区域 × 文字条件
  • 需要学习两者的对应
  • 下一步:描述、匹配、指代、问答
  • 区域表示提供空间接口;语言再指定当前需要哪一个对象、哪一项信息。
同一桌面实例图与文字条件“书左边的杯子”连接到视觉区域 × 文字条件的接口。 查看对应图解状态
查看完整图解

课堂讲述

这一部分的变化并不是“图越来越细”。我们先把区域作为计算单位,解决复用和位置问题;再为像素预测保留空间关系;最后将区域身份与局部轮廓结合,并让提示参与使用。 这些方法改变了我们能交付的答案,也留下了可被后续系统利用的区域和视觉表示。但到这里,怎样向系统表达“我要哪一个”,仍然需要约定接口。 语言给了一个很自然的入口。不是因为两个模态放在一起就一定懂了,而是人的描述、问题和指代已经包含大量任务信息。第三部分就看:这些信息怎样成为输出、监督与使用条件,以及图文对应为什么还不能自动替代定位和问答。

从空间地址到语言请求,还缺哪一种对应

独立阅读

现在已经有了三种可复用接口:共享视觉特征能供多个区域读取;区域与像素输出能描述对象位置和轮廓;点或框能指定本次关心哪一块。每一步都改变了系统收到的条件与需要交付的答案。

“框住左边杯子”把位置条件直接编码成坐标;“找到书左边的红杯”则要求系统将对象、属性、参照物和空间关系一起解释。文本并不是另一种坐标格式:同一个词可以对应多个对象,一段关系还可能指向并未直接被颜色词修饰的目标。

下一部分因此不是换一个更大模型继续同一输出,而是研究语言的几种角色:作为描述输出、作为图文配对学习信号、作为当前问题或指代条件。已有区域表示、mask 与分类能力成为可组合的部件,新训练要建立它们与语言的对应。

课后可沿自己的科研问题选择一条具体路径:若要测面积,先完成像素输出与指标;若要逐个操作对象,加入实例身份;若要按自然语言选择对象,再追踪语言条件如何进入视觉判断。主讲三部分的连接就落在这些输入输出关系上。

图示条件与公式约定

此处提出新的语言对应目标,不把添加一个文字节点当作已经训练成功。画中实例轮廓与指代词都是教学说明。

这条线索的展开与后续阅读

区域、像素与实例带着空间接口,怎样进入实验与语言任务?

选择一项完整实验,不按编号机械运行

按科研问题选择定位或像素路径,再用解析练习补齐具体疑问。

这条主线的课后顺序:先看输出,再做一项完整实验

独立阅读

不必按 Notebook 编号把所有内容从头运行。若刚听完课堂,先用 P25 的同一底图区分类别、框、语义与实例,再用 P41–45 的两个算例区分读取错位与表示碰撞。它们构成理解空间任务所需的最短连续线。

随后只选一项完整学习过程:关心对象位置就读 LAB10,沿图像、目标、匹配、分类/位置损失、预测与错误图走完;关心面积或边界就读 LAB11,比较 RGB 基线与 FCN、查看逐类 IoU 与窄缝错误。无需为了“完整”同时训练两本,也不要把只跑通环境当成理解模型。

LAB09 是检测公式的工作台,遇到匹配、NMS 或 AP 不清时按问题查;LAB03 是同源场景与空间读数的轻量练习。LAB16 的颜色连通域和 LAB20 的集合匹配放在选读,分别解释提示约束和对象排列,不与两项主实验争夺主线。

CLS02 提供区域到掩码的连续导读;CLS07、CLS08 分别展开检测公式与实例输出。各处按教师定稿名称和稳定 ID 回链。每个解释块有独立 URL,可直接带着具体问题交给 AI;链接中的正文先提供推理,再连接代码与原论文。

沿这个问题继续

先读本页解释与图,再到 LAB03 改一个坐标或对象。

按问题回查的讲解与短练习(7)

沿这个问题继续

先沿 CLS07 定位检测几何与评价疑问,再选 LAB09 做解析练习,或沿 LAB10 走完一次完整检测学习。其余入口见本部分更多学习路径。

按问题回查的讲解与短练习(6)

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:两张特征图相加,就能还原这张杯柄照片吗?

教师:本页不是还原RGB。照片是参考,输出是像素类别;融合提供两种尺度的线索,是否真的减少空洞或边界错误,要看预测与目标的比较。

沿这个问题继续

先读 CLS08 的像素目标与指标,再到 LAB11 查看已有预测、RGB 基线和错误图。其余入口见本部分更多学习路径。

按问题回查的讲解与短练习(7)

出处:FCN (2015)

沿这个问题继续

选择定位或像素的一项完整实验;带着对象与条件的问题进入 P49。

按问题回查的讲解与短练习(7)

III · 视觉与语言

语言怎样成为输出、监督和任务条件?

语言加入后,任务究竟改变了什么?

同一幅图像中的语言,是输出、监督,还是任务条件?

视觉与语言语言加入后,任务究竟改变了什么?

同一画面,先辨认四种输出

解释、算例与证据

P49 · 同一幅画面,语言提出不同的问题

第三部分仍从同一场景出发,只改变语言的作用。请先对照四个输出:句子、候选分数、区域、答案。它们都可以使用视觉和语言,却不是同一个任务换四个名字。读完本页,应能为任一请求说出输入、输出与目标来源,再按自己的问题进入后面的说明。

描述红衣人拿着一个篮球。匹配A 红衣人拿球 / B 蓝衣人拿球指代“拿球的人” → 人物区域问答谁拿着球? → 红衣人同一图像句子 · 选择 · 区域 · 答案场景与输出均为任务示意;本页没有运行描述、定位或问答模型。

同一张红蓝衣人物持球图,金色教学框覆盖画面中可见的完整红衣持球人物;右侧比较描述、文字匹配、指代人物区域和问题答案四种输出。

  • 描述
  • 红衣人拿着一个篮球。
  • 匹配
  • A 红衣人拿球 / B 蓝衣人拿球
  • 指代
  • “拿球的人” → 人物区域
  • 问答
  • 谁拿着球? → 红衣人
  • 同一图像
  • 句子 · 选择 · 区域 · 答案
  • 场景与输出均为任务示意;本页没有运行描述、定位或问答模型。
同一张红蓝衣人物持球图,金色教学框覆盖画面中可见的完整红衣持球人物;右侧比较描述、文字匹配、指代人物区域和问题答案四种输出。 查看对应图解状态
查看完整图解

课堂讲述

现在不换图,只换我们怎样使用语言。可以让模型描述整幅画面,可以问哪句话更匹配,可以说“拿球的人”要求它找到区域,也可以直接问“谁拿着球”。 这几种任务共享图像和文字,却需要不同的输出。描述要产生句子,匹配要比较候选,grounding 要指向局部区域,问答要在问题条件下提取并表达信息。 我们接下来不是沿着能力演示一路升级,而是看这些接口各自需要什么学习过程。它们也不是严格按这个顺序在历史上出现。理解研究的关键,是看到视觉特征、语言建模、配对数据和任务定义怎样在不同时点组合起来。

同一幅图像的四种任务契约

独立阅读

把两个人和一个球的同一幅图保持不动,可以提出四个不同任务。差别首先在输出,而不在模型名字。

请求 实际输入 要交付的输出 训练材料应提供什么
描述画面 图像 一段新句子 图像与参考描述
哪句话匹配 图像与文字候选 每个候选的分数或排名 已配对图文及对比关系
找到拿球的人 图像与指代短语 对象身份及框/区域 短语与区域对应、定位目标
谁拿着球 图像与问题 问题条件下的答案 图像、问题、答案

“红衣人拿着球”可以同时是参考描述、匹配候选和问答的解释,但它们在训练中扮演的角色不同。描述模型要知道怎样产生这句话;匹配模型可以只在已经给出的两句话之间选择;grounding 还要输出坐标。一个很好的相似度分数不能直接替代这些不同输出。

第二部分已经建立区域和像素接口。第三部分把语言加入之后,继续追问:语言在本次计算里是目标、监督来源还是任务条件?这三个角色可以共存。视觉助手收到一个问题、参考图像并生成回答时,问题是条件,回答是生成目标,而训练时的图文和指令数据是学习信号。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:模型最后都能说一句话,为什么还要分任务?

教师:请先看模型是否真的产生新句子。两候选选择只需两个分数;描述要在许多下一词之间逐步决定;定位还需区域坐标。输出要求决定需要什么训练证据。

沿这个问题继续

先回看本页画面并指出输入、条件和输出,再按“同一幅图像的四种任务契约”阅读。相关实验以其已保存结果为起点,需要动手时再顺序执行 Notebook;

图示条件与公式约定

同一场景的描述、匹配、指代与问答输出全部为人工定义的任务示意;金色框指向画面中的红衣持球人物,不是球和手。没有在本轮执行这些模型。

这条线索的展开与后续阅读

视觉与语言语言加入后,任务究竟改变了什么?

把技术史读成尚未接通的问题

四种任务要求不同输出;研究史要比较它们接通了哪条关系。

解释、算例与证据

P50 · 2014—2016:几条准备已久的路线相遇

本页把研究史当作问题史阅读:视觉表示、文字预测和数据已经可用,研究者分别选择描述、局部对应与问答。对照这些工作各自改变了什么、取得了什么结果,再理解研究者为什么继续推进。公开人物背景用于定位当时的研究环境。

本页独立阅读
可复用视觉特征文字序列预测图文数据与共同评价分类预训练区域表示已有文字 → 后续文字可变长度输出图像—描述图像—问题—答案2013DeViSE视觉—语义空间2014LRCN / Show and Tell图像描述2015区域—句子对齐 / VQA局部对应与问题条件2016DCC未配对类别的描述Trevor DarrellMIT 教职 1999—2008 → Berkeley,2008R-CNN、FCN、LRCN 的共同作者之一积累汇合,让新问题可训练:说出内容 · 对应局部 · 按问题回答年份标示预印本或会议窗口;技术联系不等于私人动机或单一研究者的谱系。

视觉预训练、文字序列预测与配对数据三条积累进入2013至2016的研究时间带;下方提供Trevor Darrell公开研究背景。

  • 可复用视觉特征
  • 文字序列预测
  • 图文数据与共同评价
  • 分类预训练
  • 区域表示
  • 已有文字 → 后续文字
  • 可变长度输出
  • 图像—描述
  • 图像—问题—答案
  • 2013
  • DeViSE
  • 视觉—语义空间
  • 2014
  • LRCN / Show and Tell
  • 图像描述
  • 2015
  • 区域—句子对齐 / VQA
  • 局部对应与问题条件
  • 2016
  • DCC
  • 未配对类别的描述
  • Trevor Darrell
  • MIT 教职 1999—2008 → Berkeley,2008
  • R-CNN、FCN、LRCN 的共同作者之一
  • 积累汇合,让新问题可训练:
  • 说出内容 · 对应局部 · 按问题回答
  • 年份标示预印本或会议窗口;技术联系不等于私人动机或单一研究者的谱系。
视觉预训练、文字序列预测与配对数据三条积累进入2013至2016的研究时间带;下方提供Trevor Darrell公开研究背景。 查看对应图解状态
查看完整图解

2014—2016:组件到位后,新的研究问题怎样出现

独立阅读

这段历史可以按“哪项能力已经可复用,哪条关系还没有学会”阅读。卷积网络已经能提供视觉特征;文字预测器能组织可变长度输出;图文配对和共同评价数据使不同系统能在同一问题上比较。于是连接视觉与语言开始具有可操作的实验入口。

LRCN 和 Show and Tell 在 2014 年发布预印本、2015 年发表,研究怎样把视觉信息送入文字输出。区域—句子对齐把对应关系细化到局部;VQA 则让问题决定当前要读什么。它们不是同一系统的连续版本,不能画成“描述完成后才有对齐,再完成后才有问答”的单行升级史。

研究进展不仅是多了一种漂亮演示。Show and Tell 在其论文中的 COCO 协议报告 BLEU-4 27.7,并在多个数据集比较描述质量;这个历史结果说明学习图像条件的句子分布能够产出可比较的描述系统。数字属于当时模型与评价协议,不是本课程 Lab 的分数。区域对齐工作又在图文检索和区域描述中展示了局部对应的价值。这里“为什么值得继续研究”的答案,是新接口已经带来可测量的任务能力,随后才能进一步问它遗漏了什么。

Trevor Darrell 是 LRCN 等工作的共同作者,其公开研究涉及视觉感知与语言、人机交互的连接。课程借此展示一条公共研究脉络;个人经历、合作动机或具体对话不由论文作者名单推断。

沿这个问题继续

沿 2014—2016 年的时间线,比较 caption、区域对齐与 VQA 各自的输入和输出;再到 P51 追踪图像描述的训练目标。

课堂讲述

2014 到 2016 年是一个适合观察的窗口。视觉端已经有可复用的深度特征,文字端可以组织可变长度的输出,图文数据和共同评价让这些任务能够真正训练和比较。 Berkeley 相关的 LRCN、Google 的 Show and Tell,以及 Stanford 的区域—句子对齐,选择了相近条件下的不同问题:怎么描述、怎么对应局部、怎样把视觉信息送进文字任务。VQA 则把“根据这幅图回答指定问题”明确地组织成研究任务。 这不是图像与语言第一次相遇,也不是一个人给领域起名后大家才开始。它更像几条已有积累到了一起可以做实验的时候。研究者的选择,在于看见哪一个还没有接通的关系,并把它变成能够训练和检验的问题。

图示条件与公式约定

公开背景据 Berkeley EECS 页面及其 2008 年历史主页:Trevor Darrell 在 MIT 任教 1999—2008,2008 年转赴 Berkeley。他是 R-CNN、FCN、LRCN 共同作者之一。这里只陈列公共研究背景,不推断个人动机或具体贡献。时间带中的 2014 使用 LRCN 与 Show and Tell 的预印本年份,会议出版均为 2015。

这条线索的展开与后续阅读

图像怎样约束一句新生成的描述?

从训练目标到自由生成,怎样检查模型实际使用了图像?

视觉与语言图像怎样约束一句新生成的描述?

沿视觉条件找到下一词目标

解释、算例与证据

P51 · 图像描述:视觉内容怎样成为一句话?

先沿画面指出视觉特征进入哪里,再指出已有文字与下一词目标。连续说明展开 shifted target、EOS、PAD 和实际生成,LAB13 提供已保存的实验结果。理解本页可先把文字预测器作为输入输出模块;整数移位只演示目标构造,完整图像描述还需要图像条件与实际生成。

视觉编码器图像 → 特征两条合理描述“两个人站在一起。”“红衣人拿着篮球。”文字预测器允许看到的前文 + 视觉红衣人 拿着球下一个目标图文配对给出文字目标;页面展示训练接口与参考描述,没有展示模型生成结果。

图像先编码为视觉特征;视觉条件与已有文字一起进入文字预测器,前文从红衣人推进到红衣人拿着。

  • 视觉编码器
  • 图像 → 特征
  • 两条合理描述
  • “两个人站在一起。”
  • “红衣人拿着篮球。”
  • 文字预测器
  • 允许看到的前文 + 视觉
  • 红衣人 拿着
  • 球
  • 下一个目标
  • 图文配对给出文字目标;页面展示训练接口与参考描述,没有展示模型生成结果。
图像先编码为视觉特征;视觉条件与已有文字一起进入文字预测器,前文从红衣人推进到红衣人拿着。 查看对应图解状态
查看完整图解

课堂讲述

以图像描述为例,输出不再是固定类别,而是一段可变长度的文字。训练材料给出图像和描述,视觉特征与允许看到的前面文字一起,为后面的预测提供条件。 注意,这里用的是图文配对监督,不是图像自己自动长出文字标签。不同描述可以关注不同内容:“两个人站在一起”概括人物和位置,“红衣人拿着球”指出动作主体。两句都能从当前画面得到支持。 所以这个任务既要求视觉表示支持文字表达,也要求评价容纳多种合理描述。我们现在看完整的信息流和训练材料,不展开 RNN 或 Transformer 的内部机制。那部分留到第五讲,今天必须讲清的是:视觉信息从哪里进入,文字目标从哪里来,为什么流畅句子还要对得上画面。

图像条件怎样进入一个可变长度答案

独立阅读

图像描述要建模的是 pθ(y1,…,yT∣I)p_\theta(y_1,\ldots,y_T\mid I)。链式法则将它分解为 ∏tpθ(yt∣y<t,I)\prod_t p_\theta(y_t\mid y_{<t},I):每一步都在图像和此前文字的条件下预测后续文字。这个分解是概率关系,不要求本讲先学完一种具体文字网络。

指着 P51 的图看三个位置:图像编码器把像素变成视觉特征;文字预测器同时接收视觉条件与已有文字;目标位置从“红衣人”后的“拿着”,推进到“红衣人拿着”后的“球”。如果删除视觉路径,模型仍可能补出语法合理的句子,却失去了判断画面到底是谁拿球的信息来源。

训练图文配对提供目标句子,而不是图片自行生成唯一文字标签。一幅图可以被说成“两个人站在一起”,也可以被说成“红衣人拿着球”。前者省略衣色,后者聚焦动作主体,两句都可能真实。训练学习的是这种条件下的表达分布;教师还需要说明任务要求概括、细节描述还是完整枚举。

推理时没有参考句子可偷看。模型从开始符号出发,输出一个词,再把这个词接到自己的上下文,直到结束符号或长度上限。完整的实验必须有实际图像、可学习参数、词目标、优化和这条自由生成过程。网页上推进的参考词是教学目标示意;实际生成与视觉对照放在 LAB13。

图示条件与公式约定

两条参考描述由课程作者写出。推进展示“红衣人”之后预测“拿着”,以及“红衣人拿着”之后预测“球”;这些是监督目标示例,并非实测解码结果。

这条线索的展开与后续阅读

视觉与语言图像怎样约束一句新生成的描述?

对齐前缀、目标与有效损失位置

图像与已有文字提供条件;下一步要明确每个位置到底预测什么。

训练前缀、EOS 与 PAD:损失究竟算在哪些位置

独立阅读

假设一条参考句为 a red square,词序列写成 [BOS,a,red,square,EOS]。训练输入去掉最后一项,目标去掉第一项。两者一一对齐:

已允许看到的文字 当前目标
BOS a
BOS a red
BOS a red square
BOS a red square EOS

如果批中还有更长句子,就给短句末尾补 PAD,使张量长度一致。PAD 只是存储约定,不是要生成的文字;EOS 却是有效的停止目标。掩掉 PAD 时把 EOS 一起掩掉,会抹去何时结束的监督。

词损失可写为 L=−∑i,tmitlog⁡pθ(yit∣Ii,yi,<t)/∑i,tmitL=-\sum_{i,t}m_{it}\log p_\theta(y_{it}\mid I_i,y_{i,<t})/\sum_{i,t}m_{it},其中 mit=1m_{it}=1 表示目标不是 PAD。分母按有效词计数,不按补齐后的格数计数。LAB13 的 prefix=Y[:,:-1]、targets=Y[:,1:] 和 ignore_index=PAD 对应这三个选择。

训练时喂真实前缀叫 teacher forcing。推理时前缀来自模型自己:若先误说 blue,后续就必须在 blue 的条件下继续,不能偷偷换回 red。因此保留集的逐词交叉熵与自由生成的整句正确率要分别读;两者评价的输入条件不同。

视觉与语言图像怎样约束一句新生成的描述?

先读固定前缀下的视觉对照结果

词级损失描述训练;自由生成和视觉干预才能检查当前任务中的视觉作用。

已保存的条件生成实验:视觉输入确实改变了句子

独立阅读

LAB13 当前保存的是 2026-09-22 本地 CPU 基准,当前整理没有重新训练。输入为真实渲染的 32×3232\times32 RGB 图像;训练 720 张,保留 180 张。颜色、形状、位置共有 18 种组合,两侧都包含这些组合,但保留图由独立随机渲染产生、像素哈希不重复。这检验新渲染泛化,不是未见组合泛化。

CNN 输出 48 维视觉向量;文字单位有 24 维嵌入;实验采用一个小型 GRU 文字模块。今天把它作为已明确输入输出的实现,内部循环状态留第五讲。视觉向量确实参与每一步预测,并用于初始化文字模块;真实颜色或位置标签只用于构造监督,不作为推理输入。

同一组 180 张保留图 整句精确匹配
正确图像,greedy 生成 100%
正确图像,beam 宽度 3 100%
同一模型,像素置零 5.56%
同一模型,图像循环错配 0%

固定前缀 BOS a,红方块左侧图生成 a red square on left,蓝圆右侧图生成 a blue circle on right。这里正面成立的判断是:这个有限任务中,训练后的输出使用了正确视觉条件。两种搜索同分,不支持 beam 比 greedy 更好;零图像是分布外条件,错配对照则进一步隔离了图像对应关系。自然图像有多种合理描述,不能把这里唯一规范句子的精确匹配直接移作通用 caption 评价。

固定前缀下的真实生成

图片与数字均来自已保存基准,不是把数据生成器的目标文字重新印成“模型回答”。

视觉与语言图像怎样约束一句新生成的描述?

找出物体与词语之间尚未学会的使用关系

解释、算例与证据

P52 · 认识一个物体,为什么未必会把它说出来?

本页的缺口发生在“知识如何共同使用”:视觉认识某物体、文字存在对应词,并不自动提供描述时的连接规则。DCC 的新颖对象限定在配对描述资料,而非所有数据。课程零件 K 是解释用例,理解这一限定后再回看 LLaVA 的接口学习。

课程构造:视觉类别“零件 K”已见,配对描述中未见类别:零件 K文字材料“零件 K 安装在支架上。”“工人检查了零件 K。”这个词已出现在文字里配对描述训练图像 ↔ 句子已有其他对象的配对缺少零件 K 的配对把两边的知识组合成描述DCC 的问题:在配对描述中未见,仍能否说出?DCC(CVPR 2016)研究设定的教学转写;零件 K 不是原论文样本或原论文输出。

独立的零件类别图像、包含零件词的文字语料与缺少该类别的配对描述训练集,组成DCC要解决的组合缺口。

  • 课程构造:视觉类别“零件 K”已见,配对描述中未见
  • 类别:零件 K
  • 文字材料
  • “零件 K 安装在支架上。”
  • “工人检查了零件 K。”
  • 这个词已出现在文字里
  • 配对描述训练
  • 图像 ↔ 句子
  • 已有其他对象的配对
  • 缺少零件 K 的配对
  • 把两边的知识组合成描述
  • DCC 的问题:在配对描述中未见,仍能否说出?
  • DCC(CVPR 2016)研究设定的教学转写;零件 K 不是原论文样本或原论文输出。
独立的零件类别图像、包含零件词的文字语料与缺少该类别的配对描述训练集,组成DCC要解决的组合缺口。 查看对应图解状态
查看完整图解

课堂讲述

DCC 问了一个很有意思的问题:视觉端可能已经认识某类物体,语言材料里也存在这个词,但描述系统没有见过它的图文配对,能否把两种知识组合起来? 这里的新颖不是“世界上从未出现过这个物体”,而是相关组合没有出现在配对描述训练里。研究把独立的视觉知识、文字知识和图文组合分开,才有办法检查连接能力。 这对我们很重要。两个组件分别掌握了一些知识,不等于接到一起就已经会共同使用。我们后面看到视觉编码器接入语言模型,也要问同样的问题:接口的形状对上了,什么关系还需要数据与训练去建立?

DCC:分别认识物体和词语,为什么还不会组合描述

独立阅读

想象视觉分类器已会识别一种零件 K,文字语料也出现过“零件 K”,但图像描述训练集从没有 K 的配对句子。两个模块分别有知识,不等于联合系统已经知道在什么视觉条件下、怎样把 K 放进一条描述。

DCC 将这个缺口明确为研究设定:某对象不在配对图像—句子训练资料里,却可以出现在独立类别图像和未配对文本中。方法利用这些外部知识并在语义相近概念间迁移,使描述模型能够提及配对训练中缺席的对象。论文在 MSCOCO 上做经验评价,也展示无配对描述的 ImageNet 类别例子。这是“组合与迁移需要额外机制”的正面案例,而不是宣称从所有数据中都没见过对象。

网页零件 K 是课程自定例子,不是原论文类别或逐字输出。它帮助拆开三个来源:视觉证据教“它长什么样”,文字语料教“这个词怎样使用”,配对数据或迁移机制教“在什么画面里应该说它”。若只在两端各测一次准确率,就没有直接检验第三项。

这也预告 P64 的问题。投影层让视觉向量在维度上接得上语言模型,只解决接口的形状;根据视觉条件正确使用已有词语,还需要训练建立联合使用关系。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:既然分类器认识 K,把分类结果接进句子就行吗?

教师:这是可用基线,但还要决定词形、位置和与其他对象的关系。DCC 的问题是怎样利用独立视觉和文字知识填补配对数据缺口。

沿这个问题继续

先区分“认识物体”“有对应词语”和“能组合成描述”三件事。读 DCC 对新颖对象的限定,再与 P64 的视觉—语言接口学习比较。

图示条件与公式约定

图中的零件 K 是课程自己的概念例子;不是 DCC 原始实验类别,也不是原论文逐字生成结果。DCC 处理相关物体不在配对图文训练数据中的设定,但可以使用未配对的类别图像和文字语料。

语言怎样选择当前需要的视觉信息?

局部对应、问题条件和联合预训练分别增加了哪条关系?

视觉与语言语言怎样选择当前需要的视觉信息?

把名词对应与关系绑定分开

解释、算例与证据

P53 · 一句话里的词,指向图中的哪一部分?

在同一图上分开读实体和关系。三个名词可以各自对应框,“拿着”却必须绑定正确人物与球。局部区域使语言有可以指向的对象,但关系不由找到两个对象自动获得。图上的人工标注说明任务,已保存的像素规则实验则给出可检查的输出链。

红衣人拿着球实体:对应局部内容关系:连接人物与球区域表示 + 语言片段 → 学习更细的对应教学框与关系弧线;区域对齐方法并不因此自动获得全部动作关系。

红衣人、蓝衣人与球各有局部框,句中的实体连接区域,拿着连接人物与球的关系。

  • 红衣人
  • 拿着
  • 球
  • 实体:对应局部内容
  • 关系:连接人物与球
  • 区域表示 + 语言片段 → 学习更细的对应
  • 教学框与关系弧线;区域对齐方法并不因此自动获得全部动作关系。
红衣人、蓝衣人与球各有局部框,句中的实体连接区域,拿着连接人物与球的关系。 查看对应图解状态
查看完整图解

课堂讲述

整图和句子匹配,可以告诉我们它们总体相关,但句子里每个片段对应什么,还需要更细的组织。区域—语言对齐把注意力转向这些局部关系。 “红衣人”不是一整张图,“球”也不是;“拿着”更不是单独一个物体标签,它描述对象之间的关系。一个系统即使找到了人物和球,也可能把动作关系说错。 在这个位置,第二部分的区域表示就有用了:已经能够提取局部视觉内容,语言端又提供了可对齐的片段。新的训练任务要把它们接起来,而不是把整图相似度当成所有局部关系都已解决的证据。

从整图相关到局部对应:名词与关系不是同一层信息

独立阅读

整图相似度可以说“这幅画面与两人持球有关”,却没有说明“红衣人”对应哪块像素、“球”是哪一个区域。把第二部分学过的区域表示取出来,句中的片段就有了可以对齐的视觉对象。

P53 中,红衣人、蓝衣人和球分别有候选框;“红衣人”和“球”可以各自指向区域。但“拿着”不是第四种独立物体,它描述两个实体之间的关系。即使候选框都正确,如果把关系连到另一位人物,整句依然错误。实体识别和关系绑定因而要分别检查。

Karpathy 与 Li Fei-Fei 的区域—语言对齐工作从图像与句子资料学习局部跨模态对应,并进一步生成区域描述;论文在图文检索及区域描述上给出实证。其价值是让局部对应成为可学习、可复用的对象,而不是把整图压成一个类别之后才补语言。课堂图上的框和关系线是人工标注,不冒充该论文或本课程模型的预测。

做一个最小自查:把句子改为“蓝衣人在红衣人旁边”,两个实体框可能保持不变,关系应随语句变化;改为“拿着球的人”,输出目标变成受关系约束的人物。区域表示提供候选,语言条件决定怎样选择,二者缺一不可。

沿这个问题继续

先回看本页画面并指出输入、条件和输出,再按“从整图相关到局部对应:名词与关系不是同一层信息”阅读。相关实验以其已保存结果为起点,需要动手时再顺序执行 Notebook;

图示条件与公式约定

当前实际人物场景不含桌子,按本图的红衣人、蓝衣人、球组织局部框。框由课程手工标注,关系弧线说明目标而不声称模型已预测。

这条线索的展开与后续阅读

视觉与语言语言怎样选择当前需要的视觉信息?

同图换问,再同问换图

解释、算例与证据

P54 · VQA:问题决定此刻需要哪一项信息

问题在这里选择要读的信息,同一图可以问数量、属性和关系。本页说明沿两个方向组织检查:同图换问、同问换图。LAB14 当前已经有读取像素的可学习分支和单独训练的 question-only,对象属性字典保留为 oracle 热身;三种身份应分别阅读。

不给图片有几个人?需依据图像确定谁拿着球?需依据图像确定球是什么颜色?需依据图像确定同一问题,换掉相关图像,正确答案应怎样改变?答案为人工核对的场景属性;“不给图片”展示评价条件,不是模型问答实验。

相同人物图像对应数量、持球者、球色三问;另一状态隐藏图片并将答案改为需依据图像确定。

  • 不给图片
  • 有几个人?
  • 需依据图像确定
  • 谁拿着球?
  • 需依据图像确定
  • 球是什么颜色?
  • 需依据图像确定
  • 同一问题,换掉相关图像,正确答案应怎样改变?
  • 答案为人工核对的场景属性;“不给图片”展示评价条件,不是模型问答实验。
相同人物图像对应数量、持球者、球色三问;另一状态隐藏图片并将答案改为需依据图像确定。 查看对应图解状态
查看完整图解

课堂讲述

同一张图可以支持很多问题。问数量、颜色或者持有关系,需要从相同画面中提取不同信息。VQA 把问题本身变成输入的一部分,让任务不再只有“描述一遍”。 训练时需要图像、问题和答案。早期系统可以从有限答案集合中选择,后来的模型也可以生成答案;两种接口不同,但都要检查回答是否真正利用了图像。 有些问题可以靠常见答案猜对。例如某种训练分布里,某个问法总对应同一种颜色。为了区别猜测和视觉利用,可以保持问题不变、替换相关图像,再看答案是否合理改变。我们先看清成功应该意味着什么,而不是只看一次回答听起来像不像人。

VQA:同图换问题,同问换图

独立阅读

VQA 的目标是 p(a∣I,q)p(a\mid I,q)。问题 qq 不只是输出旁的装饰,而是决定应该从图像中读取什么:问“有几个人”需要数量,问“谁拿球”需要关系,问“球是什么颜色”需要属性。保持图像固定,改变问题,正确答案就可能改变;保持问题固定,改变相关图像,正确答案也应变化。

一个封闭答案模型可以在预设词表里分类,一个生成式模型可以逐词回答。前者易于定义准确率,但答案范围受词表限制;后者表达更灵活,却需要处理同义表达、冗长回答和证据对应。不能只把分类头输出的一个标签换成长句,就称为具有新的视觉推理能力。

语言先验是有用的知识,也可能成为捷径。如果训练里“左边物体什么颜色”通常答红色,question-only 模型能取得不错成绩,却无法应对同问题下的蓝物体。VQA v2 的研究用相同问题、不同正确答案的成对图像,加强视觉证据在评价中的作用。这种设计把“答对”进一步变成“答对所需的信息确实来自图像”。

课堂上可先固定图 A 左红右蓝:问左颜色答红,问右颜色答蓝。再换成左蓝右红的图 B,保持左颜色问题,此时应答蓝。三次比较让图像条件和问题条件分别显示作用。读取场景字典中的 left_color 是已知属性 oracle,它能检验问答逻辑,但不能检验从像素感知颜色。

图示条件与公式约定

图示答案是人工核对的场景属性:2 人、红衣人持球、橙色篮球。无图状态不展示模型猜测,没有执行新 VQA 实验。

这条线索的展开与后续阅读

视觉与语言语言怎样选择当前需要的视觉信息?

先算结构化基线,再读像素问答结果

一次无图答对不足以判断图像有没有作用;先根据三个任务计算可比较的基线。

已保存的像素 VQA:为什么 44.44% 是结构化基线

独立阅读

LAB14 在 2026-09-22 保存了本地 CPU 学习结果,本次整理没有重跑。720 张训练图和 180 张保留图先按图像生成和划分,再对每图提出三种固定模板问题,共 2160/540 个图问对。模型实际读取 RGB 像素和问题 ID,不读取生成器属性字典。

保留任务分别是数量二选一、左侧颜色三选一、右侧形状二选一。只知道问题时,各任务的最佳常量正确率为 1/2,1/3,1/21/2,1/3,1/2,平均 (1/2+1/3+1/2)/3=4/9(1/2+1/3+1/2)/3=4/9。把所有七种答案混在一起写“机会率 1/7”会忽略问题已给出的答案类型。

保留条件 数量 左色 右形 全部
图像+问题 100% 100% 100% 100%
单独训练 question-only 50% 33.33% 50% 44.44%
同一视觉模型,像素置零 50% 33.33% 50% 44.44%
同一视觉模型,循环错配图像 83.33% 50% 0% 44.44%

最后一行不是随机机会率:数据按组合排列,循环移位常保留数量却恰好改变形状,因此总分相同仍有不同错误来源。正确图像下的模型通过了三个有限任务;像素置零和错配的下降支持它使用正确视觉输入。训练左侧红色比例为 73.61%,保留颜色均衡,进一步显示问题先验不能替代视觉读取。

同图换问、同问换图

问题输入在这里是三个模板 ID,不是任意句子的语言理解。先承认这个小实验确实完成的像素问答,再把开放问题、未见对象与组合列为下一层检验。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:问题模型也能答对 44%,说明图像不重要吗?

教师:先看任务结构:二选一、三选一、二选一的常量基线平均就是 4/9。视觉模型在相同保留图问对达到 100%,且错配后下降,才说明这里增加的图像条件有作用。

沿这个问题继续

先回看本页画面并指出输入、条件和输出,再按“VQA:同图换问题,同问换图 → 已保存的像素 VQA:为什么 44.44% 是结构化基线”阅读。相关实验以其已保存结果为起点,需要动手时再顺序执行 Notebook;

出处:VQA(2015)
视觉与语言语言怎样选择当前需要的视觉信息?

复用组件以后,还要学习哪些对应?

解释、算例与证据

P55 · 区域表示与语言预训练,有了可连接的部件

ViLBERT 让前面两部分的积累变得具体:检测器提供区域表示,语言预训练提供文字表示,新的预训练目标学习二者怎样共同服务任务。读本页不需要展开 attention;重点是指出可复用组件、尚未学会的对应以及跨任务迁移的研究证据。

区域视觉输入检测器留下的区域特征语言输入“红衣人拿着球”预训练的文字表示ViLBERT · 2019跨模态目标学习对应图文匹配遮挡内容预测适配问答与检索等任务检测器区域特征与预训练语言表示是实际组件来源;此页仅呈现模块接口。

左侧检测器区域特征、右侧预训练语言表示,进入ViLBERT的跨模态目标,再适配问答或检索。

  • 区域视觉输入
  • 检测器留下的区域特征
  • 语言输入
  • “红衣人拿着球”
  • 预训练的文字表示
  • ViLBERT · 2019
  • 跨模态目标学习对应
  • 图文匹配
  • 遮挡内容预测
  • 适配问答与检索等任务
  • 检测器区域特征与预训练语言表示是实际组件来源;此页仅呈现模块接口。
左侧检测器区域特征、右侧预训练语言表示,进入ViLBERT的跨模态目标,再适配问答或检索。 查看对应图解状态
查看完整图解

课堂讲述

到了区域语言预训练这一类工作,前面的积累开始以模块形式汇合。以 ViLBERT 为例,一边是检测器提取的区域表示,另一边是语言预训练,再通过跨模态目标学习它们怎样配合。 这条连接值得看,不是因为今天必须掌握完整网络结构,而是它让技术演进变得具体:检测研究留下的区域特征,能成为视觉语言系统的输入;语言研究留下的表示,也不用每个视觉任务从零学。 但新的对应关系仍要训练。复用组件不等于复用完整能力。这是今天不断出现的同一个模式:已有表示降低了新问题的起步成本,新任务又反过来要求不同的接口、监督和评价。

ViLBERT:把已有区域和文字表示变成可迁移的联合起点

独立阅读

第二部分的检测器不只留下“这里有杯子”的类别输出,也能留下每个候选区域的特征。语言预训练同样留下文字表示。ViLBERT 将两侧的已有能力接入跨模态预训练,再适配问答、指代表达、常识推理与图文检索等任务。

为什么不直接拼起来就结束?设区域向量来自检测器、词向量来自文字模型。两个向量长度可以相同,但相同坐标号并不自动代表同一种语义。跨模态目标要学习哪些局部与哪些文字对应、哪些信息可以共同预测。维度匹配只让计算合法,训练才使这条关系有任务含义。

原论文通过代理预训练任务学习联合表示,再对四类视觉语言任务做少量结构增补与任务适配,报告了相对当时任务专用模型的改善。它支持的研究方向是:区域—语言对应可以成为预训练并迁移的能力,未必每个下游任务都从头建立全部对应关系。这里保留这一正面进展,不展开内部注意力实现。

阅读图时注意“可复用”有两个尺度:检测器区域特征作为输入被复用,跨模态预训练后的表示又被多个任务复用。二者都不是说下游无需目标数据或评价。若关心小字、细小对象或未被候选器提出的区域,首先还要检查最前面的视觉输入是否已经丢失所需证据。

沿这个问题继续

先辨认区域表示和文字表示分别来自哪个已有组件,再读图文匹配、遮挡预测和下游迁移的关系;用输入与目标对照下一页的 CLIP。

图示条件与公式约定

此页以原始 ViLBERT 为例,展示检测器区域表示和预训练语言表示进入跨模态训练的模块关系;不展开内部架构。

这条线索的展开与后续阅读

已知图文配对怎样变成可用的文字候选接口?

从一对输入到双向损失,再到真实候选干预,哪些量由训练决定、哪些由使用者决定?

视觉与语言已知图文配对怎样变成可用的文字候选接口?

从固定标签表到已知图文配对

解释、算例与证据

P56 · CLIP 选择的任务:先学哪幅图与哪段话相配

CLIP 选择配对识别作为学习任务。两套编码器各自处理图片和文字,配对资料指出哪些对应应更容易被选出。与图像自监督对比的联系是训练关系的来源不同;文字监督拓展语义供给,下一页才用矩阵落实损失。

图像编码器“红衣人拿着篮球,旁边站着蓝衣人。”文字编码器文字 → 向量比较训练答案:这一图像与这一段文字配成一对向量条纹仅标示接口,未作定量含义;CLIP 学习图文匹配,不在此分支生成完整句子。

图像 Iᵢ → 图像编码器 f → 单位向量 vᵢ;配对文字 Tᵢ → 文字编码器 g → 单位向量 uᵢ。

比较 Sᵢⱼ = vᵢᵀuⱼ。已知图文配对提供训练答案;无需先生成句子。图中条纹表示接口,不是实测分数。

图像和文字分别编码成向量,在共享空间比较;图文配对提供训练答案。 查看对应图解状态
查看完整图解

课堂讲述

如果希望利用更多图文配对,不一定非要从图片预测描述中的每一个准确词语。CLIP 选择了更直接的对应任务:让配对图文的表示相互匹配。 这里我们可以复用第一部分的理解。那里比较的是同一图像产生的不同视图;这里比较的是图像与文字。训练目标仍然围绕对应关系,但文字带来了人已经组织过的语义。 两边各有编码器,并不是先把图片翻译成完整句子,再拿句子比较。编码器把它们送进可比较的表示空间。这个任务到底怎样形成监督,下一页用一个很小的批次完整走一遍。

CLIP:文字怎样从标签表变成学习信号

独立阅读

监督分类先规定一个类别表,再让模型预测表中的索引。图文配对可以提供更丰富的语义:文字可能同时包含对象、属性、动作和场景。CLIP 选择一个可扩展的任务——在一批图文中识别原有配对——把这些描述用于训练可比较的表示。

设图像编码器为 ff,文字编码器为 gg,归一化后得到 vi=f(Ii)/∥f(Ii)∥v_i=f(I_i)/\|f(I_i)\|、uj=g(Tj)/∥g(Tj)∥u_j=g(T_j)/\|g(T_j)\|。两个编码器分别处理各自输入,然后用点积 Sij=viTujS_{ij}=v_i^Tu_j 比较。没有先让图像生成一句话,再把两句话相互比较。

与第一部分的图像对比学习相连:两张增强视图的正关系来自同一原图;CLIP 的正关系来自资料中的图文配对。文字已经包含人的选择和表达,因此“没有固定类别标签”不等于“没有人类监督”。

训练完保留两套编码器,新图像与新文字可以进入同一比较接口。使用者能更换候选描述或建立检索库,这是方法的正面能力。它还没有提供下一词预测分布或框回归输出;若新任务需要这些输出,要另行定义模块、目标和训练。

图示条件与公式约定

向量条纹只表示不同模态的向量接口,条纹高度没有模型分数含义。图文配对提供已知的训练对应。

这条线索的展开与后续阅读

视觉与语言已知图文配对怎样变成可用的文字候选接口?

每一行选文字,每一列选图像

解释、算例与证据

三对图文的双向损失:从单位向量到 0.09567

P57 · 一张相似度矩阵,连接训练和使用

这页的数字能从单位向量完全复算:矩阵不是模型实测成绩。先看一行的三个竞争候选,再看一列,最后对两种方向取平均。温度改变 logits 和概率,不改变原始余弦本身。真实 CLIP 的结果需读取相应模型输出,不能沿用这里的教学数值。

单位向量点积 Sᵢⱼ;教学构造I1T1红杯I2T2蓝杯I3T3人物0.80.30.00.00.80.30.30.00.8文字找图像 ↓τ = 0.2第一列 logits:4, 0, 1.5p(正确配对) ≈ 0.909−log p ≈ 0.0957行目标 + 列目标在批次中辨认配对对角线来自配对顺序;数值是由明确单位向量构造的教学矩阵,不是 CLIP 实测分数。
I₁ 红杯
I₁ · 红杯 / T₁
I₂ 蓝杯
I₂ · 蓝杯 / T₂
I₃ 人物
I₃ · 人物 / T₃

图像 I₁、I₂、I₃ 为红杯、蓝杯、人物;文字 T₁、T₂、T₃ 按相同配对顺序排列。

单位向量点积 Sᵢⱼ(教学构造)
图像/文字T₁T₂T₃
I₁.8.30
I₂0.8.3
I₃.30.8

逐行比较文字候选,逐列比较图像候选;对角线由已知配对确定。

三幅图与三段文字组成3乘3单位向量点积矩阵,先突出首行,再突出首列,并显示温度与正确项概率。 查看对应图解状态
查看完整图解

课堂讲述

假设这一批有三对图文。每幅图都和三段文字比较,每段文字也和三幅图比较,得到这张矩阵。排好顺序以后,对角线是数据中提供的配对。 训练不只是让对角线数值绝对变大,而是让正确对应相对于其他候选更容易被选出。原始 CLIP 用双向的对比目标,从图找文字,也从文字找图。 训练以后留下两个编码器。我们可以把新的图片和新的文字送进去得到相似度,这个相似度又能够服务于分类候选或者检索。到这里,训练目标、得到的表示和使用接口终于在同一张图上对齐,而不是三段互不相关的术语。

P57 的矩阵是可实现的教学算例,不是真实 CLIP 输出。图像向量取四维空间前三个单位基 e1,e2,e3e_1,e_2,e_3;文字向量为 (.8,0,.3,.27)(.8,0,.3,\sqrt{.27})、(.3,.8,0,.27)(.3,.8,0,\sqrt{.27})、(0,.3,.8,.27)(0,.3,.8,\sqrt{.27})。每个文字向量的模平方是 .64+.09+.27=1.64+.09+.27=1,所以点积确实是余弦。

S=[.8.300.8.3.30.8].S=\begin{bmatrix}.8&.3&0\\0&.8&.3\\.3&0&.8\end{bmatrix}.

图示条件与公式约定

精确构造:图像单位向量为四维空间前三个标准基 e1,e2,e3;文字单位向量 t1=(.8,0,.3,sqrt(.27)), t2=(.3,.8,0,sqrt(.27)), t3=(0,.3,.8,sqrt(.27))。故 S=[[.8,.3,0],[0,.8,.3],[.3,0,.8]],均为真实可实现的单位向量点积。温度 .2 时第一行 logits=(4,1.5,0),第一列=(4,0,1.5);正确配对概率 .9087599243,负对数 .0956743294。所有行列同样的正确概率,双向平均目标也为 .0956743294。这是教学矩阵,不是 CLIP 输出。

这条线索的展开与后续阅读

视觉与语言已知图文配对怎样变成可用的文字候选接口?

由一行和一列算出双向训练目标

上一页的矩阵给出候选关系;现在沿第一行和第一列计算正确配对的概率。

图像找文字:第一行 S₁· = (0.8, 0.3, 0);文字找图像:第一列 S·₁ = (0.8, 0, 0.3)。S 是归一化向量点积,τ 是温度;logits = S / τ,p 表示本批候选内的相对分配,L 是负对数损失。

行表示图找文字,列表示文字找图。当前排序让正确配对位于对角线。取温度 τ=.2\tau=.2,第一行 logits 为 (4,1.5,0)(4,1.5,0),正确配对概率为

p11=e4e4+e1.5+1=0.9087599243,−log⁡p11=0.0956743294.p_{11}=\frac{e^4}{e^4+e^{1.5}+1}=0.9087599243,\qquad -\log p_{11}=0.0956743294.

第一列只是将两个负项换序,概率不变;其他行列同理。双向平均损失为 L=(LI→T+LT→I)/2=0.0956743294L=(L_{I\to T}+L_{T\to I})/2=0.0956743294。一般情况下每行每列并不同分,必须分别计算,不能从一个最好看的单元格推总损失。

优化关注正确配对相对于其他候选的概率,不是要求每个正样本点积都变成任意大的数。单位向量点积本身受限于 [−1,1][-1,1],温度缩放改变 softmax 的区分程度。更换批次会更换竞争候选;两段都适合狗图的文字也可能在配对表里互为负项,因此学习目标与语义真值并不完全重合。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:温度调小就更自信,为什么不直接调到零?

教师:它会把当前最大项放大,但当前最大项也可能错;训练梯度和优化也随之变化。把概率变尖不等于学到更正确的对应。

沿这个问题继续

核对三个文字向量的长度,再算第一行与第一列的正确配对概率及负对数。检查为什么本例各行各列的平均损失相同,再到 P58 改变候选集合。

视觉与语言已知图文配对怎样变成可用的文字候选接口?

候选改变时,分数回答的问题也变了

解释、算例与证据

P58 · 用文字组织类别,而不是重做一张固定标签表

这里的 zero-shot 不使用当前下游数据集再训练模型,而用已有编码器比较文字候选。增加候选和更换模板是不同干预:前者可以只变 softmax 分母,后者会改变文本向量。LAB04 的真实猫图四臂比较保留,可直接阅读已有结果,不必为理解接口重跑模型。

图像编码器红色杯子蓝色杯子红色球红色马克杯同一图像表示增加近义候选,归一化分数也会改变。zero-shot:不使用当前下游数据集再训练模型候选与连线为使用接口示意;不填写未运行的候选分数,也不声称概念从未出现在预训练中。
固定的红杯图像

固定图像编码;文字候选依次为红色杯子、蓝色杯子、红色球,再加入红色马克杯。候选与连线仅示意接口,未标出未运行的分数。

同一红杯图像编码保持不变,候选从红杯、蓝杯、红球三项增加近义的红色马克杯。 查看对应图解状态
查看完整图解

课堂讲述

传统分类头的输出位置绑定训练时的类别集合。CLIP 可以把我们提供的类别描述先编码,再与图像比较,这就让使用接口更灵活。 这里的 zero-shot 用法,是不使用当前下游数据集再训练模型,直接用已有的图像和文字编码器比较候选描述。它不保证相关概念从未出现在预训练资料中。改变候选文字,会改变这次比较的答案集合;加入新候选会改变 softmax 归一化分数,因此这些分数不能直接视为稳定校准的真实概率。 最重要的是看:相同视觉表示怎样在文字描述的帮助下进入一个新任务。

换候选、换模板、换图像:三个不同干预

独立阅读

训练完后,CLIP 可以把类别写成文字候选,例如 a photo of a cat.,再比较图像与每条候选的表示。这里的 zero-shot 用法,是不使用当前下游数据集再训练模型,直接用已有的图像和文字编码器比较候选描述。它不保证相关概念从未出现在预训练资料中。改变候选文字,会改变这次比较的答案集合;加入新候选会改变 softmax 归一化分数,因此这些分数不能直接视为稳定校准的真实概率。

设猫和狗的 logits 是 2 与 1,候选 softmax 给猫 e2/(e2+e)=0.7311e^2/(e^2+e)=0.7311。新增一个 logit 同为 2 的幼猫候选,原猫概率变为 e2/(2e2+e)=0.4223e^2/(2e^2+e)=0.4223。同一图像、同一猫文字、同一点积都没有改变,只是分母和选项变了。

因此有三个需要隔离的实验。只增候选:已有候选余弦应保持,softmax 可以改变。只改文字模板:文字向量改变,余弦也可能改变。只换图像:图像向量改变,应检查哪些候选关系随视觉内容变化。若三者一起改,就难以解释分数差异。

LAB04 保留的四臂猫图实验专门做这件事:A 是三类基础候选,B 添加 tiger/fox,C 保持三类但改 cropped 模板,D 从 B 删除 cat。删除正确选项后仍然必有最高项;这不是模型发现照片没有猫,而是回答空间已经被使用者改变。

图示条件与公式约定

候选集由课程明确给定。两个状态共用同一图像表示,第二状态只增加“红色马克杯”文本候选;不提供未运行的模型分数。候选 softmax 随比较集合变化,不等于已校准的开放世界概率。

这条线索的展开与后续阅读

视觉与语言已知图文配对怎样变成可用的文字候选接口?

在真实猫图上核对变化的量

教学算例已经预测:共享图文的余弦可保持,而候选集合内的相对分数改变。

Chelsea 猫图的已有 CLIP 四臂候选实验结果
LAB04 已保存的真实猫图推理结果。A 为 cat/dog/horse;B 增加 tiger/fox;C 保留 A 的候选、改为 cropped 模板;D 从 B 去掉 cat。结果来自既有记录,本轮没有运行模型。

真实猫图结果:保留模型、照片与历史身份

独立阅读

当前 LAB04 保存真实 Chelsea 猫照片与 OpenAI CLIP ViT-B/32 实验。2026-09-22 的本地复核使用固定 checkpoint revision 3d74acf9a28c67741b2f4f2ea7635f0aaf6f0268,没有重新训练 CLIP;当前整理也没有重跑该推理。图片先转 RGB、缩放并中心裁剪到 224×224224\times224,再按模型配置归一化。

基础 cat/dog/horse 候选下,cat 余弦约 0.28691、候选 softmax 约 0.99577;添加 tiger 与 fox 后,共享 cat 的余弦保持不变,softmax 降至约 0.98195;再删除 cat,tiger 成为剩余候选的最高项。新旧猫图余弦最大差约 1.04×10−71.04\times10^{-7},把后来的复核与历史材料连接起来。

正面结果是模型可以在这张真实照片上把图像与合理文字对应,并且其候选接口的变化符合预期。数值 0.99577 是给定候选集合内的相对分配,不是“现实中有猫的校准概率”。一张猫图也不能替代数据集级泛化评测。

LAB04 负责模型输入、候选、模板和关系检查;LAB12 复用同一模型产生的完整 512 维向量,研究图库缓存与搜索。不要把四个候选分数拼成所谓图像表示;真正可复用的是编码器输出的向量。先在 LAB04 理解分数身份,再在 LAB12 看系统组织,就无需重复训练或建立两份同义实验。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:增加一个候选,怎么连猫的概率都变了?

教师:余弦没有变;概率分母多了一个竞争项。它回答的是这组选项里的相对分配。请同时保存原始相似度和候选集合。

沿这个问题继续

先用给定 logits 复算两组 softmax,再到 LAB04 对照真实猫图的四臂结果。分别记录余弦与候选分数;需要研究图库搜索时,再进入 LAB12。

按问题回查的讲解与短练习(1)

检索到底复用了什么,又省去了什么?

编码缓存、语义相关性与近似搜索要怎样分别检验?

视觉与语言检索到底复用了什么,又省去了什么?

先编码图库,再让新查询比较

解释、算例与证据

P59 · 匹配还可以变成图文检索

检索把同一个比较空间用于一组已有图片。图库向量可复用,查询只需编码一次再搜索;页面前三张结果来自已有真实缓存。工作量、相关性指标和近似索引在说明与 LAB12 中展开;检索系统的进一步组织留待第八讲。

6 张来源照片 × 4 个相关视图 = 24 项查询:“a photo of a cat.”文字编码一次与 24 个已保存图像向量比较1 chelsea-center902 chelsea-full3 chelsea-right90已有结果:精确检索的前三项都是猫图变体复用 2026-09-22 本地真实 CLIP 缓存;24 项含相关裁剪,不是 24 个独立来源。本轮未运行模型。

已有六来源照片的二十四项库,接收猫图文字查询;展示既有真实缓存的精确排序前三项。

  • 6 张来源照片 × 4 个相关视图 = 24 项
  • 查询:“a photo of a cat.”
  • 文字编码一次
  • 与 24 个已保存图像向量比较
  • 1 chelsea-center90
  • 2 chelsea-full
  • 3 chelsea-right90
  • 已有结果:精确检索的前三项都是猫图变体
  • 复用 2026-09-22 本地真实 CLIP 缓存;24 项含相关裁剪,不是 24 个独立来源。本轮未运行模型。
已有六来源照片的二十四项库,接收猫图文字查询;展示既有真实缓存的精确排序前三项。 查看对应图解状态
查看完整图解

课堂讲述

同一对编码器还可以用于检索。图片库先得到表示,新的文字查询来了,再比较相似度并返回相关图片。反过来,也可以用图片查找描述。 这里和第二部分有一个计算思想上的呼应:把可以复用的计算先完成,再让不同查询使用结果。但这只是计算组织的类比,不是说检测研究直接导致了向量检索。 分类候选和检索库也不能用同一次小演示混为一谈。检索需要一组查询和明确的相关结果来评价。今天看到任务接口即可,近似索引、重排序和完整检索工程留到后面。这样既把 CLIP 能做什么讲清,又不把第三讲变成第八讲的提前版。

检索为什么能缓存:每张图编码一次,查询再比较

独立阅读

设图库有 NN 张图,收到 QQ 条文字查询。双编码器的图像输出不依赖当前查询,所以可以先计算图库矩阵 V∈RN×dV\in\mathbb R^{N\times d},查询到来时只计算文字向量 uu,再用 VuVu 得分。这把“理解输入的深度编码”和“在现有表示中比较”分成两段。

若每个图文对都重新分别编码,需 NQNQ 次图片样本编码和 NQNQ 次文字样本编码;有缓存则是 N+QN+Q。本课程 N=24,Q=12N=24,Q=12,两者为 576 与 36 次样本编码。它是解析工作量,不是秒数;一个批次调用可以同时编码多个样本。

缓存并没有消除搜索本身。exact 查询仍要与全部 NN 向量做点积;float32 图库矩阵占 4Nd4Nd 字节。本例 24×512×4=49,15224\times512\times4=49,152 字节,不含图片、模型、ID 与索引。改变 checkpoint、预处理或图片内容需要重建对应缓存;只新增文字候选不改变旧图片向量。

P59 使用已有 24 项缓存显示猫查询的前三项:chelsea-center90、chelsea-full、chelsea-right90。24 项其实来自六张照片的四种相关裁剪,不能当成 24 张独立语义样本。它足以观察排名与缓存复用;更大的索引工程属于第八讲和 LAB12 的选读部分。

图示条件与公式约定

本页只复用前轮已存在的本地 CLIP 结果,不读取、不运行 Deepnote,不新跑模型。缓存模型 openai/clip-vit-base-patch32,查询 a photo of a cat.;已有 24 项图像库的精确排序前三项为 chelsea-center90、chelsea-full、chelsea-right90。24 项来自 6 张照片的相关裁剪,并非独立样本。协议、来源与缓存校验在已有证据包中。只展示精确小库;ANN 和缓存工程留补充。

这条线索的展开与后续阅读

视觉与语言检索到底复用了什么,又省去了什么?

让每个检索指标回答自己的问题

缓存改变计算组织;质量判断仍需明确查询、相关集合和 K。

Hit、Recall 与 exact 重合率,各自在问什么

独立阅读

固定一个查询,相关集合为 R(q)R(q),检索前 KK 个结果为 AK(q)A_K(q)。三个常见指标不是同义词:Hit@K 问是否至少命中一个相关结果;Recall@K 为 ∣AK∩R∣/∣R∣|A_K\cap R|/|R|;ANN overlap 问近似搜索是否复现精确搜索,计算 ∣AK∩EK∣/K|A_K\cap E_K|/K,其中 EKE_K 为 exact 前 K。

假设某猫查询有四个猫裁剪算相关,前三名命中两个。Hit@3 是 1,Recall@3 是 2/4=0.52/4=0.5。若 exact 的前三名是 a,b,c,ANN 找到 a,b,d,二者 overlap 是 2/32/3;d 即使仍然是猫,语义命中也可能不变。模型相关性与索引逼近的是两个不同问题。

LAB12 的历史结果正体现这个区别:exact 文搜图 Hit@3=1;IVF 只查一个簇时 exact top-3 重合率为 0.7778,语义 Hit@3 仍为 1。它漏掉部分同源裁剪,却仍保留某个相关裁剪。这不是指标互相矛盾,而是各自回答了自己的问题。

阅读结果先找查询集合、相关集合和 K,再看成绩。若一个查询只有一个正例,Hit@K 与单正例 Recall@K 恰好同值;换成多正例后必须重新写清口径。保存查询和命中 ID 比只保存平均数字更便于 AI 或同学追溯解释。

视觉与语言检索到底复用了什么,又省去了什么?

选读:省搜索与增加图文交互分别改变什么

指标已分清语义命中与 exact 复现;进一步只在关心系统成本或关系表达时阅读。

选读:省搜索和增加图文交互,是不同方向

独立阅读

这部分服务于第八讲的检索预备阅读,不是 P59 必须讲完的技术章。LAB12 的 IVF-Flat 先把图库分成 8 个簇,查询只打开 nprobe 个最近簇,再对桶内原向量精确打分。近似出现在没有打开的桶;把所有 8 个桶打开应恢复 exact 排名。

2026-09-22 保存的本地结果中,nprobe=1 平均扫描 4.17 个图像向量,exact 扫描 24 个;但整批 12 查询中位耗时为约 0.1016 ms 与 0.0456 ms。小库矩阵乘法已经很便宜,Python 路由和排序成本反而更大。扫描更少不等于实测更快。计时排除模型编码、磁盘读取和建索引。

另一个方向是让查询参与局部交互。缓存左右区域向量 rjr_j,对查询 qq 计算 uj=qTrju_j=q^Tr_j、wj=softmax(uj/.05)w_j=\mathrm{softmax}(u_j/.05),再汇总 ∑jwjuj\sum_j w_ju_j。猫查询可提高猫区域权重,宇航员查询可提高宇航员区域权重;但这个聚合对区域顺序不敏感,交换左右后总分不变。多向量并不自动保存关系。

逐对重复调用独立 CLIP 编码器仍是 f(I)Tg(T)f(I)^Tg(T),不因此变成交叉编码。联合模型把图文在内部相互条件化,通常需要更多查询相关计算。可用双编码先召回,再少量重排;要判断收益,需要固定检索库、查询和评价协议。这些机制在现有 LAB12 保留为选做,不在主讲另开一章。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:缓存后为什么还需要检索算法?

教师:缓存省去了重复深度编码,却还要在 N 个向量里比较和选前 K。小库精确点积可能最简单,大库才需要衡量索引省的工作与遗漏。

沿这个问题继续

先回看本页画面并指出输入、条件和输出,再按“真实猫图结果:保留模型、照片与历史身份 → 检索为什么能缓存:每张图编码一次,查询再比较 → Hit、Recall 与 exact 重合率,各自在问什么”阅读。相关实验以其已保存结果为起点,需要动手时再顺序执行 Notebook;

按问题回查的讲解与短练习(1)

规模化图文监督带来了哪些可验证的进展?

模型、训练数据与使用接口分别贡献了什么?

视觉与语言规模化图文监督带来了哪些可验证的进展?

追溯配对供给与筛选覆盖

解释、算例与证据

P60 · 图文数据不是一堆没有来历的图片

大规模图文监督的机会来自配对供给,信号质量又取决于描述、选择和筛选。原始 CLIP、LAION 和 OpenCLIP 分属模型研究、数据资源与实现/模型系列,不能互当别名。正面的迁移证据与数据边界一起读,才能理解这种路线为何有效、又在哪些地方需要下一步工作。

“两个人站在室内。”收集与筛选保留哪些配对?图文训练配对关系提供目标筛选模型影响材料范围CLIP模型与训练方法原始数据由原工作收集LAION公开图文数据资源不是原始 CLIP 训练集OpenCLIP开源实现与模型不同权重有不同数据配方人工内容、数据处理与筛选都参与信号形成;无额外逐图类别标签并不等于无人类知识。

原图与描述经过收集筛选进入训练;下方分别说明CLIP模型方法、LAION公开数据和OpenCLIP开源实现。

  • “两个人站在室内。”
  • 收集与筛选
  • 保留哪些配对?
  • 图文训练
  • 配对关系提供目标
  • 筛选模型影响材料范围
  • CLIP
  • 模型与训练方法
  • 原始数据由原工作收集
  • LAION
  • 公开图文数据资源
  • 不是原始 CLIP 训练集
  • OpenCLIP
  • 开源实现与模型
  • 不同权重有不同数据配方
  • 人工内容、数据处理与筛选都参与信号形成;无额外逐图类别标签并不等于无人类知识。
原图与描述经过收集筛选进入训练;下方分别说明CLIP模型方法、LAION公开数据和OpenCLIP开源实现。 查看对应图解状态
查看完整图解

课堂讲述

语言监督的规模,依赖图文配对数据怎样获得和整理。图片旁边的文字可能是描述,也可能只说了背景或网站主题;配对质量不是天然一致的。 LAION 等公开资源使更多研究者能够研究大规模图文学习,但它不是原始 CLIP 的训练集。模型、训练数据和开源实现要分开说,不能把几个名字当同一个东西。 这也回到第一部分的监督供给问题。人不仅可能直接标答案,还可能通过内容生产、筛选与评价影响模型学到什么。数据更多扩大了机会,数据如何组织则决定这些机会里包含什么信号。理解这种条件,才不会把整个变化只归结为参数数量。

从网页文字到训练对应:数据扩大了什么

独立阅读

网页配图旁的文字可能准确描述对象,也可能只讨论文章主题。图片中有两个杯子,文字却只提其中一个;图文仍相关,却没有提供完整场景标注。这种监督更便于规模化收集,但目标覆盖范围由内容生产与筛选决定。

原始 CLIP 工作收集了 4 亿图文对,并在 30 多个既有视觉数据集上研究迁移。LAION-400M 是后来的开放图文数据资源,包含经 CLIP 过滤的图文对;它不是原始 CLIP 的训练集。OpenCLIP 又是另一层的实现和模型系列,具体权重使用什么数据要逐项核对。

这里存在一个积极反馈:已有模型可以帮助整理更多配对,开放的数据和实现使更多研究者能训练与比较新模型。但筛选器偏好的对应也可能进入数据分布。数量增加提供更多学习机会;对象、语言、关系、质量和去重方式决定这些机会覆盖什么。

回到第一部分的标签供给,人的工作并没有消失,只是有的从逐图填写固定类别,转向写内容、选择资料、定义任务和评价。研究报告需要同时交代模型、数据与接口;单说“用了 CLIP/LAION”还不足以重建学习条件。

图示条件与公式约定

原始 CLIP 的训练数据由原工作收集;LAION 是后来的公开图文数据资源,OpenCLIP 是独立的开源实现与模型系列。具体权重使用的训练数据要分别核对。

这条线索的展开与后续阅读

视觉与语言规模化图文监督带来了哪些可验证的进展?

先确认语言指定任务的实质进展

规模提供机会,但进展还要由明确协议下的迁移结果支持。

正面证据:自然语言监督确实拓宽了下游接口

独立阅读

CLIP 的论文贡献不只是一种损失公式。原工作研究了 30 多个视觉数据集上的迁移,且报告其 zero-shot 模型在 ImageNet 上达到原始 ResNet-50 的分类准确率水平,而不使用该任务的 128 万张训练样本训练专用分类器。数字与比较属于原论文协议,不能从本课程猫图实验重新推出。

这项结果支持一个明确判断:大规模图文匹配学到的表示,可以通过文字描述定义一批下游分类任务,减少逐任务重新标注和训练固定分类头的需求。语言成为任务指定接口,是对“分类表只能在训练时固定”的实质拓展。

然后再问边界才有意义:候选描述写得好不好、预训练是否覆盖概念、目标数据分布是否变化,都会影响迁移。关系定位和自由生成还要求别的输出。不是因为 CLIP 什么也没有证明而要继续研究,而是它已经打开了可用接口,研究者因此可以追问更细的空间、关系和交互能力。

沿这个问题继续

先回看本页画面并指出输入、条件和输出,再按“CLIP:文字怎样从标签表变成学习信号 → 正面证据:自然语言监督确实拓宽了下游接口”阅读。相关实验以其已保存结果为起点,需要动手时再顺序执行 Notebook;

沿这个问题继续

先区分原始 CLIP、LAION 与 OpenCLIP 的身份,再比较配对收集、筛选和模型训练各自改变什么。结合迁移结果,说明文字监督扩大了哪些任务接口。

怎样设计让两种解释产生不同预测的测试?

当前成功排除了什么替代解释,还缺什么条件?

视觉与语言怎样设计让两种解释产生不同预测的测试?

把两次成功背后的两条规则写出来

解释、算例与证据

P61 · 前两张图都选对,究竟说明了什么?

两次答对并不只有一种解释。当前两图都由左侧人物持球,因此关系规则和左色规则给出相同答案。先把各自预测明确写出,再去看下一页哪两个条件让它们不同。图旁给出的是规则预期,而非模型实测结果。

红在左 · 红持球蓝在左 · 蓝持球按持球者颜色红蓝按左边衣服颜色红蓝条件示意;两条规则预测。A 为原合成场景,B 为同源颜色编辑;不是模型推理。

红衣左侧持球与蓝衣左侧持球两张同源图,两条规则都得到正确的红、蓝答案。

  • 红在左 · 红持球
  • 蓝在左 · 蓝持球
  • 按持球者颜色
  • 红
  • 蓝
  • 按左边衣服颜色
  • 红
  • 蓝
  • 条件示意;两条规则预测。A 为原合成场景,B 为同源颜色编辑;不是模型推理。
红衣左侧持球与蓝衣左侧持球两张同源图,两条规则都得到正确的红、蓝答案。 查看对应图解状态
查看完整图解

课堂讲述

看这两张图。第一张红衣人在左边,也拿着球;第二张蓝衣人在左边,也拿着球。如果模型两次都选对,我们很容易觉得它已经理解“谁拿着球”。 但是另一个更简单的规则也能通过:只看左边人的衣服颜色。在这两张图里,位置线索和持球关系恰好绑在一起,两个解释给出同样的答案。 这不是故意找一个苛刻陷阱,而是在检查这两次成功究竟排除了哪些可能性。接下来我们不需要再多收集十张同样相关的图片,只需要选择让两个解释发生分歧的条件。

两次成功为何仍有两个解释

独立阅读

保留两句候选:A 为红衣人拿球、旁边有蓝衣人;B 为蓝衣人拿球、旁边有红衣人。第一张图左红持球,第二张图左蓝持球。关系规则按持球者衣色选择 A/B;位置规则只按左侧人物衣色选择 A/B。

条件 持球关系规则 左侧颜色规则
左红持球、右蓝 A A
左蓝持球、右红 B B

两个规则对这两张图作出完全相同的预测。即使真实模型两次答对,也不能仅凭这两次观察决定它用了哪条规则。这不是说成功没有价值:成功表明它在当前条件里能选对候选,只是测试没有排除另一解释。

要增加解释力,应该选择两个规则会分歧的输入,而非收集更多左侧总持球的成功图。下一页把持球位置交叉安排,保持同样两句候选,使答案依据成为可观察差别。页面表格计算的是规则预期;读取真实模型时要另查固定模型、实际输入与分数记录。

沿这个问题继续

先回看本页画面并指出输入、条件和输出,再按“两次成功为何仍有两个解释”阅读。相关实验以其已保存结果为起点,需要动手时再顺序执行 Notebook;

图示条件与公式约定

A=relationship-a-left-red-holds.png,红衣女子在左且持球;B=relationship-b-left-blue-holds.png 是 A 的同源颜色编辑,蓝衣女子在左且持球。页面是人工定义两条规则的预测,不是新 CLIP 推理。B 并非逐像素单变量变换。

这条线索的展开与后续阅读

视觉与语言怎样设计让两种解释产生不同预测的测试?

读非对角条件中的相反预测

解释、算例与证据

P62 · 把位置与关系拆开,解释才会分叉

四格的非对角条件才使两种解释分叉。逐格比较关系规则与左色规则的答案,并检查当前素材还有哪些变量共同变化。已保存的真实 CLIP 拼贴反例使用另一组输入与数值,应按各自条件解读。

红衣人持球蓝衣人持球左侧红衣左侧蓝衣持球规则 → 红 左侧规则 → 红持球规则 → 蓝 左侧规则 → 红持球规则 → 红 左侧规则 → 蓝持球规则 → 蓝 左侧规则 → 蓝非对角条件让两个解释分歧。图为同源编辑/镜像;镜像也改变姿态方向,未声称逐像素单变量。

四条件表的行固定左侧衣服颜色,列固定持球者颜色;非对角条件使持球规则与左侧规则分歧。

  • 红衣人持球
  • 蓝衣人持球
  • 左侧
  • 红衣
  • 左侧
  • 蓝衣
  • 持球规则 → 红 左侧规则 → 红
  • 持球规则 → 蓝 左侧规则 → 红
  • 持球规则 → 红 左侧规则 → 蓝
  • 持球规则 → 蓝 左侧规则 → 蓝
  • 非对角条件让两个解释分歧。图为同源编辑/镜像;镜像也改变姿态方向,未声称逐像素单变量。
四条件表的行固定左侧衣服颜色,列固定持球者颜色;非对角条件使持球规则与左侧规则分歧。 查看对应图解状态
查看完整图解

课堂讲述

现在选择红衣人在左、蓝衣人在右侧持球的对应条件。真正根据持球关系的规则应该选择蓝衣人;只看左边颜色的规则仍然选择红衣人。另一张对称条件也可以做同样的检查。 这就是为什么问卷要求改变条件,而不是只增加同类成功截图。对两个解释来说,原来一样的预测现在不一样了,结果才具有区分力。 即使模型通过这组比较,我们也只得到关于这些条件的证据,不自动证明它理解所有动作关系。但我们已经比“回答看起来不错”前进了一步:能够说明当前测试在区分什么。下一步,让语言直接要求输出那个对象的区域,又会引入什么新监督? 这里的同源照片经过颜色编辑和镜像,持球者的人物身份没有独立变化;我们用它区分图上这两条规则,不把它说成排除了所有替代解释。

四条件怎样让解释分叉,哪些变化仍然绑定

独立阅读

增加右侧持球的条件后,同一候选 A/B 产生下表:

条件 左侧颜色 持球者颜色 持球关系规则 左色规则
A 红 红 A A
B 蓝 蓝 B B
C 红 蓝 B A
D 蓝 红 A B

真正有区分力的是 C/D。只看 A/B 的满分无法区分两条规则;C/D 上如果预测追随持球者,则对关系解释提供更多支持。误差还可以细看:模型是否两种持球颜色都能区分,是否只在某一种词序或某位人物上成功。

当前素材的 A/B 同源,B 是颜色编辑;C 是 B 的精确镜像,D 是 A 的精确镜像。因此镜像同时改变位置、朝向和光照方向,持球者也仍是同一人物。这是一组针对已写明两条规则的对照,不是“只改变一个像素属性并排除所有解释”的实验。要排除人物身份捷径,需要另安排不同人物持球的输入;要排除文字模板捷径,还应换表达但保持任务关系。

教师可以指着非对角两格问:如果模型只看左边,会分别选什么?答案不是再背“相关不等于因果”,而是当场写出 A/B 两个不同预测,再用实际输出裁决这一次对照。

图示条件与公式约定

行是左侧衣服颜色(红/蓝),列是持球者颜色(红/蓝);左上 A、右上 C、左下 D、右下 B。C 是 B 的精确水平镜像;D 是 A 的精确水平镜像。两条规则预测分别为:A 红/红,C 蓝/红,D 红/蓝,B 蓝/蓝。镜像同时改变人物位置、朝向、光照方向;而且本组持球者都是同一位女子,所以本对照只区分所展示的颜色位置规则与持球颜色规则,不足以排除性别/人物身份等其他解释。稿中“把球交给右边”改写为“选择右侧持球的对应条件”,与实际素材变换一致。

这条线索的展开与后续阅读

视觉与语言怎样设计让两种解释产生不同预测的测试?

把规则四格与真实模型反例分开读

规则表提出可区分的预测;真实模型证据还需核对具体输入、文字与保存分数。

真实 CLIP 关系反例与规则四格,应分开读

独立阅读

持球四格首先是一份规则预测表;它与 LAB04 另一组真实 CLIP 关系推理不是同一证据。后者使用猫和宇航员的固定拼贴,交换左右位置,比较“猫在左、宇航员在右”及其相反描述。

2026-09-22 保存结果中,猫左图的两句余弦约为 0.37850、0.38184;交换后约为 0.35660、0.36301。两图都偏向“宇航员在左、猫在右”,所以第一张关系判断错误。这说明在该固定模型、拼贴与文字条件下,整体匹配没有正确区分这一次左右绑定。

但同一模型在猫图候选分类和小图库检索中有真实成功,不能用这个失败抹去对象匹配能力。更准确的研究问题是:哪些对象和语义可以由全局表示稳定匹配,哪些细粒度关系需要更合适的空间组织、交互或训练资料?

LAB12 的局部加权规则提供另一种解释路径:查询改变了猫/宇航员区域权重,却因汇总公式忽略坐标而对交换左右严格不敏感。这个失败来自可指出的结构对称性。它帮助区分“区域更多”与“关系已经被表达”,再自然接入 P63 的定位任务。以上均为已有历史记录,本轮没有重跑或扩大结论。

LAB04 的旧四幅持球插图也确实在 2026-09-22 做过真实 CLIP 编码,保存结果为四例中三例正确;它并非从未运行过模型。但那四幅旧输入与 v18 当前同源编辑/镜像的 A–D 底图不一致,且旧插图存在背景和姿态差异。旧分数不能贴到当前四格,也不能把 3/4 当成单变量因果结论。回链阅读时要连同原图片、候选和输入哈希一起核对。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:四格都对就证明理解持球关系了吗?

教师:它支持这组输入中关系规则胜过左色规则。当前持球人物身份未独立变化;要排除身份捷径,还要换持球者而保持其他条件可比较。

沿这个问题继续

先回看本页画面并指出输入、条件和输出,再按“四条件怎样让解释分叉,哪些变化仍然绑定 → 真实 CLIP 关系反例与规则四格,应分开读”阅读。相关实验以其已保存结果为起点,需要动手时再顺序执行 Notebook;

按问题回查的讲解与短练习(2)

一句话怎样落实为正确对象的区域?

目标、参照物与关系怎样共同约束定位输出?

视觉与语言一句话怎样落实为正确对象的区域?

沿坐标选出目标,而不是参照物

解释、算例与证据

P63 · GLIP:不只说相关,还要指出区域

语言条件落实为空间输出时,需要明确目标、参照物和关系。GLIP 提供对象级学习和迁移的研究路线;LAB15 提供可逐像素追踪的规则实验。两者的层级不同,但都帮助判断系统到底把框放在谁身上,再与后续掩码处理连接。

指代:拿球的蓝衣人“蓝衣人”“拿球的”图文交互 + 区域预测短语对应与定位监督训练目标落在局部区域输出:与短语对应的框GLIP 把词语与空间定位放进同一学习任务教学框展示任务接口,不是 GLIP 运行结果;区域交互和定位学习不能由整图分数直接代替。

蓝衣人在右侧持球场景,红衣人、蓝衣人与球都有候选框;短语和定位监督指向蓝衣人区域。

  • 指代:拿球的蓝衣人
  • “蓝衣人”
  • “拿球的”
  • 图文交互 + 区域预测
  • 短语对应与定位监督
  • 训练目标落在局部区域
  • 输出:与短语对应的框
  • GLIP 把词语与空间定位放进同一学习任务
  • 教学框展示任务接口,不是 GLIP 运行结果;区域交互和定位学习不能由整图分数直接代替。
蓝衣人在右侧持球场景,红衣人、蓝衣人与球都有候选框;短语和定位监督指向蓝衣人区域。 查看对应图解状态
查看完整图解

课堂讲述

GLIP 把语言与区域感知更直接地结合。文字中的概念和短语,不只与整幅图比较,还要与区域建立对应,并通过定位相关的监督学习输出位置。 因此,它不是简单把 CLIP 的整图分数画成一个框。局部关系、训练数据以及图文交互都进入了方法。我们在第二部分学到的区域组织,在这里遇到了更开放的语言条件。 这条技术线说明,语言可以改变视觉任务的组织方式,但不会自动消除空间任务。要指出“拿球的蓝衣人”,既要理解文字提出了什么,也要找到画面中的对应区域。接下来再看另一个方向:如果输出不是框,而是一段根据图片作出的回答呢?

“蓝杯左边的杯子”:目标、参照物、关系三者分开

独立阅读

短语 cup left of blue cup 中,目标类别是 cup,参照物是 blue cup,关系是 left of。看到 blue 就返回蓝杯,找到了参照物,却没有完成目标选择。

LAB15 的受控画布中,左红杯框为 [15,19,50,58][15,19,50,58],中心横坐标 32.5;右蓝杯框为 [109,19,144,58][109,19,144,58],中心横坐标 126.5;书的框为 [60,65,90,80][60,65,90,80]。本例定义 left-of 为目标中心横坐标小于参照中心,且目标不是参照物本身。

先找唯一蓝杯,再从其他杯子中筛选:红杯满足 32.5<126.532.5<126.5,应返回红杯框。书也在蓝杯左侧,却不满足 cup 类别约束。若蓝杯缺失、出现多个蓝杯或存在多个满足关系的目标,程序必须有明确的无目标/多义处理,不能随意返回最高颜色分的对象。

这里说明的是一套显式关系语义。“完全在左侧”可以改用 xmax(a)<xmin(r)x_{max}(a)<x_{min}(r),与中心比较在重叠情况下不同。把语言问题落实为区域时,要先解释采用哪种语义,再谈模型是否正确。图上的坐标约定是半开边界框,不是逐像素包含端点的面积公式。

这条线索的展开与后续阅读

视觉与语言一句话怎样落实为正确对象的区域?

从输入干预追到实际返回框

目标语义已定义;现在用保存的像素规则系统逐项检查输入怎样改变候选和答案。

已保存的指代实验:从像素提框后再应用关系

独立阅读

LAB15 的当前实现先从 RGB 图像按颜色阈值提取连通域,得到候选框;再解析目标、参照物与关系。它是真正读取像素的规则系统,类别由有限颜色约定提供,没有训练神经 grounding 模型。这个身份既不应被贬为“没读图”,也不应被升级为“复现 GLIP”。

实际输入改变 问句 保存的输出
原图左红、右蓝 蓝杯左边的杯子 左红杯
灰块遮住左杯 同上 无唯一可见目标
只交换两杯 RGB 色值 同上 无目标,蓝杯已在最左
保持交换图,只把 left 改 right 蓝杯右边的杯子 右红杯

遮挡是真的修改图片,不是在答案字典里删除目标;交换色值保留轮廓和背景;语言对照保持图片完全相同。代码断言干预区域外像素不变,并保存差分图。它因此能够支持这些有限条件下“图片怎样改变候选、关系怎样选择目标”的解释。

输入干预与返回框

旧关键词规则错选蓝杯仍保留为失败基线。当前结果来自 2026-09-22 已保存运行,本轮未重跑。若以后换自然照片,颜色阈值和杯子类别约定会失效;那时才需要加载相应视觉模型,并对输入和实际框做新的可追溯评价。

视觉与语言一句话怎样落实为正确对象的区域?

从透明规则走向对象级学习方案

像素规则实验解释了任务契约;GLIP 展示语言与区域可共同学习的研究路线。

GLIP:把类别和短语都放到对象级定位任务中

独立阅读

GLIP 将对象检测与短语定位用于共同的预训练。传统检测类别可以转写成文字概念,短语资料又提供更开放的语言—区域对应。视觉与文字发生交互,训练同时要求语义匹配和位置正确;这比给一组外部裁图计算 CLIP 整图分数多了任务结构与定位监督。

原论文使用 2700 万 grounding 训练样本,包含人工标注和由网络图文扩展的资料;在其协议中,直接评估 COCO 得到 49.8 AP,LVIS 得到 26.9 AP,且说明预训练没有使用 COCO 图像。这里的数字是论文所报告的对象级迁移结果,不是本课程持球图的运行。它支持语言条件和区域学习能够带来可迁移检测接口这一方向。

对课堂场景,“拿球的蓝衣人”要求图中多个对象、属性与关系共同约束一个框。若候选框身份错了,后接分割模型即使边界非常准确,也会分错对象。反过来,目标身份正确但边界粗糙,应检查分割与采样接口。把定位和掩码衔接时分开检查,正是第二部分仍然有用的原因。

LAB15 负责透明的语言关系规则,GLIP 论文负责更一般的学习方案与研究证据。两者互相解释,不互相冒充。主讲保留这一对象级接口;完整训练配置与更广数据对照留材料阅读。

沿这个问题继续

先回看本页画面并指出输入、条件和输出,再按““蓝杯左边的杯子”:目标、参照物、关系三者分开 → 已保存的指代实验:从像素提框后再应用关系 → GLIP:把类别和短语都放到对象级定位任务中”阅读。相关实验以其已保存结果为起点,需要动手时再顺序执行 Notebook;

可复用视觉与语言组件怎样学会共同回答?

接口、更新参数和指令事实各自需要怎样检查?

视觉与语言可复用视觉与语言组件怎样学会共同回答?

把视觉向量接进语言模型的输入空间

解释、算例与证据

P64 · 把视觉表示接入一个已经会说话的模型

原始 LLaVA 输入的是视觉网格向量,经线性投影接入已有语言模型,不是一个类别标签或相似度。尺寸兼容使计算可进行,任务训练才使视觉信息可被使用。先辨认这条信息流,内部序列架构留第五讲。

CLIP 视觉编码器原始 LLaVA:ViT-L/14网格特征线性投影 W视觉向量 → 语言维度文字指令:“谁拿着球?”语言模型 Vicuna视觉向量 + 文字指令回答“红衣人”接入的是一组视觉特征,而非一个 CLIP 匹配分数原始 LLaVA §4.1;网格数量为示意。参考回答用于解释接口,未作本轮视觉指令推理。

图像经CLIP视觉网格特征和线性投影进入Vicuna,与文字指令共同产生参考回答。

  • CLIP 视觉编码器
  • 原始 LLaVA:ViT-L/14
  • 网格特征
  • 线性投影 W
  • 视觉向量 → 语言维度
  • 文字指令:
  • “谁拿着球?”
  • 语言模型 Vicuna
  • 视觉向量 + 文字指令
  • 回答
  • “红衣人”
  • 接入的是一组视觉特征,而非一个 CLIP 匹配分数
  • 原始 LLaVA §4.1;网格数量为示意。参考回答用于解释接口,未作本轮视觉指令推理。
图像经CLIP视觉网格特征和线性投影进入Vicuna,与文字指令共同产生参考回答。 查看对应图解状态
查看完整图解

课堂讲述

以原始 LLaVA 为例,视觉编码器提供一组图像特征,经可训练的投影后,与文字输入共同进入语言模型。这里利用的是已有视觉模型与语言模型的能力,再建立一个新的模态接口。 请看图像信息走到了哪里。输入不是一个“图里大概有猫”的标签,也不是一项 CLIP 相似度分数,而是一组能够被后续模型使用的视觉向量。投影调整了表示接口,但维度对齐并不自动等于任务已经学会。 今天需要理解这条模块关系,语言模型内部如何组织上下文留到第五讲。眼前更关键的问题是:这几个模块接起来以后,究竟训练了谁,用什么数据让它根据图像和指令作答?

LLaVA 的连接层:把视觉向量接入已有语言空间

独立阅读

原始 LLaVA 采用 CLIP ViT-L/14 的网格视觉特征,经一个可训练线性投影接入 Vicuna。若视觉特征矩阵按行写为 Zv∈Rn×dvZ_v\in\mathbb R^{n\times d_v},连接权重为 W∈Rdv×dlW\in\mathbb R^{d_v\times d_l},则 Hv=ZvWH_v=Z_vW 有语言输入维度 dld_l。不同论文的行列约定可以转置,但信息流相同。

传进去的是一组视觉向量,不是“图中有猫”的一个标签,也不是 CLIP 的一项整图余弦。保留多个位置的特征,使后续模块有机会读取不同内容。线性投影调整接口,没有凭空增加图像中已被前处理丢失的细节。

CLIP 已有图文比较空间,为什么还要训练连接?因为 Vicuna 的词向量坐标和任务过程不是 CLIP 文本编码器的空间。向量维度对上只能保证输入合法;模型还要学会把这些输入用于按图回答。一个数学类比是两个测量仪器都输出三维数值,但坐标系、单位与使用规则不同,不能直接逐项相加。

本页只要求辨认视觉编码、投影、文字条件和回答输出四个位置。语言模型如何在序列内部处理上下文、视觉 token 怎样参与 attention,留第五讲。当前页面的格子数量是示意,不代表真实网格 token 数;示范回答也不是本轮 LLaVA 推理。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:CLIP 已经对齐图文,为什么再投影?

教师:那是 CLIP 自己的比较空间。另一个语言模型有自己的向量坐标和使用任务,投影建立接口,后续训练教它按图像和指令使用信息。

沿这个问题继续

沿视觉网格、线性投影和语言模型三个接口检查张量形状:图块数保持不变,向量宽度改变。然后到 P65 比较两个训练阶段分别更新哪些参数。

图示条件与公式约定

原始 LLaVA 使用 CLIP ViT-L/14 的网格特征,线性投影接到 Vicuna 的文字输入维度。图中格数仅作表示,不对应实际 token 数量。示例回答为人工任务说明,不是本轮 LLaVA 运行。

这条线索的展开与后续阅读

视觉与语言可复用视觉与语言组件怎样学会共同回答?

保持模块不变,对照两阶段的更新范围

解释、算例与证据

P65 · 连接层与任务使用方式,都需要训练

本页两个状态只改变训练范围与数据任务:先冻结两大模型训练投影,再冻结视觉、更新投影和语言模型。把每个模块是否更新说清,避免用“端到端”概括掉细节。再读指令数据的来源,训练目标的视觉事实必须能追溯到相应输入。

阶段二 · 图像指令训练任务使用视觉编码器冻结保持参数投影 W可训练更新参数语言模型可训练更新参数输入:图像 + 视觉指令目标:指令对应的回答可训练集合 { W, φ }两个阶段都冻结视觉编码器;任务训练改变如何使用其特征。限定原始 LLaVA §4.2。φ 为语言模型参数;不概括所有后续多模态模型的训练方案。

原始LLaVA的两阶段图:阶段一只更新投影;阶段二更新投影与语言模型;两个阶段的视觉编码器均冻结。

  • 阶段二 · 图像指令训练任务使用
  • 视觉编码器
  • 冻结
  • 保持参数
  • 投影 W
  • 可训练
  • 更新参数
  • 语言模型
  • 可训练
  • 更新参数
  • 输入:图像 + 视觉指令
  • 目标:指令对应的回答
  • 可训练集合 { W, φ }
  • 两个阶段都冻结视觉编码器;任务训练改变如何使用其特征。
  • 限定原始 LLaVA §4.2。φ 为语言模型参数;不概括所有后续多模态模型的训练方案。
原始LLaVA的两阶段图:阶段一只更新投影;阶段二更新投影与语言模型;两个阶段的视觉编码器均冻结。 查看对应图解状态
查看完整图解

课堂讲述

原始 LLaVA 的第一阶段冻结视觉编码器与语言模型,只训练投影,用图文配对建立接口。随后保持视觉编码器冻结,继续训练投影与语言模型,使系统适应视觉指令。 这区分了两个问题:视觉特征怎样接进去,以及接进去后怎样按任务使用。具体数据与训练阶段会影响能力,不能把它解释成一根连接线带来了全部理解。 我们也要用前面的办法检查结果:同一问题换图片,相关答案是否改变;同一图片换问题,是否提取了不同信息。能连贯回答是一项能力,回答是否有可靠视觉依据是另一项检查。两者共同构成真正有用的多模态系统。

原始 LLaVA 两阶段:学习接口,再学习视觉指令

独立阅读

冻结参数表示训练时不更新这组权重,不表示其输出不参与后续计算。原始 LLaVA 的训练范围必须按模块读:

阶段 视觉编码器 线性投影 语言模型 主要任务
特征对齐 冻结 更新 冻结 用图文配对建立可用视觉接口
视觉指令微调 仍冻结 继续更新 更新 根据图片和指令生成回答

第一阶段让已有视觉表示进入语言接口,第二阶段进一步学习如何在不同问法下使用这些信息。两阶段的视觉参数都冻结;论文第二阶段标题虽含 End-to-End,不能据此把视觉分支也画成更新。

训练目标仍是条件下预测后续回答,只在应由助手生成的回答与停止位置计入目标。问题和图像属于条件,不是让模型原样抄回的答案。若只记录“用了指令数据”而不记录更新范围,就无法判断能力来自视觉编码变化、连接适配还是语言模型的任务行为变化。

这与第一部分冻结读出/微调的逻辑直接相连:不更新主干仍可以学习更有效的下游用法。其他多模态方案可以选择解冻视觉,这是一项新的训练设计,不能倒写成原始 LLaVA。

图示条件与公式约定

按原论文 §4.2:阶段一视觉编码器和语言模型冻结,只更新投影 W;阶段二继续冻结视觉编码器,更新投影 W 与语言模型参数 φ。没有把 End-to-End 标题误解为视觉也解冻。

这条线索的展开与后续阅读

视觉与语言可复用视觉与语言组件怎样学会共同回答?

沿指令数据追溯答案能依据的事实

参数更新范围已清楚;还要检查训练答案是否有足够的输入证据。

视觉指令数据:问题和答案中的事实从哪里来

独立阅读

原始 LLaVA 的一部分指令资料由仅接收文本的 GPT-4 协助制作。输入是已有 caption 和对象类别、框坐标等文字化描述;这条数据制作路径没有让 GPT-4 直接查看原图。随后训练 LLaVA 时,原图才作为视觉输入与这些指令配对。

把一份场景记录想成三层。caption 可能说“两人在球场”;对象框提供人物和球的位置;若记录没有谁的手接触球、哪一人持球,数据制作模型就缺乏可靠依据回答持球关系。把回答写得更长不能补上丢失事实。需要追加标注、改问题或保留不确定性。

这种流程的积极价值是把已有图文资料转为更丰富的任务形式,让模型学习同图换问、描述与解释等交互。数据生产因此不只是在扩大样本数量,还在定义系统练习哪些条件使用方式。

学生可以对一张课程图自己做一次检查:只给对象名和框,哪些问题已能确定,哪些要看像素才知道?“左右各是谁”可能由框和类别支持;球面的小字、遮挡细节或动作接触通常需要更细证据。这与本讲开头“训练答案怎样产生”是同一个问题。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:视觉冻结是不是完全不能学习新视觉任务?

教师:视觉参数不变,但投影和语言模型可以学习新的读取与使用方式。若已有特征确实缺少细节,才需要考虑分辨率、表示或解冻等进一步改动。

沿这个问题继续

对照两阶段的冻结范围与数据任务,再追溯指令数据中的问题、答案和图像事实。用同一组模块说明:训练接口与学习回答分别改变了什么。

怎样把可复用能力改写成可检验的科研问题?

已有资产、新条件、缺失关系与评价划分怎样对应?

视觉与语言怎样把可复用能力改写成可检验的科研问题?

沿三条实线辨认真正复用的资产

解释、算例与证据

P66 · 回看这段历史:留下来的不是一个网络名字

回看的是可复用资产,而不是模型名排序。三条公开连接分别复用 MAE 初始化、检测器区域和 CLIP 视觉编码。科研练习再把“迁移”变成具体的新批次评价:任务将来遇到什么条件,决定该怎样切分和选择基线。

留下的能力在新系统中实际复用视觉表示MAE 编码器SAM 的初始化空间组织检测器区域特征ViLBERT 的视觉输入图文对应CLIP 视觉编码器LLaVA 的视觉输入新的任务仍要定义输出、补上训练关系,并检验它。实线表示公开方法中的组件复用;共享计算与检索缓存的联系属于教学类比。

MAE到SAM初始化、检测器区域到ViLBERT、CLIP视觉到LLaVA三条公开组件复用关系。

  • 留下的能力
  • 在新系统中实际复用
  • 视觉表示
  • MAE 编码器
  • SAM 的初始化
  • 空间组织
  • 检测器区域特征
  • ViLBERT 的视觉输入
  • 图文对应
  • CLIP 视觉编码器
  • LLaVA 的视觉输入
  • 新的任务仍要定义输出、补上训练关系,并检验它。
  • 实线表示公开方法中的组件复用;共享计算与检索缓存的联系属于教学类比。
MAE到SAM初始化、检测器区域到ViLBERT、CLIP视觉到LLaVA三条公开组件复用关系。 查看对应图解状态
查看完整图解

课堂讲述

现在回头看,从分类迁移到区域,从对比与重建学习到大规模预训练,再到语言参与感知,我们看到的不是一串彼此淘汰的模型名字。 每一阶段都留下了后面能够使用的东西:训练得到的参数、可复用的特征、区域处理方式、数据与评价、软件和实验经验。不同研究组在这些积累上选择新问题,也形成新的合作。后来的多模态模型不是视觉突然失去价值,而是视觉和语言两边的积累有了新的组合方式。 对你们的科研,重要的是能够识别这种组合:现在已经有哪一项能力,新的任务还缺什么关系,怎样训练并检查它。今天的三个问题,就是沿着这条线依次展开的。接下来,我们把“根据条件使用表示”再往前推一步。

三条线怎样汇合:复用的是哪些具体资产

独立阅读

回看第三讲,研究积累不是只剩一串网络名称。第一部分留下能迁移的参数与表示;第二部分留下区域、像素和实例组织;第三部分让文字成为监督、输出和任务条件。新系统复用这些资产,再为尚未建立的关系训练。

P66 的三条实线有具体公开对应:SAM 的图像编码器用 MAE 预训练初始化;ViLBERT 使用检测器提供的区域特征;原始 LLaVA 使用 CLIP 视觉编码器接入语言模型。它们不是“所有新模型都按同一条技术树演化”,而是三种可以指出输入和权重来源的复用。

另有一个计算上的类比:Fast R-CNN 共享图像特征后再服务多个区域,双编码检索缓存图片向量后再服务多个查询。二者都把可复用计算提前,但不能因此声称检测研究直接导致了向量检索。这种区分让类比有教学价值而不伪造历史因果。

对研究实践,关键问题是:已有系统交付哪种输出?新任务还缺什么对应?例如有整图表示后,检测还缺定位和匹配;有视觉和语言编码器后,问答还缺条件使用与回答目标。把缺口说具体,才能知道应该改数据、接口、目标还是评价,而不是一遇到新任务就换更大的模型。

图示条件与公式约定

三条实线分别对应公开方法中的组件复用:MAE 初始化 SAM 图像编码器,检测器区域特征用于 ViLBERT,CLIP 视觉编码器用于原始 LLaVA。共享计算与检索缓存的联系是教学类比,不代表历史因果。

这条线索的展开与后续阅读

视觉与语言怎样把可复用能力改写成可检验的科研问题?

先写未来条件,再比较两种数据划分

资产复用降低起点,却不能代替对新条件的验证;先让预测时会遇到什么变得具体。

把“已有能力可迁移”改写成一个能被检验的研究问题

独立阅读

研究判断需要一个预测时会遇到的新条件。若未来样本来自新采集批次,却随机把同批次样本分到训练和测试,成绩可能主要反映记住批次。LAB21 用透明合成数据把这个问题做成完整对照。

12 个批次各 20 个样本,目标含较弱的观测信号 0.7x0.7x 和较强批次偏置。一个基线记训练批次均值,另一个只拟合 xx 的线性关系。历史保存结果如下:

划分 训练/测试重叠批次数 批次均值 RMSE x 线性基线 RMSE
随机样本划分 12 0.7822 2.3574
整批次留出 0 2.1152 1.7980

随机划分中批次均值很好,不是程序作弊,而是评价问题允许看到同批次历史;新批次任务下这个优势消失。x 基线也没有解释全部目标,因为它缺少未知批次偏置。两张成绩表对应不同预测问题,不能只选更好的一张。

这组数据不是农业实测,不产生现实效应结论。它示范一个有用的研究动作:明确未来条件,选能利用捷径的强基线,再改变切分使解释分叉。下一项可检验改动是把偏置标准差从 3 降到 0,看两种划分的差距是否缩小。已有代码和结果保留,本轮只重新组织阅读与回链。

沿这个问题继续

沿 MAE→SAM、检测器→ViLBERT、CLIP→LLaVA 三条连接辨认实际复用的组件。再为自己的迁移任务写出新条件、数据划分和一个可比较的基线。

到后续课程继续(1)

一个条件怎样容纳多种合理结果?

条件均值、合理样本与生成过程为什么是不同目标?

视觉与语言一个条件怎样容纳多种合理结果?

先区分条件固定什么,还允许什么变化

解释、算例与证据

P67 · 同一句描述,为什么可以有很多张正确图像?

画面刻意展示同一句条件对应多个合理图像。三幅红杯强调多样性,蓝杯强调条件约束;这些是语义例子,并非单变量受控比较。下方的 ±1 算例解释为什么一个最优平均值仍可能不是合理样本,让第四讲的问题有具体起点。

条件:红色杯子放在木桌上合理图像 1合理图像 2合理图像 3不满足:蓝杯检索已有图像从已保存的候选中选择生成新图像学习条件下的可能性,再产生样本已有 ImageGen 语义示例,独立生成用于展示多解性;不是受控模型比较。Caption 已在生成文字。

同一句红色杯子木桌条件对应三幅不同红杯场景与一幅蓝杯反例;比较检索已有图与生成新样本。

  • 条件:红色杯子放在木桌上
  • 合理图像 1
  • 合理图像 2
  • 合理图像 3
  • 不满足:蓝杯
  • 检索已有图像
  • 从已保存的候选中选择
  • 生成新图像
  • 学习条件下的可能性,再产生样本
  • 已有 ImageGen 语义示例,独立生成用于展示多解性;不是受控模型比较。Caption 已在生成文字。
同一句红色杯子木桌条件对应三幅不同红杯场景与一幅蓝杯反例;比较检索已有图与生成新样本。 查看对应图解状态
查看完整图解

课堂讲述

现在只给一句话:红色杯子放在木桌上。它可以对应很多合理图像,杯子的形状、位置、光线和桌面纹理都可能不同。我们不只是想从已有图片中找一张,还希望根据条件产生新的样本。 这与整图匹配不是同一项工作。匹配函数告诉我们哪些内容更相配,却不直接告诉我们怎样产生图像。MAE 根据可见内容预测缺失部分,也不自动给出一个完整的文生图系统。 同时不要忘了,图像描述和语言模型已经在生成文字。第四讲不是第一次听到“生成”,而是把这个问题系统展开:一个条件下有多种可能,模型怎样学习它们,又怎样从中产生一个结果?

一句描述限定一组可能图像,为什么需要生成问题

独立阅读

“红色杯子放在木桌上”指定了颜色、对象和支撑关系,却没有唯一指定杯型、位置、光照、视角和木纹。P67 三幅红杯都可能满足条件,蓝杯是颜色条件的反例。这些是既有独立生成的语义场景,适合展示多解性,不能当作只改颜色的受控实验。

如果目标是从图库找一张,检索已经有明确输出;若要求产生一张新图,就需要模型定义怎样把条件和可变化因素转为像素或其他图像表示。CLIP 的相似度能帮助比较候选,却没有单独提供生成新像素的过程。

MAE 提供“已见部分约束未知部分”的重建任务,也不因此自动变成文生图系统。它的输入、目标和训练资料与文本条件采样并不相同。相同的网络模块可以被复用,但新任务必须说明如何学习和使用。

同时,caption 已经在生成文字。第四讲的新增不是第一次遇到生成,而是把条件分布、合理多样性、学习反馈和采样过程放到中心。先区分什么由条件固定、什么仍可变化,才有办法讨论多种路线各自怎样学习这些可能性。

图示条件与公式约定

复用既有三幅红杯和一幅蓝杯 ImageGen 场景,已逐幅查看。它们是独立生成的语义例子,适合展示多解性,不适合作为只改颜色的受控实验。

这条线索的展开与后续阅读

视觉与语言一个条件怎样容纳多种合理结果?

算出最优平均值,再检查它是不是可能样本

解释、算例与证据

P68 · 下一讲:怎样学习可能性,并产生一个样本?

Caption 已经展示了以图像为条件生成文字。接下来把问题推进到更多输出:训练怎样学习条件下的多种可能,使用时怎样产生其中一个样本?第四讲将比较生成路线;本讲的多解算例提供共同起点。

同一条件,可以有多种合理结果学习可能性产生一个样本x ∼ pθ(x | c)第四讲的比较入口GANVAEDiffusion自回归图像 · 文字 · 视频 · 3D逼真,是否意味着理解了规律?

同条件的三幅红杯图,连接学习可能性和产生样本两个问题;下方只列第四讲四类方法入口。

  • 同一条件,可以有多种合理结果
  • 学习可能性
  • 产生一个样本
  • x ∼ pθ(x | c)
  • 第四讲的比较入口
  • GAN
  • VAE
  • Diffusion
  • 自回归
  • 图像 · 文字 · 视频 · 3D
  • 逼真,是否意味着理解了规律?
同条件的三幅红杯图,连接学习可能性和产生样本两个问题;下方只列第四讲四类方法入口。 查看对应图解状态
查看完整图解

课堂讲述

第四讲会比较 GAN、VAE、Diffusion 等路线,也会把已经见过的自回归生成放进同一张问题图。它们不是严格的前后替代史,关键是训练信号、表示方式和产生样本的过程各有什么不同。 图像、文字、视频和三维数据又提出不同要求:文字有离散单位,视频要处理时间关系,三维还要考虑空间和多视角的一致性。这些会在生成问题中逐步进入,不在今天再开启四个专题。Transformer 则是一类可用的网络架构,不等于其中任何一种生成目标。 今天先带走三项判断:看清训练答案从哪里来;看清新任务需要保留和读取什么;看清语言加入以后,还需要建立什么对应。下一讲再问:结果看起来逼真,究竟说明模型掌握了什么规律?

一个可算的多解例子:最小均方误差为何给出不存在的结果

独立阅读

给定同一条件 cc,真实结果 XX 等概率取 −1-1 或 +1+1。若模型只能给一个确定数 aa,并最小化平均平方误差,

E[(X−a)2∣c]=12(−1−a)2+12(1−a)2=1+a2.\mathbb E[(X-a)^2\mid c]=\tfrac12(-1-a)^2+\tfrac12(1-a)^2=1+a^2.

最优值是 a=0a=0,误差为 1;但真实分布从不产生 0。模型给出了最好的条件均值,却没有给出一个真实可能样本。对应图像的直观例子是杯子可能在左或右,逐像素平均可能出现模糊或重影,而不是某一次合理摆放。

再设生成器正确地随机输出 −1-1 或 +1+1,与一份独立抽出的真值比较,二者一半相同、一半差 2,期望平方误差是 0.5×0+0.5×4=20.5\times0+0.5\times4=2。生成器符合真实分布,却在这种独立配对 MSE 上比输出 0 更差。这说明评价没有衡量我们真正要求的对象。

因此生成评价至少拆开条件满足、样本合理和多样性覆盖。逼真但总输出同一种可能会漏掉模式;很多变化但不满足红色条件也失败。这个小算例只解释问题结构,不替任何生成算法背书,完整训练和采样方法留第四讲。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:条件说清楚后为什么还要随机性?

教师:因为它通常只限定一组结果。杯型和光照没有被完全指定,合理系统应能表达这些可能性,而不是只能给平均像素。

沿这个问题继续

先比较红杯图像共享的条件与各自变化,再计算 ±1 等概率例子的均方误差最优解。解释为什么平均值可以最优,却不是分布中可能出现的样本。

到后续课程继续(1)

出处:课程大纲

图示条件与公式约定

保留四种方法名作为第四讲比较入口,不引出具体生成算法;文字生成已经在 caption 中出现。

这条线索的展开与后续阅读

视觉与语言一个条件怎样容纳多种合理结果?

带着三个层次进入后续课程

同一指标可能错量所需目标;后续课程据此区分怎样学习分布、怎样计算预测和怎样产生样本。

后续阅读:学习目标、模型架构和采样方式分别是什么

独立阅读

第三讲先带走三件事:训练答案从哪里来,任务输出需要保留与读取什么,语言加入后还需建立什么对应。第四讲把问题转为“模型怎样学习一组可能结果,并从中产生一个样本”。

GAN 通过判别反馈组织生成学习;VAE 用潜变量概率模型和可采样先验连接编码与生成;扩散从构造的破坏过程学习恢复相关预测。自回归已在 caption 中出现,用一连串条件预测组织生成。它们是后续比较入口,不在本页展开完整算法,也不是按课堂顺序互相淘汰的历史。

还要分清三种层次。网络架构规定一次预测怎样计算;训练目标规定参数依据什么反馈更新;采样或解码规定怎样使用已学预测产生结果。Transformer 是架构名称,不能直接等同于某种生成目标。更详细的 RNN、attention、Transformer 留第五讲;扩展定律与训练系统留第六讲;近似索引和检索工程留第八讲。

深读时可以沿原厚材料的生成信号、不同模态与解码算例继续,但先完成第三讲的接口理解即可。视频的时间连续和三维的多视角一致性在第四讲继续,不把它们变成第三讲末尾四个新的主讲专题。

视觉与语言一个条件怎样容纳多种合理结果?

选读:比较局部选择与完整路径概率

Caption 已经使用逐词生成;这段保留为第四讲生成与第七讲搜索的预备阅读。

选读:局部最高概率为何不保证整句最高概率

独立阅读

这段作为第四讲生成和第七讲搜索的预备阅读;第三讲只需知道推理会接续自己的输出。令首词 A/B 概率为 0.6/0.4;A 后 X/Y 为 0.51/0.49;B 后 X/Y 为 0.9/0.1;下一步都以概率 1 输出 EOS。每层出边和为 1。

完整路径 AX、AY、BX、BY 的概率分别为 0.306、0.294、0.360、0.040。greedy 首先取 A,再取 X,得到 0.306;宽度 2 的 beam 首步保留 A/B,再展开并排序,能保留最终的 BX=0.36。这个可算小树解释局部选择与完整路径概率的差别。

有限 beam 仍可能在更大树里提前删掉最优前缀;更高模型概率也不保证更符合图像。如果模型把蓝杯误识成红杯,搜索更充分可能只是更坚定地输出错误描述。必须区分视觉建模错误、概率预测错误和搜索错误。

当前 LAB13 的实际模型中 greedy 与 beam=3 均为 100% 整句匹配,没有显示 beam 的经验优势。其热身代码采用另一棵归一化概率树,greedy=AZ、概率 0.3025,beam=BY、概率 0.36;两棵树各自定义自洽,不能把一棵树的首步概率与另一棵树的结果混用。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:给一张图多种描述,损失不是互相矛盾吗?

教师:它们可以是同一条件下不同合理表达。我们学习条件分布,并由任务决定哪些信息必须覆盖;不是要求逐像素唯一地对应一句话。

学生:训练时已经把前面的正确词给了模型,它会不会根本不看图?

教师:会有这种可能,所以还要从同一前缀自由生成,并交换或去掉图像。LAB13 保留的视觉消融就是在检查这一点。

沿这个问题继续

先回看本页画面并指出输入、条件和输出,再按“图像条件怎样进入一个可变长度答案 → 训练前缀、EOS 与 PAD:损失究竟算在哪些位置 → 已保存的条件生成实验:视觉输入确实改变了句子”阅读。相关实验以其已保存结果为起点,需要动手时再顺序执行 Notebook;

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:Caption 都生成文字了,第四讲新增什么?

教师:今天用生成接口完成视觉任务;下一讲研究分布如何学到、不同训练反馈如何组织,以及怎样采样。这是研究焦点的推进,不是第一次出现生成。

沿这个问题继续

回到 ±1 多解算例,分别说清“预测平均值”和“产生一个可能样本”的目标。带着这个区别进入第四讲,再比较不同生成方法。

按问题回查的讲解与短练习(1)

到后续课程继续(1)

出处:课程大纲