CLS 02 · 从类别到区域与掩码
主线阅读与优先实验
同图四输出、共享计算、FCN、RoIAlign、信息碰撞与SAM接口
对应课堂(19 页)
可先阅读已有结果,再决定是否运行。重算时请核对各节记录的数据、参数、环境与日期。
学习路径: 一张图怎样变成一组框 · 像素、边界与对象身份。两个入口引用同一份现有材料,不需要重复阅读或运行。
先读下面的同源场景,再沿共享特征、像素预测和区域对齐往下走。读完后应能解释两件事:两个同类杯子为什么仍需两个身份;改好采样位置为什么不能自动补回已被均值抹掉的信息。每个问题都有可单独引用的 空间学习材料。
动手时先选一种深度:用 LAB 03 做坐标与表示短练习;想走完整学习过程,再在 LAB 10:RGB→框 与 LAB 11:RGB→mask 中选一本。框公式查 CLS 07,像素损失与实例区别查 CLS 08,不必按编号全部运行。
1. 同一场景,四种需要交付的答案
原始遮挡场景
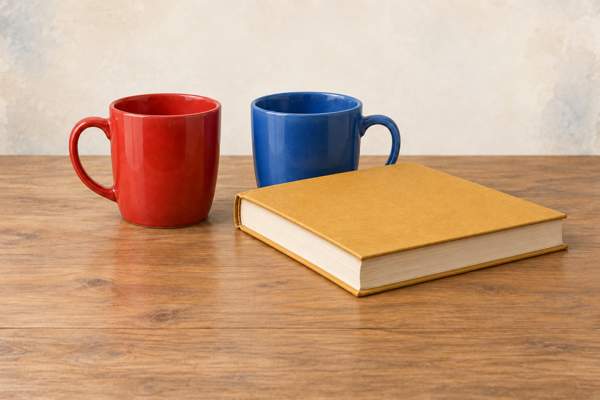
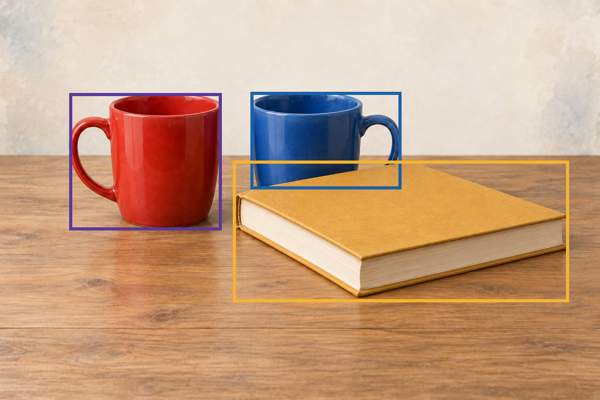
框:两个杯实例与一本书
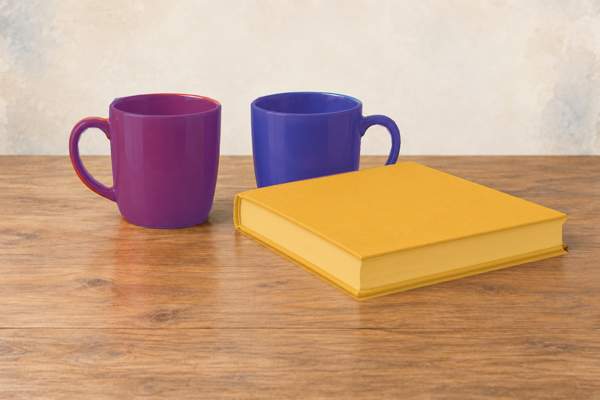
语义像素:两只杯共享类别
实例像素:两只杯分别编号
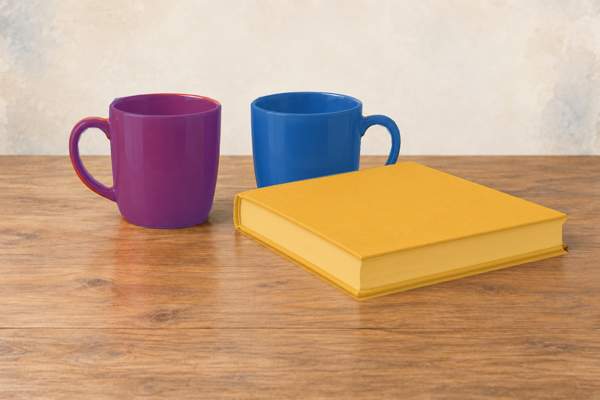
桌面多对象场景及教学框/掩码:同类杯子保留不同实例身份,局部遮挡让边界不总是完整可见。标注用于解释输出定义。
先不记模型名字。想象使用者依次改变要求:
| 使用者要什么 | 输出中至少要有什么 | 它还没有回答什么 |
|---|---|---|
| “画面里有什么?” | 杯子、书等类别 | 每个对象在哪里、有几个 |
| “找出每一个杯子。” | 每个对象的类别与框坐标 | 框内哪些像素属于杯子 |
| “把所有杯子像素选出来。” | 每个像素的类别 | 两个相接的杯子各是哪一个 |
| “分别选中两个杯子。” | 像素归属和实例身份 | 遮挡背后的不可见形状仍需额外约定 |
这四行分别对应分类、检测、语义分割、实例分割。框给出一个矩形范围,不能表达把手中间的空洞;同一个“杯子”类别值,又不能单独区分两只杯子。
先预测: 如果只保留“杯子、书”两个词,后续能从这两个词恢复第二只杯子的坐标吗?新任务改变了输出,也改变了训练答案必须包含的信息。
共享整图卷积:固定输出形状,保留区域身份
SPP-net 和 Fast R-CNN 将大量卷积计算移到整图共享阶段。对不同大小候选,区域池化再得到固定形状的区域特征,使后续分类/框回归可以共用参数。SPP-net · Fast R-CNN
沿同一张图追踪:
- 原图经过主干,得到仍有空间位置的共享特征图 F。
- 框坐标从原图坐标系映射到 F 的坐标系。
- 区域读取把各框内特征整理成固定形状。
- 每个区域分别输出类别与修正后的坐标。
杯一、杯二的区域身份没有因计算共享而消失。需要进一步追问的是:区域最初从哪里来,能否也学习?
Faster R-CNN:让候选也由特征提出
Faster R-CNN 的区域建议网络(RPN)在共享特征图上预测候选是否像对象,并调整候选框的位置。它把“值得进一步查看的区域”也变成可训练输出,再交给后续区域分类与框回归。Faster R-CNN
三步的变化可以这样读:逐区域重复抽特征 → 整图特征共享 → 在共享特征上学习提出候选。检测监督包含对象类别与框;已有分类权重提供起点,新的输出仍需学习。
到此停一下: 如果所有框都准确了,我们是否已经知道每一个杯子把手的像素边界?下面从另一个问题出发,不把 FCN 排成 Faster R-CNN 的下一版。
Mask R-CNN:在每个对象区域内预测掩码
Mask R-CNN 保留检测的区域组织,再为每个区域增加一个像素掩码分支。区域分类/框回归回答对象是什么、在哪里;掩码分支回答该区域中哪些位置属于这个实例。Mask R-CNN
若杯一与杯二同属杯子,类别相同也能有两张分别属于它们的掩码。训练要求有对应实例的像素标注;主干可复用,但区域内的精细输出不是只换一个名称就自动出现。
这时我们碰到新的敏感点:分类可能容忍区域平移一点,逐像素边界却可能因此错一排。边界错了,是读取时发生错位,还是表示里没有留下足够信息? 先看读取。
4. 对齐:把连续位置准确交给现有特征图
RoIAlign 的正面作用,是保留连续区域位置,在已有特征图上做采样,减少取整造成的区域错位。
约定原图坐标与特征坐标满足 u=x/stride,不引入像素中心额外偏移。若 x=35、stride=16,则 u=2.1875。它位于特征索引 2 与 3 之间,距离左邻为 0.1875。给定两个邻居值 2 与 6:
若先把位置取成 2,读取值会是 2,连续位移的影响被丢掉了。真实 RoIAlign 在二维区域的网格中采样,使用双线性插值并聚合;这里的一维例子只隔离连续位置怎样影响读数。
先预测: 将 x 改为 36,读数是否连续变化?把 stride 改成 8 时,还能沿用特征索引 2、3 的这两个数吗?坐标约定与特征值必须一起明确。
展开完整实现代码
# 独立一维采样练习;不等同于完整二维 RoIAlign。
import math
feature = [0.0,1.0,2.0,6.0,7.0]
stride = 16.0
for x in [32.0,35.0,36.0,40.0,48.0]:
    u = x/stride
    lo = math.floor(u); hi = min(lo+1,len(feature)-1)
    alpha = u-lo
    v = (1-alpha)*feature[lo]+alpha*feature[hi]
    print(f'原图x={x:g}, 特征u={u:g}, 左邻={lo}, 插值={v:g}')
assert math.isclose((1-0.1875)*2+0.1875*6,2.75)5. 信息没留下,放大网格能找回来吗?
看正式问卷使用的两幅小图:
- 甲:
[[1,0],[1,0]],左列为 1。 - 乙:
[[0,1],[0,1]],右列为 1。
若编码器只留下一个均值,两幅都成为 0.5。现在规定其余特征与框也相同,后续不能回看原图。读取器收到完全相同的输入,无论怎样插值或放大,都没有依据对二者作出不同判断。
这不是说所有低分辨率特征都不能表达边界。给同样一个空间格子增加通道 左列均值−右列均值,甲得到 +1、乙得到 −1。网格大小没变,却有了可区分信息。
| 表示 | 甲 | 乙 | 读取器有区别可用吗? |
|---|---|---|---|
| 全图均值 | 0.5 | 0.5 | 没有 |
| 均值+左右差 | (0.5,+1) | (0.5,−1) | 有 |
先预测: 对一张真正训练出来的粗特征图,单凭“网格很粗”能断言左右信息必定丢失吗?应检查特征与读出行为,而不能只看张量外形。
展开完整实现代码
# 独立 CPU 练习:表示碰撞与新增通道。
A = [[1.0,0.0],[1.0,0.0]]
B = [[0.0,1.0],[0.0,1.0]]
def encode(matrix):
    mean = sum(map(sum,matrix))/4
    left_minus_right = sum(row[0] for row in matrix)/2-sum(row[1] for row in matrix)/2
    return mean,left_minus_right
fa,fb = encode(A),encode(B)
assert fa[0]==fb[0]==0.5
assert fa==(0.5,1.0) and fb==(0.5,-1.0)
for label,matrix in [('甲',A),('乙',B)]:
    average,side = encode(matrix)
    enlarged = [[average]*4 for _ in range(4)]
    print(label,'只留均值:',average,'放大后首行:',enlarged[0], '新增左右差:',side)
print('同一个均值放大后仍相同;差别来自编码时保存了新的通道。')回到真实训练:对齐为什么值得修复
Mask R-CNN v3 的 Table 2 使用 COCO trainval35k 训练、minival 测试;表中未另说明时报告 mask AP。以下固定 ResNet-50-C4、stride 16,并选同为 max 聚合的行:
| 区域读取 | 是否保留对齐 | 是否双线性 | mask AP | mask AP75 |
|---|---|---|---|---|
| RoIPool | 否 | 否 | 26.9 | 26.4 |
| RoIWarp | 否 | 是 | 27.2 | 27.1 |
| RoIAlign | 是 | 是 | 30.2 | 31.8 |
RoIAlign 相比 RoIPool 的 AP 增加 3.3 点,AP75 增加 5.4 点。RoIWarp 也插值却没有同样改善,支持“保持坐标对应”这一机制判断。平均聚合的 RoIAlign 行是 AP30.3/AP75 31.5,引用时不能把不同聚合行混在一个对照里。Table 2(d) 换成 C5、stride32,mask AP 从 23.6 到 30.9;这是另一组设置。
这些是训练完整模型的论文结果,不是本课程重跑。它们说明读取位置值得修复,尤其严格定位受益;P44 则把输入 F 固定成完全相同,讨论任何确定性读出都无法创造差别。方法有效与构造例中的信息限制,可以同时成立。
6. 活动:类别图与实例图怎样不同?
下面用一个小型教学网格表示两只杯子与一本书,独立于上方照片的人工轮廓。0 是背景,1/2 是杯一/杯二,3 是书。两只杯子在中间相接;实例图仍保留两个身份。
把实例 1 与 2 都映射为类别“杯子”后,语义图保留杯子整体区域,丢掉二者的身份差别。框则只记录每个实例出现的最小矩形范围,不保存矩形内部哪些格子为空。
先预测: 如果两个杯子的语义区域连在一起,仅凭语义图能唯一确定原来的分界吗?运行下格,比较 instance、semantic 和 boxes,再改变一个格子。静态读者可直接用这一解释:类别映射是多对一;两个不同实例图可以得到同一语义图。
展开完整实现代码
# 独立 CPU 教学标签网格;不是照片真值或检测模型输出。
instance = [
 [0,0,0,0,0,0,0,0],
 [0,1,1,2,2,0,0,0],
 [0,1,1,2,2,0,0,0],
 [0,1,1,2,2,0,0,0],
 [0,0,0,0,3,3,3,0],
 [0,0,0,0,3,3,3,0]]
class_of = {0:0,1:1,2:1,3:2} # 类别0背景,1杯子,2书
semantic = [[class_of[x] for x in row] for row in instance]
boxes = {}
for identity in [1,2,3]:
    coordinates=[(r,c) for r,row in enumerate(instance) for c,x in enumerate(row) if x==identity]
    rows,cols=zip(*coordinates)
    boxes[identity]=(min(cols),min(rows),max(cols)+1,max(rows)+1)
print('实例图:'); [print(row) for row in instance]
print('语义图:'); [print(row) for row in semantic]
print('框(x0,y0,x1,y1;右/下边界不含):',boxes)
assert semantic[1][2]==semantic[1][3]==1
assert instance[1][2]!=instance[1][3]7. SAM:点一下,这次要处理哪一个?
提示指定本次目标,训练学会响应提示
在杯柄上给一个正点,并不唯一规定目标是杯柄、整只杯子还是更大的对象组合。提示式分割的任务是根据图像与提示返回合理 mask;提示增加信息,但不必天然消除所有歧义。
几何提示可以分工:正点表示希望包含的位置,负点表示希望排除的位置,框给出大致区域,已有 mask 可以作为进一步修正的输入。它们不是人工直接提供完整答案,却约束了本次想处理的对象。模型须结合图像线索填出边界。
原始 SAM 将图像编码、提示编码和 mask 解码分开。同一图像的较重表示可缓存,用户改点、改框时重复较轻的后半段。它也能为模糊提示给出多个 mask 与估计质量,从而容纳“部分还是整体”的不同解释。
本页教学图显示提示与目标的对应关系;若要评价模型,应保存真正返回的 mask,并先约定期望的对象粒度。用户给一个点后显示手工真值,不能替代推理证据。LAB 16 目前保留的是确定性颜色/连通域规则,适合比较接口,不冒充 SAM 权重推理。
原始 SAM 的图像编码器使用 MAE 预训练初始化。这连接了第一部分的表示学习,但“遮挡重建”目标并没有直接提供“某个正点应对应哪个对象 mask”的全部监督。后续还要进行提示式分割训练。
训练样本包含图像、目标 mask 与模拟提示。模型预测后,可以从错误区域追加正点或负点,再要求它修正;原论文训练模拟每个 mask 的多轮交互,掩码损失组合 focal 与 dice。这样,推理时的“改点、改框”对应训练中学过的任务,而不是凭空获得一个通用按钮。
数据组织也属于能力来源。SA-1B 来自模型辅助标注、半自动补充、全自动生成的逐步演进,最终收集约 1100 万张图像与 11 亿个 mask。这里的数据单位是区域轮廓,并非现成的图文语句对。
预训练参数、任务监督和使用接口可以分别复用:先以自监督表示为起点,再学习图像/提示到掩码,使用时缓存同图表示。如果只说“MAE 会补图所以自然会分割”,就跳过了任务训练这一关键桥梁。注意此处是原始 SAM;文字提示在论文中有另行探索,不等于公开几何提示 checkpoint 默认已具备任意语言理解。
8. 从空间提示,走向语言指定
现在我们可以清楚地区分四种能力:判断画面中的类别、找对象框、给每个像素分类、按实例分出掩码。方法的推进围绕计算共享、输出身份和空间读取展开。
我们已经能用框和掩码指出对象,也能用一个点告诉系统“这次处理哪一个”。但人往往会说“找到红色杯子”,或者问“谁拿着球”。语言能否参与学习,也参与我们向系统提出任务?
到 L03-CLS 03,沿三种可以共存的作用继续:语言成为输出、提供学习信号,以及指定当前问题。
若想先动手,到 L03-LAB 03 · 空间信息:表示、采样与掩码。它沿用同图材料与这里的确定性计算,重点判断该改采样还是改表示,无需训练大型检测器。
课后先选一条路
不必按 Notebook 编号把所有内容从头运行。若刚听完课堂,先用 P25 的同一底图区分类别、框、语义与实例,再用 P41–45 的两个算例区分读取错位与表示碰撞。它们构成理解空间任务所需的最短连续线。
随后只选一项完整学习过程:关心对象位置就读 LAB 10,沿图像、目标、匹配、分类/位置损失、预测与错误图走完;关心面积或边界就读 LAB 11,比较 RGB 基线与 FCN、查看逐类 IoU 与窄缝错误。无需为了“完整”同时训练两本,也不要把只跑通环境当成理解模型。
LAB 09 是检测公式的工作台,遇到匹配、NMS 或 AP 不清时按问题查;LAB 03 是同源场景与空间读数的轻量练习。LAB 16 的颜色连通域和 LAB 20 的集合匹配放在选读,分别解释提示约束和对象排列,不与两项主实验争夺主线。
CLS 02 承担区域到掩码的连续导读;CLS 07、08 承担深入公式与实例。每个解释块有独立 URL,可直接带着具体问题交给 AI;链接中的正文先提供推理,再连接代码与原论文。
把这一段交给 AI 时,保留哪几个条件
若问 均值碰撞,保留“F 与框相同、不能回看原图”;若问 RoIAlign 论文结果,保留骨干、步长、聚合方式与训练/测试划分。前者是确定性算例,后者是完整模型的历史训练对照。
想查看连续文字可从 P25 开始;要定位一个公式或追问,可直接引用上方独立块 URL。这样 AI 读到的是具体材料与条件,而不只是模型名字。