LAB 07 · MoCo:历史 key、队列与两种更新
按问题继续
真实FIFO键、EMA、梯度更新及低于随机基线的保留结果
对应课堂(6 页)
可先阅读已有结果,再决定是否运行。重算时请核对各节记录的数据、参数、环境与日期。
学习路径: 视图、投影头与历史字典
本步拿到的旧key来自哪里,又怎样与当前query比较?
先手推容量4的FIFO与一次EMA,再在train_moco找到query、key、旧队列、loss和入队位置。读前5步trace,指出首次淘汰的是哪批特征;旧向量不会因EMA自动重算。
本册用真实图像和反向传播,保存结果中损失下降,但形状读出低于随机基线。你的产出是一次更新的有向流程加一句评价:哪项证据证明机制接入了训练,哪项证据回答下游用途。
从概率到字典更新
查询 q=(1,0),归一化后的第一个键最接近它。温度0.1时,其 softmax 概率约0.999939;温度0.5时约0.859767。温度改变的是已有相似度差距在概率中的放大,不会改变此处的键排序。
FIFO 容量4,从 a,b,c,d 入队 e,f 后得到 c,d,e,f。键参数 θk=(0,2)、查询参数 θq=(2,4),m=0.9 的一次 EMA 是 (0.2,2.2)。EMA 不是把两个模型的输出向量平均,也不是对键编码器额外反向传播。
展开完整实现代码
import os, tempfile
LAB_WORKDIR = tempfile.mkdtemp(prefix='lecture03-')
os.chdir(LAB_WORKDIR)
print('Ephemeral experiment workspace ready')
import numpy as np
q=np.array([1.,0.]); keys=np.array([[.8,.2],[0.,1.],[-1.,0.]])
keys=keys/np.linalg.norm(keys,axis=1,keepdims=True)
for T in [.1,.5]:
 s=keys@q/T; p=np.exp(s-s.max()); p/=p.sum(); print('T',T,'p',p.round(4))
queue=['a','b','c','d']; queue=(queue+['e','f'])[-4:]
tk=np.array([0.,2.]); tq=np.array([2.,4.]); print('queue',queue,'EMA',(0.9*tk+0.1*tq))运行准备与结果身份
本册包含全部生成数据、模型、损失、优化与评价代码。按顺序在新内核运行;不读另一册的变量,不需要下载图像或预训练权重。依赖 Python 3.12、NumPy、matplotlib、scikit-learn 和 CPU PyTorch。本次实际版本见输出 JSON;若环境缺少 PyTorch,先运行 python -m pip install torch==2.14.0 --index-url https://download.pytorch.org/whl/cpu,再启动内核。NumPy、matplotlib、scikit-learn 可用 python -m pip install numpy matplotlib scikit-learn 安装。
下方表格和静态图来自 2026-09-22 本地 CPU 完整训练;它们不是原来的数值热身输出,也不代表 Deepnote 云端已重跑。运行本册会另建 lab07-notebook-output,保存 inputs.npz、config.json、权重、图与 results.json。CPU 时间受机器负载影响;本次每册约 10–25 秒,不能当作跨设备速度基准。单种子、小任务的结果用来检验路径和对照,不作方法排名。
展开完整实现代码
"""CPU image contrastive experiment. No class/color label enters pretraining."""
from pathlib import Path
import copy, hashlib, json, os, platform, time
import numpy as np
import torch
from torch import nn
from torch.nn import functional as F
from sklearn.neighbors import KNeighborsClassifier
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt

torch.set_num_threads(2)
SEED=20260922

SOURCE_SHA256='09bbb32bb5502db3535d89efec2045ffcd85c249b49f622390f12875060845d4'
print("source",SOURCE_SHA256,"torch",torch.__version__)图像、两视图与同源正例
每本从种子独立生成相同的600/240源图切分。训练的每批60张图各产生两个视图;颜色保留,几何、亮度和噪声变化。源图索引相同的两视图是正例,而不是“类别相同就是正例”。生成标签只用于后面的冻结读出。
先读 info_nce 的正例索引 (i+N) mod 2N,确认它把前N个视图和后N个视图一一配对;对角线屏蔽自己。然后跟随 zero_grad → backward → step,观察编码器第一层实际发生非零变化。
展开完整实现代码
def make_data(seed=SEED):
    rng=np.random.default_rng(seed)
    yy,xx=np.mgrid[:16,:16]
    images=[]; shape=[]; color=[]; split=[]
    # Stratified before view construction. One independently generated source per ID.
    for s in range(3):
        for c in range(2):
            for i in range(140):
                cx,cy=rng.uniform(6,10,2); r=rng.uniform(3.0,4.7)
                dx,dy=xx-cx,yy-cy
                if s==0: mask=dx*dx+dy*dy<=r*r
                elif s==1: mask=np.maximum(abs(dx),abs(dy))<=r
                else: mask=abs(dx)+abs(dy)<=r*1.35
                # Red and blue have equal channel sums: grayscale erases hue by design.
                rgb=np.array([.9,.15,.15] if c==0 else [.15,.15,.9])
                bg=rng.uniform(.015,.075,(16,16,1))
                im=np.where(mask[...,None],rgb*rng.uniform(.8,1),bg)
                im+=rng.normal(0,.012,im.shape)
                images.append(np.clip(im,0,1).transpose(2,0,1))
                shape.append(s); color.append(c); split.append(0 if i<100 else 1)
    x=np.asarray(images,dtype='float32'); split=np.asarray(split)
    ids=np.arange(len(x)); train=ids[split==0]; test=ids[split==1]
    assert set(train).isdisjoint(test)
    assert len({hashlib.sha256(v.tobytes()).hexdigest() for v in x})==len(x)
    return torch.from_numpy(x),np.asarray(shape),np.asarray(color),train,test

def views(x, destroy_color=False):
    # Independent transforms of each source; no labels/scene attributes are read.
    a=x.clone(); n=len(a)
    shifts=torch.randint(-1,2,(n,2))
    for i,(dy,dx) in enumerate(shifts.tolist()):
        a[i]=torch.roll(a[i],(dy,dx),(-2,-1))
    a=a*torch.empty(n,1,1,1).uniform_(.8,1.2)
    a=a+torch.randn_like(a)*.025
    # The ablation changes only the hue swap. Every run consumes this RNG draw.
    swap=torch.rand(n)<.5
    if destroy_color: a[swap]=a[swap][:,[2,1,0]]
    return a.clamp(0,1)

class ImageEncoder(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv=nn.Sequential(nn.Conv2d(3,12,3,padding=1),nn.ReLU(),
          nn.Conv2d(12,24,3,stride=2,padding=1),nn.ReLU(),
          nn.Conv2d(24,24,3,stride=2,padding=1),nn.ReLU())
        self.readout=nn.Linear(24*4*4,48)
    def forward(self,x): return self.readout(self.conv(x).flatten(1))

class ContrastiveModel(nn.Module):
    def __init__(self):
        super().__init__(); self.encoder=ImageEncoder()
        self.projector=nn.Sequential(nn.Linear(48,48),nn.ReLU(),nn.Linear(48,24))
    def forward(self,x):
        h=self.encoder(x); z=self.projector(h)
        return h,z

def info_nce(z1,z2,tau=.2):
    z=F.normalize(torch.cat([z1,z2]),dim=1); n=len(z1)
    logits=z@z.T/tau
    logits=logits.masked_fill(torch.eye(2*n,dtype=torch.bool),-1e9)
    positive=(torch.arange(2*n)+n)%(2*n)
    return F.cross_entropy(logits,positive)

def train_simclr(initial,x,train,destroy_color,epochs=40):
    # Equal initialization, minibatch ordering, optimizer, steps, and RNG streams.
    torch.manual_seed(SEED+1)
    model=copy.deepcopy(initial); opt=torch.optim.Adam(model.parameters(),lr=.002)
    history=[]; before=next(model.encoder.parameters()).detach().clone()
    for epoch in range(epochs):
        model.train(); losses=[]
        for ids in torch.as_tensor(train)[torch.randperm(len(train))].split(60):
            batch=x[ids]; a,b=views(batch,destroy_color),views(batch,destroy_color)
            loss=info_nce(model(a)[1],model(b)[1])
            opt.zero_grad(); loss.backward(); opt.step(); losses.append(float(loss.detach()))
        history.append(float(np.mean(losses)))
    delta=float((next(model.encoder.parameters()).detach()-before).norm())
    assert delta>0
return model,history,delta为什么队列需要缓慢变化的键编码器?
批内方法的键都由当前参数生成。FIFO 让字典容量与当前批大小分开,但旧键来自较早的参数;若表示空间每步剧烈旋转,今天的查询与昨天的键就难以比较。MoCo 用
减缓键编码器变化。下面的教学实现 m=0.95,队列容量240、批大小60;query 和 key 初始权重相同。每步先对 key 做 EMA,再在 no_grad 中编码第二视图;查询梯度只更新 query;当次键以 detach 状态入队,最旧的键出队。第一次队列为空,采用当前批 detached keys 热身;后续正例放第0列,队列是负例列。
为避免一个源图跨 epoch 再出现时被当作自己的负例,队列同时保存源图 ID,并屏蔽同源旧键。同类别的不同源图仍可能是假负例;这正是实例目标与语义类别不同的地方。此实现没有BatchNorm,因此没有多设备BN信息泄漏处理;论文工程细节不能据此宣称已全部实现。
主讲按原论文Algorithm 1展示先计算本批key、更新query、再EMA的流程;下面代码在本批key前做EMA。二者时序应分别按各自实现追踪,详见 把一次学习走通,也读清实现顺序。这不是把旧队列重新编码。
展开完整实现代码
def moco_warmup():
    q=np.array([1.,0.]); keys=np.array([[.8,.2],[0.,1.],[-1.,0.]])
    keys/=np.linalg.norm(keys,axis=1,keepdims=True)
    probs={}
    for T in [.1,.5]:
        s=keys@q/T; p=np.exp(s-s.max());p/=p.sum();probs[str(T)]=p.tolist()
    queue=['a','b','c','d']; queue=(queue+['e','f'])[-4:]
    ema=.9*np.array([0.,2.])+.1*np.array([2.,4.])
    assert queue==['c','d','e','f']; assert np.allclose(ema,[.2,2.2])
    return {'temperature_probabilities':probs,'FIFO':queue,'EMA':ema.tolist()}

def train_moco(initial,x,train,epochs=15):
    # Small genuine image implementation: query grads, detached EMA keys, FIFO negatives.
    torch.manual_seed(SEED+2)
    query=copy.deepcopy(initial); key=copy.deepcopy(initial)
    for p in key.parameters(): p.requires_grad=False
    opt=torch.optim.Adam(query.parameters(),lr=.002)
    queue=torch.empty((0,24)); queue_ids=torch.empty(0,dtype=torch.long)
    history=[]; trace=[]; m=.95; capacity=240
    before=next(query.encoder.parameters()).detach().clone()
    for epoch in range(epochs):
        losses=[]
        for ids in torch.as_tensor(train)[torch.randperm(len(train))].split(60):
            a,b=views(x[ids]),views(x[ids])
            q=F.normalize(query(a)[1],dim=1)
            with torch.no_grad():
                for pk,pq in zip(key.parameters(),query.parameters()):pk.mul_(m).add_(pq,alpha=1-m)
                k=F.normalize(key(b)[1],dim=1)
            # Warmup uses detached current keys. Later batches use a real FIFO dictionary.
            if not len(queue):
                logits=q@k.T/.2; labels=torch.arange(len(ids))
                loss=F.cross_entropy(logits,labels)
            else:
                positive=(q*k).sum(1,keepdim=True)
                negative=q@queue.T
                # A source already in queue is NOT treated as its own negative.
                negative=negative.masked_fill(ids[:,None]==queue_ids[None,:],-1e9)
                logits=torch.cat([positive,negative],dim=1)/.2
                loss=F.cross_entropy(logits,torch.zeros(len(ids),dtype=torch.long))
            opt.zero_grad();loss.backward();opt.step()
            with torch.no_grad():
                queue=torch.cat([queue,k])[-capacity:];queue_ids=torch.cat([queue_ids,ids])[-capacity:]
            losses.append(float(loss.detach()))
            if len(trace)<5:trace.append({'step':len(trace),'queue_size':len(queue),'first_source_id':int(queue_ids[0]),'last_source_id':int(queue_ids[-1])})
        history.append(float(np.mean(losses)))
    assert all(p.grad is None for p in key.parameters())
return query,key,queue,queue_ids,history,trace,float((next(query.encoder.parameters()).detach()-before).norm())冻结参数以后才使用标签
评估提取清洁图像的 h48 和 z24,各自归一化;5-NN 只在训练图建立参考库,线性读出只在训练图拟合标准化和分类器。240张保留图没有用于调参。随机模型、批内模型与队列模型同初始网络;但批内训练40轮、队列模型15轮,负例数与目标也不同,所以这是一组完整路径与失败分析,不能用最终数字对SimCLR和MoCo排名。
展开完整实现代码
def evaluate(model,x,ys,yc,train,test):
    model.eval()
    with torch.no_grad(): h,z=model(x)
    scores={}
    for space,features in [('h',h),('z',z)]:
        a=F.normalize(features,dim=1).numpy()
        for target,y in [('shape',ys),('color',yc)]:
            knn=KNeighborsClassifier(n_neighbors=5,metric='cosine')
            knn.fit(a[train],y[train])
            # Standardization and classifier fit use TRAIN only; test used once for reporting.
            linear=make_pipeline(StandardScaler(),LogisticRegression(C=1,max_iter=1000))
            linear.fit(a[train],y[train])
            scores[f'{space}_{target}_knn']=float(knn.score(a[test],y[test]))
            scores[f'{space}_{target}_linear']=float(linear.score(a[test],y[test]))
    with torch.no_grad():
        # Counterfactual hue swap only: same geometry and pixels, channels exchanged.
        ah,az=model(x[test][:,[2,1,0]])
        for space,original,other in [('h',h[test],ah),('z',z[test],az)]:
            scores[f'{space}_hue_swap_cosine']=float(F.cosine_similarity(original,other).mean())
    return scores

def plot_results(out,x,initial,models,results,histories):
    fig,ax=plt.subplots(3,6,figsize=(12,6))
    ids=[0,100,140,280,420,700]
    torch.manual_seed(SEED+6)
    for j,i in enumerate(ids):
        ax[0,j].imshow(x[i].permute(1,2,0));ax[0,j].set_title(f'source {i}')
        paired_state=torch.get_rng_state()
        for row,erase in [(1,False),(2,True)]:
            torch.set_rng_state(paired_state)
            ax[row,j].imshow(views(x[i:i+1],erase)[0].permute(1,2,0))
    for row,label in enumerate(['source','view: hue kept','view: hue can swap']):ax[row,0].set_ylabel(label)
    for a in ax.flat:a.set_xticks([]);a.set_yticks([])
    fig.tight_layout();fig.savefig(out/'views.png',dpi=140);plt.close(fig)
    fig,axes=plt.subplots(1,3,figsize=(14,4))
    for name,hist in histories.items():axes[0].plot(np.arange(1,len(hist)+1),hist,label=name)
    axes[0].set(xlabel='epoch',ylabel='InfoNCE (batch mean)',title='Training objective');axes[0].legend(fontsize=8)
    names=list(results)
    for ax,task in zip(axes[1:],['shape','color']):
        pos=np.arange(len(names)); width=.34
        for off,space in [(-width/2,'h'),(width/2,'z')]:
            ax.bar(pos+off,[results[n][f'{space}_{task}_knn'] for n in names],width,label=space)
        ax.set_xticks(pos,names,rotation=20);ax.set_ylim(0,1.05);ax.set_title(f'Frozen cosine 5-NN: {task}')
        ax.set_ylabel('held-out accuracy');ax.legend()
    fig.tight_layout();fig.savefig(out/'training-and-probes.png',dpi=140);plt.close(fig)

def run_contrastive(out_dir='lab06-output',mode='color'):
    started=time.time();out=Path(out_dir);out.mkdir(parents=True,exist_ok=True)
    torch.manual_seed(SEED)
    x,ys,yc,train,test=make_data()
    np.savez_compressed(out/'inputs.npz',images=x.numpy(),shape=ys,color=yc,train_ids=train,test_ids=test)
    initial=ContrastiveModel(); torch.save(initial.state_dict(),out/'random-init.pt')
    results={'random':evaluate(initial,x,ys,yc,train,test)};histories={};models={};deltas={}
    if mode=='color':
        for name,erase in [('keep-hue',False),('swap-hue',True)]:
            model,hist,delta=train_simclr(initial,x,train,erase)
            results[name]=evaluate(model,x,ys,yc,train,test);histories[name]=hist;models[name]=model;deltas[name]=delta
            torch.save(model.state_dict(),out/f'{name}.pt')
    else:
        model,hist,delta=train_simclr(initial,x,train,False)
        results['simclr']=evaluate(model,x,ys,yc,train,test);histories['simclr']=hist;models['simclr']=model;deltas['simclr']=delta
        torch.save(model.state_dict(),out/'simclr.pt')
        query,key,queue,queue_ids,hist,trace,delta=train_moco(initial,x,train)
        results['moco-toy']=evaluate(query,x,ys,yc,train,test);histories['moco-toy']=hist;models['moco-toy']=query;deltas['moco-toy']=delta
        torch.save({'query':query.state_dict(),'key':key.state_dict(),'queue':queue,'queue_ids':queue_ids},out/'moco-toy.pt')
        (out/'queue-trace.json').write_text(json.dumps(trace,indent=2))
    config={'seed':SEED,'mode':mode,'image_shape':[3,16,16],'train_n':len(train),'test_n':len(test),'batch_size':60,'epochs_simclr':40,'epochs_moco':15,'tau':.2,'adam_lr':.002,'h_dim':48,'z_dim':24,'labels_used_only_for_probes':True,'knn':{'k':5,'metric':'cosine'},'linear_probe':{'regularization_C':1,'standardizer_fit':'train-only'},'test_tuning':'none; fixed protocol before first run'}
    (out/'config.json').write_text(json.dumps(config,indent=2))
    plot_results(out,x,initial,models,results,histories)
    payload={'code_sha256':globals().get('SOURCE_SHA256') or hashlib.sha256(Path(__file__).read_bytes()).hexdigest(),'kind':'local CPU full training + frozen held-out probes','utc':time.strftime('%Y-%m-%dT%H:%M:%SZ',time.gmtime()),'seconds':time.time()-started,'torch':torch.__version__,'numpy':np.__version__,'python':platform.python_version(),'scores':results,'loss_history':histories,'encoder_weight_l2_change':deltas,'warmup':moco_warmup(),'inputs_sha256':hashlib.sha256((out/'inputs.npz').read_bytes()).hexdigest()}
    (out/'results.json').write_text(json.dumps(payload,indent=2))
    print(json.dumps({'scores':results,'encoder_weight_l2_change':deltas,'seconds':payload['seconds']},indent=2))
return payload展开完整实现代码
result=run_contrastive('lab07-notebook-output',mode='moco')
print('FIFO/EMA warmup',result['warmup'])
print(Path('lab07-notebook-output/queue-trace.json').read_text())
from IPython.display import Image,display
display(Image(filename='lab07-notebook-output/training-and-probes.png'))已运行结果:字典正确,不代表语义读出必然变好
| 编码器 | h形状5NN | z形状5NN | h颜色5NN | z颜色5NN | h形状线性 | h颜色线性 |
|---|---|---|---|---|---|---|
| random | 72.50% | 60.42% | 100.00% | 100.00% | 56.25% | 100.00% |
| simclr | 47.50% | 58.33% | 100.00% | 100.00% | 69.17% | 100.00% |
| moco-toy | 38.33% | 38.75% | 100.00% | 100.00% | 54.58% | 100.00% |
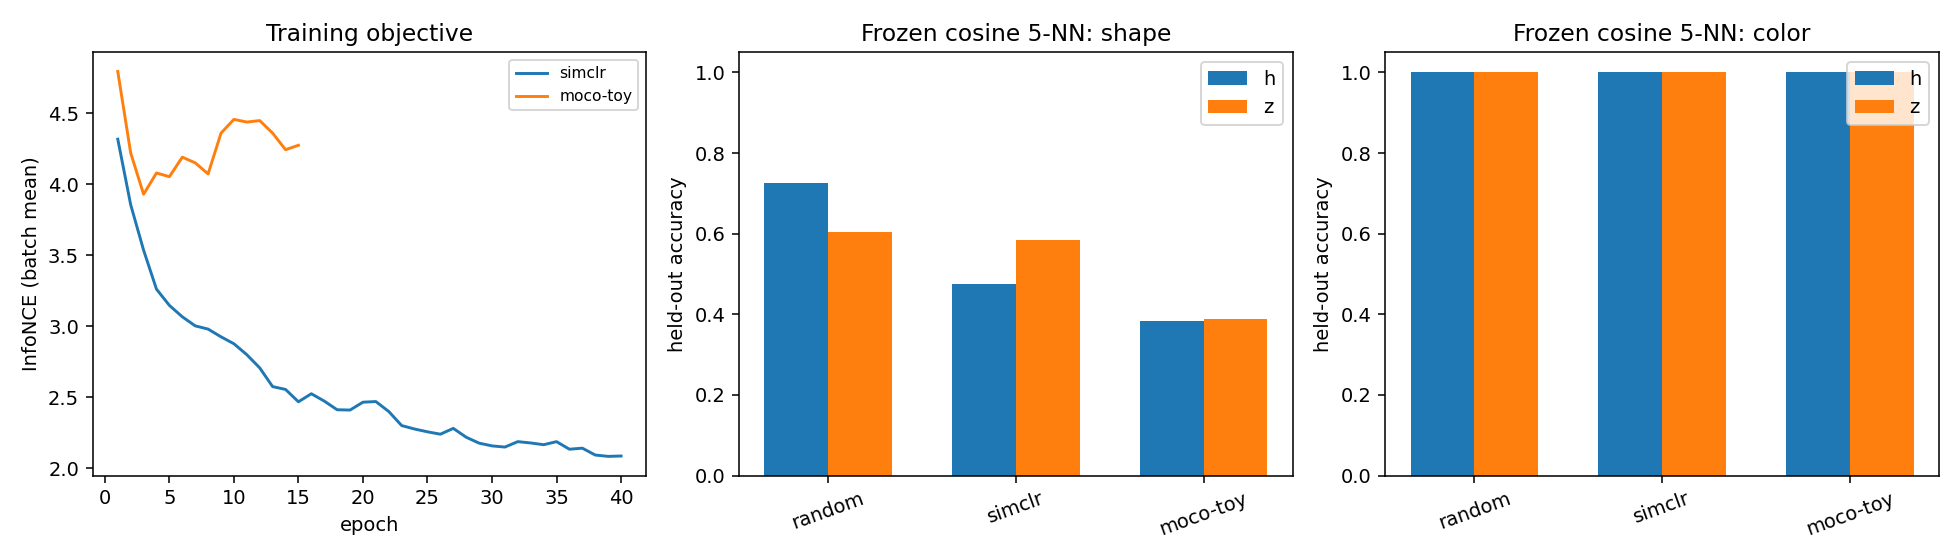
批内模型h形状5-NN为47.50%,小型MoCo为38.33%,都低于随机网络72.50%;颜色准确率均为100%。MoCo训练损失从4.793降至4.274,query第一层权重变化范数0.7625,且key参数全部没有梯度。模型实际学了,但有限的实例区分目标更容易保留颜色、位置等因素;不能把“loss下降”翻译成“形状语义更好”。
队列前几步的长度是60、120、180、240、240,第5步开始淘汰旧键,完整ID轨迹和最终队列随权重保存。这个证据与前面的字符串FIFO各回答一层问题:字符串检查精确更新顺序,图像代码检验这个顺序是否真的接入了训练。
若要考察增强能否改变这些结果,先保持队列容量、EMA和训练轮数,参照LAB06只加入色相交换。若要研究m,就保持其余设置,预先指定一组m和多枚种子;不要看过本保留集以后反复调到胜过随机再报告。
云端复核(2026-09-22):Python 3.13 / PyTorch 2.12.0+cu130 环境以 CPU 张量完整执行,SimCLR h形状5-NN为54.17%,小型MoCo为37.92%,随机仍为72.50%;颜色均100%。本地表格保留其 Python 3.12 / PyTorch 2.14 CPU 的实际结果,两次不合并为同一测量。队列/EMA接入和编码器更新均由云端输出核验。运行 ID:3e1babc4-7e23-46fe-8bfd-257351081ef9。
接回前后知识
来源:MoCo 原论文(CVPR 2020) 给出动态字典、队列与动量编码器;作者代码仓库 是完整实现入口。SimCLR 原论文 是本册批内对照的研究来源。本册小CNN、空队列热身和同源ID屏蔽均在代码中显式列出,属于教学实现选择。