已保存的指代实验:从像素提框后再应用关系
课堂上下文:从哪个问题来
语言条件落实为空间输出时,需要明确目标、参照物和关系。GLIP 提供对象级学习和迁移的研究路线;LAB15 提供可逐像素追踪的规则实验。两者的层级不同,但都帮助判断系统到底把框放在谁身上,再与后续掩码处理连接。
LAB15 的当前实现先从 RGB 图像按颜色阈值提取连通域,得到候选框;再解析目标、参照物与关系。它是真正读取像素的规则系统,类别由有限颜色约定提供,没有训练神经 grounding 模型。这个身份既不应被贬为“没读图”,也不应被升级为“复现 GLIP”。
| 实际输入改变 | 问句 | 保存的输出 |
|---|---|---|
| 原图左红、右蓝 | 蓝杯左边的杯子 | 左红杯 |
| 灰块遮住左杯 | 同上 | 无唯一可见目标 |
| 只交换两杯 RGB 色值 | 同上 | 无目标,蓝杯已在最左 |
| 保持交换图,只把 left 改 right | 蓝杯右边的杯子 | 右红杯 |
遮挡是真的修改图片,不是在答案字典里删除目标;交换色值保留轮廓和背景;语言对照保持图片完全相同。代码断言干预区域外像素不变,并保存差分图。它因此能够支持这些有限条件下“图片怎样改变候选、关系怎样选择目标”的解释。
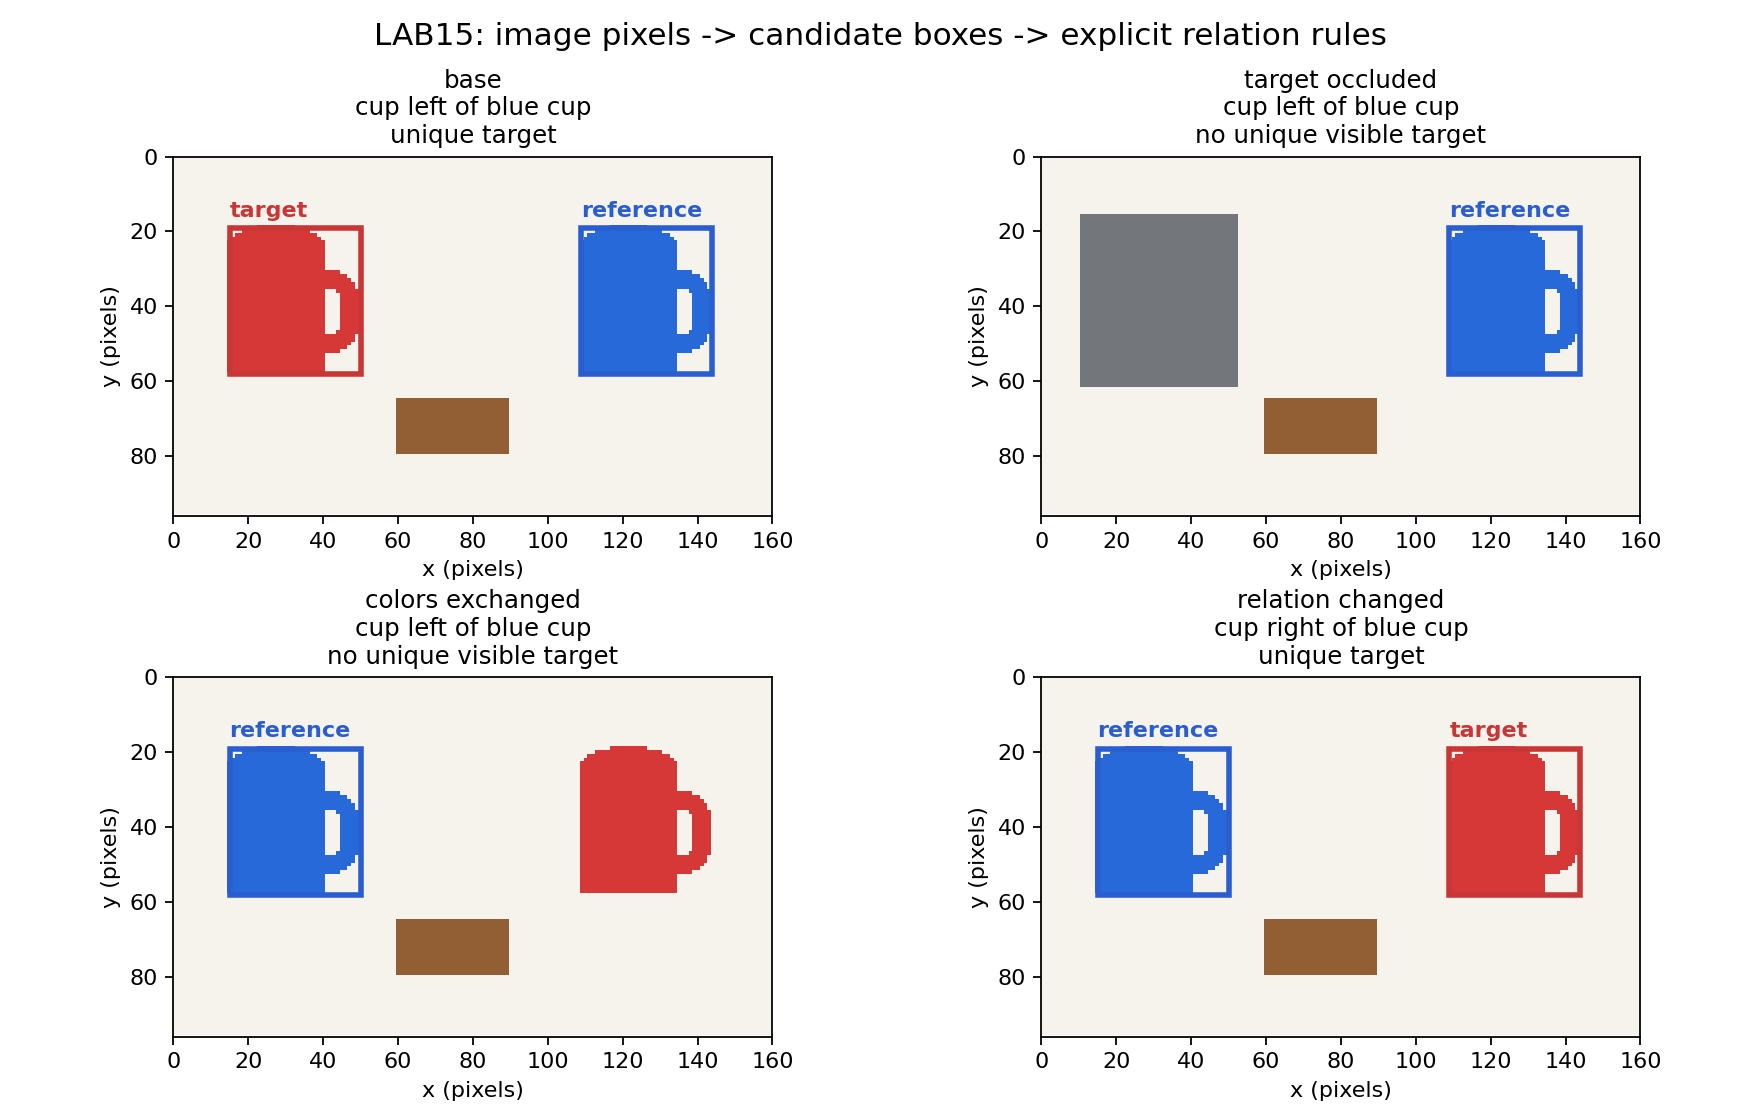
旧关键词规则错选蓝杯仍保留为失败基线。当前结果来自 2026-09-22 已保存运行,本轮未重跑。若以后换自然照片,颜色阈值和杯子类别约定会失效;那时才需要加载相应视觉模型,并对输入和实际框做新的可追溯评价。