LAB 11 · 从 RGB 到像素:读出、FCN 与边界
按问题继续
前景/背景/mIoU口径、RGB到mask训练、FCN与1×1读出及边界
对应课堂(6 页)
可先阅读已有结果,再决定是否运行。重算时请核对各节记录的数据、参数、环境与日期。
学习路径: 像素、边界与对象身份
一张框正确的图,仍未说明椭圆边缘和两物体间的背景缝。本册对应 P36–38,训练 RGB→三类像素输出,并比较逐像素线性读出和小型 FCN;它没有训练实例身份。
先预测采样结果,再判断指标名称
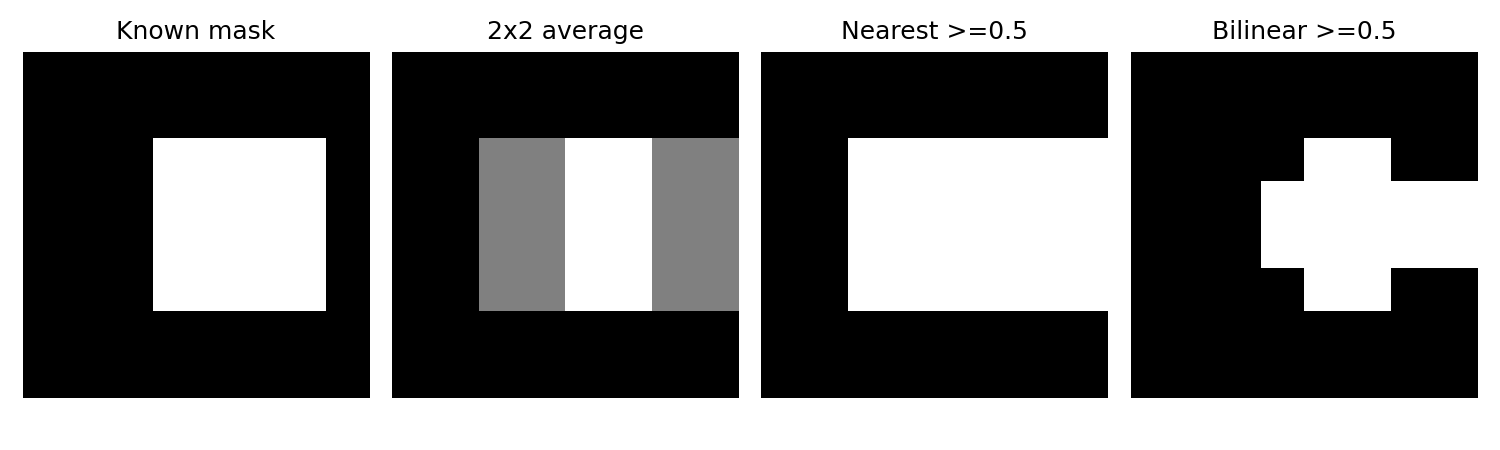
8×8 真值有 16 个前景、48 个背景。每个 2×2 小块求平均得到 4×4 覆盖率;最近邻扩大回 8×8,再以 ≥.5 二值化,会把半覆盖小块全部判前景,因此预测前景有 24 个像素。前景交集 16、并集 24,;背景交集 40、并集 48,。两类平均为 .75,8 个像素错,准确率为 .875。
双线性插值在四个邻近覆盖率之间加权,align_corners=False 明确规定坐标对应。它不凭空恢复原边界。本例阈值仍为 .5:双线性只有 6 个错误像素,像素准确率 .90625,却仍然得到前景 IoU=2/3;误差位置、前景集合大小变化会使不同指标给出不同读数。它的背景 IoU=.88462,两类 mIoU=.77564。不能把“更平滑”直接改写成“知道了真实轮廓”。
对 RGB 或 logits 的双线性插值可以混合实值。对类别 mask,编号 1、2 不是数轴上可平均的强度:几何变换应采用最近邻保持离散标签;ignore=255 也必须保持身份。下面的训练增强只水平翻转,对图像和 mask 执行同一个随机选择。
展开完整实现代码
import os, tempfile
from pathlib import Path
# Isolated ephemeral workspace supports detached runs with readonly project storage.
SPATIAL_RUN_DIR = Path(tempfile.mkdtemp(prefix='lecture03-'))
os.chdir(SPATIAL_RUN_DIR)
print('Ephemeral experiment directory:', SPATIAL_RUN_DIR)展开完整实现代码
import importlib.util, subprocess, sys
from pathlib import Path
# The only download, if needed, is open-source Python packages, not model weights.
if importlib.util.find_spec('torch') is None:
    subprocess.check_call([sys.executable, '-m', 'pip', 'install', 'torch', '--index-url', 'https://download.pytorch.org/whl/cpu'])
missing=[p for p in ['numpy','matplotlib'] if importlib.util.find_spec(p) is None]
if missing: subprocess.check_call([sys.executable,'-m','pip','install',*missing])
import torch, numpy as np
print('Python',sys.version.split()[0], 'torch',torch.__version__, 'numpy',np.__version__, 'device: CPU')三类逐像素预测的可执行定义
生成图像为 [B,3,48,48],真值为 int64 [B,48,48],logits 为 [B,3,48,48]。通道 0/1/2 分别是背景/红色矩形/蓝色椭圆。384 张训练图与 128 张保留图使用原始场景种子 7101 和 7901;没有把同图的翻转分到两侧。对象数、位置、尺寸和亮度变化,含空图与多对象图。
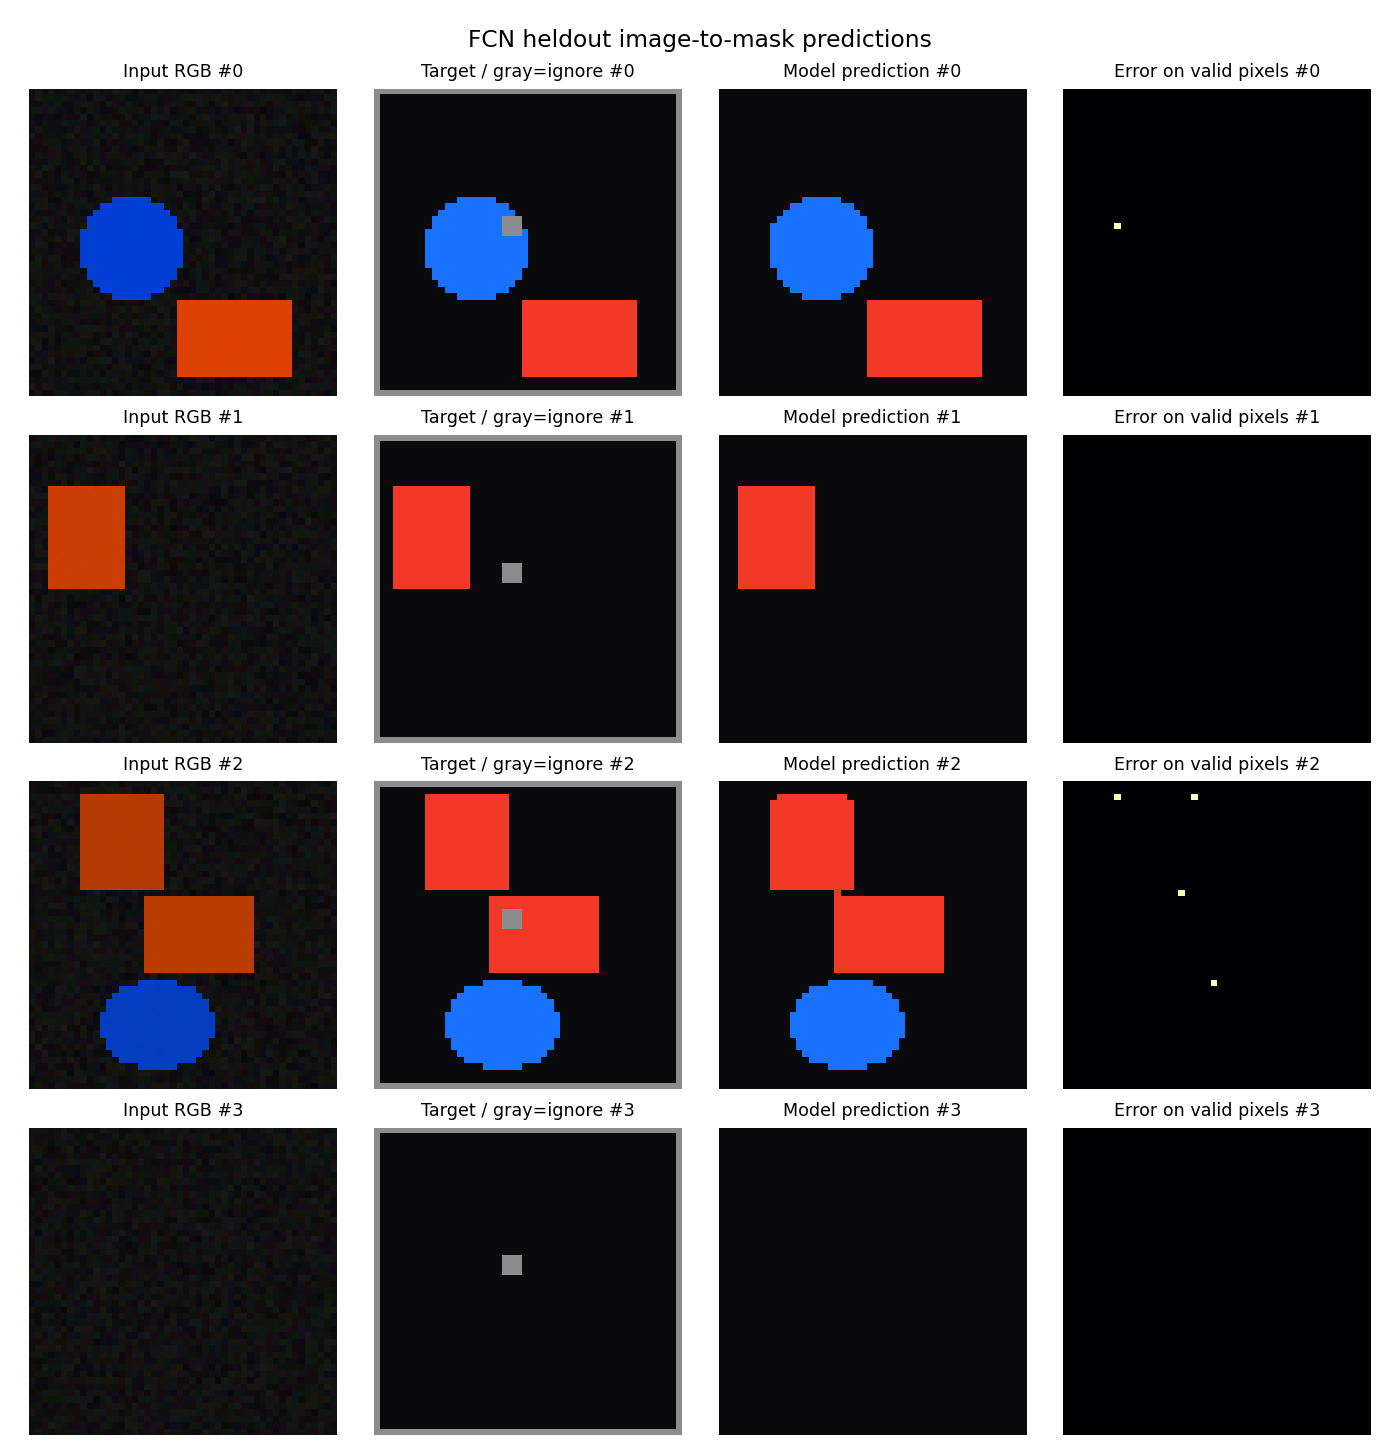
每张 mask 的一像素边框和 [20:23,20:23] 区域标为 255,模拟未标注区域。255 不代表第四类;loss 用 ignore_index=255 排除,混淆矩阵也只统计有效像素。本次保留集有 269,696 个有效像素、25,216 个忽略像素。忽略区仍然会产生模型输出,但不能据此判断对错。
以下代码格依次写出同一个自包含脚本。数据生成和度量函数在本册内完整给出,不依赖另一册先执行。
展开完整实现代码
%%writefile lab11_segmentation.py
"""LAB11: sampling warm-up, learned pixel readout, and image-to-mask FCN.
Run: python lab11_segmentation.py --out lab11-results --epochs 20
Dependencies: torch numpy matplotlib. Self-contained; CPU only.
"""
"""Shared transparent geometry and image construction for LAB10/11; no downloads."""
import json, hashlib, platform, sys, time
from pathlib import Path
from datetime import datetime, timezone
import numpy as np
import torch
from torch import nn
from torch.nn import functional as F
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt
from matplotlib.patches import Rectangle

def seed_all(seed=7):
    np.random.seed(seed); torch.manual_seed(seed); torch.set_num_threads(2)

def iou_matrix(a,b):
    if len(a)==0 or len(b)==0: return torch.zeros((len(a),len(b)))
    lo=torch.maximum(a[:,None,:2],b[None,:,:2]); hi=torch.minimum(a[:,None,2:],b[None,:,2:])
    inter=(hi-lo).clamp(min=0).prod(-1)
    area_a=(a[:,2:]-a[:,:2]).clamp(min=0).prod(-1)
    area_b=(b[:,2:]-b[:,:2]).clamp(min=0).prod(-1)
    return inter/(area_a[:,None]+area_b[None,:]-inter).clamp(min=1e-8)

def make_scenes(n,seed,size=48,scale=1.0):
    """Independent seed defines original sample, scale changes only object size.
    Boxes xyxy normalized; red rectangle=1, blue ellipse=2; zero to three objects.
    Images are rasterized from latent scene, labels are never a network input.
    """
    rng=np.random.default_rng(seed); xs=[]; ys=[]; masks=[]
    yy,xx=np.mgrid[:size,:size]
    for index in range(n):
        image=rng.uniform(.035,.095,(3,size,size)).astype('float32')
        num=int(rng.choice([0,1,2,3],p=[.18,.30,.36,.16]))
        boxes=[]; labels=[]; mask=np.zeros((size,size),np.int64)
        original=[]
        for obj in range(num):
            for attempt in range(60):
                w,h=rng.integers(9,19,size=2); x=rng.integers(2,size-w-2); y=rng.integers(2,size-h-2)
                box=np.array([x,y,x+w,y+h],np.float32)/size
                if not original or iou_matrix(torch.tensor(np.array(original)),torch.tensor(box[None])).max()<.08: break
            original.append(box); label=int(rng.integers(1,3)); color=rng.uniform(.7,.98)
            cx,cy=(box[0]+box[2])/2,(box[1]+box[3])/2
            sw,sh=(box[2]-box[0])*scale,(box[3]-box[1])*scale
            x1,y1,x2,y2=np.round(np.array([cx-sw/2,cy-sh/2,cx+sw/2,cy+sh/2])*size).astype(int)
            x2=max(x2,x1+2); y2=max(y2,y1+2)
            region=(xx>=x1)&(xx<x2)&(yy>=y1)&(yy<y2)
            if label==2: region &= ((xx+.5-(x1+x2)/2)/((x2-x1)/2))**2+((yy+.5-(y1+y2)/2)/((y2-y1)/2))**2<=1
            image[:,region]*=.2
            image[0 if label==1 else 2,region]=color
            image[1,region]=.15+color*.12
            mask[region]=label
            boxes.append([x1/size,y1/size,x2/size,y2/size]); labels.append(label)
        xs.append(image); masks.append(mask)
        ys.append({'boxes':torch.tensor(boxes,dtype=torch.float32).reshape(-1,4),'labels':torch.tensor(labels,dtype=torch.long),'sample_id':f'{seed}:{index}'})
    return torch.from_numpy(np.stack(xs)),ys,torch.from_numpy(np.stack(masks))

def nms(boxes,scores,threshold=.35):
    order=torch.argsort(scores,descending=True,stable=True); keep=[]
    while len(order):
        i=order[0]; keep.append(i.item()); order=order[1:]
        if len(order): order=order[iou_matrix(boxes[i:i+1],boxes[order])[0]<=threshold]
    return torch.tensor(keep,dtype=torch.long)

def average_precision(predictions,targets,iou_threshold=.5,score_threshold=0):
    """Per-class global score order, max-IoU GT then unused check; all-points AP."""
    result={}; all_tp=all_fp=all_gt=0
    for cls in [1,2]:
        gt={i:t['boxes'][t['labels']==cls] for i,t in enumerate(targets)}
        used={i:set() for i in gt}; total=sum(len(v) for v in gt.values())
        rows=[]
        for i,p in enumerate(predictions):
            for j in range(len(p['scores'])):
                if int(p['labels'][j])==cls and float(p['scores'][j])>=score_threshold:
                    rows.append((float(p['scores'][j]),i,j,p['boxes'][j]))
        rows.sort(key=lambda r:(-r[0],r[1],r[2])); tp=[]; fp=[]
        for score,i,j,b in rows:
            ok=False
            if len(gt[i]):
                overlaps=iou_matrix(b[None],gt[i])[0]; best=int(overlaps.argmax())
                ok=float(overlaps[best])>=iou_threshold and best not in used[i]
                if ok:used[i].add(best)
            tp.append(int(ok));fp.append(int(not ok))
        tp=np.cumsum(tp);fp=np.cumsum(fp)
        recall=tp/max(total,1); precision=tp/np.maximum(tp+fp,1)
        mr=np.r_[0,recall,1];mp=np.r_[0,precision,0]
        mp=np.maximum.accumulate(mp[::-1])[::-1];loc=np.where(mr[1:]!=mr[:-1])[0]
        ap=float(((mr[loc+1]-mr[loc])*mp[loc+1]).sum()) if total else None
        result[str(cls)]={'AP':ap,'GT':total,'TP':int(tp[-1]) if len(tp) else 0,'FP':int(fp[-1]) if len(fp) else 0}
        all_tp+=result[str(cls)]['TP'];all_fp+=result[str(cls)]['FP'];all_gt+=total
    return {'per_class':result,'mAP':float(np.mean([r['AP'] for r in result.values() if r['AP'] is not None])),
            'precision':all_tp/max(all_tp+all_fp,1),'recall':all_tp/max(all_gt,1),'iou_threshold':iou_threshold,'score_threshold':score_threshold}

def provenance(path,started):
    p=Path(path)
    return {'utc_started':started,'utc_completed':datetime.now(timezone.utc).isoformat(),'execution':'CPU, complete script',
            'python':sys.version,'torch':torch.__version__,'numpy':np.__version__,'platform':platform.platform(),'threads':torch.get_num_threads(),
            'code_sha256':hashlib.sha256(p.read_bytes()).hexdigest(),
            'device':'CPU', 'source_file':p.name}

def save_json(path,data):Path(path).write_text(json.dumps(data,indent=2,ensure_ascii=False))

def segmentation_metrics(pred,target):
    valid=target!=255; t=target[valid];p=pred[valid]
    cm=torch.bincount(t*3+p,minlength=9).reshape(3,3).double()
    intersection=cm.diag();union=cm.sum(0)+cm.sum(1)-intersection
    iou=intersection/union.clamp(min=1)
    return {'IoU_background':float(iou[0]),'IoU_red_rectangle':float(iou[1]),'IoU_blue_ellipse':float(iou[2]),
            'mIoU_3_classes':float(iou[union>0].mean()),'pixel_accuracy':float(intersection.sum()/cm.sum()),
            'valid_pixels':int(valid.sum()),'ignored_pixels':int((~valid).sum()),'confusion_matrix_true_rows':cm.int().tolist()}

import argparse
热身作为可回归检查
binary_metrics 分别建立背景、前景的交集与并集,明确平均的类别集合。代码断言最近邻的前景 2/3、背景 5/6、mIoU=.75 和 8 个错误像素。若后续修改插值坐标或阈值,这些测试会直接提醒:你已经改变了原先的实验条件。
为什么同时训练 1×1 读出和 FCN
逐像素读出是 Conv2d(3,3,1),只有 12 个参数:每个像素用共享线性变换和 softmax 分类,没有邻域、形状或对象关系。它是原正文曾承诺而旧代码未实现的可学习逻辑读出。
FCN 有 20,590 个参数。细分支在 48×48 上提取边缘;粗分支两次 stride=2 得到 12×12 特征,再用 1×1 卷积产生三通道 logits。粗 logits 双线性恢复到 48×48,与细分支 logits 相加。细分支保留空间细节,粗分支提供较大邻域;两者通过同一个像素交叉熵一起更新。这个结构借鉴 FCN 的粗细融合思想,并非 D2L 预训练 ResNet-18/转置卷积实现的逐行复制。
损失 对所有有效像素平均。没有任何一项要求不同物体的实例 ID,因此相邻的两个蓝椭圆都应是类别 2;但椭圆间属于背景的窄缝仍必须保留。
展开完整实现代码
%%writefile -a lab11_segmentation.py
def binary_metrics(pred,target):
    ious=[]
    for cls in [0,1]:
        inter=((pred==cls)&(target==cls)).sum().item();union=((pred==cls)|(target==cls)).sum().item()
        ious.append(inter/union)
    return {'background_IoU':ious[0],'foreground_IoU':ious[1],'mIoU_two_classes':sum(ious)/2,
            'pixel_accuracy':float((pred==target).float().mean()),'error_pixels':int((pred!=target).sum())}

def sampling_warmup(out):
    mask=torch.zeros((8,8),dtype=torch.long);mask[2:6,3:7]=1
    coarse=F.avg_pool2d(mask.float()[None,None],2)
    nearest=F.interpolate(coarse,scale_factor=2,mode='nearest')[0,0]>=.5
    bilinear=F.interpolate(coarse,scale_factor=2,mode='bilinear',align_corners=False)[0,0]>=.5
    nm=binary_metrics(nearest,mask);bm=binary_metrics(bilinear,mask)
    assert abs(nm['foreground_IoU']-2/3)<1e-12
    assert abs(nm['background_IoU']-5/6)<1e-12
    assert abs(nm['mIoU_two_classes']-.75)<1e-12 and nm['error_pixels']==8
    # Bilinear interpolates probabilities/logits; categorical labels use nearest.
    fig,axes=plt.subplots(1,4,figsize=(10,3))
    for ax,data,title in zip(axes,[mask,coarse[0,0],nearest,bilinear],['Known mask','2x2 average','Nearest >=0.5','Bilinear >=0.5']):
        ax.imshow(data,cmap='gray',vmin=0,vmax=1,interpolation='nearest');ax.set_title(title);ax.axis('off')
    fig.tight_layout();fig.savefig(out/'sampling-warmup.png',dpi=150);plt.close(fig)
    return {'nearest':nm,'bilinear_align_corners_false':bm,'identity':'known-mask resampling only; no image model'}

class PixelReadout(nn.Module):
    """A learned softmax regression at every RGB pixel; no spatial receptive field."""
    def __init__(self):super().__init__();self.readout=nn.Conv2d(3,3,1)
    def forward(self,x,mode='bilinear'):return self.readout(x)

class SmallFCN(nn.Module):
    def __init__(self):
        super().__init__()
        self.fine=nn.Sequential(nn.Conv2d(3,12,3,padding=1),nn.ReLU(),nn.Conv2d(12,12,3,padding=1),nn.ReLU())
        self.coarse=nn.Sequential(nn.Conv2d(12,24,3,stride=2,padding=1),nn.ReLU(),nn.Conv2d(24,32,3,stride=2,padding=1),nn.ReLU(),nn.Conv2d(32,32,3,padding=1),nn.ReLU())
        self.head=nn.Conv2d(32,3,1);self.skip=nn.Conv2d(12,3,1)
    def forward(self,x,mode='bilinear'):
        fine=self.fine(x);coarse_logits=self.head(self.coarse(fine))
        kw={'align_corners':False} if mode=='bilinear' else {}
        return F.interpolate(coarse_logits,size=x.shape[-2:],mode=mode,**kw)+self.skip(fine)

def with_ignore(masks):
    masks=masks.clone();masks[:,0,:]=255;masks[:,-1,:]=255;masks[:,:,0]=255;masks[:,:,-1]=255
    # A fixed small region represents missing annotation, not another semantic class.
    masks[:,20:23,20:23]=255
    return masks
参数更新和三个单条件比较
像素读出训练 25 epoch、Adam lr=.03;FCN 训练 20 epoch、Adam lr=.003。每个 batch 同时翻转图像与标签、前向得到 logits、计算 CE、清零梯度、反向传播、更新参数。
三个比较均使用同一训练后权重:(1) 只把粗 logits 的 bilinear 换 nearest;(2) 相同潜在场景的对象尺寸乘 .45,其余生成条件保持一致;(3) RGB 做 5×5 均值模糊,几何和 target 不变。前两者分别检查重采样方式和尺度,第三者检查边缘观测变弱。像素读出也参加尺度与模糊对照,避免把一个完美基准遗漏在困难条件之外。
展开完整实现代码
%%writefile -a lab11_segmentation.py
def train_model(model,x,target,epochs,lr):
    opt=torch.optim.Adam(model.parameters(),lr=lr);history=[]
    for epoch in range(epochs):
        model.train();losses=[]
        for ids in torch.randperm(len(x)).split(32):
            images=x[ids];labels=target[ids]
            # One geometric decision applies to both image and mask.
            if torch.rand(())<.5:images=images.flip(-1);labels=labels.flip(-1)
            logits=model(images)
            assert logits.shape==(len(ids),3,48,48) and labels.dtype==torch.long
            loss=F.cross_entropy(logits,labels,ignore_index=255)
            opt.zero_grad();loss.backward();opt.step();losses.append(float(loss.detach()))
        history.append(float(np.mean(losses)))
        if epoch==0 or (epoch+1)%5==0:print(type(model).__name__,epoch+1,history[-1],flush=True)
    return history

@torch.no_grad()
def predict(model,x,mode='bilinear'):
    model.eval();return torch.cat([model(b,mode=mode).argmax(1) for b in x.split(32)])

def plot_predictions(images,truth,pred,path,title,indices=None):
    if indices is None:indices=[0,1,2,3]
    palette=np.array([[.04,.04,.05],[.95,.22,.15],[.10,.45,1],[.55,.55,.55]])
    fig,axes=plt.subplots(len(indices),4,figsize=(10,2.6*len(indices)),squeeze=False)
    for row,i in enumerate(indices):
        mask=truth[i].numpy().copy();mask[mask==255]=3
        error=(pred[i]!=truth[i])&(truth[i]!=255)
        data=[images[i].permute(1,2,0).numpy(),palette[mask],palette[pred[i].numpy()],error.numpy()]
        for ax,d,name in zip(axes[row],data,['Input RGB','Target / gray=ignore','Model prediction','Error on valid pixels']):
            ax.imshow(d,cmap='magma',interpolation='nearest');ax.axis('off');ax.set_title(f'{name} #{i}',fontsize=9)
    fig.suptitle(title);fig.tight_layout();fig.savefig(path,dpi=140);plt.close(fig)
展开完整实现代码
%%writefile -a lab11_segmentation.py
def run(out='lab11-results',epochs=20):
    started=datetime.now(timezone.utc).isoformat();start=time.time();out=Path(out);out.mkdir(exist_ok=True,parents=True);seed_all(19)
    warmup=sampling_warmup(out)
    train,_,raw_train=make_scenes(384,7101);test,_,raw_test=make_scenes(128,7901)
    small,_,raw_small=make_scenes(128,7901,scale=.45)
    target=with_ignore(raw_train);test_target=with_ignore(raw_test);small_target=with_ignore(raw_small)
    readout=PixelReadout();pixel_history=train_model(readout,train,target,epochs=25,lr=.03)
    fcn=SmallFCN();random_pred=predict(fcn,test);history=train_model(fcn,train,target,epochs=epochs,lr=.003)
    pred=predict(fcn,test);nearest_pred=predict(fcn,test,mode='nearest');small_pred=predict(fcn,small)
    # Same image/target, blur changes RGB only, preserving geometry and label.
    blurred=F.avg_pool2d(F.pad(test,(2,2,2,2),mode='reflect'),5,stride=1);blur_pred=predict(fcn,blurred)
    # ignore_index check: arbitrarily changing predictions only at ignored pixels leaves metrics identical.
    altered=pred.clone();altered[test_target==255]=(altered[test_target==255]+1)%3
    assert segmentation_metrics(pred,test_target)==segmentation_metrics(altered,test_target)
    # Synchronized flip can be undone on both image and categorical target.
    assert torch.equal(train.flip(-1).flip(-1),train) and torch.equal(target.flip(-1).flip(-1),target)
    results={'provenance':provenance(__file__,started),'config':{'image_shape':[3,48,48],'logits_shape':['B',3,48,48],'target_shape':['B',48,48],
            'target_dtype':'int64','classes':{'0':'background','1':'red rectangle','2':'blue ellipse'},'ignore_label':255,
            'train_count':384,'heldout_count':128,'split_seeds':[7101,7901],'seed':19,'FCN_epochs':epochs,'readout_epochs':25,
            'loss':'cross_entropy on valid pixels, ignore_index=255','optimizer':'Adam FCN lr=.003; pixel readout lr=.03',
            'FCN_parameters':sum(p.numel() for p in fcn.parameters()),'readout_parameters':sum(p.numel() for p in readout.parameters()),
            'upsampling':'12x12 coarse logits ->48x48 bilinear align_corners=False + fine skip logits','augmentation':'paired horizontal flip',
            'data_identity':'generated scenes with color/shape correlated; heldout original scene seeds; no pretrained weights'},
            'sampling_warmup':warmup,'random_FCN':segmentation_metrics(random_pred,test_target),
            'learned_pixel_readout':segmentation_metrics(predict(readout,test),test_target),'trained_FCN':segmentation_metrics(pred,test_target),
            'condition_nearest_logits':segmentation_metrics(nearest_pred,test_target),'condition_scale_045':segmentation_metrics(small_pred,small_target),
            'condition_RGB_blur5':segmentation_metrics(blur_pred,test_target),'readout_RGB_blur5':segmentation_metrics(predict(readout,blurred),test_target),'readout_scale_045':segmentation_metrics(predict(readout,small),small_target),'history_FCN':history,'history_pixel_readout':pixel_history,
            'ignore_metric_invariance_test':'passed','paired_flip_involution_test':'passed','sampling_known_values_tests':'passed','seconds':time.time()-start}
    counts=((pred!=test_target)&(test_target!=255)).flatten(1).sum(1);worst=counts.argsort(descending=True)[:4].tolist()
    results['failure_examples']=[{'sample_index':i,'wrong_valid_pixels':int(counts[i])} for i in worst]
    torch.save({'state_dict':fcn.state_dict(),'config':results['config']},out/'fcn.pt');torch.save(readout.state_dict(),out/'pixel-readout.pt')
    np.savez_compressed(out/'heldout-input-target-predictions.npz',images=test.numpy(),target=test_target.numpy(),prediction=pred.numpy(),
                       half_scale_images=small.numpy(),half_scale_target=small_target.numpy(),half_scale_prediction=small_pred.numpy(),blur_images=blurred.numpy(),blur_prediction=blur_pred.numpy())
    plot_predictions(test,test_target,pred,out/'heldout-segmentation.png','FCN heldout image-to-mask predictions')
    plot_predictions(test,test_target,pred,out/'failure-segmentation.png','Four largest valid-pixel error counts',worst)
    plot_predictions(small,small_target,small_pred,out/'small-object-segmentation.png','Same latent scenes: object dimensions x0.45')
    plot_predictions(blurred,test_target,blur_pred,out/'blur-segmentation.png','Same geometry, RGB blurred with 5x5 average')
    fig,ax=plt.subplots(figsize=(7,4));ax.plot(history,label='FCN');ax.plot(pixel_history,label='pixel softmax readout');ax.set(xlabel='epoch (zero based)',ylabel='valid-pixel CE');ax.legend();fig.tight_layout();fig.savefig(out/'training-curve.png',dpi=150);plt.close(fig)
    save_json(out/'run.json',results);print(json.dumps({k:results[k]['mIoU_3_classes'] for k in ['random_FCN','learned_pixel_readout','trained_FCN','condition_scale_045','condition_RGB_blur5']},indent=2),flush=True)
    return results

if __name__=='__main__':
    p=argparse.ArgumentParser();p.add_argument('--out',default='lab11-results');p.add_argument('--epochs',type=int,default=20);a=p.parse_args();run(a.out,a.epochs)
运行:模型输出必须和输入、真值一起看
下格在新 Python 进程完整运行。每张结果图按“RGB / target / prediction / 有效像素错误”排列,target 中灰色是 ignore,不是模型应该学出的类别。脚本还检查:任意修改 ignore 区预测不改变指标;同步翻转两次恢复输入和标签。
展开完整实现代码
import subprocess,sys,json
subprocess.run([sys.executable,'lab11_segmentation.py','--out','lab11-results-rerun','--epochs','20'],check=True)
R=json.loads(Path('lab11-results-rerun/run.json').read_text())
print('sampling:',R['sampling_warmup'])
for key in ['random_FCN','learned_pixel_readout','trained_FCN','condition_nearest_logits','condition_scale_045','condition_RGB_blur5','readout_RGB_blur5']:
    r=R[key];print(key,{k:round(v,5) for k,v in r.items() if 'IoU' in k or k=='pixel_accuracy'})
print(R['provenance'])
from IPython.display import Image,display
for filename in ['sampling-warmup.png','heldout-segmentation.png','failure-segmentation.png','small-object-segmentation.png','blur-segmentation.png']:
display(Image(filename='lab11-results-rerun/'+filename))已完成结果:复杂模型没有被安排成赢家
本地 CPU 完整运行开始于 2026-09-22T16:28:24.497499+00:00,PyTorch 2.14.0+cpu;源码 SHA-256 为 ecbe38c4a53eb691b7e31be95eaa8ab3a0b93578005d2605072196cc5dc66445。FCN 训练 CE 从 .85632 降到 .00492。下面 mIoU 均对背景、红矩形、蓝椭圆三个类别等权平均;先在整份保留集累计混淆矩阵,再计算逐类 IoU,未对每张图的 IoU 简单平均。
| 模型 / 输入条件 | 三类 mIoU | 结论能说到哪里 |
|---|---|---|
| 随机初始化 FCN | .01470 | 尚未学到类别读出 |
| 训练后 1×1 RGB 读出 | 1.00000 | 本合成集每个像素颜色已足以分类 |
| 训练后 FCN,双线性 | .99041 | 学到图像到 mask,边界仍有少量错 |
| 同 FCN,最近邻 logits | .91180 | 改变上采样坐标权重影响空间决策 |
| 同 FCN,对象尺寸 ×.45 | .94396 | 细小蓝对象和窄缝更难保持 |
| 同 FCN,RGB 5×5 模糊 | .92397 | 边缘观测变弱时性能下降 |
| 同 RGB 读出,5×5 模糊 | .84996 | 无邻域基准受混合颜色更大影响 |
像素读出比 FCN 的原分布结果更好,是有意义的负结果:更复杂结构不是得分保证,数据又带有强颜色线索。在尺寸 ×.45 条件下读出仍为 1.0,说明纯颜色规则不会因为面积变小而失效;在模糊条件下,邻域 FCN 才表现出比单像素读出更强的耐受。这不能直接推广到真实语义分割,真实同类物体的颜色并不恒定。
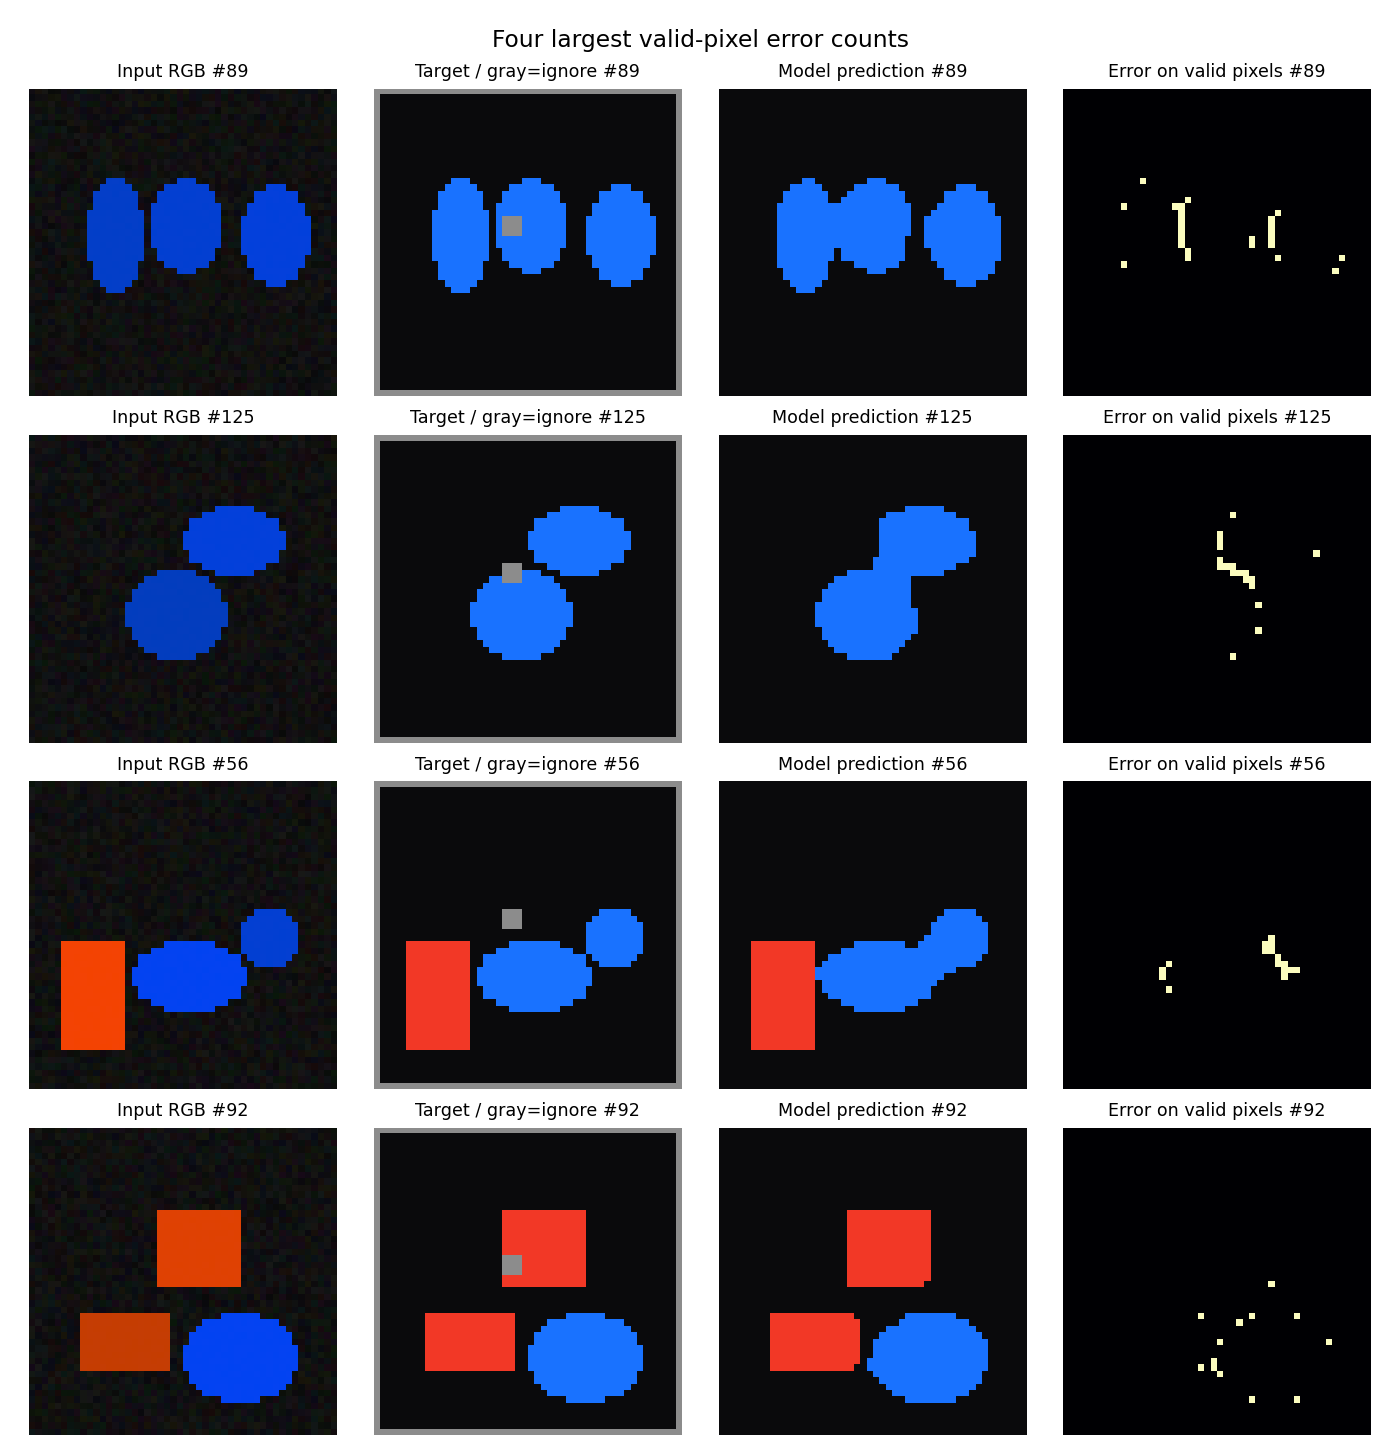
错误最多的图 89 有 25 个有效像素错,图 125 有 18 个,图 56 有 16 个,图 92 有 13 个。图 89/125 的两个蓝椭圆间出现背景窄缝被填平的错误:mask 所需的边界证据可能在低分辨率表示中混合,即使细分支能改善,也不保证完全恢复。此处蓝色连通不等于实例计数正确,本册没有训练实例分割。
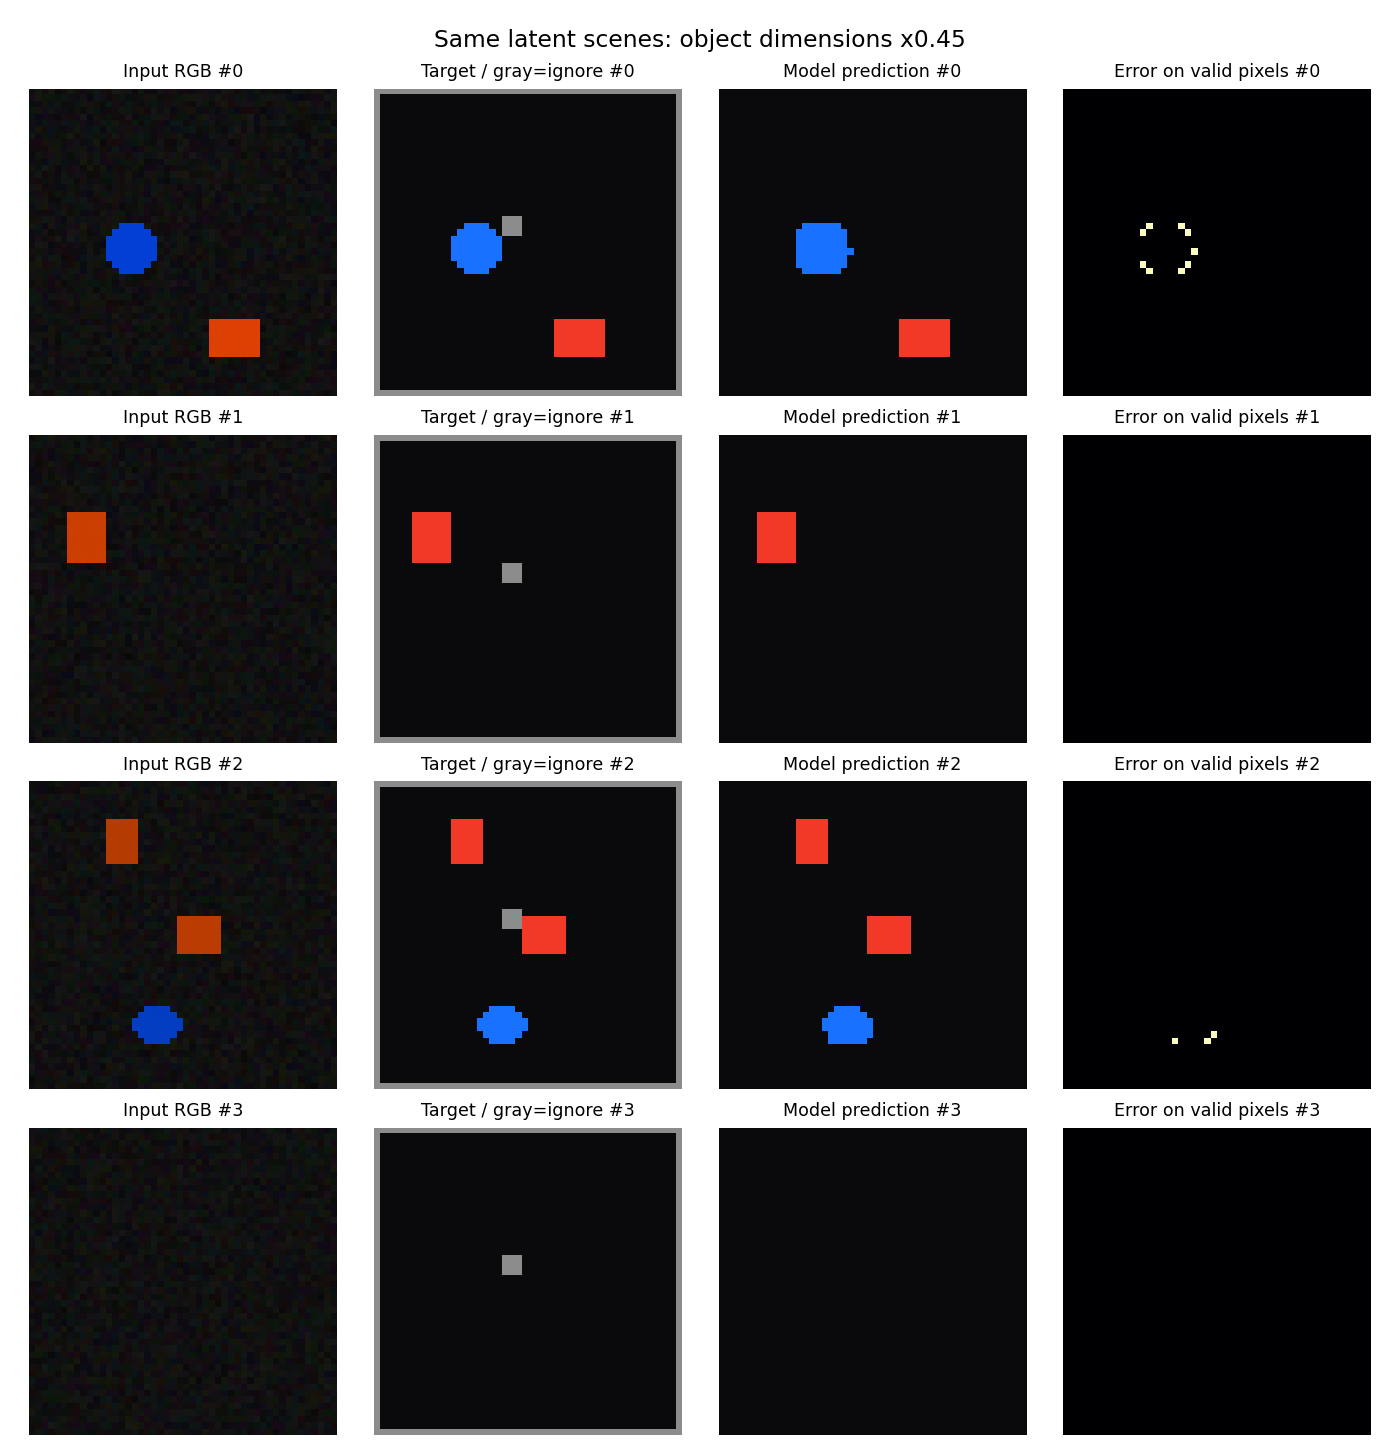
尺寸 ×.45 后像素准确率仍有 .99816,但蓝椭圆 IoU 只有 .85763,红矩形 .97613,背景 .99812。小对象在整图像素数中占比太低,仅报告准确率会掩盖其损失。最近邻对照的蓝类 IoU 进一步降到 .80928,而背景 .98558,展示了不同类别边界受采样影响不同。
下一次只把训练增强加入模糊,保持场景、epoch 和网络不变,再看“干净图/模糊图”两列是否同时改善。若想检验颜色捷径,应重新定义颜色与类别的生成关系并同时调整训练与测试协议;不能把标签含义改变的分布转移误说成边界采样问题。
来源与结构输出的连接
2026-09-22 实时核验 D2L §14.11 Fully Convolutional Networks,采用全卷积逐像素读出、上采样和双线性坐标的解释;本实现使用可学习粗/细分支加双线性插值,没有预训练骨干,也没有宣称复现其 VOC 实验。ignore、三类混淆矩阵、两个颜色场景和条件对照是本课程的独立教学构造。
LAB10 中检测框正确只说明包围区域满足评价阈值。LAB11 中椭圆边缘、相邻对象间的背景缝、未标注像素仍是不同问题:输出粒度决定什么算错误,采样与任务头决定哪些空间信息能留下。返回网页的空间主线时,可以用本册三张同源输入/目标/错误图说明这一步转折,而不只说“语义分割更精细”。