Lecture 03 学习讲义
正文
工具
按问题查找
视觉与语言语言怎样选择当前需要的视觉信息?

同图换问,再同问换图

解释、算例与证据

P54 · VQA:问题决定此刻需要哪一项信息

问题在这里选择要读的信息,同一图可以问数量、属性和关系。本页说明沿两个方向组织检查:同图换问、同问换图。LAB14 当前已经有读取像素的可学习分支和单独训练的 question-only,对象属性字典保留为 oracle 热身;三种身份应分别阅读。

不给图片有几个人?需依据图像确定谁拿着球?需依据图像确定球是什么颜色?需依据图像确定同一问题,换掉相关图像,正确答案应怎样改变?答案为人工核对的场景属性;“不给图片”展示评价条件,不是模型问答实验。

相同人物图像对应数量、持球者、球色三问;另一状态隐藏图片并将答案改为需依据图像确定。

  • 不给图片
  • 有几个人?
  • 需依据图像确定
  • 谁拿着球?
  • 需依据图像确定
  • 球是什么颜色?
  • 需依据图像确定
  • 同一问题,换掉相关图像,正确答案应怎样改变?
  • 答案为人工核对的场景属性;“不给图片”展示评价条件,不是模型问答实验。
相同人物图像对应数量、持球者、球色三问;另一状态隐藏图片并将答案改为需依据图像确定。 查看对应图解状态
查看完整图解

课堂讲述

同一张图可以支持很多问题。问数量、颜色或者持有关系,需要从相同画面中提取不同信息。VQA 把问题本身变成输入的一部分,让任务不再只有“描述一遍”。 训练时需要图像、问题和答案。早期系统可以从有限答案集合中选择,后来的模型也可以生成答案;两种接口不同,但都要检查回答是否真正利用了图像。 有些问题可以靠常见答案猜对。例如某种训练分布里,某个问法总对应同一种颜色。为了区别猜测和视觉利用,可以保持问题不变、替换相关图像,再看答案是否合理改变。我们先看清成功应该意味着什么,而不是只看一次回答听起来像不像人。

VQA:同图换问题,同问换图

独立阅读

VQA 的目标是 p(a∣I,q)p(a\mid I,q)。问题 qq 不只是输出旁的装饰,而是决定应该从图像中读取什么:问“有几个人”需要数量,问“谁拿球”需要关系,问“球是什么颜色”需要属性。保持图像固定,改变问题,正确答案就可能改变;保持问题固定,改变相关图像,正确答案也应变化。

一个封闭答案模型可以在预设词表里分类,一个生成式模型可以逐词回答。前者易于定义准确率,但答案范围受词表限制;后者表达更灵活,却需要处理同义表达、冗长回答和证据对应。不能只把分类头输出的一个标签换成长句,就称为具有新的视觉推理能力。

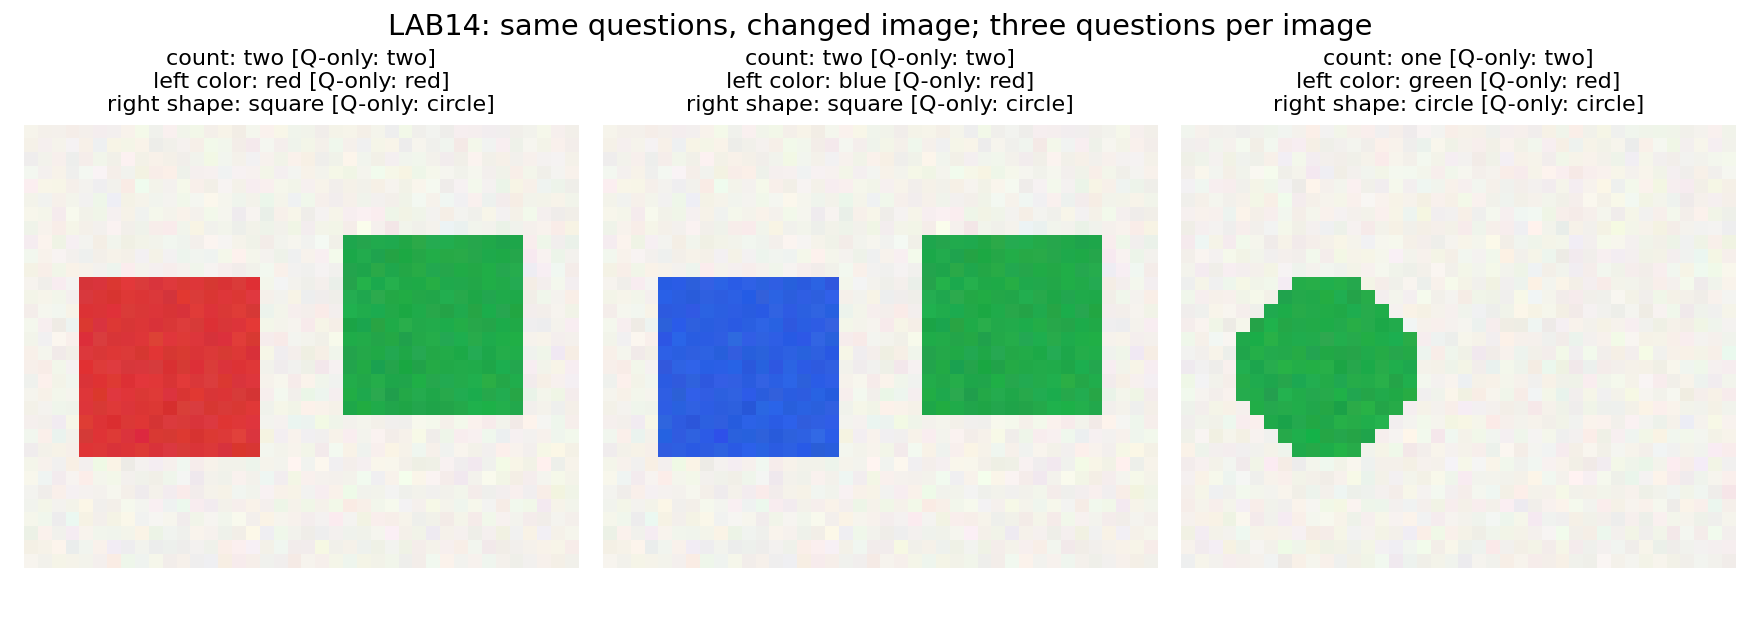
语言先验是有用的知识,也可能成为捷径。如果训练里“左边物体什么颜色”通常答红色,question-only 模型能取得不错成绩,却无法应对同问题下的蓝物体。VQA v2 的研究用相同问题、不同正确答案的成对图像,加强视觉证据在评价中的作用。这种设计把“答对”进一步变成“答对所需的信息确实来自图像”。

课堂上可先固定图 A 左红右蓝:问左颜色答红,问右颜色答蓝。再换成左蓝右红的图 B,保持左颜色问题,此时应答蓝。三次比较让图像条件和问题条件分别显示作用。读取场景字典中的 left_color 是已知属性 oracle,它能检验问答逻辑,但不能检验从像素感知颜色。
图示条件与公式约定

图示答案是人工核对的场景属性:2 人、红衣人持球、橙色篮球。无图状态不展示模型猜测,没有执行新 VQA 实验。

这条线索的展开与后续阅读

视觉与语言语言怎样选择当前需要的视觉信息?

先算结构化基线,再读像素问答结果

一次无图答对不足以判断图像有没有作用;先根据三个任务计算可比较的基线。

已保存的像素 VQA:为什么 44.44% 是结构化基线

独立阅读

LAB14 在 2026-09-22 保存了本地 CPU 学习结果,本次整理没有重跑。720 张训练图和 180 张保留图先按图像生成和划分,再对每图提出三种固定模板问题,共 2160/540 个图问对。模型实际读取 RGB 像素和问题 ID,不读取生成器属性字典。

保留任务分别是数量二选一、左侧颜色三选一、右侧形状二选一。只知道问题时,各任务的最佳常量正确率为 1/2,1/3,1/21/2,1/3,1/2,平均 (1/2+1/3+1/2)/3=4/9(1/2+1/3+1/2)/3=4/9。把所有七种答案混在一起写“机会率 1/7”会忽略问题已给出的答案类型。

保留条件 数量 左色 右形 全部
图像+问题 100% 100% 100% 100%
单独训练 question-only 50% 33.33% 50% 44.44%
同一视觉模型,像素置零 50% 33.33% 50% 44.44%
同一视觉模型,循环错配图像 83.33% 50% 0% 44.44%

最后一行不是随机机会率:数据按组合排列,循环移位常保留数量却恰好改变形状,因此总分相同仍有不同错误来源。正确图像下的模型通过了三个有限任务;像素置零和错配的下降支持它使用正确视觉输入。训练左侧红色比例为 73.61%,保留颜色均衡,进一步显示问题先验不能替代视觉读取。

同图换问、同问换图

问题输入在这里是三个模板 ID,不是任意句子的语言理解。先承认这个小实验确实完成的像素问答,再把开放问题、未见对象与组合列为下一层检验。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:问题模型也能答对 44%,说明图像不重要吗?

教师:先看任务结构:二选一、三选一、二选一的常量基线平均就是 4/9。视觉模型在相同保留图问对达到 100%,且错配后下降,才说明这里增加的图像条件有作用。

沿这个问题继续

先回看本页画面并指出输入、条件和输出,再按“VQA:同图换问题,同问换图 → 已保存的像素 VQA:为什么 44.44% 是结构化基线”阅读。相关实验以其已保存结果为起点,需要动手时再顺序执行 Notebook;

出处:VQA(2015)