CLS 08 · 密集预测、实例与集合输出
按问题继续
像素损失、IoU口径、粗细表示、实例身份与集合输出
对应课堂(11 页)
可先阅读已有结果,再决定是否运行。重算时请核对各节记录的数据、参数、环境与日期。
学习路径: 像素、边界与对象身份
本册承接 P36 的逐像素任务,解释 LAB 11 为什么需要新的目标、损失和评价。先读 logits/目标/ignore,再用 8×8 算例区分前景 IoU、两类 mIoU 和像素准确率;最后看语义类别为何不能唯一给出实例身份。
希望先看结果,可读 RGB 读出与 FCN 的对照;希望核一个指标,可引用 0.667 与 0.75 的完整算例。读完应能解释“框对了但边界仍错”和“所有杯子像素对了但实例仍未分开”这两个缺口。
坐标采样的动手入口是 LAB 03;多尺度和集合匹配留在本册后部选读。它们不要求在理解像素预测前先完成。
一个框可以同时包住杯身、杯把和杯把中的背景。框坐标全对,仍不代表我们知道每个像素属于谁。若两只杯子接触,语义分割可以把它们都标成“杯子”,但要分别计数和操作,就还需区分实例身份。这里不是同一个答案换显示颜色,而是输出空间和监督单位发生了变化。
一张类别图怎样成为可训练的输出
语义分割的输出通常为 ,其中 是 batch, 是类别数, 是空间大小。目标 是整数类别图。对每个有效像素做 softmax 交叉熵,再按有效像素数平均:
排除 ignore label,例如未标注区域。ignore 不应变成一个额外背景类,也不进入评价混淆矩阵。二类任务可以用一个 foreground logit 加 sigmoid/BCE,也可以用两个 logits 加 softmax;张量形状和损失接口必须与这种选择一致。
FCN 用卷积保持空间网格并输出位置相关分数,再把较粗分辨率恢复到目标大小。U-Net 的编码—解码结构把深层上下文与浅层高分辨率特征通过跳连结合;这种连接提供额外可用信息,而不仅是把同一张粗图放大。D2L §14.11 FCN · U-Net 原论文。图像和 mask 的裁剪、翻转、缩放必须使用同一几何变换,否则网络被要求把一个位置的像素对应到另一个位置的标签。
上采样能增加格子,不能单凭格子恢复被删掉的区别
最近邻复制相邻值;双线性插值对邻域数值加权。给二维网格
在横坐标 、纵坐标 处,四点权重为 ,插值得到 12.5。它精确说明怎样从已有数值取连续位置,不能保证 12.5 就是原始图像那一点的真实内容。
如果两个 图案“左半亮”和“右半亮”都被平均成 0.5,任何只拿这个平均值的确定性解码器都必须给二者相同输出。增加一个“左减右”通道后才可以区分。这是 LAB 03 的表示碰撞例;它解释为什么需要保留空间信息,而非只提高显示分辨率。
类别 mask 本身是离散 ID,通常用最近邻几何采样。对类别编号 1 和 3 做双线性插值,得到 2 并不意味着中间真的存在第 2 类。模型的连续 logits 或概率图则可以按适当约定插值,再 argmax/阈值。插值坐标约定也要固定,例如是否对齐端点;同样叫 bilinear 的两个设置可能在边界位置不同。
一个 8×8 反例怎样澄清四种指标
设真值前景有 16 像素,从真值 mask 平均降采样再最近邻恢复并阈值化后,预测前景有 24 像素,其中真阳性 16、假阳性 8、假阴性 0、真阴性 40。这是采样机制例,预测过程直接使用了真值 mask,不能当作看图模型的能力证据。
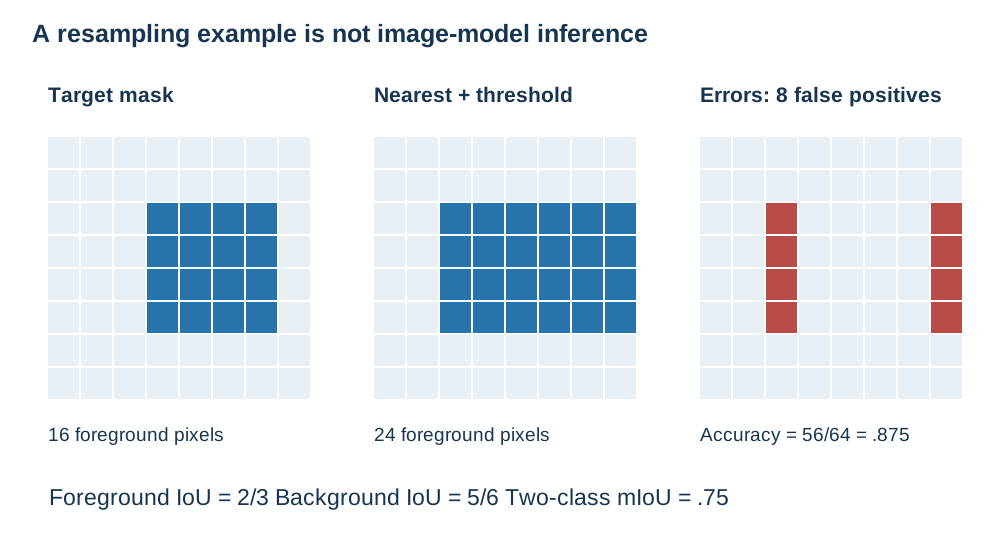
三张网格由同一组 8×8 数组绘制。目标矩形为行 2–5、列 3–6(从 0 计数);阈值化最近邻恢复多出了 8 个前景像素。
| 指标 | 计算 | 本例结果 |
|---|---|---|
| 前景 IoU | ||
| 背景 IoU | ||
| 两类 mIoU,含背景 | 0.75 | |
| 像素准确率 | 0.875 |
“mIoU=0.667”在这个例子里错在名称:0.667 是单类前景 IoU。若报告不含背景的类均值,应写清类别集合;若某类真值和预测都为空,要说明是忽略该类还是采用约定值。背景占比很高时,全预测背景也可能有高像素准确率,所以要看逐类混淆和边界错误,而不只看一个总数。
真正视觉模型必须从图像推断 mask。LAB 11 先保留上述采样例及最近邻/双线性比较,再进入小型像素模型。两段实验分别检验采样损失和学习能力,结论不互相替代。
主实验在 2026-09-22 本地 CPU 完成训练,384 张训练图、128 张保留图,输入 48×48 RGB。三类为背景、红矩形、蓝椭圆,目标形状为 [B,48,48],logits 为 [B,3,48,48],ignore label 255 在损失与指标中均被排除。20,590 参数的小型 FCN 将 12×12 粗 logits 双线性上采样并融合精细跳连,训练 20 epoch;另训练只有 12 个参数的逐像素 RGB 线性读出作基线。
| 保留图像条件 | 小型 FCN 三类 mIoU | RGB 逐像素线性读出 mIoU |
|---|---|---|
| 原始合成图 | 0.99041 | 1.00000 |
| 对象尺度变为 0.45 倍 | 0.94396 | 1.00000 |
| RGB 图作 5×5 模糊 | 0.92397 | 0.84996 |
RGB 基线满分说明原数据颜色已直接泄露类别,不能据 FCN 高分宣称它学会了复杂形状或需要深层上下文。模糊后边缘颜色混合,FCN 在这个干预下更稳健;这才是当前对照支持的具体比较。原始条件下 FCN 的逐类 IoU 为背景 0.99861、矩形 0.99833、椭圆 0.97429,较细曲线边界更难。
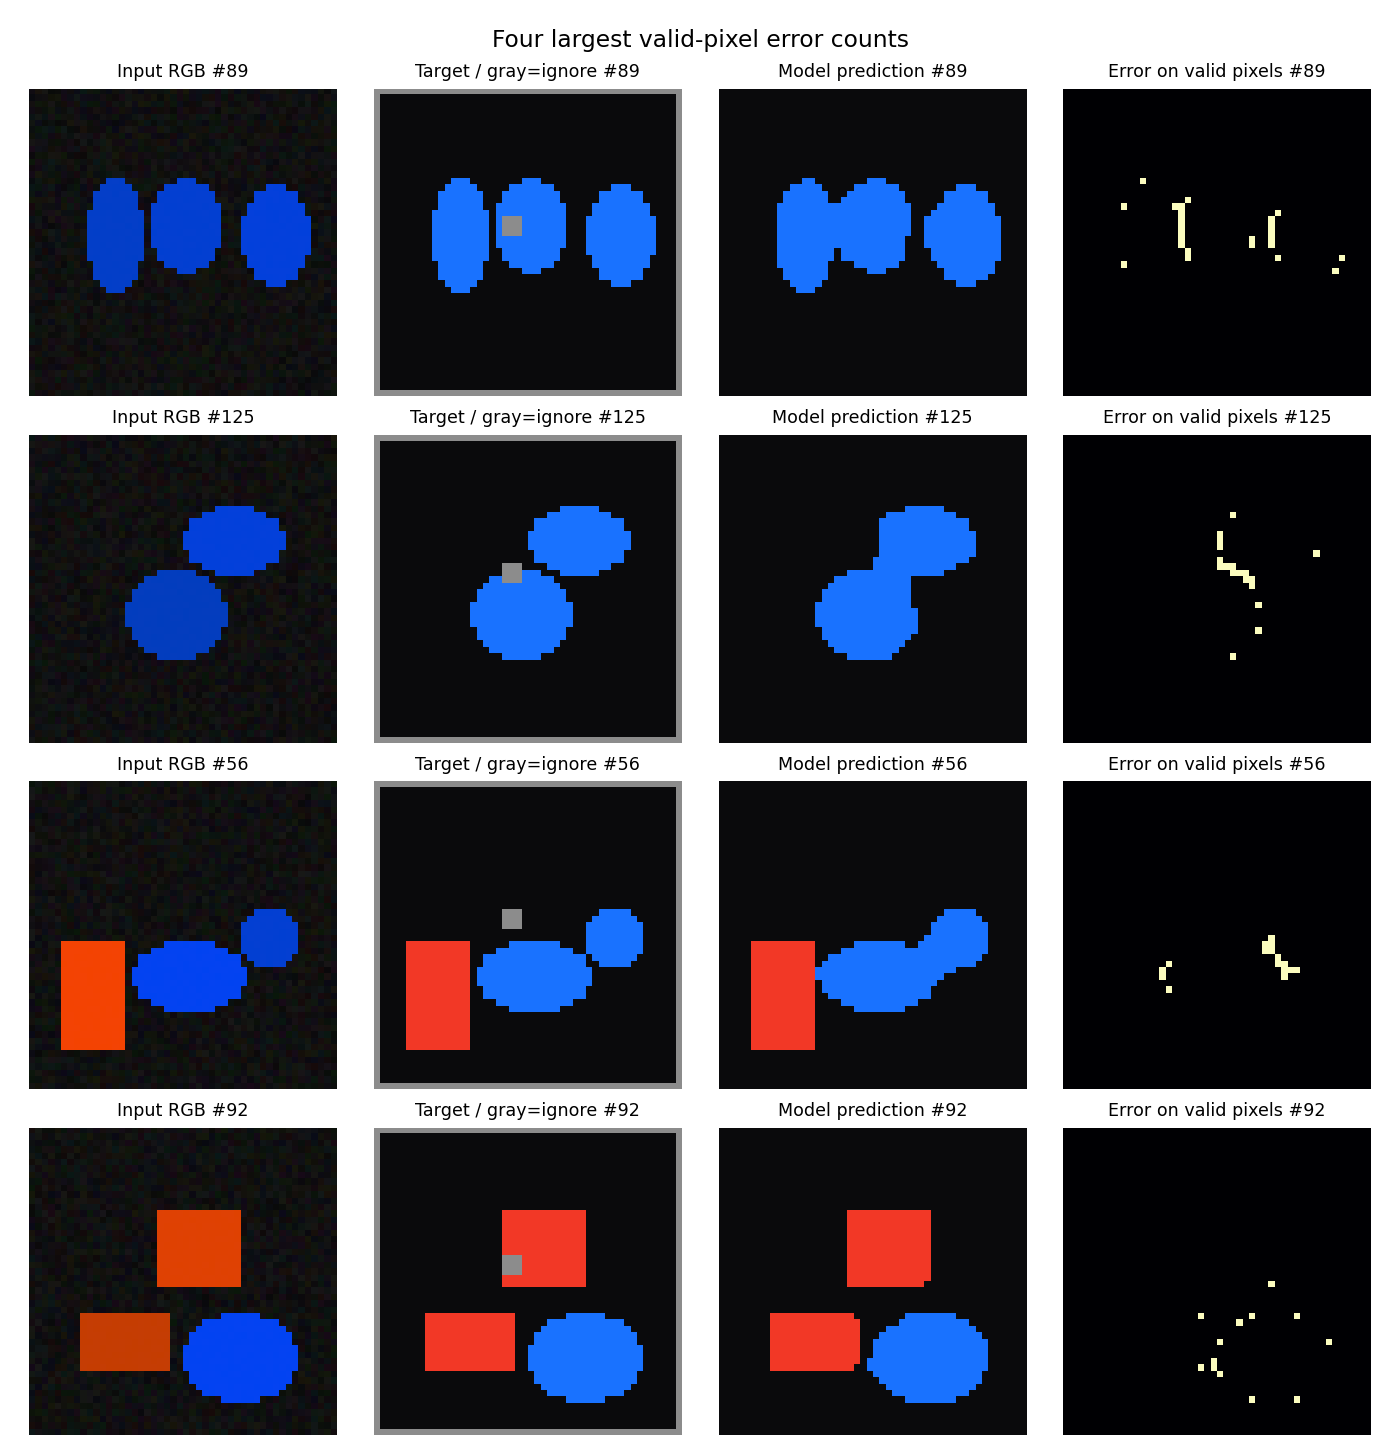
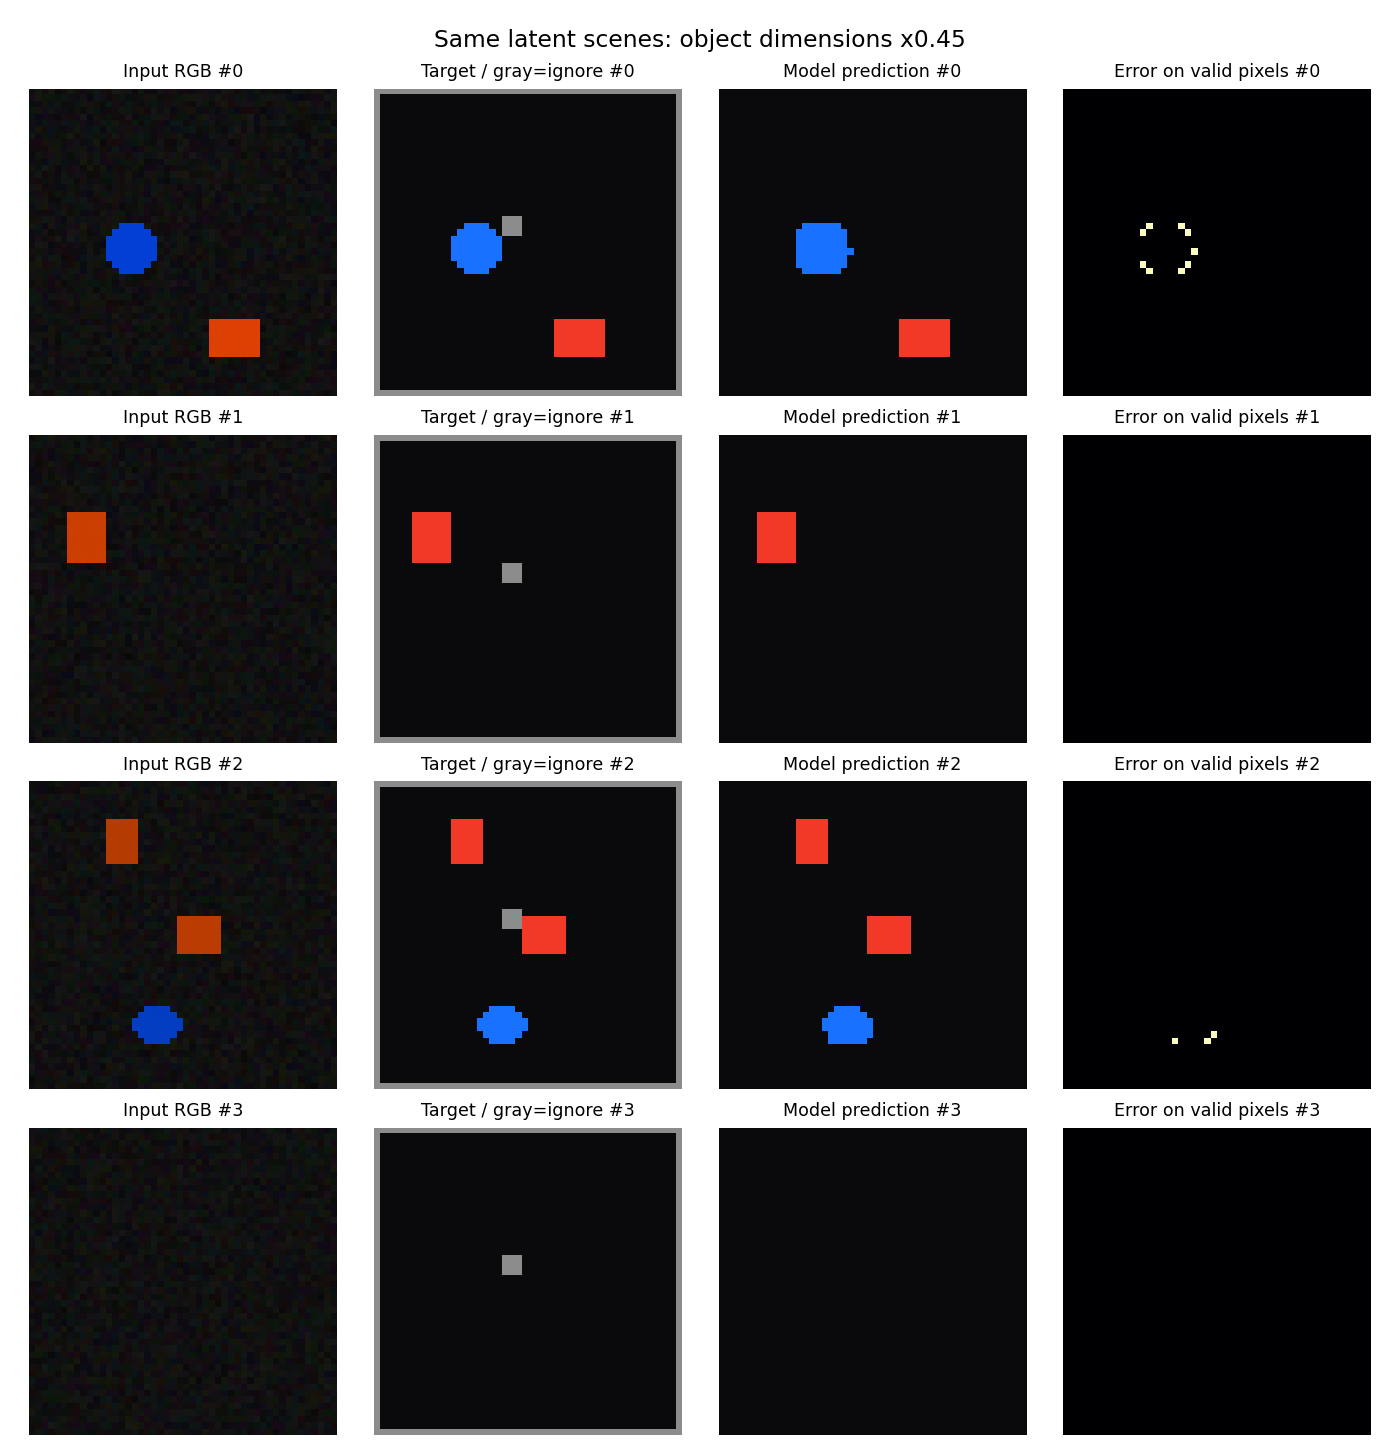
保持已训练参数,测试时仅把粗 logits 的双线性插值改为最近邻,mIoU 降到 0.91180。这说明当前网络对训练时的采样约定敏感,不能把它读作“最近邻永远更差”,因为网络没有在两种上采样设置下分别重训。前面的已知 mask 热身中,双线性分支前景 IoU 仍为 2/3,背景 IoU 为 0.88462、两类 mIoU 为 0.77564;指标差异与模型泛化仍须分开。
从类别像素走向逐个对象
把像素标为杯子类别,只声明“这里属于杯子集合”。实例标注还声明“这里属于杯一,那里属于杯二”。两只杯子即使同色、接触甚至相互遮挡,实例任务仍需给出两份对象身份。
考虑一行标签 [1,1,2,2],其中 1、2 是两只杯子的实例号。将它们都映射到类别杯子=1,就得到 [1,1,1,1]。另一个实例划分 [1,2,2,2] 经同样映射也得到同一类别行。因此类别图不能唯一反推出实例边界。
连通域可以在“每个对象互不接触”的特定条件下帮忙计数,但一旦两只杯子相接,一个连通块可含两个对象;反过来同一被遮挡的对象还可能产生不连通的可见部分。对象身份不是连通性规则自动保证的属性。
区域路线给每个候选一份身份,像素路线给精细轮廓。把它们结合,就可以在“这个候选对象”之内预测局部 mask。这是进入 Mask R-CNN 的具体需求,而不是为了再增加一种模型名称。
选读:不同尺度与无序集合,分别改变哪一部分?
把“有跳连”当成一个共同名字,容易遮住任务差异。FCN 的跳接把较细层的空间线索与粗语义预测结合,服务于逐像素输出;U-Net 的编码—解码路径将高分辨率特征接到相应解码层;FPN 自顶向下融合与横向连接,形成可供不同尺度对象使用的特征层级。
| 观察点 | 应在计算图里找什么 |
|---|---|
| 较细信息从哪里来 | 原图或编码器哪个中间层,而非只看上采样箭头 |
| 怎么对齐 | 两条支路的步长、尺寸、坐标约定 |
| 怎样组合 | 相加或拼接,组合后是否再有可学习预测 |
| 服务哪个目标 | 单张类别图、多尺度框、局部实例 mask |
如果原图中 4×4 像素的目标进入 stride16 网格,其连续跨度只有 1/4×1/4 格;这使位置读取困难,但不能仅据小于一格断言信息必全丢,通道仍可能记录响应。更细输入或跨层特征带来新的观测机会,是否改善要在指定任务上检查。
保留这份比较,是为学生读到结构名时有判断坐标;本轮主讲不再把它拆为几个平行论文段落。
大量背景参考框已经很容易分类,却可能因数量占优而贡献大量总损失。focal loss 在基本交叉熵外乘 。取 γ=2,正确类概率 .9 的样本权重 .01,概率 .5 的权重 .25,后者相对贡献更大。这是在调整哪些样本值得继续关注,不直接增加空间信息,也不指定哪项预测负责哪只对象。
对象匹配回答另一件事:当真值是一组无序对象,预测槽位该怎样对应它们?给两预测、两真值的代价矩阵 [[2,.3],[.4,2]],对角总代价 4,交叉 .7,所以选择交叉。交换标注数组顺序不该改变对象集合本身,匹配用于消除这个任意顺序。
LAB 20 从类别概率、框 L1 与 IoU 实际构造成本,再穷举 2! 分配;它是足够透明的解析练习。这里没有图像编码器学习,也不是完整 DETR。主讲保留对象身份的必要性,这些损失组织细节进入选读即可,不必为保持课程丰富而重新开一章。
LAB 20 尺度与集合短算例 保留实际成本构造;不需要为了理解像素目标先学完 DETR。完整注意力结构留在第五讲,不在这里展开。
对齐的正面实证
Mask R-CNN v3 的 Table 2 使用 COCO trainval35k 训练、minival 测试;表中未另说明时报告 mask AP。以下固定 ResNet-50-C4、stride 16,并选同为 max 聚合的行:
| 区域读取 | 是否保留对齐 | 是否双线性 | mask AP | mask AP75 |
|---|---|---|---|---|
| RoIPool | 否 | 否 | 26.9 | 26.4 |
| RoIWarp | 否 | 是 | 27.2 | 27.1 |
| RoIAlign | 是 | 是 | 30.2 | 31.8 |
RoIAlign 相比 RoIPool 的 AP 增加 3.3 点,AP75 增加 5.4 点。RoIWarp 也插值却没有同样改善,支持“保持坐标对应”这一机制判断。平均聚合的 RoIAlign 行是 AP30.3/AP75 31.5,引用时不能把不同聚合行混在一个对照里。Table 2(d) 换成 C5、stride32,mask AP 从 23.6 到 30.9;这是另一组设置。
这些是训练完整模型的论文结果,不是本课程重跑。它们说明读取位置值得修复,尤其严格定位受益;P44 则把输入 F 固定成完全相同,讨论任何确定性读出都无法创造差别。方法有效与构造例中的信息限制,可以同时成立。