LAB 13 · 看图生成一句话:训练、解码与消融
按问题继续
真实CNN–GRU条件训练与greedy/beam生成、遮图/错图消融
对应课堂(2 页)
可先阅读已有结果,再决定是否运行。重算时请核对各节记录的数据、参数、环境与日期。
学习路径: 图像怎样约束句子与回答
本册确实用RGB图像训练CNN+GRU并接续自身输出。2026-09-22本地基准保存了正确图、像素置零和循环错图的结果;18种语义组合在训练/保留两侧都出现,检验的是新渲染样本,不是未见组合或自然照片泛化。结果和完整协议。
读完应能拿一组图片与生成句子说明视觉是否影响输出,以及为何teacher-forced交叉熵不能替代生成评价。动手复现时按原代码顺序执行;GRU内部与beam搜索可留后续课,不影响先理解图像条件。另一个输出接口见LAB 14 问答。
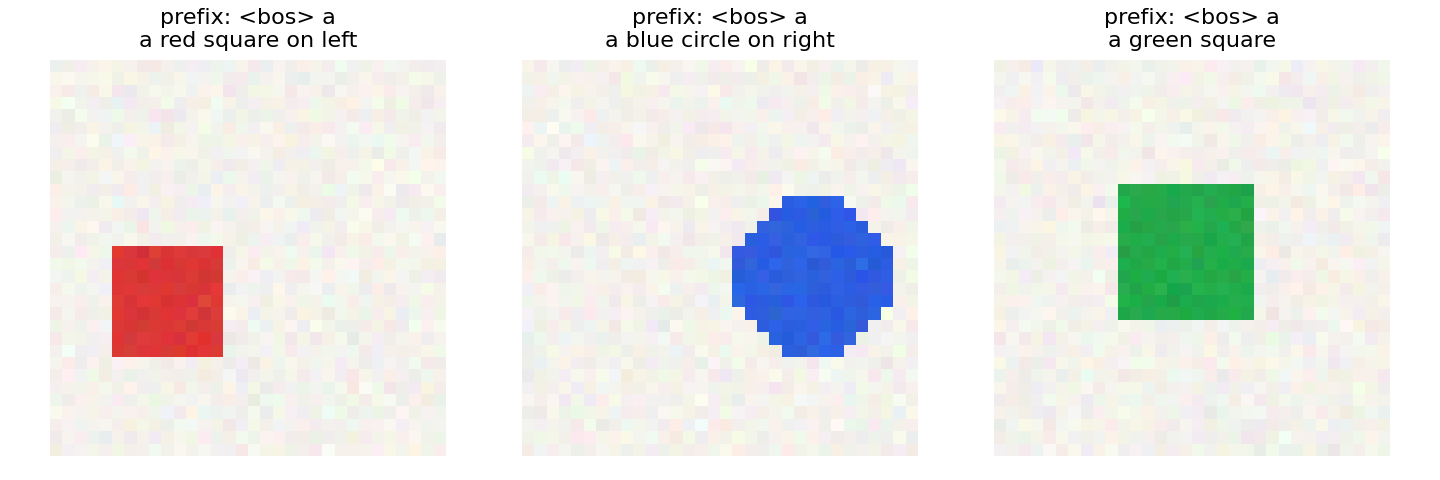
图中句子由已训练模型生成。下一项问题是“同图换问会怎样”,进入 LAB 14 · 图像问答:视觉条件与问题先验。
先拆开两个容易混淆的问题
训练的目标是 ,不是同时猜出整句。teacher forcing 提供真实前缀,所以输入 [BOS,a,red,square] 对齐目标 [a,red,square,EOS]。PAD 只用来把批量补成矩形,不是下一词答案;EOS 则是真正需要学习的结束事件。下面保留原有两条整数序列,直接打印 input、target 与 mask。
原概率树只写了 A→X 的 0.45,却把 AX 称为 greedy,没有交代另外 0.55 分给谁。现在补齐每层归一化的树:根的 A/B 为 0.55/0.45;A 的 X/Z 为 0.45/0.55;B 的 Y/Z 为 0.8/0.2。实际执行 greedy 得到 AZ,概率 0.3025;宽度 2 的 beam 得到 BY,概率 0.36。它解释局部最大不保证全句最大;并不证明 beam 在真实模型上一定改善内容正确性。
展开完整实现代码
# Detached readonly runs write only to an isolated ephemeral directory.
import os, tempfile
_LAB_WORKDIR = tempfile.mkdtemp(prefix="lecture03-lab13-")
os.chdir(_LAB_WORKDIR)
print("ephemeral workdir:", _LAB_WORKDIR)

seqs=[[1,4,5,2],[1,6,2,0]]
print('warm-up input',[s[:-1] for s in seqs])
print('warm-up target',[s[1:] for s in seqs])
print('warm-up loss mask',[[int(t!=0) for t in s[1:]] for s in seqs])
# Every outgoing distribution sums to one. Both paths terminate after two tokens.
tree={():{'A':.55,'B':.45},('A',):{'X':.45,'Z':.55},('B',):{'Y':.80,'Z':.20}}
assert all(abs(sum(p.values())-1)<1e-9 for p in tree.values())
greedy_path=();greedy_probability=1.
for _ in range(2):
    token=max(tree[greedy_path],key=tree[greedy_path].get)
    greedy_probability*=tree[greedy_path][token];greedy_path+= (token,)
beams=[((),1.)]
for _ in range(2):
    beams=sorted([(seq+(word,),p*conditional) for seq,p in beams for word,conditional in tree[seq].items()],key=lambda b:b[1],reverse=True)[:2]
print('actual tree greedy:',greedy_path,greedy_probability,'beam2:',beams[0])1. 准备一个可以完整跑完的学习问题
依赖 Python、NumPy、Pillow、Matplotlib、PyTorch;CPU 即可。缺包时在环境安装 numpy pillow matplotlib torch,随后 Restart & Run All。下面各格按顺序独立初始化数据与权重,不读另一册的变量,输出写入 outputs/lab13/。保存的基准使用 PyTorch 2.14.0+cpu;2026-09-22 保存基准的本地耗时约十余秒,不是 Deepnote 云端运行声明。
展开完整实现代码
from pathlib import Path
import json, hashlib, platform, sys, time
from datetime import datetime, timezone
import numpy as np
from PIL import Image, ImageDraw
import matplotlib
if 'get_ipython' not in globals(): matplotlib.use('Agg')
import matplotlib.pyplot as plt
import torch
from torch import nn
import torch.nn.functional as F
OUT = Path('outputs/lab13'); OUT.mkdir(parents=True, exist_ok=True)
torch.set_num_threads(1)
torch.manual_seed(1303)
np.random.seed(1303)
START = time.perf_counter()
VOCAB = ['<pad>', '<bos>', '<eos>', 'a', 'red', 'blue', 'green', 'square', 'circle', 'on', 'left', 'right']
W = {s:i for i,s in enumerate(VOCAB)}
PAD, BOS, EOS = 0, 1, 2
COLORS = {'red':(220,55,55), 'blue':(45,95,225), 'green':(35,170,75)}
print('CPU', torch.__version__, 'seed 1303; no downloaded data or weights')2. 图像先生成,目标句子只进入损失
三种颜色 × 两种形状 × 三个位置,得到 18 种组合。每图随机改变小幅平移、尺寸和像素噪声。中心图像的描述较短,如 a red square;侧边图像则为 a red square on left,因此本实验真的存在 PAD,而不是摆一个从来不被使用的 mask。
训练与保留图分别由 seed 13031 和 13033 生成,并检查像素哈希不重复。语义组合在两边都出现;这是新渲染样本的泛化,不是没见过组合的组合泛化。所有保留图的统计只用于最终报告。初期结构调试用 seed 13032 的开发图,另存于历史记录,不能混称独立测试。
展开完整实现代码
def render_object(color, shape, position, rng):
    canvas = Image.new('RGB', (32,32), (244,242,236))
    painter = ImageDraw.Draw(canvas)
    cx = {'left':8, 'center':16, 'right':24}[position] + int(rng.integers(-1,2))
    cy = 16 + int(rng.integers(-4,5)); radius = int(rng.integers(4,7))
    box = (cx-radius, cy-radius, cx+radius, cy+radius)
    if shape == 'square': painter.rectangle(box, fill=COLORS[color])
    else: painter.ellipse(box, fill=COLORS[color])
    arr = np.array(canvas).astype(np.float32) / 255
    arr = np.clip(arr + rng.normal(0,.018,arr.shape),0,1).astype(np.float32)
    return arr

def make_caption_data(n, seed):
    rng = np.random.default_rng(seed); images=[]; sequences=[]; descriptions=[]
    conditions = [(c,s,p) for c in COLORS for s in ['square','circle'] for p in ['left','center','right']]
    for i in range(n):
        color, shape, pos = conditions[i % len(conditions)]
        words = ['a',color,shape] + ([] if pos=='center' else ['on',pos])
        sequence = [BOS] + [W[w] for w in words] + [EOS]
        sequences.append(sequence+[PAD]*(7-len(sequence)))
        images.append(render_object(color,shape,pos,rng)); descriptions.append(' '.join(words))
    return torch.tensor(np.stack(images)).permute(0,3,1,2), torch.tensor(sequences), descriptions

Xtrain, Ytrain, train_text = make_caption_data(720,13031)
Xtest, Ytest, test_text = make_caption_data(180,13033)
# Independent random pixels/geometry; no duplicate image crosses the split.
train_hashes = {hashlib.sha256(x.numpy().tobytes()).hexdigest() for x in Xtrain}
assert not train_hashes.intersection(hashlib.sha256(x.numpy().tobytes()).hexdigest() for x in Xtest)
np.savez_compressed(OUT/'lab13-data.npz', train_images=Xtrain.numpy(), train_tokens=Ytrain.numpy(), test_images=Xtest.numpy(), test_tokens=Ytest.numpy())
print('images:', tuple(Xtrain.shape), tuple(Xtest.shape), 'tokens:', tuple(Ytrain.shape))
print('teacher input:', Ytrain[:3,:-1].tolist())
print('shifted target:',Ytrain[:3,1:].tolist())
print('loss mask:',Ytrain[:3,1:].ne(PAD).int().tolist())3. 视觉特征怎样真正进入语言模型
输入是 [B,3,32,32]。两次卷积和池化产生空间特征,展平后映射为 48 维视觉向量;这里不用全局平均池化,因为“左/右”依赖空间布局。每个词嵌入为 24 维,与同一视觉向量拼接后送入共享的 GRU;视觉向量还初始化 64 维隐藏状态。输出 logits 为 [B,T,12]。
代码中的 targets=Y[:,1:] 对齐 prefix=Y[:,:-1],ignore_index=PAD 排除补齐位置。优化器同时更新 CNN、词嵌入、GRU 和输出头,没有把真实颜色或位置喂给 CNN。每个 epoch 的保留集交叉熵仍是 teacher-forced 量,因此不能替代下一节的自由生成评价。
一次真实失败也有教学意义: 首轮使用未中心化像素和 tanh 视觉投影时,模型几乎忽略图像,整句准确率为 5.56%,视觉置零结果相同;历史代码、权重和 JSON 均保留。最终结构改为输入中心化、LayerNorm/ReLU 投影并降低学习率,之后锁定新的保留集。结果支持“视觉依赖需要检验”,不支持只凭训练损失下降就宣布模型看图。
展开完整实现代码
class Captioner(nn.Module):
    def __init__(self):
        super().__init__()
        self.cnn = nn.Sequential(nn.Conv2d(3,12,3,padding=1),nn.ReLU(),nn.MaxPool2d(2),nn.Conv2d(12,24,3,padding=1),nn.ReLU(),nn.MaxPool2d(2),nn.Flatten(),nn.Linear(24*8*8,48),nn.LayerNorm(48),nn.ReLU())
        self.word = nn.Embedding(len(VOCAB),24,padding_idx=PAD)
        self.initial = nn.Linear(48,64)
        self.rnn = nn.GRU(24+48,64,batch_first=True)
        self.output = nn.Linear(64,len(VOCAB))
    def encode(self, pixels):
        return self.cnn(pixels - 0.5)
    def forward(self, pixels, prefix):
        visual = self.encode(pixels)
        features = visual[:,None,:].expand(-1,prefix.shape[1],-1)
        hidden,_ = self.rnn(torch.cat((self.word(prefix),features),-1),self.initial(visual)[None])
        return self.output(hidden)

model = Captioner()
optimizer = torch.optim.Adam(model.parameters(),lr=.001)
curve=[]
for epoch in range(45):
    model.train(); order=torch.randperm(len(Xtrain)); total=0.; tokens=0
    for ix in order.split(60):
        logits=model(Xtrain[ix],Ytrain[ix,:-1])
        targets=Ytrain[ix,1:]
        # Sum over real targets then divide by their count, not padded positions.
        loss=F.cross_entropy(logits.reshape(-1,len(VOCAB)),targets.reshape(-1),ignore_index=PAD,reduction='sum')/targets.ne(PAD).sum()
        optimizer.zero_grad(); loss.backward(); nn.utils.clip_grad_norm_(model.parameters(),5); optimizer.step()
        count=int(targets.ne(PAD).sum()); total+=float(loss.detach())*count; tokens+=count
    model.eval()
    with torch.no_grad():
        logits=model(Xtest,Ytest[:,:-1]); gold=Ytest[:,1:]
        test_loss=float(F.cross_entropy(logits.reshape(-1,len(VOCAB)),gold.reshape(-1),ignore_index=PAD))
    curve.append({'epoch':epoch+1,'train_token_ce':total/tokens,'heldout_teacher_forced_ce':test_loss})
    if epoch in [0,5,11,23,44]: print(curve[-1])
torch.save({'state_dict':model.state_dict(),'vocab':VOCAB,'seed':1303},OUT/'lab13-caption-weights.pt')4. 推理只接自己的输出,再检查视觉依赖
Greedy 每一步取当前分布的 argmax,追加到自己的前缀,遇到 EOS 停止。下面的 beam 真实展开每条未结束假设,累加 log probability,并只保留分数最高的 3 条;结束假设不再扩展,最长生成 8 个新 token。此处没有长度归一化,所以不同长度会受原始句子概率的长度偏好影响。保留数据已足够简单,两种搜索都能答对,并未显示 beam 胜出。
本册的整句精确匹配比较解码后的内容字符串:颜色、形状和位置需与规范句一致。words()会忽略BOS/PAD并在EOS处截断,因此这个分数不单独检查EOS出现的具体位置;停止行为应另看生成token序列。它适合唯一规范句子的合成任务。自然图像可有多种正确描述,不能照搬此指标。视觉置零是分布外干预,单独下降还不够;因此再做固定错配:把保留集图像循环移位一个位置,保持真值句子不变。这个排列无固定点,但不等于均匀随机抽样,也不能当作“随机猜测基线”。
先预测:固定 <bos> a,红方块左侧换成蓝圆右侧,哪个词最先应改变?随后检查 same_prefix_controls,不要把数据生成器的标签当成模型生成。
展开完整实现代码
@torch.no_grad()
def greedy(pixels, prefix=(BOS,), max_new=8):
    model.eval(); seq=torch.tensor(prefix).repeat(len(pixels),1); finished=torch.zeros(len(pixels),dtype=torch.bool)
    for _ in range(max_new):
        nxt=model(pixels,seq)[:,-1].argmax(-1)
        nxt=torch.where(finished,torch.tensor(EOS),nxt)
        seq=torch.cat((seq,nxt[:,None]),1); finished|=nxt.eq(EOS)
        if bool(finished.all()): break
    return seq.tolist()

@torch.no_grad()
def beam_one(pixel, width=3, max_new=8):
    beams=[([BOS],0.0,False)]
    for _ in range(max_new):
        candidates=[]
        for seq,score,done in beams:
            if done: candidates.append((seq,score,True)); continue
            lp=F.log_softmax(model(pixel[None],torch.tensor([seq]))[0,-1],dim=-1)
            values,indices=lp.topk(width)
            for value,idx in zip(values.tolist(),indices.tolist()):
                candidates.append((seq+[idx],score+value,idx==EOS))
        beams=sorted(candidates,key=lambda b:b[1],reverse=True)[:width]
        if all(b[2] for b in beams): break
    # Ended hypotheses only if at least one ended; otherwise max-length fallback.
    ended=[b for b in beams if b[2]]
    return max(ended or beams,key=lambda b:b[1])

def words(ids):
    out=[]
    for idx in ids:
        if idx==EOS: break
        if idx not in [BOS,PAD]: out.append(VOCAB[idx])
    return ' '.join(out)

pred=[words(s) for s in greedy(Xtest)]
beam_pred=[words(beam_one(x)[0]) for x in Xtest]
zero_pred=[words(s) for s in greedy(torch.zeros_like(Xtest))]
# A deterministic derangement shifts test images; target captions stay fixed.
shuffle_index=torch.roll(torch.arange(len(Xtest)),1)
shuffle_pred=[words(s) for s in greedy(Xtest[shuffle_index])]
exact=lambda p: float(np.mean([a==b for a,b in zip(p,test_text)]))
metrics={'heldout_images':len(Xtest),'greedy_exact_match':exact(pred),'beam3_exact_match':exact(beam_pred),'zero_pixels_exact_match':exact(zero_pred),'shuffled_pixels_exact_match':exact(shuffle_pred),'final_train_token_ce':curve[-1]['train_token_ce'],'final_heldout_teacher_forced_ce':curve[-1]['heldout_teacher_forced_ce']}
print(json.dumps(metrics,indent=2))
# Hold the language prefix fixed; change only the input image.
rng=np.random.default_rng(999)
control_specs=[('red','square','left'),('blue','circle','right'),('green','square','center')]
control_pixels=torch.tensor(np.stack([render_object(*spec,rng) for spec in control_specs])).permute(0,3,1,2)
control_pred=[words(s) for s in greedy(control_pixels,prefix=(BOS,W['a']))]
controls=[{'condition':list(spec),'fixed_prefix':'<bos> a','generated':p} for spec,p in zip(control_specs,control_pred)]
print('same prefix, changed image:',json.dumps(controls,indent=2))5. 读真实图、真实曲线与失败边界
| 解码/干预 | 保留集整句准确率 |
|---|---|
| Greedy,自回归 | 100.0% |
| Beam,宽度 3 | 100.0% |
| 相同模型,所有像素置零 | 5.6% |
| 相同模型,图像循环错配 | 0.0% |
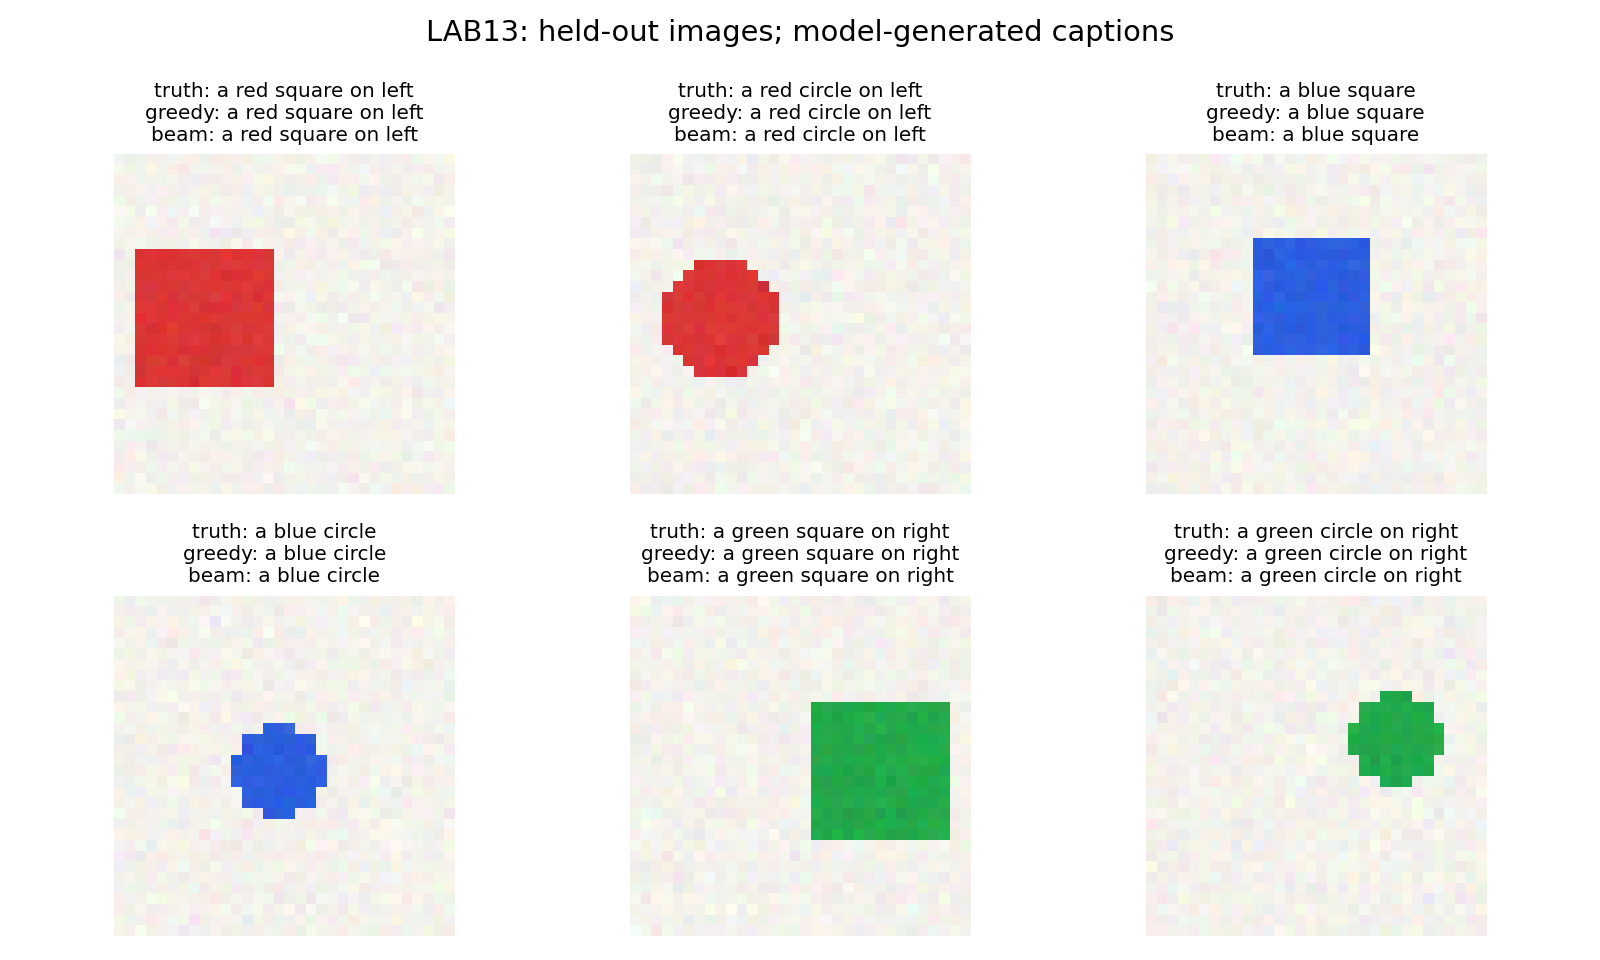
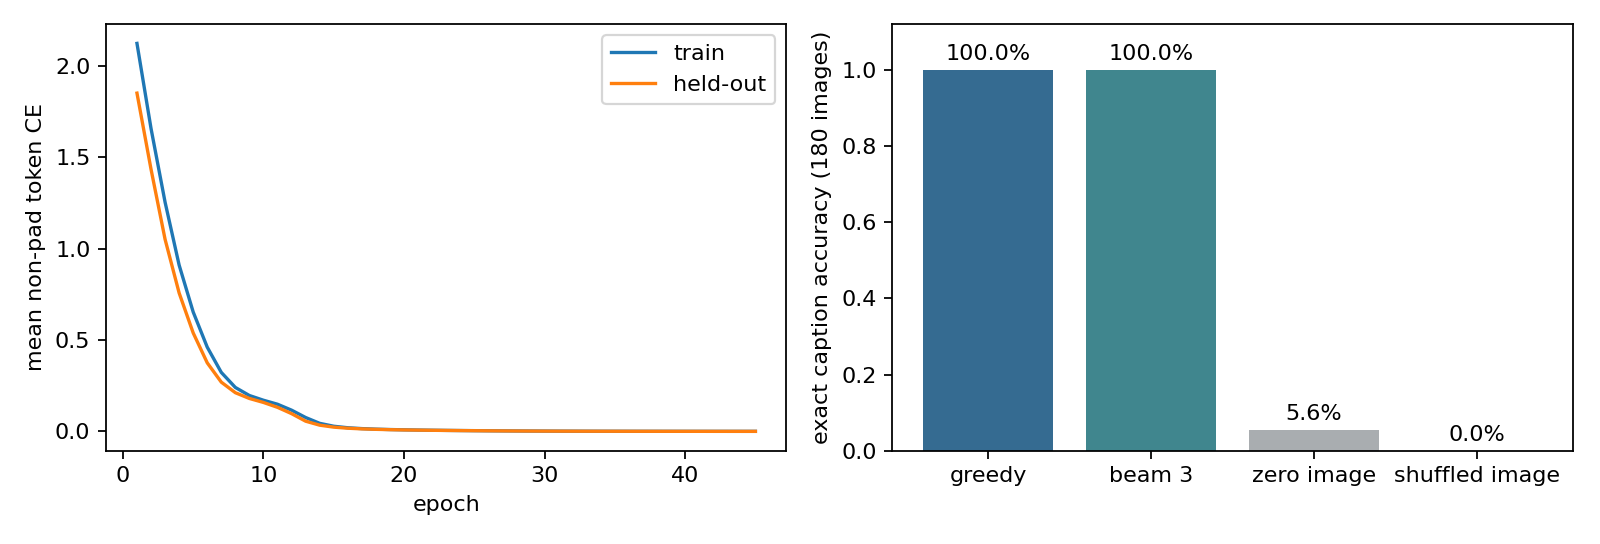
100% 只覆盖小词表、单对象和熟悉的语义组合;大小变化、噪声幅度都有限。下一步只改变一个条件:把 radius 范围扩大,或让图像包含两个对象,并先明确描述目标是否也应改变。不要在同一次改动中同时加对象、换语料和换评分,否则失败难以归因。
展开完整实现代码
fig,axes=plt.subplots(2,3,figsize=(10,6))
chosen=[0,3,7,10,14,17]
for ax,i in zip(axes.flat,chosen):
    ax.imshow(Xtest[i].permute(1,2,0)); ax.axis('off')
    ax.set_title('truth: '+test_text[i]+'\ngreedy: '+pred[i]+'\nbeam: '+beam_pred[i],fontsize=9)
fig.suptitle('LAB13: held-out images; model-generated captions',fontsize=13); fig.tight_layout()
fig.savefig(OUT/'lab13-caption-predictions.png',dpi=160); plt.show(); plt.close(fig)
fig,axes=plt.subplots(1,2,figsize=(10,3.4))
axes[0].plot([r['epoch'] for r in curve],[r['train_token_ce'] for r in curve],label='train'); axes[0].plot([r['epoch'] for r in curve],[r['heldout_teacher_forced_ce'] for r in curve],label='held-out'); axes[0].set(xlabel='epoch',ylabel='mean non-pad token CE');axes[0].legend()
labels=['greedy','beam 3','zero image','shuffled image'];values=[metrics[k] for k in ['greedy_exact_match','beam3_exact_match','zero_pixels_exact_match','shuffled_pixels_exact_match']]
axes[1].bar(labels,values,color=['#356b91','#40868e','#a9adb0','#a9adb0']);axes[1].set(ylim=(0,1.12),ylabel='exact caption accuracy (180 images)')
for i,v in enumerate(values):axes[1].text(i,v+.025,f'{v:.1%}',ha='center')
fig.tight_layout();fig.savefig(OUT/'lab13-caption-controls.png',dpi=160);plt.show();plt.close(fig)
fig,axes=plt.subplots(1,3,figsize=(9,3))
for ax,x,row in zip(axes,control_pixels,controls):
    ax.imshow(x.permute(1,2,0));ax.axis('off');ax.set_title('prefix: <bos> a\n'+row['generated'],fontsize=10)
fig.tight_layout();fig.savefig(OUT/'lab13-same-prefix.png',dpi=160);plt.show();plt.close(fig)
result={'notebook_id':'3da47f3ee3554ee0a36e0bb6a2fdc61f','execution':'local CPU, fresh process; not a Deepnote cloud run','created_utc':datetime.now(timezone.utc).isoformat(),'elapsed_seconds':time.perf_counter()-START,'environment':{'python':sys.version,'torch':torch.__version__,'numpy':np.__version__,'platform':platform.platform()},'split':{'train_seed':13031,'test_seed':13033,'train_images':720,'test_images':180,'description':'independent noisy renders; same 18 semantic combinations on both sides; no compositional/general-photo claim'},'metrics':metrics,'curve':curve,'same_prefix_controls':controls,'predictions':[{'truth':t,'greedy':p,'beam3':b,'zero':z,'shuffled':s} for t,p,b,z,s in zip(test_text,pred,beam_pred,zero_pred,shuffle_pred)],'weight_sha256':hashlib.sha256((OUT/'lab13-caption-weights.pt').read_bytes()).hexdigest(),'data_sha256':hashlib.sha256((OUT/'lab13-data.npz').read_bytes()).hexdigest()}
(OUT/'lab13-results.json').write_text(json.dumps(result,indent=2))
print('saved',OUT,'seconds',round(result['elapsed_seconds'],2))保存、来源与下一步
lab13-data.npz 保存真实训练/保留像素与 token;lab13-caption-weights.pt 保存该次模型;lab13-results.json 保存分割种子、逐轮损失、每条预测、环境、时间和权重/数据 SHA-256。下载的执行版 Notebook 含实际输出,完整代码在每格内。本册的训练和推理已在本地全新 Python 进程运行;这与原 Deepnote 云端历史 run 分开记录。
Show and Tell,CVPR 2015,论文作者/CVF 原文 是图像条件最大似然描述生成的来源。本册保留这一因子分解与 CNN→循环解码思路,但使用小 GRU、自造图形和简化评价;不是原论文复现。
回到 第四讲 · 从条件多解走向生成模型:caption 已经在生成。下一讲继续研究的是怎样表达更复杂的条件分布、目标与采样,而不是第一次出现生成。