Lecture 03 学习讲义
正文
工具
按问题查找
区域、像素与实例检测分数很高,错误究竟在哪里?

在同一场景里辨认四类检测错误

解释、算例与证据

P35 · 检测错在哪里,要分开看

从错类、漏检、框偏和重复四项错误读结果。IoU 把位置偏差变成可比较几何量,AP 再加入分数排序与对象唯一匹配。沿下方积分例走完分数排序、精确率与召回率计算,再用 LAB10 的结果辨认这些错误。

Lecture 03 课堂图解 P35漏检没有报告蓝杯错类别红杯 → “花瓶”偏位重复面积各 4 · 交集 2IoU = 2 / (4 + 4 − 2) = 1/3类别分数高,不会自动修正位置检测错误要分开检查;完整匹配、阈值和 AP 协议在补充阅读。
漏检
真值对象没有得到匹配的预测,召回会降低。
错类别
框覆盖对象,但类别不符,不能当作正确检测。
框偏位
类别对了,位置仍可能过不了 IoU 阈值。
重复预测
一个真值最多匹配一次;后来的重复框计作假阳性。

IoU 算例:两个框面积各为4,交集为2;并集=4+4−2=6,IoU=2/6=1/3。类别分数高不会自动修正位置。

同一场景的四种检测错误,以及面积各 4、交集 2 的框对,算得 IoU=1/3。 查看对应图解状态
查看完整图解

课堂讲述

现在检验系统,不能只问它有没有认出“杯子”。这个结果漏了一只,那个类别错了,这个位置偏了,另一个把同一只报了两次。这些错误需要分别观察。 位置常用交并比描述:相交面积除以覆盖的总面积。例子中两个框面积都是四,交集为二,交并比就是三分之一。类别分数高,不会自动把这个位置变得准确。 完整评价还要说明预测怎样与真值匹配,怎样处理重复和阈值。今天不手推整套 AP,但要留下这项判断:当你说某个预训练表示改善了检测,必须知道改善体现在哪种任务错误,而不只看一列总分。这也为接下来的像素任务准备了不同的检查方式。

图示条件与公式约定

IoU 面积算例使用两个 2×2 连续方框,横向错开1,交集2、并集6,IoU=1/3。四种错误是教学构造,不是本轮推理。

这条线索的展开与后续阅读

区域、像素与实例检测分数很高,错误究竟在哪里?

同样偏移一个单位,为什么小框损失更大?

从框偏这一类错误开始,把交集、并集和对象尺度放进同一计算。

同样移动一个单位,小框为什么更吃亏

独立阅读

两个面积均为 4 的框,交集为 2,并集为 4+4−2=64+4-2=6,所以 IoU=1/3,而不是 1/2。分母必须是覆盖总面积,不能只用真值面积。连续坐标的宽写作 x2−x1x_2-x_1,不要混入“整数像素含两端”的加一规则。

把两个同样大小的正方形横向错开 d,边长为 w 且 0≤d<w0\le d<w。交集面积 (w−d)w(w-d)w,并集 (w+d)w(w+d)w,于是 IoU=(w−d)/(w+d)(w-d)/(w+d)。错开一个单位时,边长 10 的框 IoU=9/11,边长 2 的框却只有 1/3。绝对坐标误差相同,几何质量不同。

检测检查还要分清错类、漏检、框偏和重复。分数只说明模型的相对确信程度,不能直接把偏掉的框变准。若同一模型 AP50 很好而 AP75 明显下降,说明它能覆盖不少对象,但更严格位置要求暴露了问题;还应查看具体预测,才能知道误差来自偏移、大小还是同类拥挤。

区域、像素与实例检测分数很高,错误究竟在哪里?

沿三个预测算出 AP=5/6

位置是否合格只是一步;按分数处理预测时还要为对象保留唯一匹配。

三个预测怎样变成 AP=5/6

独立阅读

固定一个类别、一张图里两个真值对象,IoU 合格门槛为 .5。三个预测按分数递减处理,身份依次是“命中对象 A”“重复命中 A”“命中 B”。同一真值不能用两次,因此 TP/FP 序列是 TP、FP、TP。

已处理预测数 累计 TP 累计 FP precision recall
1 1 0 1 1/2
2 1 1 1/2 1/2
3 2 1 2/3 1

采用本课程实验的 all-points precision-envelope 积分:从右向左取后续 precision 的最大值,于是包络为 1、2/3、2/3。recall 只有两次增加,各增加 1/2,所以 AP=(1/2)×1+(1/2)×(2/3)=5/6(1/2)\times1+(1/2)\times(2/3)=5/6。把第二项重复框排到最后,先后成为 TP、TP、FP,包络积分会变为 1;这说明分数排序有实际意义。

这里的 AP 是指定 IoU 下的一类积分;LAB10 对两个前景类分别算,再平均,分别报告 AP50 与 AP75。COCO 还有不同 IoU、recall 采样和面积等约定,不能给这个小算例贴“COCO AP”的名称。LAB09 提供与代码一致的匹配规则,遇到一个预测接近多个真值时,要按该实现的最大 IoU 对应顺序判断。

区域、像素与实例检测分数很高,错误究竟在哪里?

进入 LAB10:先读失败图,再解释高分

把错误分类、IoU 和 AP 带回已保存的图像到框学习记录。

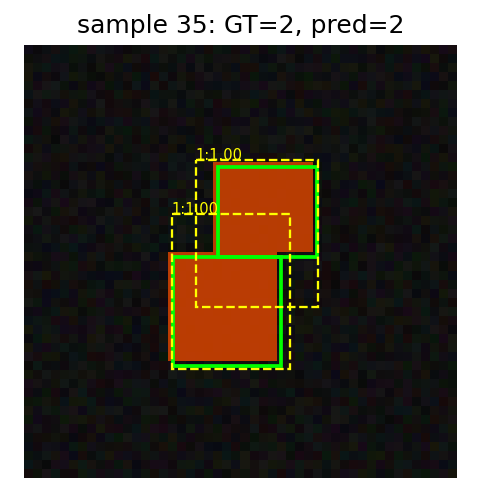
LAB10 原失败图的样本35完整面板,绿色为真值,黄色为分数至少0.4的预测
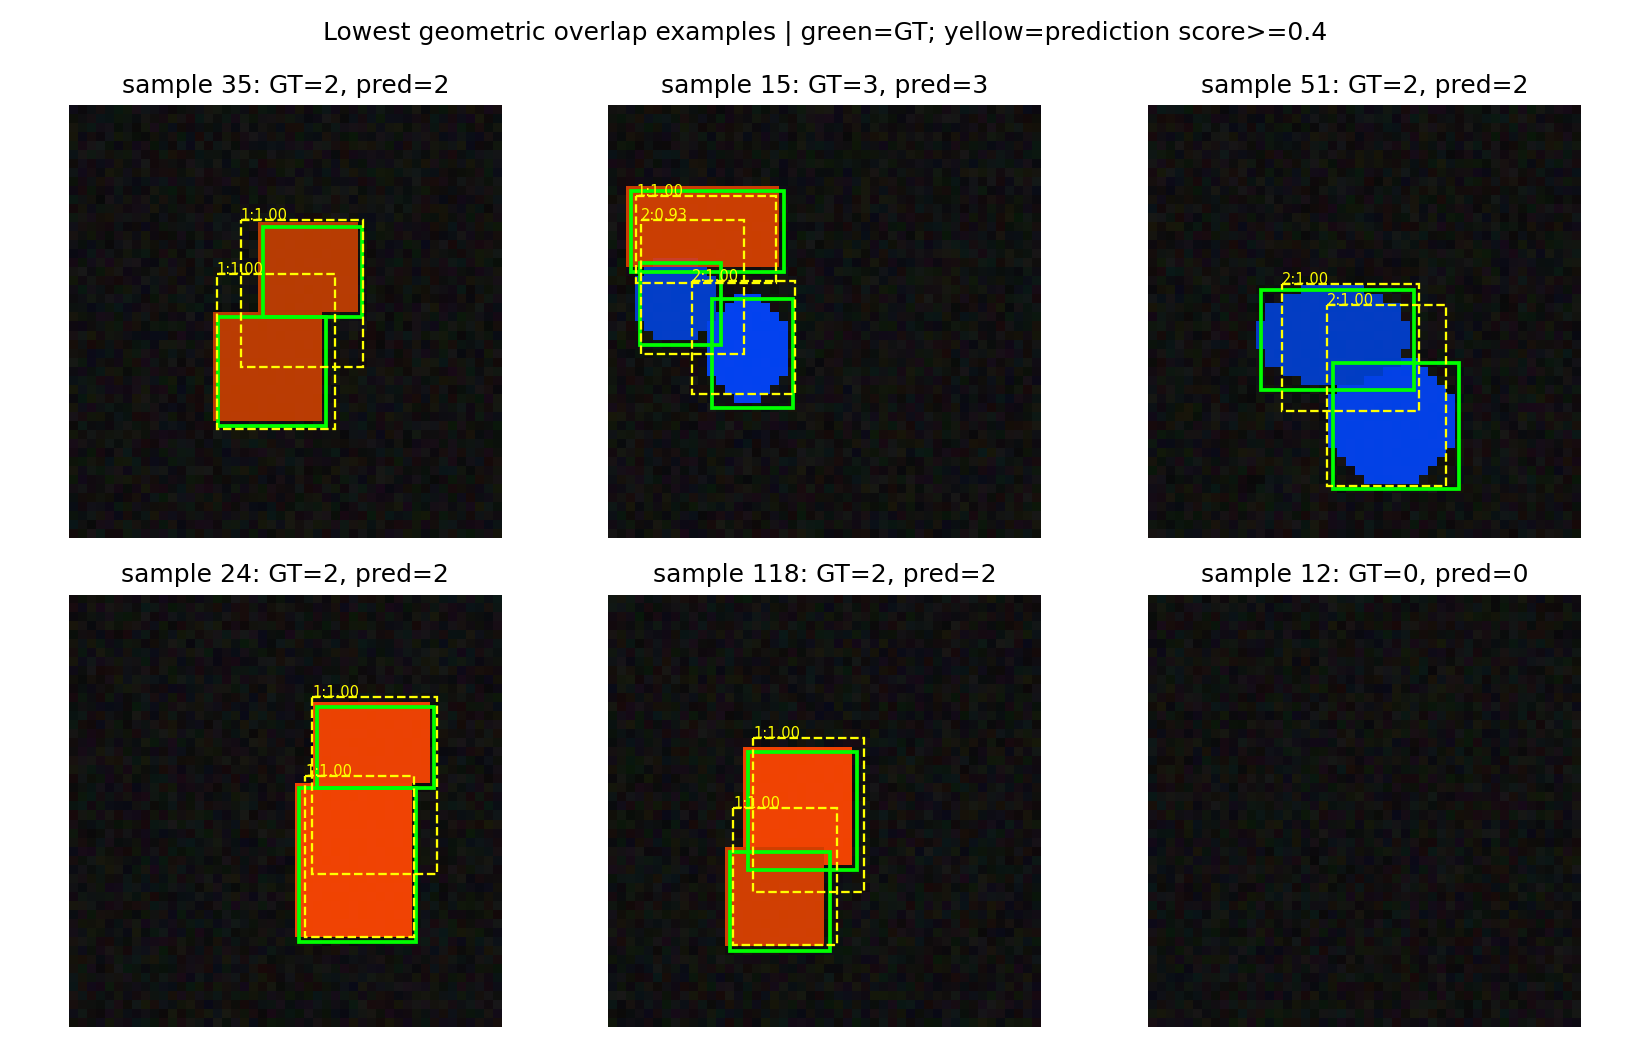
已有实验记录的样本35面板:绿色框为真值,黄色框为分数至少0.4的预测。样本35的真值与预测各有两个框,但边界没有正确对应两个相邻对象。样本按几何失败选取,不能代表全部样本的错误比例。查看完整失败图

从 RGB 到框:当前 LAB10 已经具备完整闭环

独立阅读

当前 LAB10 的主实验输入是真正的 48×48 RGB 合成图,目标是零至三个对象的类别与归一化框。卷积骨干生成 12×12 网格,每格两个参考框,共 288 个;两个头输出 [B,288,3] 类别 logits 与 [B,288,4] 偏移。图像进入 model(images),坐标只参与监督与评价。

保留的 2026-09-22 本地完整运行用 768 张训练图、96 张验证图、192 张保留图,训练 28 epoch。它以 TinySSD 的锚框检测闭环为起点,采用单特征层、两种参考尺度,不能称为 D2L 全部多尺度结构的复现。

条件 AP50 AP75
随机初始化 .00746 .00003
训练后原尺度 .97303 .70367
同权重,仅对象尺寸减半 .61490 .17987

这些是已有运行记录,本轮内容整理没有重跑实验。原分布明显改善,且存在多对象与空图,支持“模型学习到了图像到对象位置的映射”。更严格位置门槛与小尺度条件仍显著下降,帮助定位下一步研究问题。红色与矩形、蓝色与椭圆相关,因此不能据此宣称自然图像泛化。

读者可先看同一行的 RGB、真值框、预测框和失败图,再看匹配与损失,最后按需运行。原四维逻辑回归保留在热身位置,它说明分类更新,不承担检测证据。

区域、像素与实例检测分数很高,错误究竟在哪里?

只改变 NMS,检查新增框究竟是什么

已有模型让我们能够固定输入与权重,只检查后处理带来的取舍。

同一检测器改变 NMS,召回为何变好而精度变差

独立阅读

LAB10 已保存一组更接近真实使用的对照:输入与训练后权重保持不变,只把 NMS IoU 阈值从 .35 放宽到 .65。展示/工作点的分数门槛固定 .4。

NMS IoU recall@工作点 precision@工作点 AP50
.35 .98311 .94175 .97303
.65 1.00000 .41926 .95866

放宽后,一些原来被抑制的候选重新出现,补到了最后少数对象;同时大量同一对象的重复框留在输出,所以 precision 大降。AP 的变化比这个固定工作点的 precision 小,因为 AP 汇总整个分数排序,而工作点只看分数至少 .4 的输出。

这组已有本地结果不是本轮新运行。它的价值是把 P34 的两种效应落实到同一模型:预测数量增加本身没有确定好坏,必须看新增的是哪个对象、是否重复,以及部署时怎样使用阈值。选阈值应使用验证集与任务成本;不能反复挑保留集最漂亮的数字再称泛化结果。

区域、像素与实例选读:输出组织与训练分配还可以怎样改变?

一阶段检测简化哪一段,保留哪些问题?

回查 LAB10 实现时,用这一页辨认它与两阶段路线共有和不同的部分。

选读:一阶段检测保留了哪些相同问题

独立阅读

一阶段检测不先为每个 proposal 再做一套区域分类,而是在一个或多个特征网格上直接预测类别与位置。这个改变简化了输出路径,却没有消除参考几何、目标匹配、正负不平衡、重复预测与定位评价。

若 16×16 网格每格有 4 个参考框,共 1024 项;每项预测含背景的 3 类 logits 与 4 个偏移,就有 7168 个输出数。这些数还是结构化候选,需按同一位置顺序与参考框配对,随后解码并整理。张量 reshape 顺序错误时,模型的偏移可能被贴到另一个 anchor 上。

D2L TinySSD 在多尺度特征上构造参考框与预测。当前 LAB10 为保持 CPU 可运行,用 12×12 单层网格、每格两个尺寸,共 288 项;它保留图像输入到框输出的学习链,但不等于多尺度模型的全部能力。

本条作为从主讲移出的深入阅读:理解它有助于读实验代码,不要求课堂再开 SSD 全章。FPN 关注怎样形成不同尺度的表示,SSD 关注怎样在特征上预测;两者都出现多尺度,不意味着同一机制。

区域、像素与实例选读:输出组织与训练分配还可以怎样改变?

把难例权重与对象匹配分成两件事

一种训练调整影响样本权重,另一种先确定预测与目标的对应。

选读:难例权重和对象匹配不是一件事

独立阅读

大量背景参考框已经很容易分类,却可能因数量占优而贡献大量总损失。focal loss 在基本交叉熵外乘 (1−pt)γ(1-p_t)^\gamma。取 γ=2,正确类概率 .9 的样本权重 .01,概率 .5 的权重 .25,后者相对贡献更大。这是在调整哪些样本值得继续关注,不直接增加空间信息,也不指定哪项预测负责哪只对象。

对象匹配回答另一件事:当真值是一组无序对象,预测槽位该怎样对应它们?给两预测、两真值的代价矩阵 [[2,.3],[.4,2]],对角总代价 4,交叉 .7,所以选择交叉。交换标注数组顺序不该改变对象集合本身,匹配用于消除这个任意顺序。

LAB20 从类别概率、框 L1 与 IoU 实际构造成本,再穷举 2! 分配;它是足够透明的解析练习。这里没有图像编码器学习,也不是完整 DETR。主讲保留对象身份的必要性,这些损失组织细节进入选读即可,不必为保持课程丰富而重新开一章。

区域、像素与实例选读:输出组织与训练分配还可以怎样改变?

选读 LAB20:沿真实输入核对交叉匹配

用已保存的小算例落实上一页的对应问题,检查成本与数组顺序。

LAB20 的两个槽位为何应交叉匹配

独立阅读

当前 LAB20 的第一项预测框在右侧,类别概率更支持第二类;第二项预测在左侧,更支持第一类。真值数组却按左、右保存。如果不考虑内容,直接让槽位 0 学真值 0,就人为制造了位置和类别冲突。

代码按教学定义 Cij=−log⁡pi(cj)+2∥bi−gj∥1+(1−IoU)C_{ij}=-\log p_i(c_j)+2\lVert b_i-g_j\rVert_1+(1-IoU) 构造成本,得到约 [[5.0971,.4509],[.4779,5.6026]]。对角总代价 10.6997,交叉 .9288,因此最佳分配为槽位 0→真值 1、槽位 1→真值 0。只交换标注或预测数组的排列,最小内容对应仍然不变。

此处的负对数分类项、IoU 与系数是教学选择;官方 DETR matcher 使用其明确的分类、L1、GIoU 成本,不应声称公式逐项一致。匹配找到最低代价也不意味着检测正确:即使两项预测都很差,算法仍会选一个较便宜分配。检测质量仍要用保留数据与定位/类别标准评价。

本册另一小算例把 16 像素目标映到不同 stride 的连续跨度,属于尺度读取,与集合匹配不同。导航中把二者标为两项可单独读的短练习,学生无需为找一句机制解释穿过全部实验。

区域、像素与实例带着空间接口,怎样进入实验与语言任务?

选择一项完整实验,不按编号机械运行

按科研问题选择定位或像素路径,再用解析练习补齐具体疑问。

这条主线的课后顺序:先看输出,再做一项完整实验

独立阅读

不必按 Notebook 编号把所有内容从头运行。若刚听完课堂,先用 P25 的同一底图区分类别、框、语义与实例,再用 P41–45 的两个算例区分读取错位与表示碰撞。它们构成理解空间任务所需的最短连续线。

随后只选一项完整学习过程:关心对象位置就读 LAB10,沿图像、目标、匹配、分类/位置损失、预测与错误图走完;关心面积或边界就读 LAB11,比较 RGB 基线与 FCN、查看逐类 IoU 与窄缝错误。无需为了“完整”同时训练两本,也不要把只跑通环境当成理解模型。

LAB09 是检测公式的工作台,遇到匹配、NMS 或 AP 不清时按问题查;LAB03 是同源场景与空间读数的轻量练习。LAB16 的颜色连通域和 LAB20 的集合匹配放在选读,分别解释提示约束和对象排列,不与两项主实验争夺主线。

CLS02 提供区域到掩码的连续导读;CLS07、CLS08 分别展开检测公式与实例输出。各处按教师定稿名称和稳定 ID 回链。每个解释块有独立 URL,可直接带着具体问题交给 AI;链接中的正文先提供推理,再连接代码与原论文。
沿这个问题继续

先沿 CLS07 定位检测几何与评价疑问,再选 LAB09 做解析练习,或沿 LAB10 走完一次完整检测学习。其余入口见本部分更多学习路径。

按问题回查的讲解与短练习(6)