区域、像素与实例选读:输出组织与训练分配还可以怎样改变?
一阶段检测不先为每个 proposal 再做一套区域分类,而是在一个或多个特征网格上直接预测类别与位置。这个改变简化了输出路径,却没有消除参考几何、目标匹配、正负不平衡、重复预测与定位评价。
若 16×16 网格每格有 4 个参考框,共 1024 项;每项预测含背景的 3 类 logits 与 4 个偏移,就有 7168 个输出数。这些数还是结构化候选,需按同一位置顺序与参考框配对,随后解码并整理。张量 reshape 顺序错误时,模型的偏移可能被贴到另一个 anchor 上。
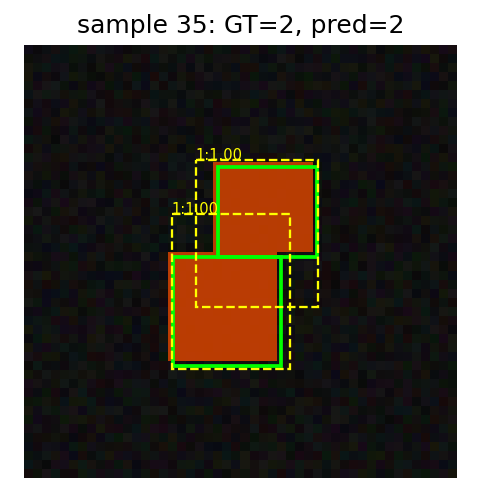
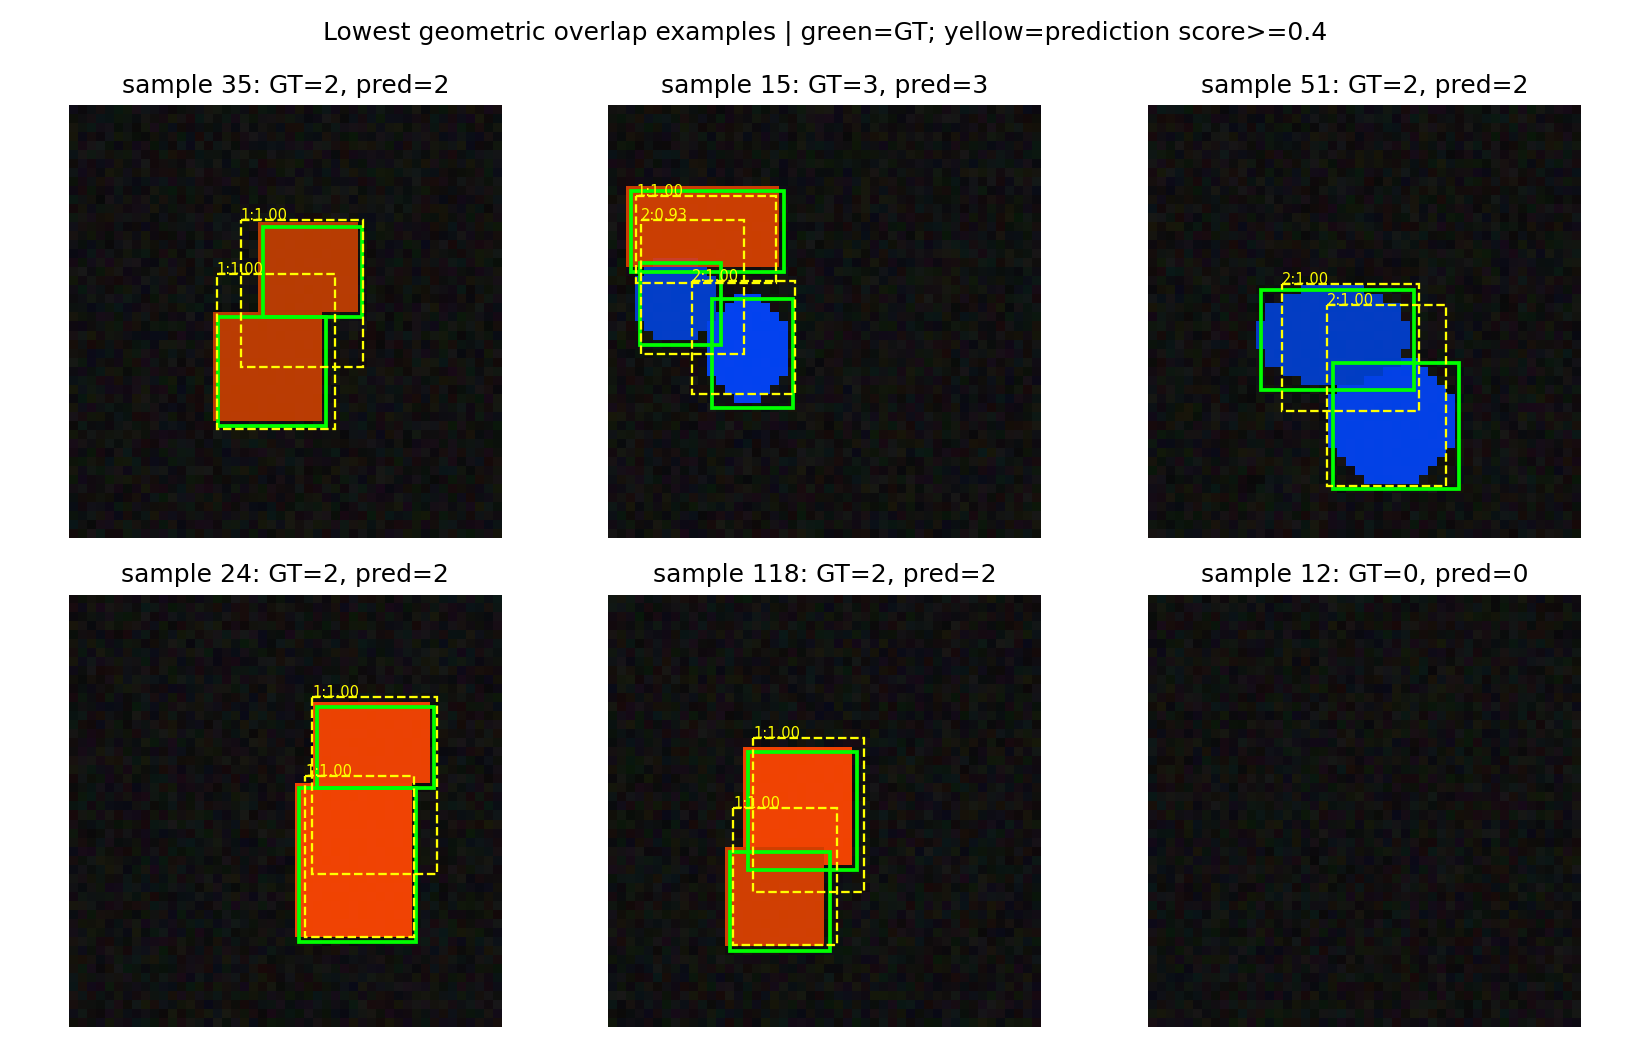
D2L TinySSD 在多尺度特征上构造参考框与预测。当前 LAB10 为保持 CPU 可运行,用 12×12 单层网格、每格两个尺寸,共 288 项;它保留图像输入到框输出的学习链,但不等于多尺度模型的全部能力。
本条作为从主讲移出的深入阅读:理解它有助于读实验代码,不要求课堂再开 SSD 全章。FPN 关注怎样形成不同尺度的表示,SSD 关注怎样在特征上预测;两者都出现多尺度,不意味着同一机制。
区域、像素与实例选读:输出组织与训练分配还可以怎样改变?
大量背景参考框已经很容易分类,却可能因数量占优而贡献大量总损失。focal loss 在基本交叉熵外乘 (1−pt)γ。取 γ=2,正确类概率 .9 的样本权重 .01,概率 .5 的权重 .25,后者相对贡献更大。这是在调整哪些样本值得继续关注,不直接增加空间信息,也不指定哪项预测负责哪只对象。
对象匹配回答另一件事:当真值是一组无序对象,预测槽位该怎样对应它们?给两预测、两真值的代价矩阵 [[2,.3],[.4,2]],对角总代价 4,交叉 .7,所以选择交叉。交换标注数组顺序不该改变对象集合本身,匹配用于消除这个任意顺序。
LAB20 从类别概率、框 L1 与 IoU 实际构造成本,再穷举 2! 分配;它是足够透明的解析练习。这里没有图像编码器学习,也不是完整 DETR。主讲保留对象身份的必要性,这些损失组织细节进入选读即可,不必为保持课程丰富而重新开一章。
区域、像素与实例选读:输出组织与训练分配还可以怎样改变?
当前 LAB20 的第一项预测框在右侧,类别概率更支持第二类;第二项预测在左侧,更支持第一类。真值数组却按左、右保存。如果不考虑内容,直接让槽位 0 学真值 0,就人为制造了位置和类别冲突。
代码按教学定义 Cij=−logpi(cj)+2∥bi−gj∥1+(1−IoU) 构造成本,得到约 [[5.0971,.4509],[.4779,5.6026]]。对角总代价 10.6997,交叉 .9288,因此最佳分配为槽位 0→真值 1、槽位 1→真值 0。只交换标注或预测数组的排列,最小内容对应仍然不变。
此处的负对数分类项、IoU 与系数是教学选择;官方 DETR matcher 使用其明确的分类、L1、GIoU 成本,不应声称公式逐项一致。匹配找到最低代价也不意味着检测正确:即使两项预测都很差,算法仍会选一个较便宜分配。检测质量仍要用保留数据与定位/类别标准评价。
本册另一小算例把 16 像素目标映到不同 stride 的连续跨度,属于尺度读取,与集合匹配不同。导航中把二者标为两项可单独读的短练习,学生无需为找一句机制解释穿过全部实验。
区域、像素与实例带着空间接口,怎样进入实验与语言任务?
不必按 Notebook 编号把所有内容从头运行。若刚听完课堂,先用 P25 的同一底图区分类别、框、语义与实例,再用 P41–45 的两个算例区分读取错位与表示碰撞。它们构成理解空间任务所需的最短连续线。
随后只选一项完整学习过程:关心对象位置就读 LAB10,沿图像、目标、匹配、分类/位置损失、预测与错误图走完;关心面积或边界就读 LAB11,比较 RGB 基线与 FCN、查看逐类 IoU 与窄缝错误。无需为了“完整”同时训练两本,也不要把只跑通环境当成理解模型。
LAB09 是检测公式的工作台,遇到匹配、NMS 或 AP 不清时按问题查;LAB03 是同源场景与空间读数的轻量练习。LAB16 的颜色连通域和 LAB20 的集合匹配放在选读,分别解释提示约束和对象排列,不与两项主实验争夺主线。
CLS02 提供区域到掩码的连续导读;CLS07、CLS08 分别展开检测公式与实例输出。各处按教师定稿名称和稳定 ID 回链。每个解释块有独立 URL,可直接带着具体问题交给 AI;链接中的正文先提供推理,再连接代码与原论文。