Lecture 03 学习讲义
正文
工具
按问题查找
视觉与语言一句话怎样落实为正确对象的区域?

沿坐标选出目标,而不是参照物

解释、算例与证据

P63 · GLIP:不只说相关,还要指出区域

语言条件落实为空间输出时,需要明确目标、参照物和关系。GLIP 提供对象级学习和迁移的研究路线;LAB15 提供可逐像素追踪的规则实验。两者的层级不同,但都帮助判断系统到底把框放在谁身上,再与后续掩码处理连接。

指代:拿球的蓝衣人“蓝衣人”“拿球的”图文交互 + 区域预测短语对应与定位监督训练目标落在局部区域输出:与短语对应的框GLIP 把词语与空间定位放进同一学习任务教学框展示任务接口,不是 GLIP 运行结果;区域交互和定位学习不能由整图分数直接代替。

蓝衣人在右侧持球场景,红衣人、蓝衣人与球都有候选框;短语和定位监督指向蓝衣人区域。

  • 指代:拿球的蓝衣人
  • “蓝衣人”
  • “拿球的”
  • 图文交互 + 区域预测
  • 短语对应与定位监督
  • 训练目标落在局部区域
  • 输出:与短语对应的框
  • GLIP 把词语与空间定位放进同一学习任务
  • 教学框展示任务接口,不是 GLIP 运行结果;区域交互和定位学习不能由整图分数直接代替。
蓝衣人在右侧持球场景,红衣人、蓝衣人与球都有候选框;短语和定位监督指向蓝衣人区域。 查看对应图解状态
查看完整图解

课堂讲述

GLIP 把语言与区域感知更直接地结合。文字中的概念和短语,不只与整幅图比较,还要与区域建立对应,并通过定位相关的监督学习输出位置。 因此,它不是简单把 CLIP 的整图分数画成一个框。局部关系、训练数据以及图文交互都进入了方法。我们在第二部分学到的区域组织,在这里遇到了更开放的语言条件。 这条技术线说明,语言可以改变视觉任务的组织方式,但不会自动消除空间任务。要指出“拿球的蓝衣人”,既要理解文字提出了什么,也要找到画面中的对应区域。接下来再看另一个方向:如果输出不是框,而是一段根据图片作出的回答呢?

“蓝杯左边的杯子”:目标、参照物、关系三者分开

独立阅读

短语 cup left of blue cup 中,目标类别是 cup,参照物是 blue cup,关系是 left of。看到 blue 就返回蓝杯,找到了参照物,却没有完成目标选择。

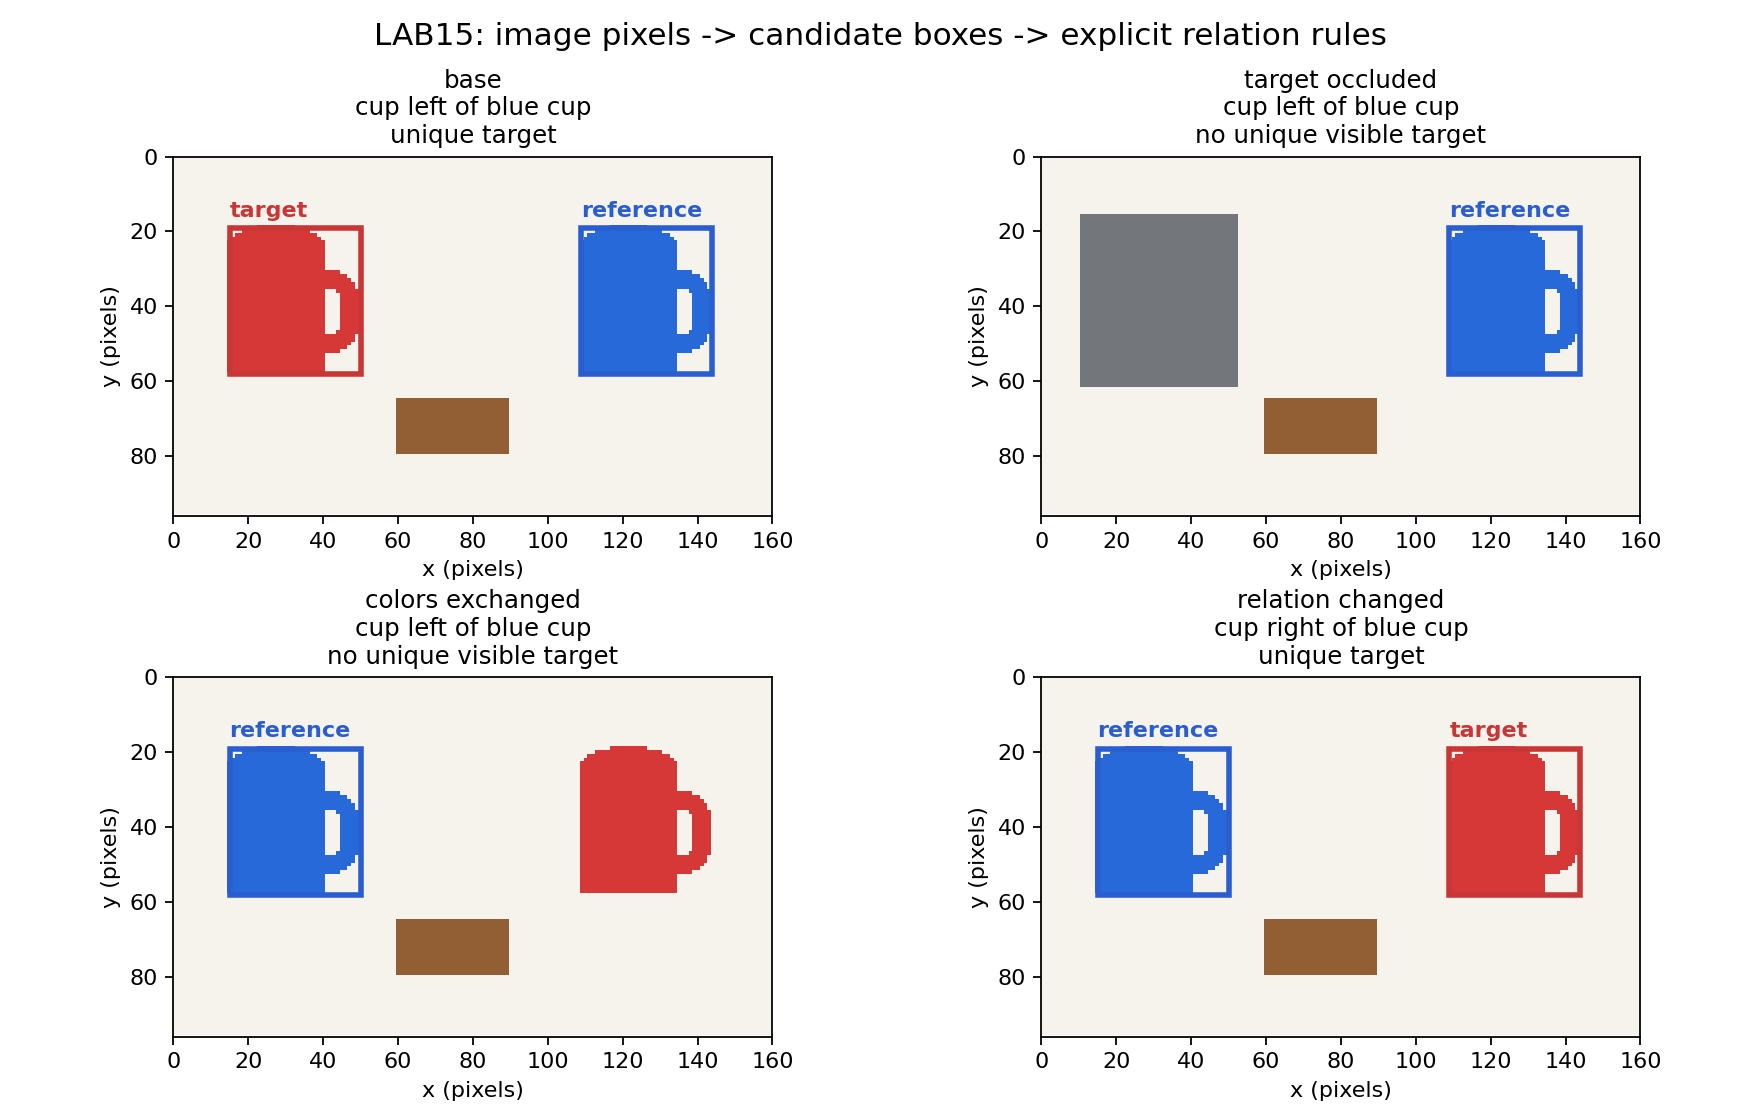
LAB15 的受控画布中,左红杯框为 [15,19,50,58][15,19,50,58],中心横坐标 32.5;右蓝杯框为 [109,19,144,58][109,19,144,58],中心横坐标 126.5;书的框为 [60,65,90,80][60,65,90,80]。本例定义 left-of 为目标中心横坐标小于参照中心,且目标不是参照物本身。

先找唯一蓝杯,再从其他杯子中筛选:红杯满足 32.5<126.532.5<126.5,应返回红杯框。书也在蓝杯左侧,却不满足 cup 类别约束。若蓝杯缺失、出现多个蓝杯或存在多个满足关系的目标,程序必须有明确的无目标/多义处理,不能随意返回最高颜色分的对象。

这里说明的是一套显式关系语义。“完全在左侧”可以改用 xmax(a)<xmin(r)x_{max}(a)<x_{min}(r),与中心比较在重叠情况下不同。把语言问题落实为区域时,要先解释采用哪种语义,再谈模型是否正确。图上的坐标约定是半开边界框,不是逐像素包含端点的面积公式。
这条线索的展开与后续阅读

视觉与语言一句话怎样落实为正确对象的区域?

从输入干预追到实际返回框

目标语义已定义;现在用保存的像素规则系统逐项检查输入怎样改变候选和答案。

已保存的指代实验:从像素提框后再应用关系

独立阅读

LAB15 的当前实现先从 RGB 图像按颜色阈值提取连通域,得到候选框;再解析目标、参照物与关系。它是真正读取像素的规则系统,类别由有限颜色约定提供,没有训练神经 grounding 模型。这个身份既不应被贬为“没读图”,也不应被升级为“复现 GLIP”。

实际输入改变 问句 保存的输出
原图左红、右蓝 蓝杯左边的杯子 左红杯
灰块遮住左杯 同上 无唯一可见目标
只交换两杯 RGB 色值 同上 无目标,蓝杯已在最左
保持交换图,只把 left 改 right 蓝杯右边的杯子 右红杯

遮挡是真的修改图片,不是在答案字典里删除目标;交换色值保留轮廓和背景;语言对照保持图片完全相同。代码断言干预区域外像素不变,并保存差分图。它因此能够支持这些有限条件下“图片怎样改变候选、关系怎样选择目标”的解释。

输入干预与返回框

旧关键词规则错选蓝杯仍保留为失败基线。当前结果来自 2026-09-22 已保存运行,本轮未重跑。若以后换自然照片,颜色阈值和杯子类别约定会失效;那时才需要加载相应视觉模型,并对输入和实际框做新的可追溯评价。

视觉与语言一句话怎样落实为正确对象的区域?

从透明规则走向对象级学习方案

像素规则实验解释了任务契约;GLIP 展示语言与区域可共同学习的研究路线。

GLIP:把类别和短语都放到对象级定位任务中

独立阅读

GLIP 将对象检测与短语定位用于共同的预训练。传统检测类别可以转写成文字概念,短语资料又提供更开放的语言—区域对应。视觉与文字发生交互,训练同时要求语义匹配和位置正确;这比给一组外部裁图计算 CLIP 整图分数多了任务结构与定位监督。

原论文使用 2700 万 grounding 训练样本,包含人工标注和由网络图文扩展的资料;在其协议中,直接评估 COCO 得到 49.8 AP,LVIS 得到 26.9 AP,且说明预训练没有使用 COCO 图像。这里的数字是论文所报告的对象级迁移结果,不是本课程持球图的运行。它支持语言条件和区域学习能够带来可迁移检测接口这一方向。

对课堂场景,“拿球的蓝衣人”要求图中多个对象、属性与关系共同约束一个框。若候选框身份错了,后接分割模型即使边界非常准确,也会分错对象。反过来,目标身份正确但边界粗糙,应检查分割与采样接口。把定位和掩码衔接时分开检查,正是第二部分仍然有用的原因。

LAB15 负责透明的语言关系规则,GLIP 论文负责更一般的学习方案与研究证据。两者互相解释,不互相冒充。主讲保留这一对象级接口;完整训练配置与更广数据对照留材料阅读。

沿这个问题继续

先回看本页画面并指出输入、条件和输出,再按““蓝杯左边的杯子”:目标、参照物、关系三者分开 → 已保存的指代实验:从像素提框后再应用关系 → GLIP:把类别和短语都放到对象级定位任务中”阅读。相关实验以其已保存结果为起点,需要动手时再顺序执行 Notebook;