Lecture 03原始遮挡场景
原始遮挡场景
主线阅读与优先实验
同图四输出、共享计算、FCN、RoIAlign、信息碰撞与SAM接口
原始遮挡场景
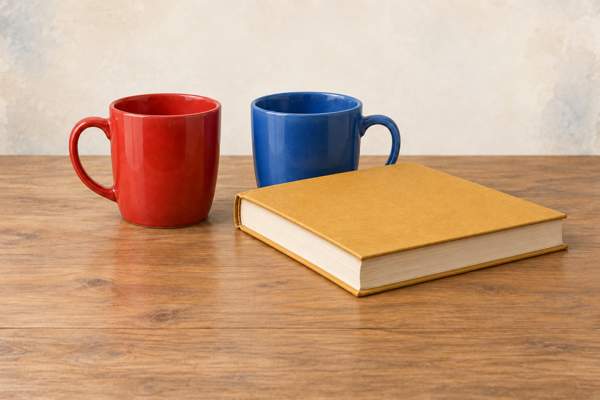
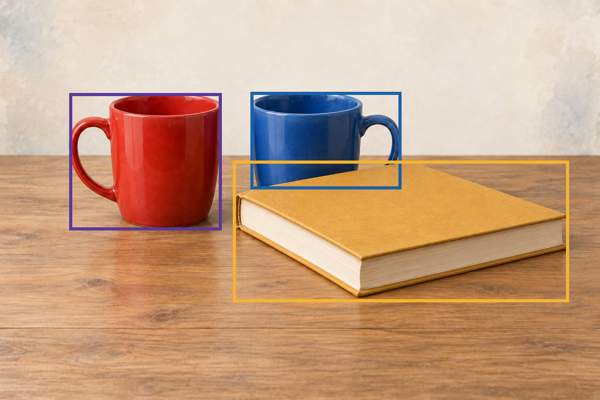
框:两个杯实例与一本书
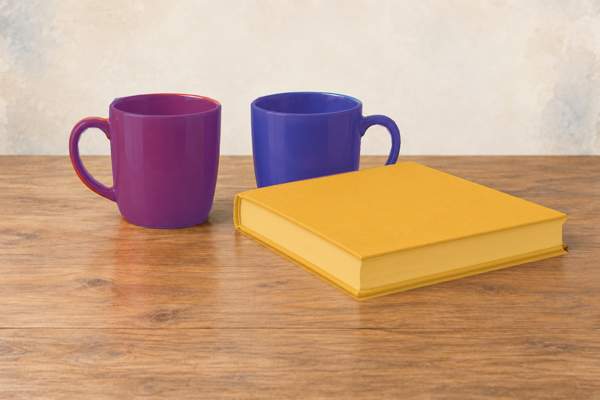
语义像素:两只杯共享类别
实例像素:两只杯分别编号
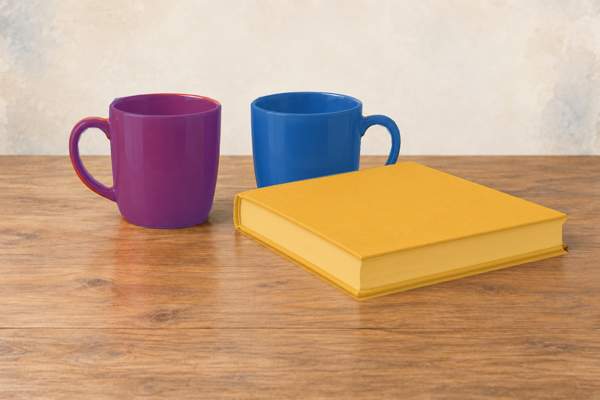
桌面多对象场景及教学框/掩码:同类杯子保留不同实例身份,局部遮挡让边界不总是完整可见。标注用于解释输出定义。
先不记模型名字。想象使用者依次改变要求:
| 使用者要什么 | 输出中至少要有什么 | 它还没有回答什么 |
|---|---|---|
| “画面里有什么?” | 杯子、书等类别 | 每个对象在哪里、有几个 |
| “找出每一个杯子。” | 每个对象的类别与框坐标 | 框内哪些像素属于杯子 |
| “把所有杯子像素选出来。” | 每个像素的类别 | 两个相接的杯子各是哪一个 |
| “分别选中两个杯子。” | 像素归属和实例身份 | 遮挡背后的不可见形状仍需额外约定 |
这四行分别对应分类、检测、语义分割、实例分割。框给出一个矩形范围,不能表达把手中间的空洞;同一个“杯子”类别值,又不能单独区分两只杯子。
先预测: 如果只保留“杯子、书”两个词,后续能从这两个词恢复第二只杯子的坐标吗?新任务改变了输出,也改变了训练答案必须包含的信息。