LAB 08 · 图像重建:遮挡损失与表示评价
按问题继续
索引恢复、去噪/遮挡ConvAE训练、PCA基线、独立冻结评价
对应课堂(5 页)
可先阅读已有结果,再决定是否运行。重算时请核对各节记录的数据、参数、环境与日期。
学习路径: 从遮挡重建到表示评价
图像恢复得更好,与学到更好用的表示,是同一个结果吗?
先看固定前8张保留图的输入、预测与误差,再读两份评价:隐藏像素MSE与冻结编码器5NN。第五列拼回已知像素和预测隐藏部分,数值只评价隐藏区域;不要把可见真值当模型预测。
产出一份双指标解释:哪项说明恢复改善,哪项说明本次数字读出改善。需要追踪实现时,先核对索引恢复,再读patch_mask、隐藏loss分母和冻结probe。这里训练的是密集卷积自编码器;原MAE只编码可见token的计算节省由P20另行解释。
索引热身仍然有用,但不能叫学到了语义
先保留旧版0到15序列的可见均值填充。4个可见值时隐藏MSE为19.9167,8个可见值时为21.25;可见数更多却不一定降低这个均值代理,因为选中的位置和值都改变了,没有模型学习。
接着随机打乱16个索引,保留4个,其余放mask标记−1;用逆排列恢复原位置。验证恢复后可见值位于正确坐标。这个断言证明的是位置对应,不是重建质量。
展开完整实现代码
import os, tempfile
LAB_WORKDIR = tempfile.mkdtemp(prefix='lecture03-')
os.chdir(LAB_WORKDIR)
print('Ephemeral experiment workspace ready')
import numpy as np
x=np.arange(16,dtype=float).reshape(4,4)
for visible in ([0,3,9,14],[0,5,10,15,3,6,9,12]):
 mask=np.ones(16,bool); mask[list(visible)]=False
 pred=np.full(16,x.ravel()[list(visible)].mean())
 mse=((pred[mask]-x.ravel()[mask])**2).mean()
 print('visible',len(visible),'masked',mask.sum(),'masked MSE',round(float(mse),3))
rng=np.random.default_rng(7);ids_shuffle=rng.permutation(16)
ids_restore=np.argsort(ids_shuffle);visible=ids_shuffle[:4]
shuffled=np.concatenate([x.ravel()[visible],np.full(12,-1.)])
restored=shuffled[ids_restore]
assert np.array_equal(restored[visible],x.ravel()[visible])
print('shuffle',ids_shuffle,'restore',ids_restore,'restored',restored)运行准备与结果身份
本册包含全部生成数据、模型、损失、优化与评价代码。按顺序在新内核运行;不读另一册的变量,不需要下载图像或预训练权重。依赖 Python 3.12、NumPy、matplotlib、scikit-learn 和 CPU PyTorch。本次实际版本见输出 JSON;若环境缺少 PyTorch,先运行 python -m pip install torch==2.14.0 --index-url https://download.pytorch.org/whl/cpu,再启动内核。NumPy、matplotlib、scikit-learn 可用 python -m pip install numpy matplotlib scikit-learn 安装。
下方表格和静态图来自 2026-09-22 本地 CPU 完整训练;它们不是原来的数值热身输出,也不代表 Deepnote 云端已重跑。运行本册会另建 lab08-notebook-output,保存 inputs.npz、config.json、权重、图与 results.json。CPU 时间受机器负载影响;本次每册约 10–25 秒,不能当作跨设备速度基准。单种子、小任务的结果用来检验路径和对照,不作方法排名。
展开完整实现代码
"""Actual denoising and masked convolutional AE on held-out digit images; not original ViT MAE."""
from pathlib import Path
import copy, hashlib, json, platform, time
import numpy as np
import torch
from torch import nn
from torch.nn import functional as F
from sklearn.datasets import load_digits
from sklearn.model_selection import train_test_split
from sklearn.neighbors import KNeighborsClassifier
import matplotlib
matplotlib.use('Agg')
import matplotlib.pyplot as plt

torch.set_num_threads(2)
SEED=20260922

SOURCE_SHA256='9f7f2ed888f5ea118ad1fc622ff64e1aa1e53d5ae162698fcbfb005f45201825'
print("source",SOURCE_SHA256,"torch",torch.__version__)数据、破坏与瓶颈
按数字标签分层分出1257张训练图和540张保留图,之后才产生破坏。标签只用于分层和最终近邻评价,AE优化只读取像素。像素原值0–16除以16,统一到[0,1];这里不是MNIST的28×28输入。
去噪输入按25%概率把像素置0,再叠加标准差0.15高斯噪声并裁剪到[0,1]。目标仍是原始清洁图像。两层stride2卷积将8×8压到16×2×2,线性层得到16维瓶颈;解码器从瓶颈扩展,再用转置卷积回到1×8×8,经sigmoid输出。
遮挡实验把8×8图像切为16个2×2patch。训练每图恰好隐藏8个patch,输入为两个通道:可见像素和二值mask。mask=1代表隐藏,能够区分“真黑像素”与“未知像素”。隐藏目标只出现在损失端,不能被送入编码器。
展开完整实现代码
def digit_data():
    data=load_digits(); x=torch.tensor(data.images/16,dtype=torch.float32)[:,None]
    train,test=train_test_split(np.arange(len(x)),test_size=.3,random_state=SEED,stratify=data.target)
    assert set(train).isdisjoint(test)
    return x,data.target,train,test

def noise_corrupt(x):
    return (x*(torch.rand_like(x)>.25)+torch.randn_like(x)*.15).clamp(0,1)

def patch_mask(n,ratio=.5):
    # Grid is 4x4 patches, each 2x2 pixels. 1 means HIDDEN.
    order=torch.rand(n,16).argsort(dim=1)
    keep=int(16*(1-ratio))
    patch=torch.ones(n,16);patch.scatter_(1,order[:,:keep],0)
    return patch.reshape(n,1,4,4).repeat_interleave(2,2).repeat_interleave(2,3)

class ConvAE(nn.Module):
    def __init__(self,channels=1):
        super().__init__()
        self.encoder=nn.Sequential(nn.Conv2d(channels,8,3,stride=2,padding=1),nn.ReLU(),
          nn.Conv2d(8,16,3,stride=2,padding=1),nn.ReLU(),nn.Flatten(),nn.Linear(64,16))
        self.expand=nn.Linear(16,64)
        self.decoder=nn.Sequential(nn.ConvTranspose2d(16,8,4,stride=2,padding=1),nn.ReLU(),
          nn.ConvTranspose2d(8,1,4,stride=2,padding=1),nn.Sigmoid())
    def forward(self,x):
h=self.encoder(x);return self.decoder(self.expand(h).reshape(-1,16,2,2)),h两个目标,两个分母
去噪的损失对所有像素平均:
遮挡模型只在隐藏集合M上平均:
如果对整图算MSE,再把大量可见真值复制到输出,会人为改善分母。这也是重建面板与指标要分开说明的原因:图上为方便阅读将已知像素原样保留,数值只评价隐藏部分。
两模型各自独立初始化并保存对应随机权重,Adam学习率0.003;去噪40轮,遮挡50轮。训练循环中每轮重新生成破坏,只有训练源图参与参数更新。
展开完整实现代码
def train_ae(x,train,kind,epochs=40):
    torch.manual_seed(SEED+(kind=='masked'))
    model=ConvAE(2 if kind=='masked' else 1);initial=copy.deepcopy(model)
    opt=torch.optim.Adam(model.parameters(),lr=.003);history=[]
    before=next(model.encoder.parameters()).detach().clone()
    for epoch in range(epochs):
        model.train();losses=[]
        for ids in torch.as_tensor(train)[torch.randperm(len(train))].split(64):
            clean=x[ids]
            if kind=='denoise':
                pred,_=model(noise_corrupt(clean));loss=F.mse_loss(pred,clean)
            else:
                mask=patch_mask(len(ids),.5)
                inp=torch.cat([clean*(1-mask),mask],dim=1)
                pred,_=model(inp);loss=(((pred-clean)**2)*mask).sum()/mask.sum()
            opt.zero_grad();loss.backward();opt.step();losses.append(float(loss.detach()))
        history.append(float(np.mean(losses)))
    delta=float((next(model.encoder.parameters()).detach()-before).norm());assert delta>0
    return model,initial,history,delta

def frozen_probe(model,x,y,train,test,masked=False):
    model.eval()
    with torch.no_grad():
        # Clean image readout; mask channel zero. No reconstruction targets at inference.
        inp=torch.cat([x,torch.zeros_like(x)],1) if masked else x
        h=model(inp)[1]
        a=F.normalize(h,dim=1).numpy()
    probe=KNeighborsClassifier(n_neighbors=5,metric='cosine').fit(a[train],y[train])
    return float(probe.score(a[test],y[test]))

def mask_index_warmup():
    rng=np.random.default_rng(7);tokens=np.arange(16);shuffle=rng.permutation(16)
    restore=np.argsort(shuffle);keep=shuffle[:4]
    shuffled=np.concatenate([tokens[keep],np.full(12,-1)])
    restored=shuffled[restore]
    assert np.array_equal(restored[keep],tokens[keep]);assert (restored==-1).sum()==12
    proxy=[]
    for visible in ([0,3,9,14],[0,5,10,15,3,6,9,12]):
        mask=np.ones(16,bool);mask[visible]=False
        pred=np.full(16,tokens[visible].mean())
        proxy.append({'visible':len(visible),'masked':int(mask.sum()),'constant_predictor_masked_mse':float(((pred[mask]-tokens[mask])**2).mean())})
return {'shuffle':shuffle.tolist(),'ids_restore':restore.tolist(),'restored':restored.tolist(),'constant_proxy':proxy}PCA、均值基线与冻结评价
PCA只在清洁训练图上拟合均值与16个主轴,再把保留集的噪声图投影回低秩空间。受约束的线性自编码器与PCA子空间有联系,所以它是有意义的透明比较;SVD没有替代这里的非线性神经网络训练。二者瓶颈同为16维,但参数量、目标和优化不同,不能把这一结果解释成严格的架构消融。
遮挡评估固定模型权重,在25%、50%、75%三个比例上使用同一批保留图和每图同一随机排列;隐藏集合随比例嵌套增加。对照是训练集均值图和填零,不是用保留图计算的均值。卷积模型在三个比例下仍处理完整8×8网格,不能把可见patch数当作本模型的加速比。
表示评价输入清洁图像,遮挡模型的mask通道全零;分别提取已训练/随机初始化的16维h,L2归一化后做余弦5-NN。参考库只有训练图及其标签。重建评价和数字识别有不同分母、单位和目标,不互相替代。
展开完整实现代码
def run_reconstruction(out_dir='lab08-output'):
    started=time.time();out=Path(out_dir);out.mkdir(parents=True,exist_ok=True)
    x,y,train,test=digit_data()
    np.savez_compressed(out/'inputs.npz',images=x.numpy(),labels=y,train_ids=train,test_ids=test)
    denoise,random_d,hist_d,delta_d=train_ae(x,train,'denoise',40)
    masked,random_m,hist_m,delta_m=train_ae(x,train,'masked',50)
    torch.save(denoise.state_dict(),out/'denoise.pt');torch.save(masked.state_dict(),out/'masked-conv-ae.pt')
    torch.save({'denoise':random_d.state_dict(),'masked':random_m.state_dict()},out/'random-init.pt')
    denoise.eval();masked.eval();torch.manual_seed(SEED+19)
    clean=x[test];corrupted=noise_corrupt(clean)
    with torch.no_grad():recon=denoise(corrupted)[0]
    mean_image=x[train].mean(0,keepdim=True)
    # PCA fits clean training images only. It is a rank-16 linear projection baseline.
    a=x[train].flatten(1).numpy();mu=a.mean(0);_,_,vt=np.linalg.svd(a-mu,full_matrices=False)
    v=vt[:16];noisy=corrupted.flatten(1).numpy();pca=np.clip((noisy-mu)@v.T@v+mu,0,1)
    metrics={'denoise':{'corrupted_input_mse':float(F.mse_loss(corrupted,clean)),
      'train_mean_mse':float(((clean-mean_image)**2).mean()),
      'rank16_pca_noisy_mse':float(np.mean((pca-clean.flatten(1).numpy())**2)),
      'learned_conv_ae_mse':float(F.mse_loss(recon,clean))}}
    masked_outputs={}
    for ratio in [.25,.5,.75]:
        torch.manual_seed(SEED+25)  # Same permutation at all ratios: nested hidden sets.
        mask=patch_mask(len(clean),ratio)
        inp=torch.cat([clean*(1-mask),mask],1)
        with torch.no_grad():pred=masked(inp)[0]
        loss=(((pred-clean)**2)*mask).sum()/mask.sum()
        mean_loss=(((mean_image-clean)**2)*mask).sum()/mask.sum()
        zero_loss=((clean**2)*mask).sum()/mask.sum()
        metrics[f'mask_{ratio}']={'hidden_pixels_mse':float(loss),'train_mean_hidden_mse':float(mean_loss),
          'zero_fill_hidden_mse':float(zero_loss),'visible_patches':int(16*(1-ratio)),
          'conv_encoder_grid_pixels':64}
        masked_outputs[ratio]=(mask,pred)
    probes={}
    for name,model,is_masked in [('random-denoise',random_d,False),('trained-denoise',denoise,False),('random-masked',random_m,True),('trained-masked',masked,True)]:
        probes[name]=frozen_probe(model,x,y,train,test,is_masked)
    # Save complete inference evidence, including corruption and masks.
    output_arrays={'clean':clean.numpy(),'corrupted':corrupted.numpy(),'denoised':recon.numpy(),'pca':pca.reshape(-1,1,8,8)}
    for ratio,(mask,pred) in masked_outputs.items():output_arrays[f'mask_{ratio}']=mask.numpy();output_arrays[f'pred_{ratio}']=pred.numpy()
    np.savez_compressed(out/'predictions.npz',**output_arrays)
    # Examples selected BEFORE seeing predictions: first eight test IDs, never cherry-picked.
    mask,pred=masked_outputs[.5]
    fig,axes=plt.subplots(8,6,figsize=(9,12))
    titles=['clean','corrupted','denoised','50% masked','predicted hidden','absolute error']
    for i in range(8):
        completed=clean[i]*(1-mask[i])+pred[i]*mask[i]
        ims=[clean[i],corrupted[i],recon[i],clean[i]*(1-mask[i]),completed,abs(completed-clean[i])]
        for j,im in enumerate(ims):
            axes[i,j].imshow(im[0],cmap='magma' if j==5 else 'gray',vmin=0,vmax=1,interpolation='nearest')
            axes[i,j].set_xticks([]);axes[i,j].set_yticks([])
            if i==0:axes[i,j].set_title(titles[j],fontsize=9)
        axes[i,0].set_ylabel(f'id {test[i]}\ny={y[test[i]]}',fontsize=8)
    fig.tight_layout();fig.savefig(out/'reconstruction-grid.png',dpi=150);plt.close(fig)
    fig,axes=plt.subplots(1,3,figsize=(14,4))
    axes[0].plot(hist_d,label='denoise: all pixels');axes[0].plot(hist_m,label='masked: hidden only');axes[0].legend(fontsize=8)
    axes[0].set(xlabel='epoch (0-based)',ylabel='train MSE',title='Objectives have different pixel sets')
    ratios=[.25,.5,.75]
    axes[1].plot(ratios,[metrics[f'mask_{r}']['hidden_pixels_mse'] for r in ratios],'o-',label='trained at 50%')
    axes[1].plot(ratios,[metrics[f'mask_{r}']['train_mean_hidden_mse'] for r in ratios],'o--',label='train mean')
    axes[1].set(xlabel='evaluation mask ratio',ylabel='held-out hidden MSE');axes[1].legend()
    axes[2].bar(list(probes),list(probes.values()));axes[2].tick_params(axis='x',rotation=25)
    axes[2].set(ylim=(0,1),ylabel='held-out accuracy',title='Frozen clean h: cosine 5-NN')
    fig.tight_layout();fig.savefig(out/'loss-mask-probe.png',dpi=140);plt.close(fig)
    config={'seed':SEED,'dataset':'sklearn load_digits, 1797 grayscale 8x8, pixels divided by16','train_n':len(train),'test_n':len(test),'split':'stratified random source-image split before corruption','denoise_epochs':40,'masked_epochs':50,'batch_size':64,'adam_lr':.003,'latent_dim':16,'denoise_corruption':{'pixel_drop':.25,'gaussian_sigma':.15,'clip':[0,1]},'mask_training_ratio':.5,'mask_patch_pixels':[2,2],'labels_used':'stratify/probe only; never AE loss','mask_encoder':'dense two-channel convolutional autoencoder; NOT ViT MAE','test_tuning':'none; predetermined epochs/mask ratios'}
    (out/'config.json').write_text(json.dumps(config,indent=2))
    payload={'code_sha256':globals().get('SOURCE_SHA256') or hashlib.sha256(Path(__file__).read_bytes()).hexdigest(),'kind':'local CPU full training and held-out evaluation','utc':time.strftime('%Y-%m-%dT%H:%M:%SZ',time.gmtime()),'seconds':time.time()-started,'torch':torch.__version__,'numpy':np.__version__,'python':platform.python_version(),'metrics':metrics,'frozen_clean_5nn':probes,'loss_history':{'denoise':hist_d,'masked':hist_m},'encoder_weight_l2_change':{'denoise':delta_d,'masked':delta_m},'index_warmup':mask_index_warmup(),'inputs_sha256':hashlib.sha256((out/'inputs.npz').read_bytes()).hexdigest()}
    (out/'results.json').write_text(json.dumps(payload,indent=2))
    print(json.dumps({'metrics':metrics,'frozen_clean_5nn':probes,'seconds':payload['seconds']},indent=2))
return payload展开完整实现代码
result=run_reconstruction('lab08-notebook-output')
from IPython.display import Image,display
display(Image(filename='lab08-notebook-output/reconstruction-grid.png'))
display(Image(filename='lab08-notebook-output/loss-mask-probe.png'))已运行结果:能恢复笔画,也会模糊或补错
| 去噪保留集指标 | 全像素MSE(越低越好) |
|---|---|
| 直接使用破坏图像 | 0.06244 |
| 训练集均值图 | 0.07351 |
| 16维PCA投影噪声图 | 0.04160 |
| 16维卷积去噪AE | 0.03217 |
| 评估遮挡率(均训练于50%) | 模型隐藏MSE | 训练均值隐藏MSE | 可见patch数 |
|---|---|---|---|
| 25% | 0.03933 | 0.07420 | 12 |
| 50% | 0.04341 | 0.07402 | 8 |
| 75% | 0.05563 | 0.07390 | 4 |
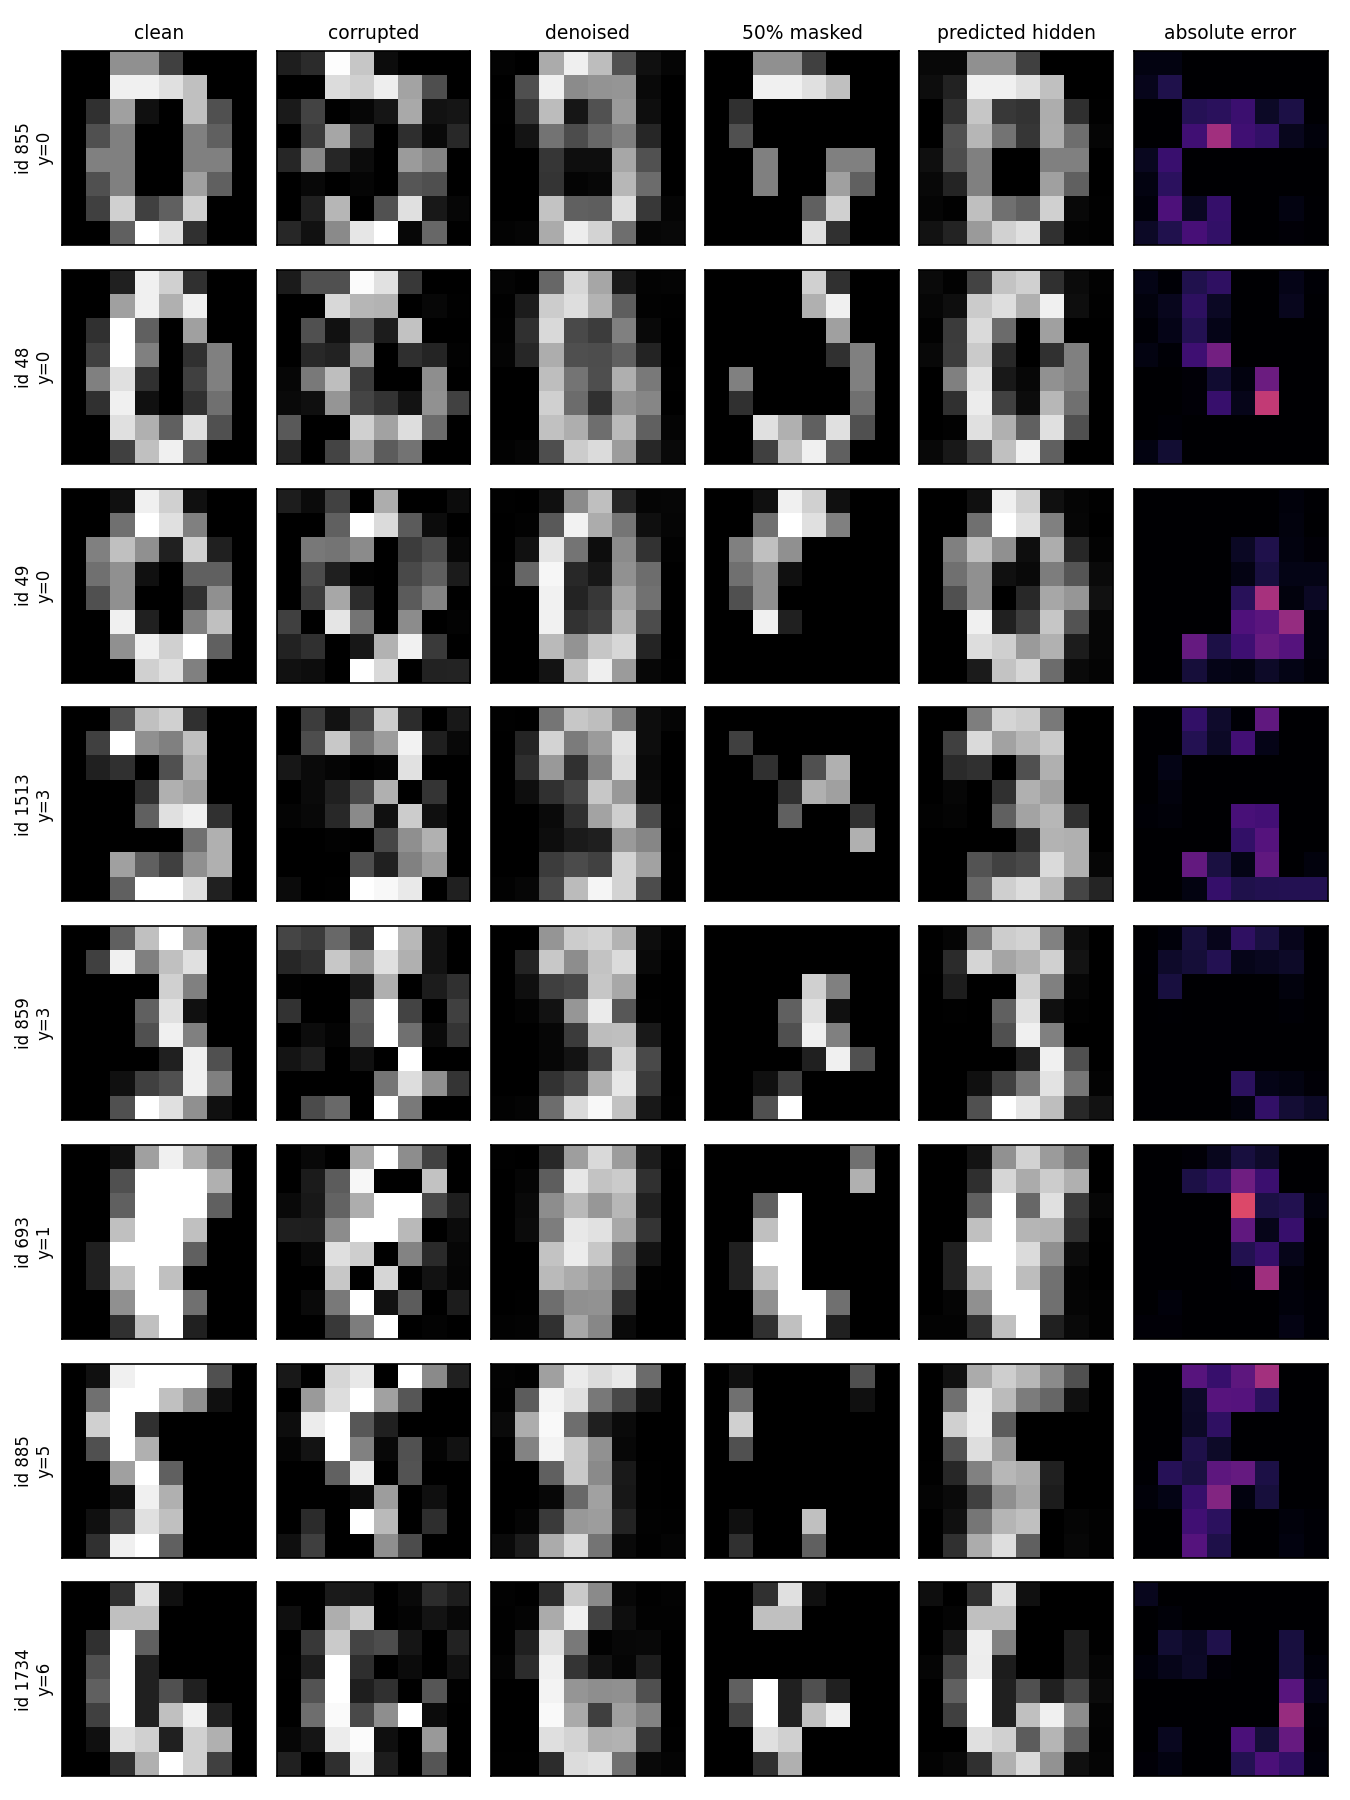
显示的是切分后前8个保留ID,选择规则不看预测好坏。第五列把可见真值和模型预测的隐藏部分拼回一张图;不是整图每个像素都由模型预测。第六列对应这个拼回图的绝对误差,因此可见区域为零。第三列去噪结果则整幅来自模型。
笔画大体恢复,但某些0被补得过厚、3的弯曲部分变模糊,5也会出现错误笔画。平方损失在缺少证据时倾向平均可能的像素,这种模糊并不等于模型正确理解了数字。75%遮挡的模型仍低于均值基线,但隐藏误差上升;这只是本数据、固定权重与这组嵌套mask的结果,不能作为75%是通用最佳比例的证明。
云端复核(2026-09-22):同一代码在 Deepnote 的 Python 3.13 / PyTorch 2.12.0+cu130 环境以 CPU 张量完整执行。去噪MSE仍为0.03217,50%遮挡隐藏MSE为0.04341,冻结读出仍为95.00%/92.04%;与本地基准一致到所报告精度。保存的静态图和权重仍明确标作本地基准。运行 ID:22b87ac6-c0ca-4586-b562-4d72103337ef。
表示评价给出另一份证据
| 清洁h的冻结5-NN | 保留集数字准确率 |
|---|---|
| 去噪架构:随机初始化 | 84.26% |
| 去噪架构:训练后 | 95.00% |
| 遮挡架构:随机初始化 | 88.52% |
| 遮挡架构:训练后 | 92.04% |
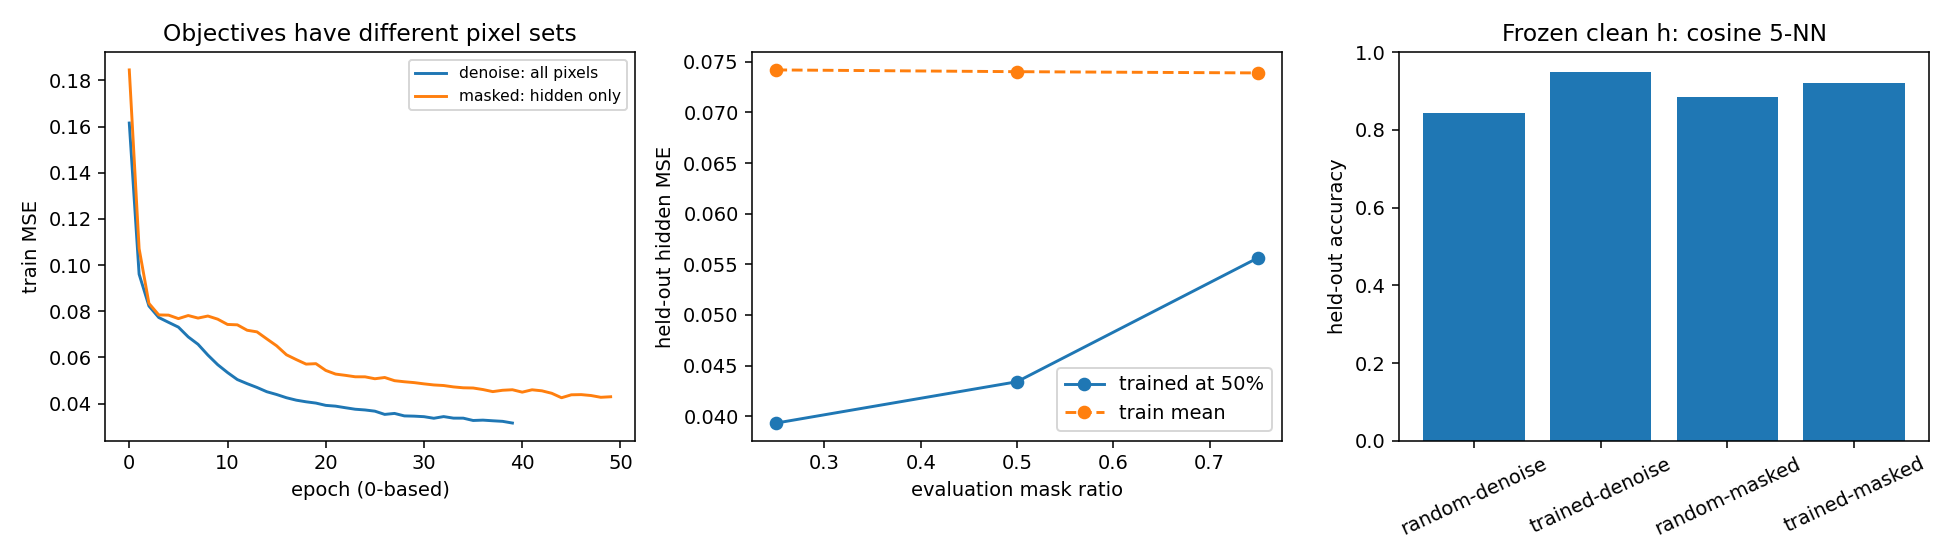
训练后的瓶颈在这次固定切分上比各自随机基线更适合数字近邻识别。两种随机基线不同,因为遮挡模型多一个输入通道,种子也独立;不能只比较95%和92.04%就宣称去噪在所有任务上更好。该切分以源图为单位,没有写作者分组,因此它也不证明跨写作者泛化。
对照 LAB 06:那里训练损失下降可以同时损害某项下游能力。这里重建和读出都改善,是实际测到的共同变化,不是从“无监督”这个名称推导出来的保证。
与原MAE逐项对齐
| 环节 | 本册masked ConvAE | 原MAE关键设计 |
|---|---|---|
| 编码器输入 | 可见像素+mask通道,完整8×8网格 | 只输入可见patch的token |
| 编码器 | 小卷积网络、16维瓶颈 | ViT编码器 |
| 位置恢复 | 索引热身精确演示;主模型保持网格位置 | 解码端恢复token顺序并加入mask token |
| 重建损失 | 隐藏像素MSE | masked patch的像素重建目标 |
| 计算量随mask变化 | 本实现基本不减少 | 可见token更少会减少编码器计算 |
| 表示评价 | 小数字集冻结5-NN | 论文有大规模分类与迁移评价 |
因此本册完成了真实图像遮挡重建与单独的表示评价,但没有把卷积模型重命名为原MAE复现。索引热身、masked ConvAE和MAE论文提供三种不同粒度的证据。
可做的条件修改:保持训练权重,先改变 patch_mask 的评估遮挡比例,维持相同随机排列;再选择一个新实验,把训练遮挡率改为75%,另存新目录。先预测低可见证据会怎样改变细笔画和读出,不要只寻找一张好看的重建图。
来源:去噪自编码器原论文、MAE原论文、MAE作者实现的mask/restore/loss、scikit-learn digits数据说明。本册模型结构、训练权重、图和测量来自本轮CPU运行。