Lecture 03已运行结果:字典正确,不代表语义读出必然变好
已运行结果:字典正确,不代表语义读出必然变好
按问题继续
真实FIFO键、EMA、梯度更新及低于随机基线的保留结果
已运行结果:字典正确,不代表语义读出必然变好
| 编码器 | h形状5NN | z形状5NN | h颜色5NN | z颜色5NN | h形状线性 | h颜色线性 |
|---|---|---|---|---|---|---|
| random | 72.50% | 60.42% | 100.00% | 100.00% | 56.25% | 100.00% |
| simclr | 47.50% | 58.33% | 100.00% | 100.00% | 69.17% | 100.00% |
| moco-toy | 38.33% | 38.75% | 100.00% | 100.00% | 54.58% | 100.00% |
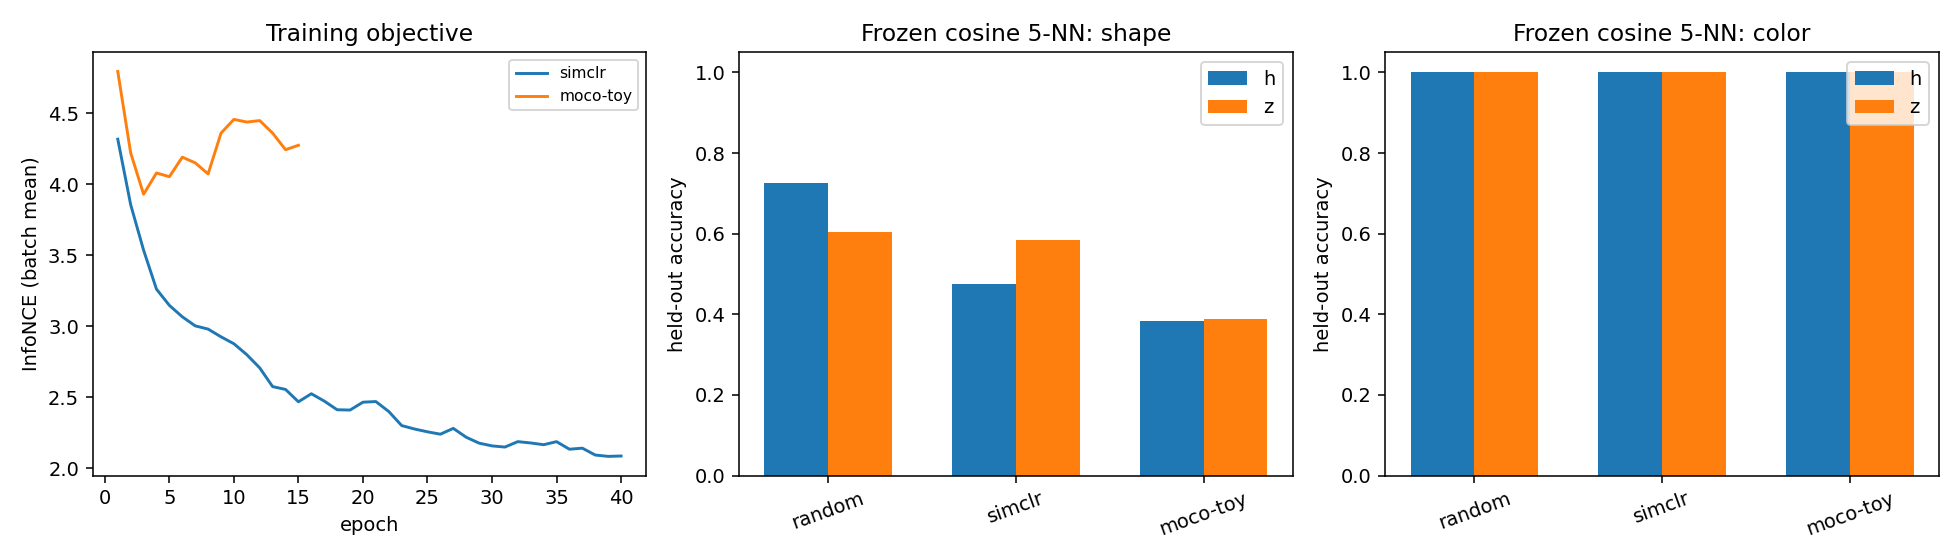
批内模型h形状5-NN为47.50%,小型MoCo为38.33%,都低于随机网络72.50%;颜色准确率均为100%。MoCo训练损失从4.793降至4.274,query第一层权重变化范数0.7625,且key参数全部没有梯度。模型实际学了,但有限的实例区分目标更容易保留颜色、位置等因素;不能把“loss下降”翻译成“形状语义更好”。
队列前几步的长度是60、120、180、240、240,第5步开始淘汰旧键,完整ID轨迹和最终队列随权重保存。这个证据与前面的字符串FIFO各回答一层问题:字符串检查精确更新顺序,图像代码检验这个顺序是否真的接入了训练。
若要考察增强能否改变这些结果,先保持队列容量、EMA和训练轮数,参照LAB06只加入色相交换。若要研究m,就保持其余设置,预先指定一组m和多枚种子;不要看过本保留集以后反复调到胜过随机再报告。
云端复核(2026-09-22):Python 3.13 / PyTorch 2.12.0+cu130 环境以 CPU 张量完整执行,SimCLR h形状5-NN为54.17%,小型MoCo为37.92%,随机仍为72.50%;颜色均100%。本地表格保留其 Python 3.12 / PyTorch 2.14 CPU 的实际结果,两次不合并为同一测量。队列/EMA接入和编码器更新均由云端输出核验。运行 ID:3e1babc4-7e23-46fe-8bfd-257351081ef9。