LAB 02 · 参数迁移:冻结、局部与全量微调
按问题继续
同源参数的冻结/局部/全量/scratch与BN模式辨析
对应课堂(1 页)
可先阅读已有结果,再决定是否运行。重算时请核对各节记录的数据、参数、环境与日期。
学习路径: 表示怎样迁移到新任务
允许改变参数以后,已有权重是否比从头训练更有用?
先读目标数字图和四臂参数范围:只训练新头、解冻后部、全部微调、随机起点。随后只按验证交叉熵选择停点和方案,最后读取保留评价。保存协议中scratch较好;用它检查“迁移必然获益”的直觉,而不是换一套口径把结果改好。
输入是MNIST数字≥5,叶片图只是应用情境。重算从准备单元开始,保持源checkpoint不变;需要新结论时另留评价集。只想判断现成表示而不改参数,请用LAB 01。
假设任务,效果待验证;AIGC情境插图。
先从图上找复用的理由,也找改变的条件。 同一个叶片识别任务,从白底固定拍摄走向温室:叶缘、叶脉和局部纹理仍可能有用;光照、尺度、背景和遮挡却发生变化。已有表示因此值得作为起点,但“值得试”之后,还要比较冻结、局部解冻和全部更新。
为让你现在就能动手,本页实际运行的是有真实标签的数字是否 ≥5:源任务为十类 MNIST,新任务为二分类。它练习相同的比较方法,结果属于数字任务。
本独立包携带原 L02-LAB 02 checkpoint、原报告和官方 MNIST 文件;无需访问其他项目的运行内存或文件。加载时校验 SHA-256。新任务 640 张图均来自源训练/源验证未用的官方训练索引,划分为 256 训练、128 验证、256 保留评价。缺少书写者分组,不能声称控制了书写者泄漏。用验证选择,最后查看保留集。
下面在 CPU 上比较三种迁移范围和一个从头训练对照,默认各 4 轮。耗时依环境而定;先读取项目中的数据和模型文件,无付费接口或新增作业义务。
准备:本实验的固定材料
先读保存结果,再决定是否重算。 原教师曲线与输入图仍内嵌在本册,历史数值位于 historical-v16/。
在当前项目中使用 lab09-transfer/。下面的准备代码先检查该目录,若缺失则下载本讲原站的完整包并安全解压;已有文件不覆盖。包内含 results/cnn-plain-state.pt、results/lab02-results.json 和两份官方 MNIST 训练文件,无须先运行第二讲 notebook。
安装该目录 requirements.txt 后从本册顺序运行。模型、数据和源划分会逐项核对;训练四臂是学生可选操作,保存结果已经足以完成讨论。
展开完整实现代码
# 当前项目中的独立材料:已存在则复用,缺失才从本讲原站准备。
from pathlib import Path
import io, zipfile, urllib.request
_base = Path.cwd()
_folder = 'lab09-transfer'
_sentinel = 'data/train-images-idx3-ubyte.gz'
_choices = [_base/_folder, _base/'lecture03-labs'/_folder, _base]
_ready = next((p for p in _choices if (p/_sentinel).is_file()), None)
if _ready is None:
    _url = 'https://codingai-lec03.pages.dev/course/materials/' + _folder + '.zip'
    _payload = urllib.request.urlopen(_url, timeout=60).read()
    with zipfile.ZipFile(io.BytesIO(_payload)) as _archive:
        _names = [i.filename for i in _archive.infolist() if not i.is_dir()]
        _prefix = _folder + '/'
        _prefixed = all(n.startswith(_prefix) for n in _names)
        _destination = _base if _prefixed else _base/_folder
        for _item in _archive.infolist():
            _target = (_destination/_item.filename).resolve()
            if not _target.is_relative_to(_destination.resolve()):
                raise ValueError('材料包中有越界路径,停止解压。')
            if _item.is_dir():
                _target.mkdir(parents=True, exist_ok=True)
            elif not _target.exists():
                _target.parent.mkdir(parents=True, exist_ok=True)
                _target.write_bytes(_archive.read(_item))
    _ready = next((p for p in _choices if (p/_sentinel).is_file()), None)
assert _ready is not None, '请将本讲完整材料包解压到当前项目的 ' + _folder + '/;保留文件结构。'
LAB_ROOT = _ready
print('材料目录已就绪:', LAB_ROOT)

import copy, gzip, hashlib, io, json, os, time
from pathlib import Path
from collections import OrderedDict
import numpy as np
import matplotlib.pyplot as plt
from matplotlib.patches import Rectangle
import torch
from torch import nn
from torch.nn import functional as F
torch.set_num_threads(2)
torch.manual_seed(20260917)

ROOT=LAB_ROOT
if not (ROOT/'data').is_dir() and (ROOT/'lab09-transfer/data').is_dir():ROOT=ROOT/'lab09-transfer'
assert (ROOT/'data').is_dir(), '请解压独立 lab09-transfer 包并保留目录结构。'
OUT=ROOT/'runs/current';OUT.mkdir(parents=True,exist_ok=True)
**重算入口:**当前项目的 lab09-transfer/ 是明确文件依赖。清空内存后,从本册准备代码顺序运行;不借用其他 notebook 的变量。
展开完整实现代码
MODEL_PATH=ROOT/'results/cnn-plain-state.pt'
REPORT_PATH=ROOT/'results/lab02-results.json'
DATA=ROOT/'data'
files={
 'train-images-idx3-ubyte.gz':'440fcabf73cc546fa21475e81ea370265605f56be210a4024d2ca8f203523609',
 'train-labels-idx1-ubyte.gz':'3552534a0a558bbed6aed32b30c495cca23d567ec52cac8be1a0730e8010255c'}
missing=[str(p) for p in [MODEL_PATH,REPORT_PATH,*[DATA/n for n in files]] if not p.is_file()]
if missing:
    raise RuntimeError('独立材料包不完整,请重新解压 data/ 与 results/:'+', '.join(missing))
report=json.loads(REPORT_PATH.read_text())
protocol=report['protocol']
assert protocol['split_seed']==20260908 and protocol['train_n']==12000, '本练习要求 LAB 02 默认源训练划分;改变划分后需要重新检查源/目标重叠。'
raw={}
for name,sha in files.items():
    raw[name]=(DATA/name).read_bytes()
    assert hashlib.sha256(raw[name]).hexdigest()==sha, 'MNIST 文件不匹配:'+name
images=np.frombuffer(gzip.decompress(raw['train-images-idx3-ubyte.gz']),dtype=np.uint8,offset=16).reshape(60000,1,28,28)
digit_labels=np.frombuffer(gzip.decompress(raw['train-labels-idx1-ubyte.gz']),dtype=np.uint8,offset=8)
partition=np.random.default_rng(20260908).permutation(60000)
expected_partition_sha=hashlib.sha256(partition.tobytes()).hexdigest()
expected_train_sha=hashlib.sha256(partition[:12000].tobytes()).hexdigest()
expected_val_sha=hashlib.sha256(partition[50000:].tobytes()).hexdigest()
assert protocol['train_ids_sha256']==expected_train_sha
assert protocol['partition_sha256']==expected_partition_sha and protocol['validation_n']==10000
state_bytes=MODEL_PATH.read_bytes()
model_sha256=hashlib.sha256(state_bytes).hexdigest()
COURSE_MODEL_SHA256='ba8b738cc67d4ec3cd83d75a5dbe8a70ec548377335ba0abaaa7c23cd14eeba3'
identity=report.get('checkpoint_provenance',{}).get('cnn-plain-state.pt')
if identity is not None:
    assert identity['sha256']==model_sha256, '模型与 LAB 02 报告不是同一轮保存的文件;请重新运行 LAB 02 第4节和保存结果单元。'
    source=identity['source_protocol']
    assert source['split_seed']==20260908 and source['train_n']==12000 and source['validation_n']==10000
    assert source['partition_sha256']==expected_partition_sha
    assert source['train_ids_sha256']==expected_train_sha and source['validation_ids_sha256']==expected_val_sha
    source_files={item['file']:item['sha256'] for item in source['files']}
    assert all(source_files.get(name)==sha for name,sha in files.items()), '源训练数据身份与本练习不一致。'
    identity_basis='LAB02 training-time checkpoint hash and source protocol'
elif model_sha256==COURSE_MODEL_SHA256:
    # 已追溯的课程旧模型兼容旧报告;此分支仅接受这一份确切文件。
    identity_basis='known course checkpoint SHA-256 with verified default source split'
else:
    raise RuntimeError('当前模型缺少与报告绑定的训练来源。请重新运行更新后的 LAB 02 第4节及保存结果单元;不要给旧文件补写哈希。')
target_ids=partition[12000:12640]
assert not set(target_ids)&set(partition[:12000])
assert not set(target_ids)&set(partition[50000:])
target_buffer=io.BytesIO()
np.savez_compressed(target_buffer,images=images[target_ids],digit_labels=digit_labels[target_ids],
 official_train_ids=target_ids,split=np.array([0]*256+[1]*128+[2]*256,dtype=np.uint8))
provenance={'dataset':'MNIST official training set','source_task':'ten-class digit classification',
 'source_checkpoint_sha256':model_sha256,'source_identity_basis':identity_basis,'source_origin':'bundled original LAB02 protected checkpoint; cross-project independent package',
 'target_task':'digit >= 5 (binary)','source_split_seed':20260908,
 'source_train_permutation_positions':[0,12000],'source_validation_permutation_positions':[50000,60000],
 'target_permutation_positions':[12000,12640],'target_split_sizes':{'train':256,'validation':128,'heldout':256},
 'target_ids_sha256':hashlib.sha256(target_ids.tobytes()).hexdigest(),
 'limitations':['single small digit task','source/target sample indices disjoint; writer groups unavailable','not a leaf experiment']}
asset_bytes={'cnn-plain-state.pt':state_bytes,'target.npz':target_buffer.getvalue(),
 'target-provenance.json':json.dumps(provenance).encode()}
print('使用包内已核验模型;目标样本与默认源训练/验证索引不重叠。')
展开完整实现代码
source_state=torch.load(io.BytesIO(asset_bytes['cnn-plain-state.pt']),map_location='cpu',weights_only=True)
def make_cnn():
    return nn.Sequential(OrderedDict([
      ('conv1',nn.Conv2d(1,8,3,padding=1)),('relu1',nn.ReLU()),('pool1',nn.MaxPool2d(2)),
      ('conv2',nn.Conv2d(8,16,3,padding=1)),('relu2',nn.ReLU()),('pool2',nn.MaxPool2d(2)),
      ('flatten',nn.Flatten()),('hidden',nn.Linear(784,32)),('relu3',nn.ReLU()),('logits',nn.Linear(32,10))]))
source_model=make_cnn();source_model.load_state_dict(source_state);source_model.eval()
assert sum(p.numel() for p in source_model.parameters())==26698
print('已读取独立包内的 26698 参数 CNN;PyTorch',torch.__version__)
print('当前模型 SHA-256:',model_sha256)
1. 先写预测,再确定协议
标签变了,输入的笔画还在。 下面是目标训练集的前 8 个例子;y=1 表示数字 ≥5,y=0 表示数字 <5。
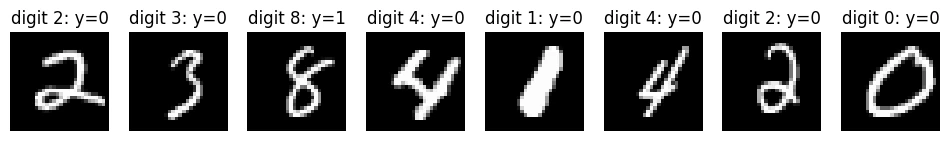
已保存的默认输入:官方 MNIST 训练图像,按本页固定索引取样,灰度除以 255,统一右移 2 像素、边界补零。图来自此前本地执行;不是叶片数据或生成数字。
源表示见过数字形态,却没用过这 640 个样本。已有表示是否有用、冻结是否足够、解冻越多是否越好,是三个不同问题。先选你预计最好的方案,并写一个可能推翻判断的结果。
TRAIN_LIMIT 控制训练量,DX 控制固定水平位移,EPOCHS 控制轮数;先运行默认值。三种迁移共用源检查点、新头初始化、批次顺序、优化器和预算。可更新参数与每步计算成本不同,不能称为等算力比较;从头训练检验起点的作用。改协议后就是新实验。
展开完整实现代码
TRAIN_LIMIT=256
DX=2
EPOCHS=4
BATCH_SIZE=64
LEARNING_RATE=0.002
SEED=20260917
with np.load(io.BytesIO(asset_bytes['target.npz']),allow_pickle=False) as z:
    target={k:z[k].copy() for k in z.files}
provenance=json.loads(asset_bytes['target-provenance.json'])
assert 16<=TRAIN_LIMIT<=256 and -4<=DX<=4 and EPOCHS>=1
x=torch.tensor(target['images'],dtype=torch.float32)/255
def shift_x(a,dx):
    b=torch.zeros_like(a)
    if dx>=0:b[:,:,:,dx:]=a[:,:,:,:a.shape[-1]-dx]
    else:b[:,:,:,:dx]=a[:,:,:,-dx:]
    return b
x=shift_x(x,DX)
y=torch.tensor((target['digit_labels']>=5).astype(np.int64))
train_idx=np.flatnonzero(target['split']==0)[:TRAIN_LIMIT]
val_idx=np.flatnonzero(target['split']==1)
heldout_idx=np.flatnonzero(target['split']==2)
train_x,train_y=x[train_idx],y[train_idx]
val_x,val_y=x[val_idx],y[val_idx]
assert len(set(target['official_train_ids']))==640
assert not set(train_idx)&set(val_idx) and not set(train_idx)&set(heldout_idx)
print('训练/验证/保留:',len(train_idx),len(val_idx),len(heldout_idx),'固定横移',DX)
print('训练标签计数',torch.bincount(train_y,minlength=2).tolist(),'验证标签计数',torch.bincount(val_y,minlength=2).tolist())
fig,axes=plt.subplots(1,8,figsize=(12,2))
for i,ax in enumerate(axes):
    ax.imshow(train_x[i,0],cmap='gray',vmin=0,vmax=1);ax.set_title(f'digit {target["digit_labels"][train_idx[i]]}: y={train_y[i].item()}');ax.axis('off')
plt.show()
2. “冻住”到底冻住哪些参数?
先沿一行读“从哪里开始”,再读“哪些部分会动”。 四行都是同一小 CNN 的二分类版本。
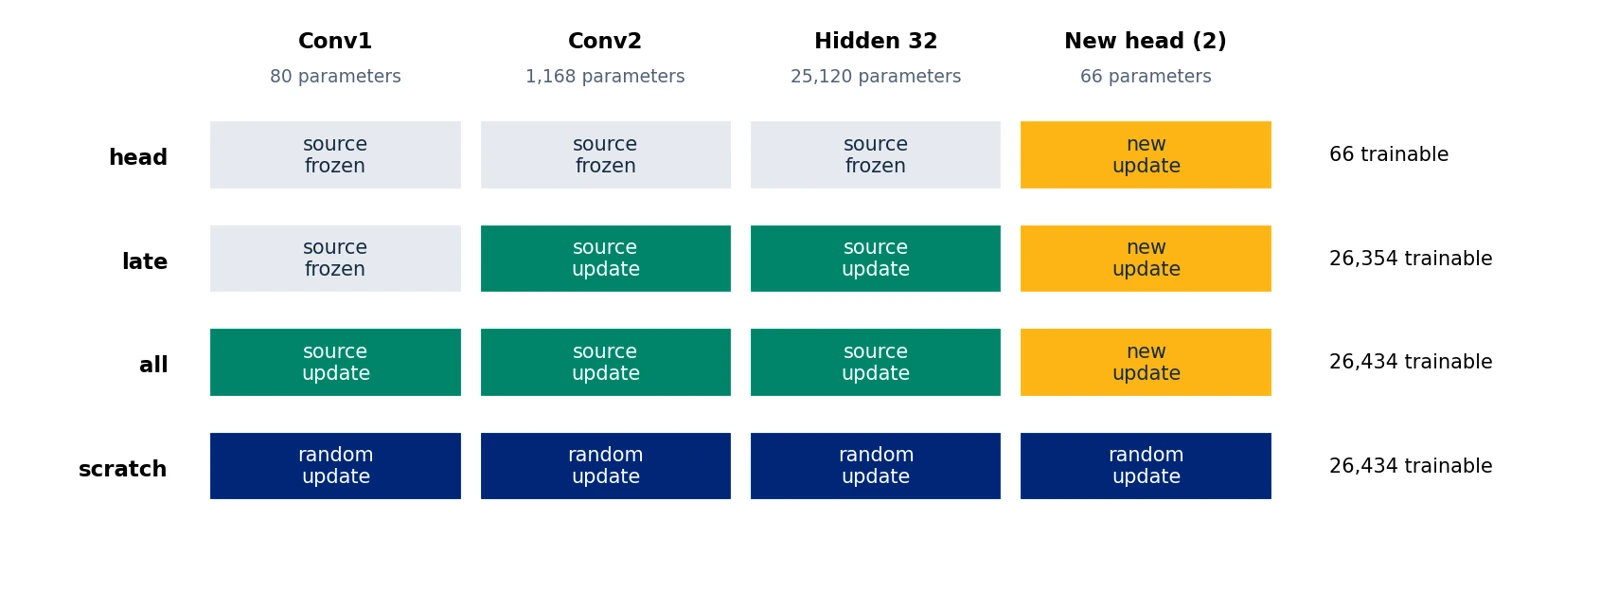
结构示意,由本页模型定义与参数计数绘制。灰:读取源参数并冻结;绿:读取源参数并更新;黄:新分类头;蓝:随机起点并更新。图中 66/26354/26434 是可更新参数数,尚不是效果。
head 只更新新头;late 更新第二卷积层、32 维隐藏层与新头;all 更新全部层。scratch 不读预训练权重。先核对: late 与 all 只相差 80 个可更新参数,它们对应图中的哪一块?为什么“少解冻一层”不一定意味着参数大幅减少?
代码会实际核对可更新参数。这个模型没有 BatchNorm 或 Dropout;含这些层时,冻结参数还需单独决定模式与状态,见第二讲 LAB05 · 经典架构与视觉表示与第二讲 LAB03 · 架构实验室。
展开完整实现代码
MODES=['head','late','all','scratch']
def make_target_model(mode):
    assert mode in MODES
    torch.manual_seed(SEED)
    model=make_cnn()
    if mode!='scratch':model.load_state_dict(source_state)
    torch.manual_seed(SEED+1)
    model.logits=nn.Linear(32,2)
    for name,param in model.named_parameters():
        param.requires_grad_(mode in ('all','scratch') or name.startswith('logits.') or (mode=='late' and name.startswith(('conv2.','hidden.'))))
    return model
scope_table=[]
for mode in MODES:
    model=make_target_model(mode)
    scope_table.append({'mode':mode,'trainable':sum(p.numel() for p in model.parameters() if p.requires_grad),'total':sum(p.numel() for p in model.parameters())})
print(json.dumps(scope_table,indent=2))
3. 运行比较:用验证集选每组的停点
先看一个真实的、可能推翻直觉的参考结果。 每轮结束冻结当前模型计算训练与验证交叉熵,各组保留验证交叉熵最低的检查点。
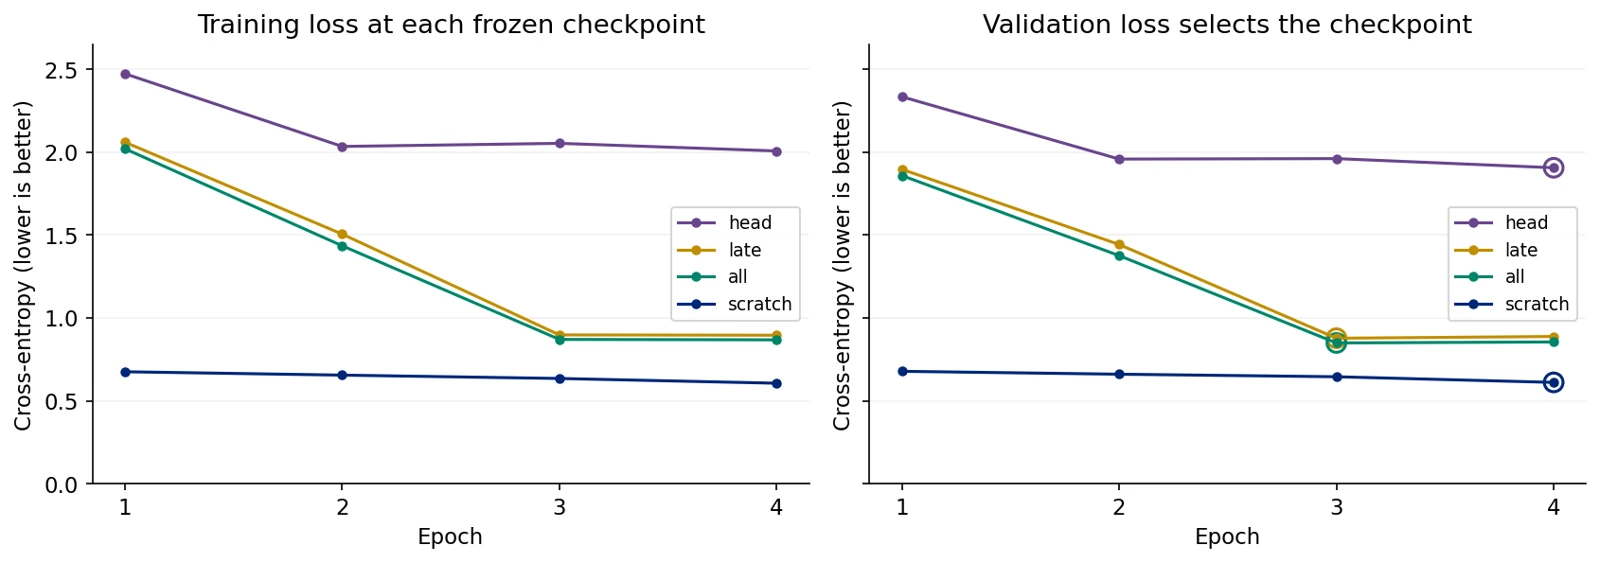
已保存本地运行:课件源检查点 ba8b738c…14eeba3,256 训练/128 验证,统一右移 2px,seed=20260917,Adam lr=.002,batch=64,各 4 轮。两图纵轴相同;右图空心圈是各组所选停点。最低验证 CE:head 1.906、late .877、all .849、scratch .611。本图读取已保存数值绘制;没有把它写成此次 Deepnote 云端输出。
先回答: 按预先写好的验证选择规则,这次应该选谁?scratch 获胜说明当前协议里预训练并未自动带来优势;它不能证明迁移普遍无效。短预算、相同学习率和这项特定二分类都限制结论。
下面会训练你的 4 个小模型,不覆盖既有源模型与课件响应。先保持默认协议核对,再进入最后的保留集评价;此时不能用保留结果回头挑更新范围。
展开完整实现代码
@torch.no_grad()
def evaluate_binary(model,xx,yy):
    model.eval();scores=model(xx)
    return {'ce':float(F.cross_entropy(scores,yy)), 'accuracy':float((scores.argmax(1)==yy).float().mean())}
torch.use_deterministic_algorithms(True)
generator=torch.Generator().manual_seed(SEED+2)
orders=[torch.randperm(len(train_y),generator=generator) for _ in range(EPOCHS)]
models={};records={}
for mode in MODES:
    model=make_target_model(mode)
    frozen_before={n:p.detach().clone() for n,p in model.named_parameters() if not p.requires_grad}
    optimizer=torch.optim.Adam([p for p in model.parameters() if p.requires_grad],lr=LEARNING_RATE)
    best_ce=float('inf');history=[];start=time.perf_counter()
    for epoch,order in enumerate(orders,1):
        model.train()
        for ids in order.split(BATCH_SIZE):
            optimizer.zero_grad();loss=F.cross_entropy(model(train_x[ids]),train_y[ids]);loss.backward();optimizer.step()
        tr=evaluate_binary(model,train_x,train_y);va=evaluate_binary(model,val_x,val_y)
        history.append({'epoch':epoch,'train_ce':tr['ce'],'val_ce':va['ce'],'val_accuracy':va['accuracy']})
        if va['ce']<best_ce:
            best_ce=va['ce'];best_state=copy.deepcopy(model.state_dict());selected=epoch
    elapsed=time.perf_counter()-start
    model.load_state_dict(best_state)
    for name,param in model.named_parameters():
        if name in frozen_before: assert torch.equal(param.detach(),frozen_before[name]),name
    models[mode]=model
    records[mode]={'selected_epoch':selected,'train':evaluate_binary(model,train_x,train_y),
                   'validation':evaluate_binary(model,val_x,val_y),'seconds':elapsed,'history':history}
fig,axes=plt.subplots(1,2,figsize=(10,3.5),sharey=True)
for mode,r in records.items():
    axes[0].plot([v['epoch'] for v in r['history']],[v['train_ce'] for v in r['history']],label=mode)
    axes[1].plot([v['epoch'] for v in r['history']],[v['val_ce'] for v in r['history']],label=mode)
    chosen=next(v for v in r['history'] if v['epoch']==r['selected_epoch'])
    axes[1].scatter([chosen['epoch']],[chosen['val_ce']],facecolors='none',edgecolors=axes[1].lines[-1].get_color(),s=75,zorder=3)
ymax=max(v[key] for r in records.values() for v in r['history'] for key in ('train_ce','val_ce'))
axes[0].set_ylim(0,max(ymax*1.05,1e-8))
axes[0].set_ylabel('Cross-entropy (same scale)')
axes[0].set_title('training CE');axes[1].set_title('validation CE')
for ax in axes:ax.set_xlabel('epoch');ax.legend()
plt.tight_layout();plt.show()
print(json.dumps({m:{k:v for k,v in r.items() if k!='history'} for m,r in records.items()},indent=2))
4. 固定选择后,再看保留集
先根据验证交叉熵选方案,再运行下格。在这个教学本中你可以看到所有候选的保留结果,但它们只作评价,不能回头选择学习率、轮数、位移或报告最漂亮的一次。
计时是当前环境的一次实测,不是稳定性能基准;同轮数也不等于同计算量。小数据、单种子和相近领域限制了结论,不能直接外推到叶片。
展开完整实现代码
selected_mode=min(records,key=lambda m:records[m]['validation']['ce'])
for mode,model in models.items():
    records[mode]['heldout']=evaluate_binary(model,x[heldout_idx],y[heldout_idx])
print('只按验证 CE 选出的方案:',selected_mode)
print('mode | train acc | val acc | heldout acc | selected epoch')
for mode,r in records.items():
    print(mode,round(r['train']['accuracy'],4),round(r['validation']['accuracy'],4),round(r['heldout']['accuracy'],4),r['selected_epoch'])
LAB09_RESULT={'provenance':provenance,'protocol':{'train_n':TRAIN_LIMIT,'dx':DX,'epochs':EPOCHS,'batch_size':BATCH_SIZE,'learning_rate':LEARNING_RATE,'seed':SEED},
              'selected_by_validation':selected_mode,'scopes':scope_table,'records':records}
print('LAB09_RESULT_JSON='+json.dumps(LAB09_RESULT,ensure_ascii=False))

(OUT/'transfer-results.json').write_text(json.dumps(LAB09_RESULT,ensure_ascii=False,indent=2))
# 当前单元无法确认宿主平台或是否使用全新进程;unknown 不等于 False。
verification={'local_run':'unknown','cloud_run':'unknown','source_model_unchanged':hashlib.sha256(MODEL_PATH.read_bytes()).hexdigest()==model_sha256,'source_checkpoint_sha256':model_sha256,'sample_split_independent':True,'selected_by_validation':selected_mode,'scope':'complete student/teacher re-execution of 4 small transfer arms','torch':torch.__version__}
(OUT/'verification.json').write_text(json.dumps(verification,indent=2))
5. 回到叶片任务:哪些判断可以迁移,哪些不能?
可以带走的是比较方法:同一个起点、明确新标签、独立划分、固定更新范围、验证选择、保留集评价。不能带走的是本数字实验的准确率或最佳方案。
给叶片实验写一张下一步表:预训练来源及输入处理、按叶片/来源分组的划分、只训练新头的起点、解冻候选、评价指标、预算、会推翻当前选择的证据。保持结果栏为空,直到真实叶片数据和运行结果存在。
继续一步:把训练样本改为64,或把DX改为0,只改一项并重新运行第1节起的所有单元。先记预测,再比较训练/验证间距。第二轮之后保留集已被看过,探索结果应如实记录,正式报告需要重新预先固定评价协议。
来源:既有 LAB02 v2 检查点与官方 MNIST 训练文件,准确索引和文件哈希已内置;本页二分类比较不复用旧准确率作为新输出。MNIST 来源 · 历史 L02-LAB 02 源模型与训练记录。
返回第三讲:主讲:三种更新范围 · CLS 01 · 学习信号、表示与迁移 · 统一导读。
旧第二讲 LAB 09 兼容入口保留作历史兼容;当前学习路径以上面的第三讲入口为准。
返回课程:第三讲导读 · 当前迁移主讲。旧第二讲 LAB 09 兼容入口保留作历史兼容。感受野与响应观察已拆回第二讲参考,不要求先完成它才能运行迁移。
6 · 选读:参数、梯度记录和模块状态
迁移可以只训练新分类头、解冻后部,或整体微调。应固定数据划分与评价指标,使用相同预算或明确记录预算差异;训练集很小时,也要把冻结表示的简单读出作为基线。
三个开关控制不同对象:
| 开关 | 改变什么 | 不自动保证什么 |
|---|---|---|
| model.eval() | BN、Dropout 等模块的模式 | 不关闭自动求导 |
| torch.no_grad() | 作用域内的梯度图记录 | 不切换 BN/Dropout 模式 |
| parameter.requiresgrad(False) | 指定参数是否需要梯度 | 不冻结 BN 的运行统计 |
例如冻结 backbone 权重后,若它仍处于 train 模式,BN buffers 可能继续变化,Dropout 也可能继续随机屏蔽。普通预测常同时使用 eval 与 no_grad;输入梯度可视化可能需要 eval,但必须保留输入的梯度记录。应按任务组合开关,而非背一个通用模板。
本节扩展了课后 BN 状态知识,主讲结课不以掌握这些 API 差异作为所有学生的通过条件。
先判断:为了画输入敏感性图,先调用 eval() 是否会导致无法求输入梯度?
核对提示:不会。eval 只切换特定模块模式;只要记录计算图并让输入 requiresgrad=True,仍可求梯度。若放在 nograd 作用域内,才会丢失需要的记录。
来源与继续阅读