1. 训练闭环没有换,先问答案从哪里来
第二讲用一个具体闭环连接图像、网络、类别预测、人工标签、损失和参数更新。ImageNet 分类预训练让同一个网络读过大量图像,并从分类错误中调整表示。今天先保留这个闭环,把注意力放到标签:更多图片,是否意味着我们已经获得更多合适的训练题?
一张桌面图可以被标为“室内”,也可以要求框出两个杯子,还可以要求逐像素区分杯与桌面。这三种答案需要不同的判断与标注劳动。把粗类别集合拼在一起也不会自动得到细粒度答案:只标“杯子”的数据无法直接告诉我们哪一个是红杯。
2016 年的同期访谈中,Scale 共同创始人 Lucy Guo 与 Alexandr Wang 介绍了将人工任务、人员组织与质量控制包装成可调用服务的做法;任务包括分类、数据提取等。这段经历说明,监督供给也有组织与工程问题。同期访谈
一条路线是把人的判断组织得更有效;另一条路线是重新设计训练任务,让已有数据提供一部分答案。我们先借文字看看后一条路线怎样成立。
2. 同一段文字,两种可见条件
使用同一句话:The red cup is on the table.。这里用 The / red / cup / is / on / the / table / . 作为教学 token;实际 tokenizer 未必这样切。位置决定“当前预测的是哪一项”,可见条件决定模型能利用哪些信息。
| 任务 | 本次看见什么 | 目标从哪里取得 | 反馈怎样产生 |
|---|---|---|---|
| 从左到右预测 | The / red / cup |
原文下一个 token is |
提高正确 token 的预测概率 |
| 遮词预测 | The / red / [MASK] / is / on / the / table / . |
原文被遮住的 cup |
比较遮住位置的预测与目标 |
遮词可利用左右两侧,左到右预测不能提前看后文。两者都从已有文本构造目标;人仍参与文本写作、数据选择和任务设计。
回到从左到右预测:一个输出 token,成为下一步条件。 使用时,先由 The / red / cup 预测一个 token;选出 is 后,将它接到前文,再预测 on。训练时原文已经给出目标,使用时接入的是模型选出的 token,这两种过程要区分。
这里不需要展开 Q/K/V:先抓住 token、位置、可见条件、目标和逐步输出。自回归语言建模:GPT-2 技术报告 · BERT
3. 有了很多训练题,怎样把它们学完?
扩大数据覆盖,可能让表示遇到更丰富的对象与条件;扩大模型,可能提高拟合复杂规律的能力。两者是否值得取决于数据质量、训练预算和用途。固定预算时,大模型每步更贵;更多数据也不等于每个样本都能得到充分训练。
旧材料中 ViT 原文 Table 5 的比较仍可帮助判断:在 ImageNet 微调、384 输入的条件下,ImageNet 预训练的 ViT-B/16 与 L/16 为 77.91% 与 76.53%;换成 ImageNet-21k 预训练为 83.97% 与 85.15%。模型变大并不在所有预训练条件下获益。数据分布和标签也变了,不能把全部差异只归因于图片数。ViT 原文
计算组织依次面对三个问题:每一步算得太慢 → 一份训练状态装不下 → 分摊之后如何交换信息。它们分别改变“谁处理数据”“谁保管状态”和“计算前后谁要拿到什么”。
活动 A:两个设备怎样执行同一次更新?
两边从同一参数 θ=[1,2] 出发,处理不同且等大小的本地批次。各自对本地样本损失取平均,得到 g₁=[2,4]、g₂=[6,0]。全局平均梯度为 [4,2],学习率 0.1,所以两边都更新到 θ′=[0.6,1.8]。
动作是先合并梯度,再把同一个合并结果交给每份模型;这种集合通信通常称作 all-reduce。如果每份模型分别沿局部梯度走一步,它们就不再相同。
先预测: 把第二个本地批次从 2 个样本改成 6 个,同样等权平均还对应全体样本的平均损失吗?运行下面代码,再改局部梯度和样本数。静态答案:等权时 [0.6,1.8];样本数 2:6 时全局梯度 [5,1],共同参数 [0.5,1.9]。这是确定性算例。
# 独立 CPU 练习;每个局部梯度对应本地样本平均损失。
import math
theta = [1.0, 2.0]
local_gradients = [[2.0, 4.0], [6.0, 0.0]]
learning_rate = 0.1
def common_update(batch_sizes):
    total = sum(batch_sizes)
    gradient = [sum(n*g[j] for n,g in zip(batch_sizes,local_gradients))/total for j in range(2)]
    updated = [x-learning_rate*g for x,g in zip(theta,gradient)]
    return gradient, updated
for sizes in ([2,2], [2,6]):
    gradient, updated = common_update(sizes)
    print('本地样本数', sizes, '全局平均梯度', gradient, '共同参数', updated)
assert all(math.isclose(a,b) for a,b in zip(common_update([2,2])[1], [0.6,1.8]))
assert all(math.isclose(a,b) for a,b in zip(common_update([2,6])[1], [0.5,1.9]))
保存的本地 CPU 输出(2026-09-22):
本地样本数 [2, 2] 全局平均梯度 [4.0, 2.0] 共同参数 [0.6, 1.8]
本地样本数 [2, 6] 全局平均梯度 [5.0, 1.0] 共同参数 [0.5, 1.9]
状态装不下:共享数据还不够
普通数据并行让不同设备看不同数据,但每个设备仍保存模型的权重、梯度以及优化器状态。Adam 的一阶矩与二阶矩是随训练更新的状态;β₁、β₂是决定更新规则的超参数,两者不要混成一件东西。
考虑把参数索引 0–3 归设备甲、4–7 归设备乙保管。一次分片训练可按这样的信息流理解:
- 即将计算某一层时,从拥有者取齐这一层需要的权重分片(all-gather)。
- 本地数据完成前向与反向,产生梯度贡献。
- 将各设备的梯度贡献合并,并把合并后的每一片交给其拥有者(reduce-scatter)。
- 拥有者用自己保管的梯度、优化器状态更新该片权重;下次计算需要时再收集。
这是帮助理解完全分片的一次信息流;具体实现会选择预取、缓存或重新收集。分片降低每个设备持有的状态量,但数据移动、同步和等待成为成本。不能仅凭总显存判断训练速度。ZeRO 原论文
计算资源让我们完成更多训练,但它不会替我们决定图像里应当学什么。文字提供了一种预测组织;图像中,我们需要构造哪些关系?
4. 第一条视觉路线:同一图像的两个视图
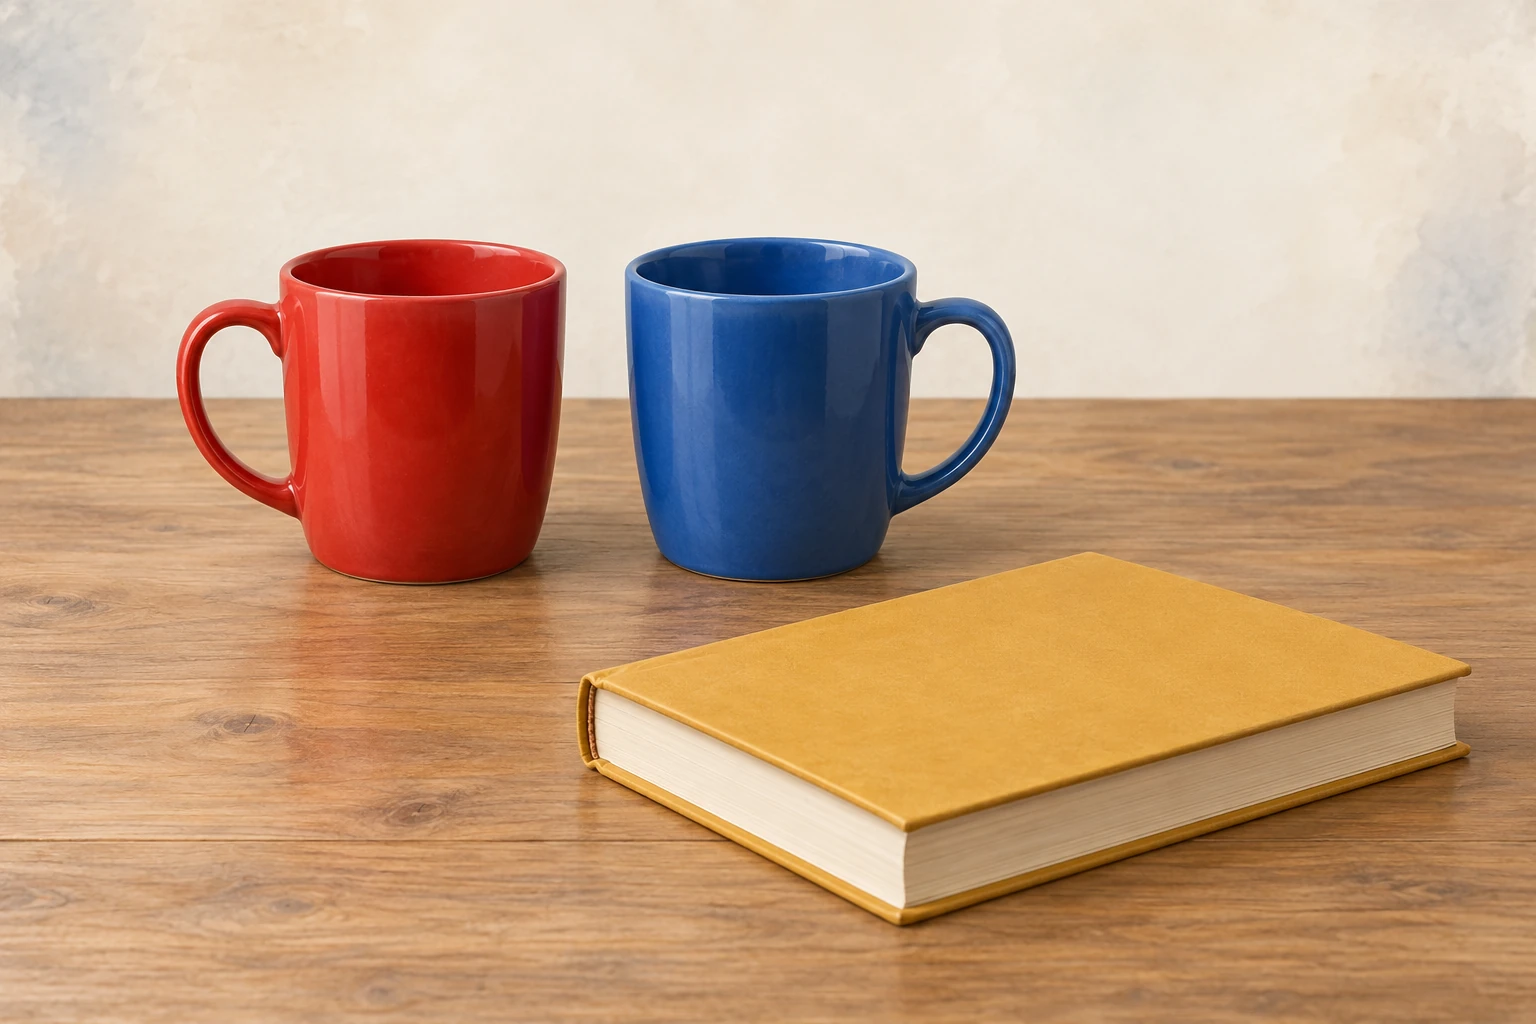
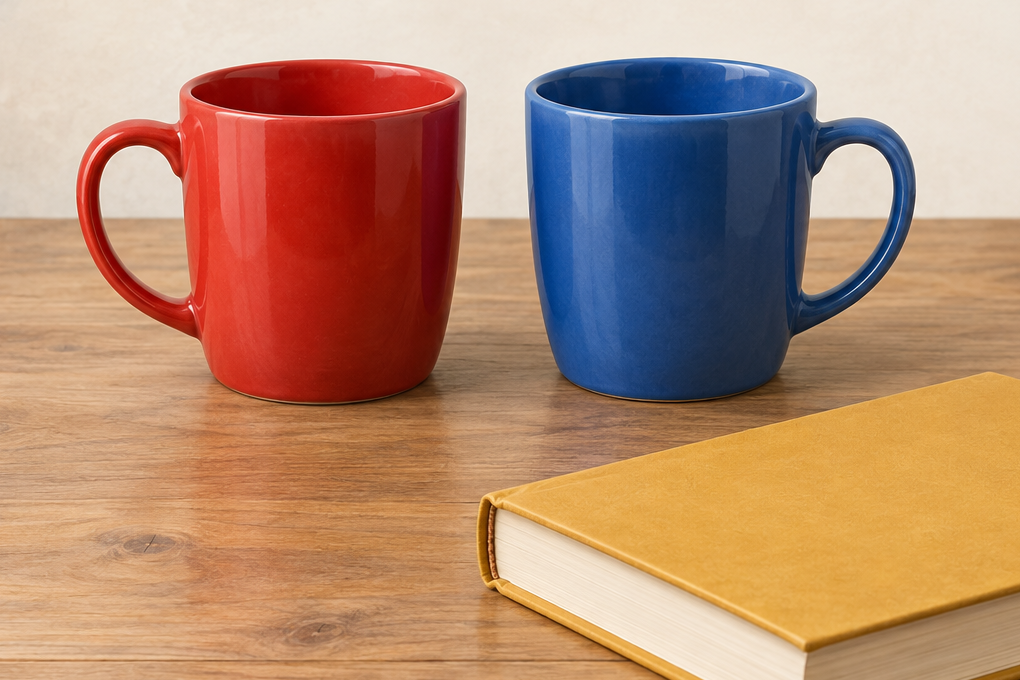
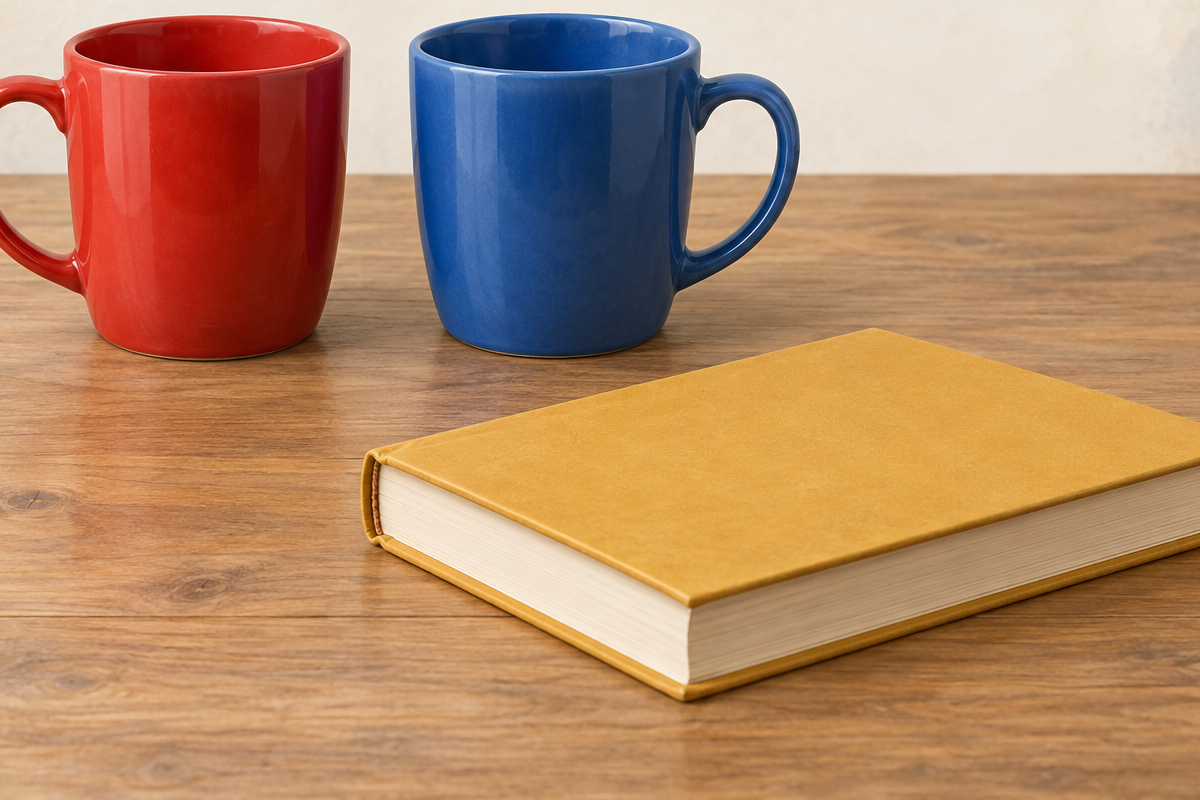
同一源场景的裁剪与变换,用于观察训练配对;图中的相似关系是任务设定。
对一张桌面照片做两种变换,产生查询视图 q 与对应的 key 视图 k⁺。同一照片提供正配对,不要求先写“杯子”标签。来自另一张照片的 key 可以进入比较字典,但它也可能拍了同一种杯子;“不同图像”不等于“不同语义类别”。
对归一化向量,点积可作相似度。MoCo 的目标让正确配对在字典里得到较高相对分数:
ℓ = −log [ exp(qᵀk⁺/τ) / (exp(qᵀk⁺/τ) + Σ exp(qᵀk⁻/τ)) ]
τ 决定分数进入 softmax 后的尖锐程度。目标关心的不是所有向量无条件相同,而是指定正配对相对候选更容易找回。MoCo
看图后先预测: 若两个裁剪都保留杯子但桌面背景不同,系统被要求忽略什么?若其中一张只剩桌面,正配对又要求了什么?
活动 B:八个槽位记住的是什么?
MoCo 把近期 key 特征放进先进先出队列。八个槽位最初为 [a0,a1,b0,b1,c0,c1,d0,d1]。本批加入 [e0,e1] 后,最老的 [a0,a1] 离开,成为 [b0,b1,c0,c1,d0,d1,e0,e1]。队列保存的是当时算好的特征及其身份,不是每步重新编码全部旧图片。
旧 key 与新 query 的坐标系变化太快,会让字典难以比较。键编码器用查询编码器的参数做移动平均:
θk ← m θk + (1−m) θq
取 m=0.9、原 θk=[0,2]、当前 θq=[2,4],得到新 θk=[0.2,2.2]。平均的是网络参数;查询编码器仍由梯度学习。这不是优化器中的梯度动量,也没有把旧队列重算成新特征。
先预测: 再加入两项后哪些身份离开?把 m 改为 0 或 1 各会怎样?运行下格并解释队列长度与变化速度如何分别被两种设计控制。
# 独立 CPU 机制;追踪特征身份,不进行图像模型训练。
from collections import deque
queue = deque(['a0','a1','b0','b1','c0','c1','d0','d1'], maxlen=8)
m = 0.9
key_theta = [0.0,2.0]
query_theta = [2.0,4.0]
print('更新前:', list(queue))
for batch in (['e0','e1'], ['f0','f1']):
    key_theta = [m*k+(1-m)*q for k,q in zip(key_theta,query_theta)]
    queue.extend(batch)
    print('加入',batch,'→',list(queue),'key参数',[round(x,4) for x in key_theta])
assert list(queue)==['c0','c1','d0','d1','e0','e1','f0','f1']
assert all(abs(a-b)<1e-12 for a,b in zip(key_theta,[0.38,2.38]))
保存的本地 CPU 输出(2026-09-22):
更新前: ['a0', 'a1', 'b0', 'b1', 'c0', 'c1', 'd0', 'd1']
加入 ['e0', 'e1'] → ['b0', 'b1', 'c0', 'c1', 'd0', 'd1', 'e0', 'e1'] key参数 [0.2, 2.2]
加入 ['f0', 'f1'] → ['c0', 'c1', 'd0', 'd1', 'e0', 'e1', 'f0', 'f1'] key参数 [0.38, 2.38]
SimCLR:同一目标也可以用不同计算组织
SimCLR 使用当前批次里的两视图进行比较,较大的批次给每个查询提供更多候选;MoCo 的队列把候选规模与当前批次大小部分解耦。两者在特征身份、存储与计算成本上有不同取舍。
沿 x → f → h → g → z 追踪一次训练:f 是编码器,h 是其输出;g 是投影头,z 是用于对比目标的空间。损失计算在 z,梯度仍穿过 g 回到 f。 迁移时可以读取 h,所以训练目标空间与下游读出空间不必相同。
论文中的取舍不是一条版本升级链。MoCo 在 2019 年公开,SimCLR 在 2020 年公开;后续 MoCo v2 借鉴了包括投影头在内的设计。SimCLR · MoCo v2
5. 第二条视觉路线:只看四块,预测其余位置
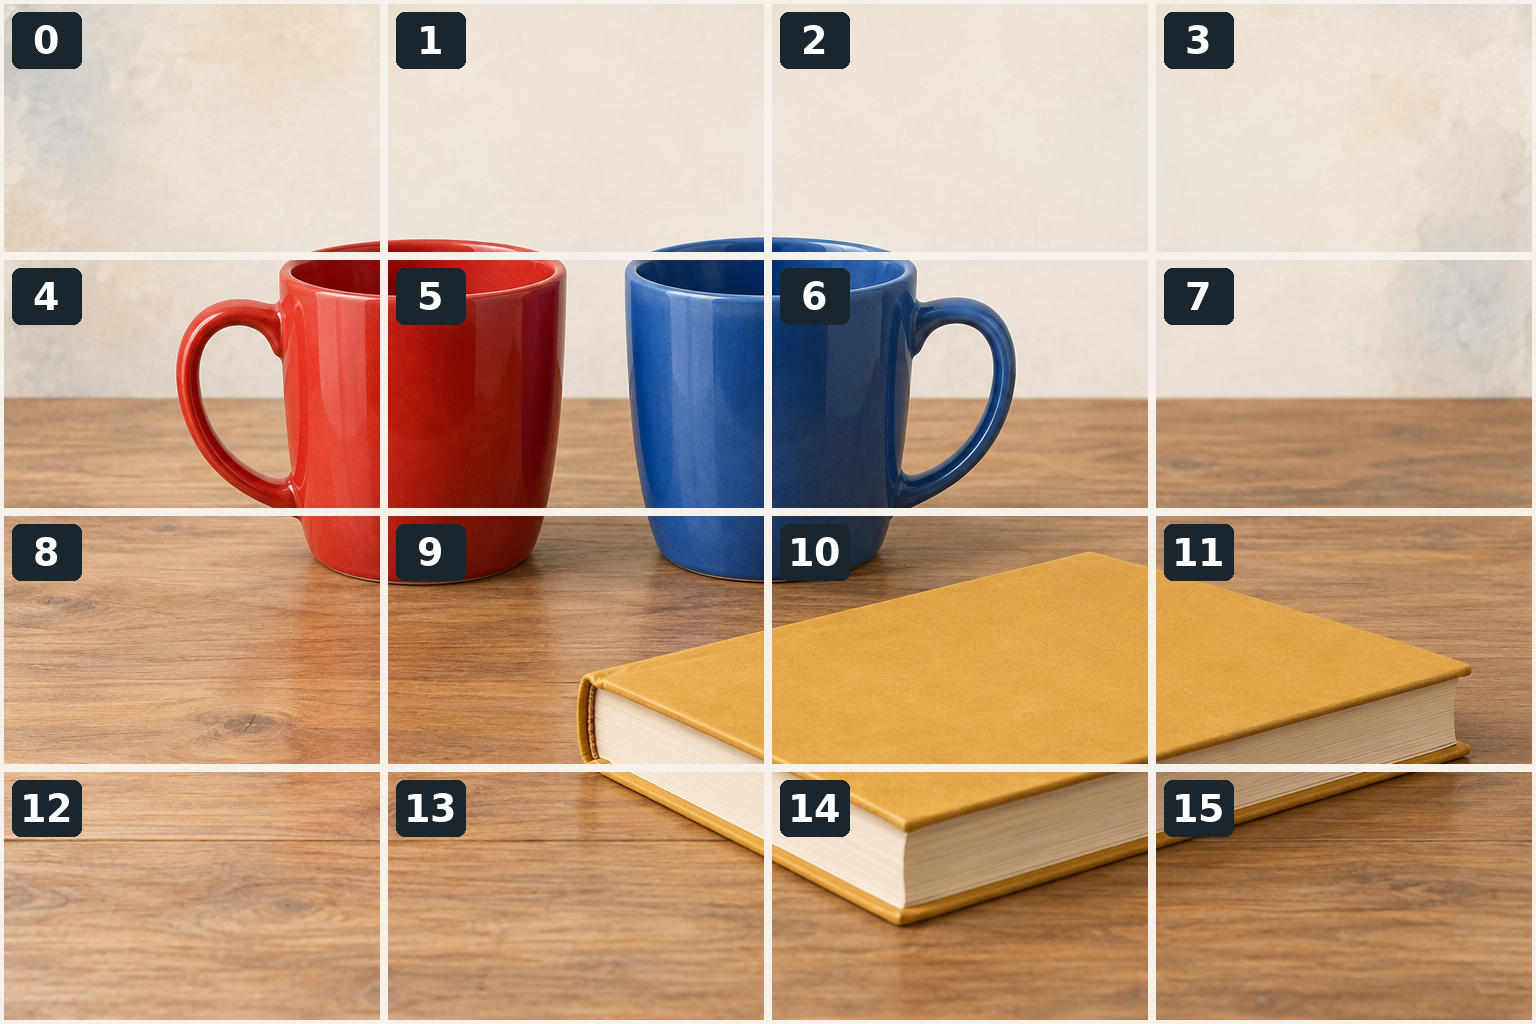
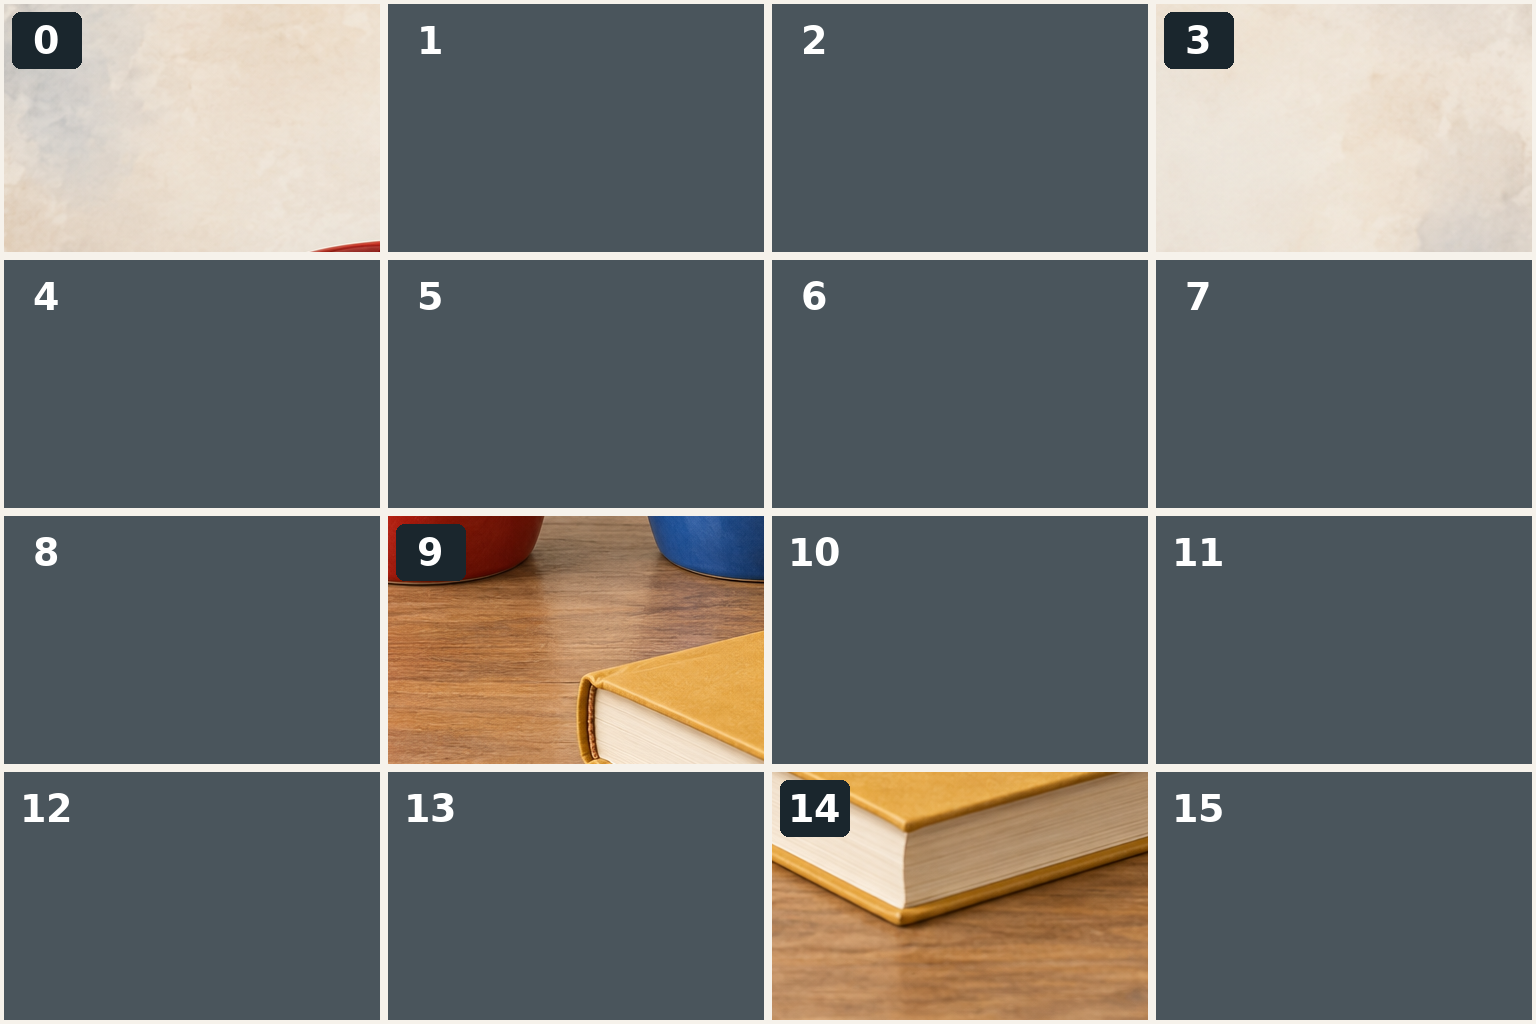
16 块位置示意:可见位置为 0、3、9、14;其余是要预测的位置。完整源图提供目标,图中不展示虚构模型补全。
MAE 把图像分成 4×4 的 16 块。这个教学例子保留 4 块,遮住 12 块:编码器只读取可见块及其位置;轻量解码器将可见表示放回正确位置,再在缺失处插入 mask token,构成完整位置序列。隐藏位置的预测与原图相应位置比较,形成训练损失。训练之后主要保留编码器服务识别任务。MAE
先预测: 如果把相同四块的位置信息拿走,解码器还知道它们来自左上还是右下吗?把可见集合改为相邻四块,对推测全图会有什么影响?
对比目标强调变换后的关系;遮挡目标要求可见内容支持缺失内容预测。两种路线都有可能得到可复用表示,也都有选择代价:强变换可能删掉任务线索,重建可能把资源用在下游并不关心的纹理上。
# 独立 CPU 练习:改变 visible 或 crop,观察位置与目标集合。
visible = {0,3,9,14}
crop = (0,0,4,4)  # 网格坐标 (左,上,右,下),右/下边界不含;可改为 (0,0,2,4)
assert visible <= set(range(16))
left,top,right,bottom = crop
assert 0 <= left < right <= 4 and 0 <= top < bottom <= 4
retained = {4*r+c for r in range(top,bottom) for c in range(left,right)}
encoder_positions = sorted(visible & retained)
masked_positions = sorted(retained-visible)
print('编码器读入位置:',encoder_positions)
print('损失比较位置:',masked_positions)
print('解码器位置表:')
for r in range(4):
    print(['OUT' if 4*r+c not in retained else (str(4*r+c) if 4*r+c in visible else 'MASK') for c in range(4)])
if crop == (0,0,4,4):
    assert len(encoder_positions)==4 and len(masked_positions)==12
print('这些是输入/目标位置;这里没有训练或执行重建模型。')
保存的本地 CPU 输出(2026-09-22):
编码器读入位置: [0, 3, 9, 14]
损失比较位置: [1, 2, 4, 5, 6, 7, 8, 10, 11, 12, 13, 15]
解码器位置表:
['0', 'MASK', 'MASK', '3']
['MASK', 'MASK', 'MASK', 'MASK']
['MASK', '9', 'MASK', 'MASK']
['MASK', 'MASK', '14', 'MASK']
这些是输入/目标位置;这里没有训练或执行重建模型。
6. 什么变化应该忽略,哪些差别必须留下?
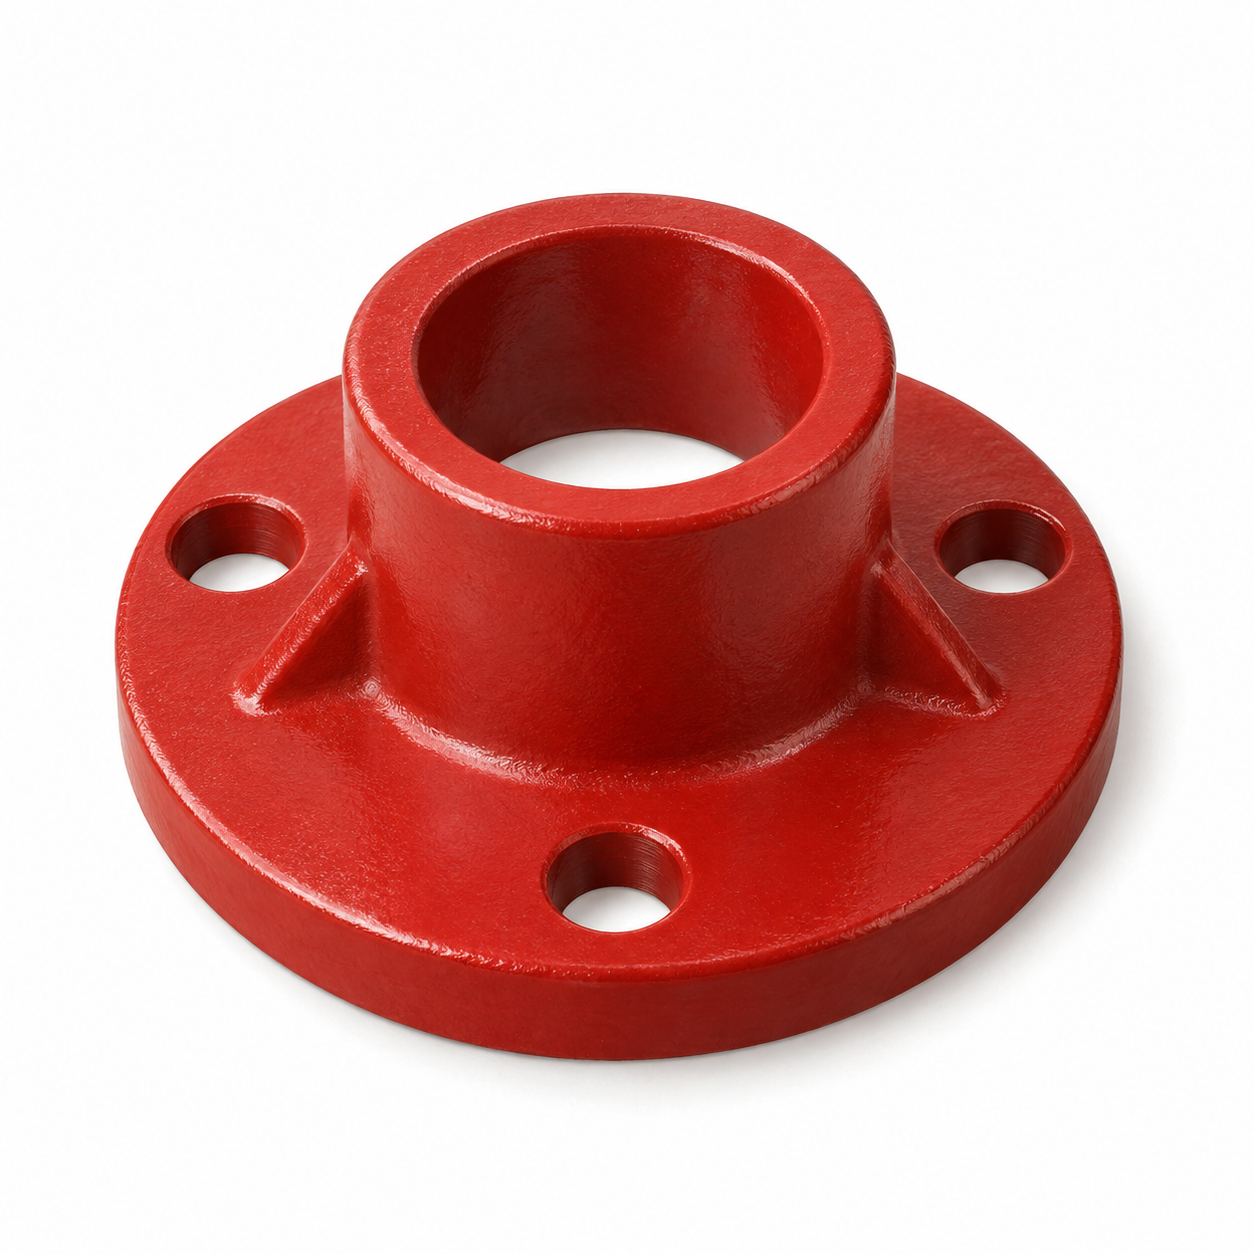
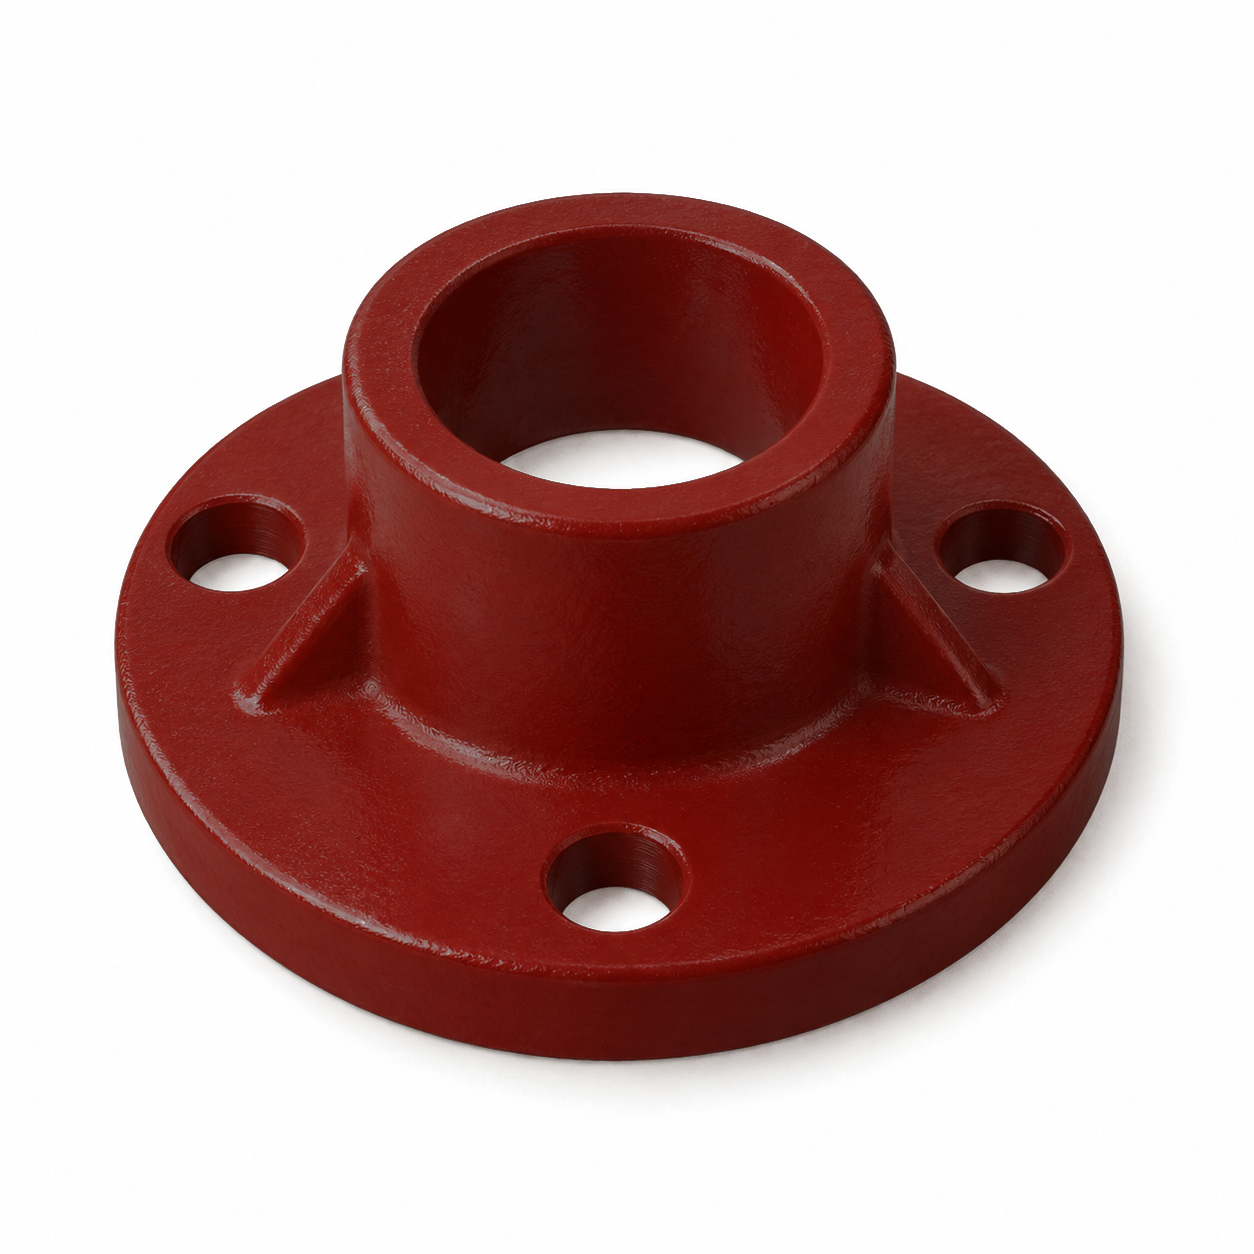
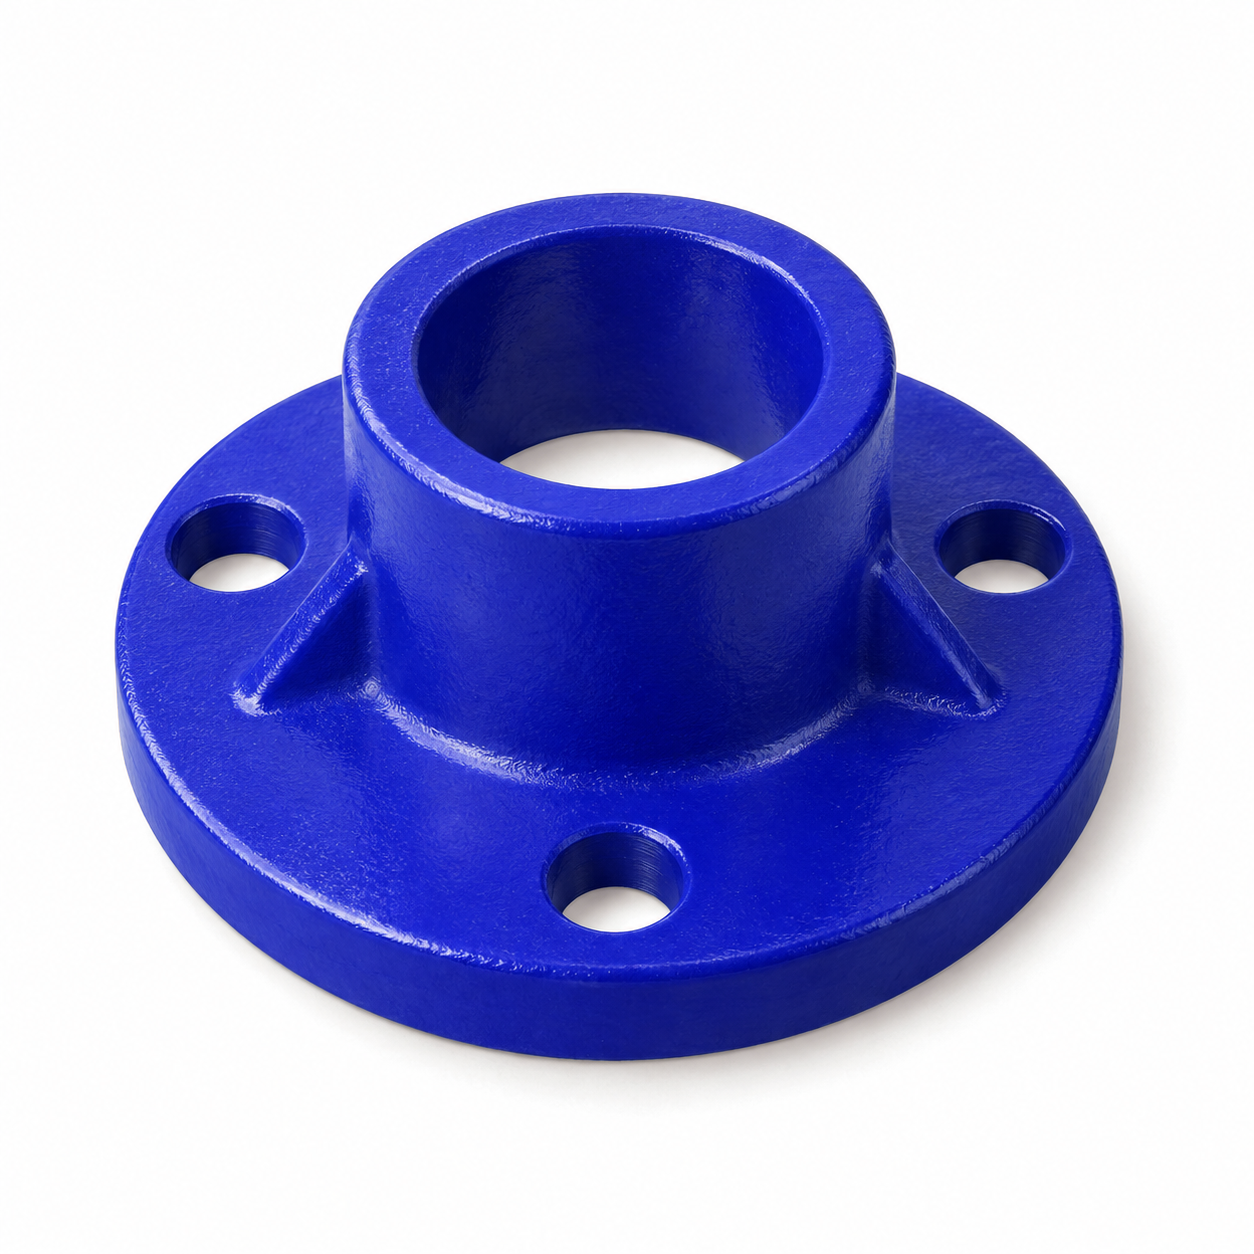
同型号红蓝零件的增强情境;受控光强和色相变换用于讨论任务答案是否保持。
设下游要区分红色与蓝色的同型号零件。轮廓、孔位都一样,颜色才决定标签。整体无色光强变化可以改变“有多亮”而保持颜色关系;强色相变化却可能把红变蓝。把它们都统称为“颜色增强”,会掩盖两者对任务的不同含义。
现在固定编码器,只给少量标签训练一个线性读出。问题可以拆为三步:
- 结构是否允许保存颜色差异?一个多通道张量可以容纳它。
- 训练实际是否保留颜色差异?要求强色相不变的目标可能使它被忽略。
- 读出器能否使用已保留的信息?信息存在,不保证一条线性边界就能取出来。
先作判断: 对这个任务选哪一种变换?然后说明用什么误例或读出比较来改变判断。答案不依赖“增强越强越好”,而依赖最终要保留的差别。
四点 XOR:读不出来,不一定是没留下
四个表示 h 为 (−1,−1)、(−1,+1)、(+1,−1)、(+1,+1)。同号的两点标签为 0,异号的两点为 1。每一点都不同,标签信息并未因碰撞而消失,但这两组对角点不能被一条直线完全分开。
加一个确定性非线性特征 z=h₁×h₂ 后,同号为 +1、异号为 −1,一维阈值就能分开。这只构造了“表示与读出一起决定可用性”的例子;它不主张真实 SimCLR 的投影头必然学成这个乘法。
静态结果:原四点各有身份;新特征为 [+1,−1,−1,+1],用 z<0 读取标签得到 [0,1,1,0]。这也解释为什么需要同时报告冻结线性评价与允许非线性适配的评价。
# 独立 CPU XOR 检查;这里的变换是手工构造。
h = [(-1,-1),(-1,1),(1,-1),(1,1)]
y = [0,1,1,0]
z = [a*b for a,b in h]
prediction = [int(v<0) for v in z]
assert prediction == y
assert tuple((h[0][j]+h[3][j])/2 for j in (0,1)) == (0,0)
assert tuple((h[1][j]+h[2][j])/2 for j in (0,1)) == (0,0)
print('h:',h,'手工非线性特征:',z,'阈值读出:',prediction)
print('两类凸包都包含原点;因此原空间不存在严格分开两类的直线。')
保存的本地 CPU 输出(2026-09-22):
h: [(-1, -1), (-1, 1), (1, -1), (1, 1)] 手工非线性特征: [1, -1, -1, 1] 阈值读出: [0, 1, 1, 0]
两类凸包都包含原点;因此原空间不存在严格分开两类的直线。
7. 表示确实可以复用:看一个下游例子
MoCo 原论文 Table 2(b) 将在 ImageNet-1M 上预训练的 ResNet-50-C4 接入 Faster R-CNN,再用 PASCAL VOC trainval07+12 的检测标注全层微调 24k 次。在 test2007 上取 5 次实验平均,COCO 式 box AP 为:有监督预训练 53.5,MoCo 预训练 55.9。原文 Table 2(b) 与 §4.2.1
这里的积极证据是:通过视图对比学习的编码器可以适配对象检测,在这套明确协议下提供了有用起点。两组下游微调方案相匹配;检测头和主干都接受目标任务监督,这不是“冻结后自动会检测”,也不表示预训练与下游合计预算被完全配平。
这也自然引出下一部分:用哪一种目标预训练,与最后要输出类别、框还是掩码,是可以分别设计的两个问题。
两个主线实验,各回答一个问题
| 入口 | 保持什么 | 改变什么 | 观察什么 |
|---|---|---|---|
| L03-LAB 01 · 固定表示:标签预算与读出 | 已有 CNN 与缓存特征 | 标签预算、kNN/linear 读出 | 少量标签能读出什么,错在哪里 |
| L03-LAB 02 · 参数迁移:冻结、局部与全量微调 | 同一源 checkpoint、目标划分与任务 | 允许更新的参数范围;另有 scratch 对照 | 适配收益是否值得额外更新 |
Lab 01 使用已有有监督 CNN 表示。Lab 02 的实际情境是 MNIST 十分类参数迁移到“数字是否≥5”的二分类,不把数字实验读成自然场景检测结果。历史训练与缓存可直接阅读,无需先重训模型。
比较时固定样本划分、标签预算和评价指标,由验证集选择超参数与训练停点。含 BatchNorm 的网络还要分别决定权重、运行统计与 train/eval 状态;冻结权重不自动冻结一切。更充分的实验条件和原结果留在各 Lab。
8. 从可用表示,转向对象的位置与边界
我们已经看到几种训练表示的方法:人工标签、从文本构造目标、图像视图关系、遮挡重建。计算组织使训练可实施,用途检验表示价值。
现在固定一份可用的视觉表示,改变要求:不只判断画面里有什么,还要找到每个对象的位置与边界。 历史上的 R-CNN 从有监督分类预训练出发,再用检测数据适配;检测并不以自监督为前提。
接下来追问:哪些计算可以复用,哪些空间信息必须留下,新的输出需要怎样的训练?
选择一个继续入口: 到 L03-CLS 02 看同一桌面场景的四种输出;到 L03-LAB 01 / 02 阅读已有真实结果;对无标签学习的前史感兴趣,可打开 L03-LAB 05,看 Lloyd 如何实际拟合 patch 词典。
把关系放回图中
左右滑动查看完整图解 ↔
左右滑动查看完整图解 ↔
左右滑动查看完整图解 ↔