MAE 让昂贵编码器只看少量位置
按问题继续
词典/PCA数值、线性自编码约束、遮挡索引、masked ConvAE与MAE区别
MAE 让昂贵编码器只看少量位置
把图像切为 patch 后,MAE 随机选择可见子集,编码器只处理可见 patch 及其位置;轻量解码器补入 mask token,恢复完整位置顺序,再预测被遮挡的像素目标。原 MAE 的一个关键设计是高遮挡率与这种不对称编码—解码结构,见 MAE §3 与图 1。这里不是先让编码器看完整图,再在输出端涂黑几块。
四个原始位置是 [0,1,2,3]。随机排列 ids_shuffle=[2,0,3,1],只保留前两项,所以编码器看到原位置 2、0。解码器先得到 [z2,z0,M,M],再用逆排列 ids_restore=[1,3,0,2] 取回 [z0,M,z2,M]。位置 1、3 的损失可以按
计算,其中 为遮挡位置集合。若补 mask 后忘记恢复顺序,即便预测数值合理,也是在与错误位置的目标比较。排列练习可以证明索引正确;它不能证明编码器已经学会图像语义。
再看计算:16 个 patch 只保留 4 个,编码器注意力的成对位置数由 变为 ,这是二次项的 1/16;线性层、patch embedding、解码器和实际硬件开销不按同样比例缩小。因此不能把这个比例直接称为端到端加速 16 倍。高 mask 比例同时改变任务难度与编码成本,需要一起讨论。
| 方法 | 输入受什么限制 | 代码/表示约束 | 重建好能支持什么判断 |
|---|---|---|---|
| K-means 词典 | 通常看到完整 patch | 一个中心索引 | 该词典的量化误差小 |
| PCA | 通常看到完整向量 | 低维线性子空间 | 方差被线性子空间有效保留 |
| 去噪自编码器 | 看到明确破坏后的图 | 架构、瓶颈及正则化 | 对指定破坏能恢复保留图像 |
| MAE | 编码器只看可见 patch | 可见位置及编码—解码设计 | 能利用上下文预测遮挡目标 |
这四行都没有自动回答“少量标签能否读出类别”“颜色是否保留”“边界是否准确”。那些是另设的评价问题。LAB 08 把索引检查与图像重建分开:先确认输入—mask—目标位置,再比较输入、重建和误差,最后冻结编码器作读出。划分必须先按原图进行,再生成破坏版本;否则同一原图的干净版和带噪版可能分居训练与测试,给出过于乐观的结果。
已运行的图像重建:恢复更好,表示评价另算
LAB 08 在 2026-09-22 本地 CPU 从头训练卷积自编码器。数据是 sklearn load_digits 的 1797 张 8×8 灰度图,先按原图分层随机划分 1257 训练、540 保留,再生成破坏;没有按书写者分组,因此结论是这个原图随机划分下的数字任务。标签只用于划分与读出,不进入重建损失。16 维瓶颈的去噪网络训练 40 epoch,破坏为 25% 像素丢弃加标准差 0.15 的高斯噪声并裁到 [0,1]。
| 保留集方法 | 与干净目标的逐像素 MSE |
|---|---|
| 直接使用带噪输入 | 0.06244 |
| 训练集拟合的 rank-16 PCA 重建 | 0.04160 |
| 学到的卷积去噪自编码器 | 0.03217 |
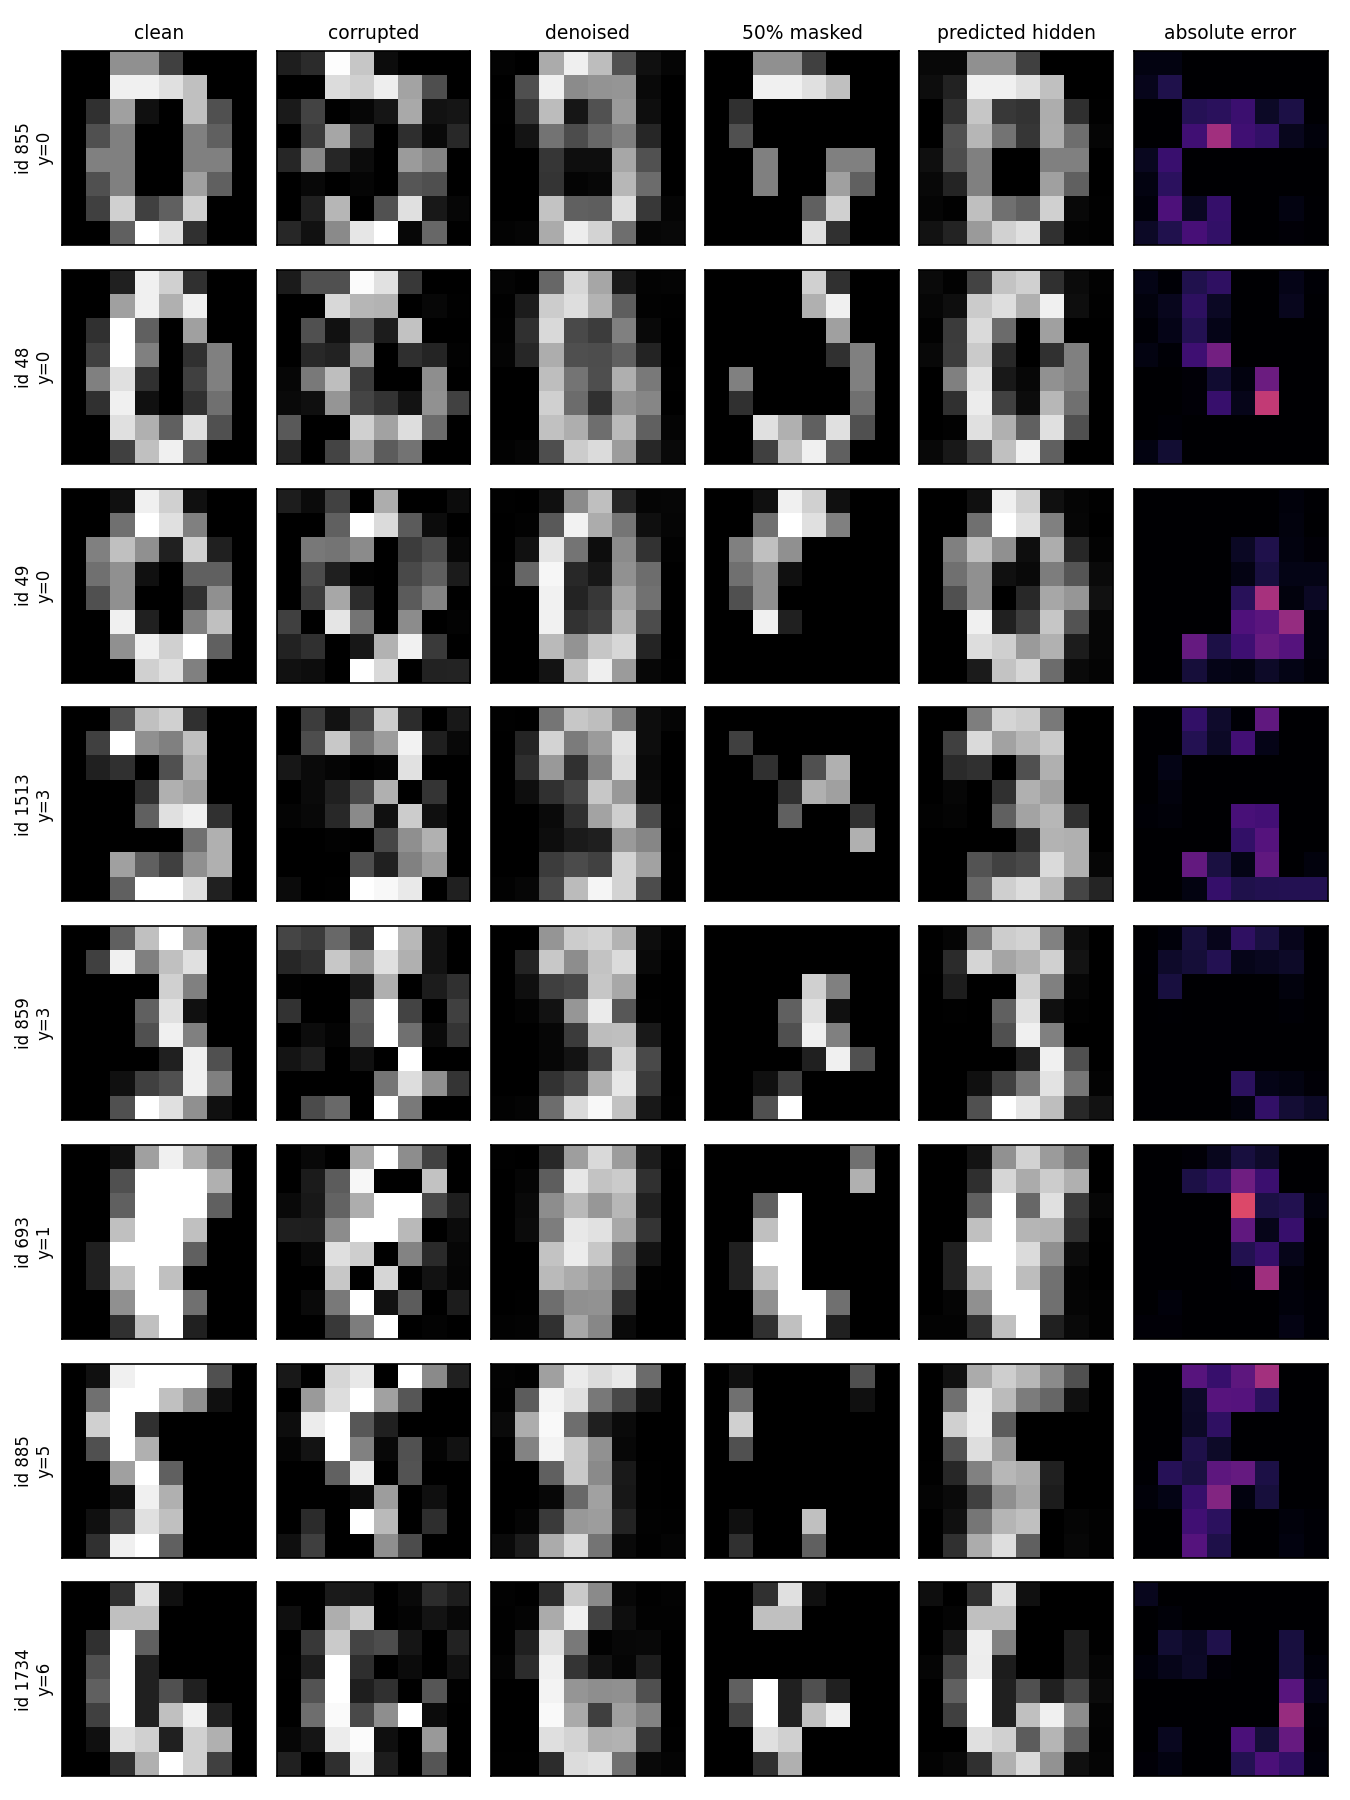
另一个两通道卷积模型接收“被遮挡图像+可见性 mask”,在 50% 的 2×2 patch 隐藏率下训练 50 epoch。它处理整张密集网格,不是原论文只编码可见 token 的 ViT MAE。固定每图同一排列、让隐藏集合嵌套,测试 25%/50%/75% 遮挡时,隐藏位置 MSE 分别为 0.03933/0.04341/0.05563;相应训练均值基线为 0.07420/0.07402/0.07390。遮挡增加后重建变难,但这个卷积模型并未获得 MAE 的可见 token 计算节省。
冻结编码器、输入干净保留图像作 5NN,去噪架构由随机初始化的 84.26% 到训练后的 95.00%;遮挡架构由 88.52% 到 92.04%。两种架构输入通道不同,随机基线也应分别保留,不能把它们混成同一个起点。重建改善和读出改善在这次实验中同时出现,但它们仍是两项独立测量。配置、输入 hash 与权重均在 LAB 08 对应材料中。
重建为“保存信息”提供了可计算目标;下一册 CLS 05 会主动要求某些变化在表示中不产生差异。二者的张力是具体的:准确重建颜色需要留下颜色,颜色不变的对比目标却可能鼓励忽略它。好的表示要服务什么,必须由下游问题回答。