CLS 03 · 视觉与语言:任务、训练与接口
主线阅读与优先实验
caption历史、VQA、CLIP候选、关系控制、GLIP/LLaVA与生成桥梁
对应课堂(11 页)
可先阅读已有结果,再决定是否运行。重算时请核对各节记录的数据、参数、环境与日期。
学习路径: 文字候选与图文检索
同一张图可以配文字、生成描述、回答问题,也可以按短语返回区域。本册把这四种输出放到同一条线上:语言此刻是答案、学习信号,还是任务条件?
| 你想解决的问题 | 先读 | 再做或深读 |
|---|---|---|
| 图像怎样改变一句话或一个答案 | P51 描述、P54 问答 | CLS 09,按兴趣选 LAB13 或 LAB14 |
| 图文配对怎样得到可复用表示 | P57 矩阵、P58 候选 | 优先 LAB 04;需要图库缓存时再进 LAB12 |
| 一句话指哪个对象,视觉如何接入语言模型 | P63 定位、P64 接口 | CLS 11,其中 LAB15 是可复算的关系规则练习 |
1. 语言可以在同一系统里承担三种作用
前一部分用框和点指定对象。现在把任务说出来:“描述这张桌面图”“找到红杯”“谁拿着球”。这些句子对系统提出的输出要求不同。
| 语言的作用 | 本部分追问 | 需要建立的接口 |
|---|---|---|
| 作为输出 | 如何利用图像和已生成词,描述所见? | 视觉表示连接词序列预测 |
| 作为学习信号 | 图文配对怎样教会匹配与检索? | 图像与文本进入可比较空间 |
| 作为任务条件 | 这句话指哪个区域,或要求回答什么? | 区域—词语对应,或视觉条件下的指令作答 |
这不是互斥的三类系统,也不是后一阶段淘汰前一阶段。一个视觉助手可以使用图文配对学习,用问题指定任务,再生成文字回答。先明确语言此刻的作用,再讨论需要的训练与接口。
2. 语言作为输出:看图说话怎样接上已有能力?
图像描述学习 :视觉特征与已有文字一起决定下一词。训练时配对描述给出目标;推理时从开始符号出发,只能接续自己的输出,直到结束符号。今天先把这条接口看清,循环网络内部留第五讲。
返回图像条件的课堂图。完整的 shifted target、EOS/PAD 和保留集生成对照归并到 CLS 09 · 图像条件输出:描述与问答 与 LAB 13 · 看图生成一句话:训练、解码与消融;本册不复制两份训练说明。
一张图可有多种真实描述。“桌上有杯子”与“左侧红杯靠近书”聚焦信息不同。先说明任务要求概括还是详细描述,再判断遗漏是否构成错误。图像条件怎样进入一个可变长度答案 · 已保存的条件生成实验:视觉输入确实改变了句子。
研究背景:组件到位后,选择哪一个新问题?
2014–2016 年,视觉预训练、文字预测与图文数据汇合,出现描述、区域对齐和视觉问答等不同研究入口。Trevor Darrell 是 LRCN 的共同作者之一;这里使用公开研究背景,不推断个人动机或讲者私下经历。
这段历史的重点是正面进展:已有表示确实开始支持可训练、可比较的新任务。再问组合缺口和局部关系,才知道后续工作为何需要新机制。课堂历史图 · 历史事实、评价结果与来源 · DCC 的配对缺口。
3. 语言作为学习信号:把配对变成可比较关系
CLIP 使用已配对的图像与文字,同时训练两种编码器。训练后,可以把“a photo of a cup”等候选描述编码成文字向量,与图像向量比较,做分类或在已有集合中检索。CLIP
这项能力来自配对学习:图像向量与文字向量本来并不天然处在可比较的坐标系。图文配对包含人的文字和数据选择,是外部学习信号;不使用固定类别标签不等于完全没有监督。
设红杯、蓝杯、书三张图分别与三段描述配对。把归一化表示记为 uᵢ 和 vⱼ,组成 Sᵢⱼ=uᵢᵀvⱼ。每一行回答“这张图配哪段文字”;每一列回答“这段文字配哪张图”。正确配对位于对角线,两种方向的分类损失一起参与训练。
活动 A:一张小矩阵,两种查找方向
行与列共同使用红杯、蓝杯、书的固定顺序。构造三维单位图像向量为三个坐标轴;对应文字向量在自身轴上取 4、另外两轴上取 1,再除以 √18 归一化。因此下表的每一项都是真正的余弦相似度:对角为 4/√18≈0.9428,非对角为 1/√18≈0.2357。这些向量是教学构造,不是 CLIP 推理输出。
| 红杯描述 | 蓝杯描述 | 书描述 | |
|---|---|---|---|
| 红杯图 | 4/√18 | 1/√18 | 1/√18 |
| 蓝杯图 | 1/√18 | 4/√18 | 1/√18 |
| 书图 | 1/√18 | 1/√18 | 4/√18 |
先将温度设为 τ=1,令 logits=S/τ。先预测: 把蓝杯文字向量对红杯轴的权重从 1 改大并重新归一化,哪张图与哪段文字的正确配对可能变难?运行后分别看行与列的正确配对概率,而不是只看一个总分。
批内未配对不保证语义完全无关,近重复和描述质量都会影响目标。这里先固定对角配对关系,隔离双向损失的计算。
按默认构造计算,行、列方向的正确配对概率均约为 [0.5035, 0.5035, 0.5035],双向平均损失约 0.686192。这是本页教学向量的确定性计算结果,可先阅读再改条件。
展开完整实现代码
# 独立 CPU 的双向配对目标;余弦来自归一化教学向量。
import math
objects = ['redcup', 'bluecup', 'book']
image_vectors = [[1.0,0.0,0.0],[0.0,1.0,0.0],[0.0,0.0,1.0]]
text_weights = [[4.0,1.0,1.0],[1.0,4.0,1.0],[1.0,1.0,4.0]]
def normalize(vector):
    norm=math.sqrt(sum(x*x for x in vector))
    return [x/norm for x in vector]
text_vectors=[normalize(vector) for vector in text_weights]
S=[[sum(a*b for a,b in zip(u,v)) for v in text_vectors] for u in image_vectors]
temperature=1.0
logits=[[s/temperature for s in row] for row in S]
def softmax(row):
    exps=[math.exp(x-max(row)) for x in row]
    return [x/sum(exps) for x in exps]
row_prob=[softmax(row) for row in logits]
col_prob=[softmax(list(col)) for col in zip(*logits)]
row_loss=-sum(math.log(row_prob[i][i]) for i in range(3))/3
col_loss=-sum(math.log(col_prob[i][i]) for i in range(3))/3
print('对象顺序:',objects,'温度:',temperature)
print('余弦矩阵:',[[round(s,6) for s in row] for row in S])
print('每张图找正确文字:',[round(row_prob[i][i],4) for i in range(3)])
print('每段文字找正确图:',[round(col_prob[i][i],4) for i in range(3)])
print('双向平均损失:',round((row_loss+col_loss)/2,6))
assert all(abs(sum(p)-1)<1e-12 for p in row_prob+col_prob)
assert all(abs(sum(x*x for x in vector)-1)<1e-12 for vector in image_vectors+text_vectors)
if text_weights==[[4.0,1.0,1.0],[1.0,4.0,1.0],[1.0,1.0,4.0]] and temperature==1.0:
    assert all(math.isclose(S[i][j],(4 if i==j else 1)/math.sqrt(18)) for i in range(3) for j in range(3))
    assert math.isclose((row_loss+col_loss)/2,0.6861917388550698)
从这张教学矩阵,走到真实模型
上面代码使用三维单位向量和 τ=1,正确概率约 0.5035、平均损失约 0.686192。课堂 P57 使用另一组四维单位向量和 τ=.2,正确概率约 0.90876、损失约 0.09567。两套都是自洽的教学构造;不要把一套的温度、矩阵和另一套的结果拼在一起。
LAB 04 · CLIP:候选、提示与关系检验 固定真实猫图与 CLIP checkpoint,分别扩大候选、改模板和删除正确类别;这是模型证据。LAB 12 · CLIP延伸:缓存与检索(近似索引选读) 使用同一编码器得到的完整向量,继续看缓存与检索。先完成前者再选后者,避免重复做两份“图文匹配”。为什么候选 softmax 会变。
4. 看衣色,还是看关系?让两种规则作出不同预测
正式问题保留两句候选:
- A.
A person in red holds a ball beside a person in blue. - B.
A person in blue holds a ball beside a person in red.
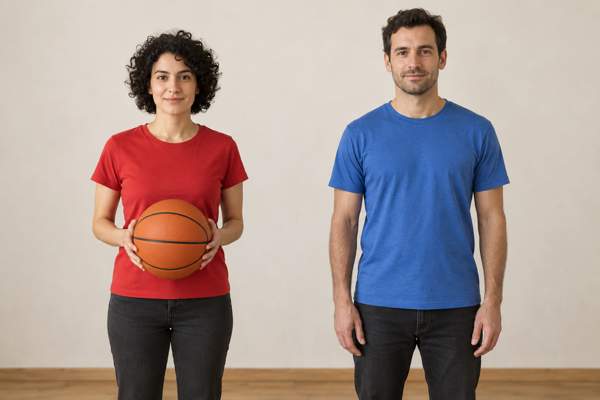
条件1:左红持球
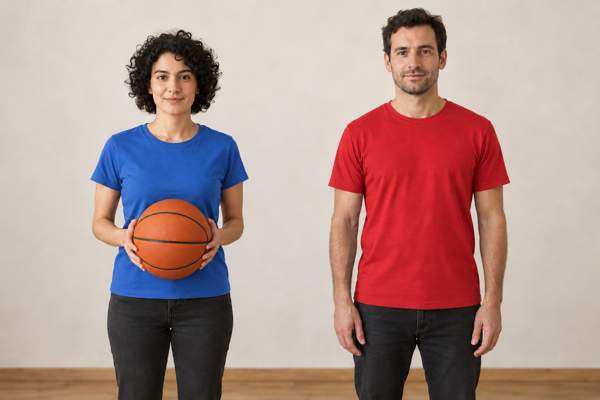
条件2:左蓝持球
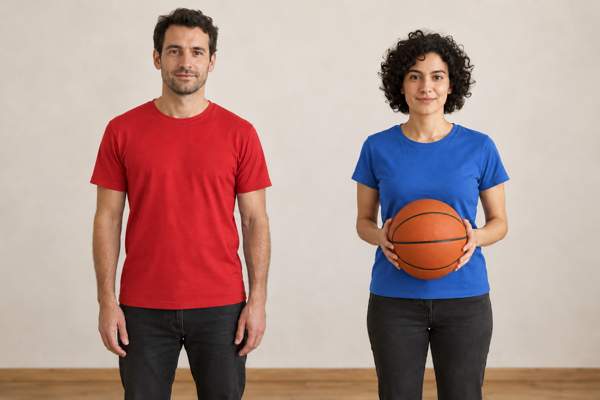
条件3:右蓝持球
条件4:右红持球
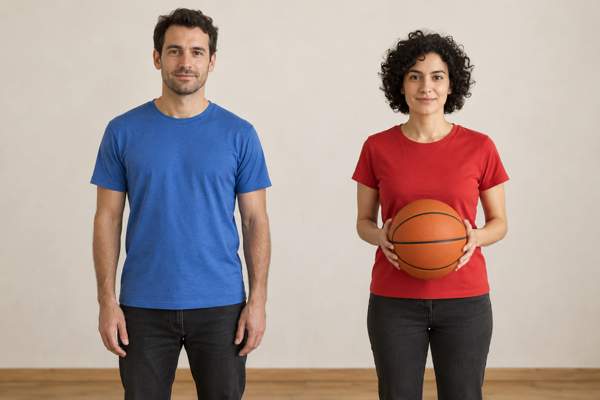
两个人、一个球;左右均按观看者位置。每个条件的持球人及另一人是否接触球应从图中确认。
原来两幅图的持球人都站在左侧:左红持球时 A 合适,左蓝持球时 B 合适。两个观察同时符合两条规则:读取持球者衣色,或者仅仅读取左侧人物衣色。因此原两图不足以区分两种解释。
新增右侧人物持球的两种条件,保持 A/B 候选不变。现在两条规则会给出不同预测,实验才有机会区分它们。图中独立生成的姿态、背景、光照也可能变化,所以它是针对竞争解释的条件设计,不声称所有图像只变了一个像素因素。
四条件的规则预期
| 条件 | 左侧 | 右侧 | 持球位置 | 持球者衣色规则 | 左侧衣色规则 |
|---|---|---|---|---|---|
| 1 | 红 | 蓝 | 左 | A | A |
| 2 | 蓝 | 红 | 左 | B | B |
| 3 | 红 | 蓝 | 右 | B | A |
| 4 | 蓝 | 红 | 右 | A | B |
前两行两规则相同,后两行不同。先预测: 假如模型在第 3、4 行也跟随持球者,能否据此证明它理解所有关系?这会支持当前检验中的关系解释,但更广结论还需不同人物、位置、动作和候选表达。
下格只计算这张规则预期表。真实 CLIP 分数需固定模型、预处理、四幅输入与候选后实际推理,再与表中规则比较。
展开完整实现代码
# 独立 CPU 规则对照;输出 A/B 来自明确规则,不是 CLIP。
conditions=[('1','red','blue','left'),('2','blue','red','left'),
            ('3','red','blue','right'),('4','blue','red','right')]
answer_of={'red':'A','blue':'B'}
rows=[]
for cid,left,right,holder_side in conditions:
    holder_color=left if holder_side=='left' else right
    relation=answer_of[holder_color]
    shortcut=answer_of[left]
    rows.append((cid,relation,shortcut))
    print('条件',cid,'持球者规则',relation,'左侧规则',shortcut,'一致?',relation==shortcut)
assert rows==[('1','A','A'),('2','B','B'),('3','B','A'),('4','A','B')]5. 语言指定任务之一:这句话指的是哪个区域?
CLIP 整图相似度给配对程度;“蓝杯左边的杯子”还要求输出目标区域。这里需要分开目标、参照物与关系,不能看到 blue 就返回蓝杯。
P63 的 GLIP 说明对象级语言定位的学习路线;CLS 11 · 语言定位与视觉模型接口 展开监督、空间输出和模型接口;LAB 15 · 语言指代小练习:目标、参照与关系 用像素提框与关系规则做完整对照。后者不是 GLIP 推理,但能准确解释为什么旧关键词规则选错。
6. 语言指定任务之二:根据画面回答这个问题
原始 LLaVA 的接口是视觉编码器 → 线性投影 → 语言模型。送入的是视觉网格向量,不是一个类别标签。阶段一冻结视觉与语言模型,只训练投影;阶段二仍冻结视觉,更新投影与语言模型。
P64 与 P65 对照这两个阶段。完整解释集中于 CLS 11 · 语言定位与视觉模型接口;注意后续版本的连接器不倒写为原始配置,RNN/attention 的内部结构留第五讲。
7. 哪些能力可以继承,哪些环节还要重新学习?
| 新任务 | 可以复用的部件 | 仍要建立的环节 |
|---|---|---|
| 固定表示分类 | 视觉编码器 | 目标标签与读出 |
| 检测与实例分割 | 视觉主干 | 区域组织、空间读取、框/掩码监督 |
| 图文匹配 | 合适的视觉与语言编码器 | 共同空间、配对学习与候选定义 |
| 文字定位 | 视觉空间特征与文字表示 | 区域—词语交互与定位训练 |
| 视觉问答 | 视觉编码器与语言模型 | 连接层、视觉指令与回答评价 |
这张表不要求每个系统都从上一行起步。它提醒我们:复用已有能力之后,仍要说明新任务的学习信号、输出与接口。
回到全讲中心问题:网络学到的视觉表示,怎样变成可复用、可指定、可检验的能力? 现在再改变一次任务:把输入图像拿走,只保留描述,要求系统创造一幅新图。
8B. 同一句话,为什么有多种合理图像?
满足条件 A
满足条件 B
满足条件 C
违反红杯条件:蓝杯
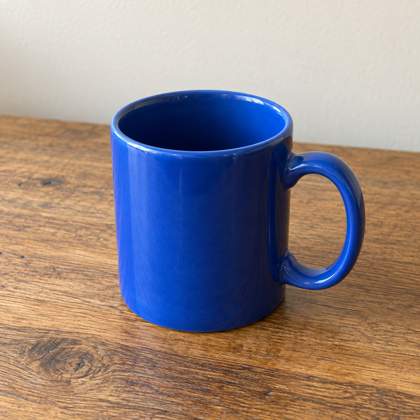
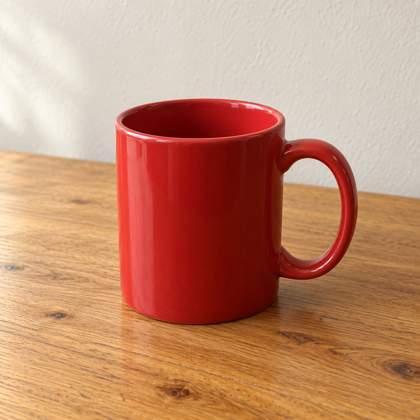
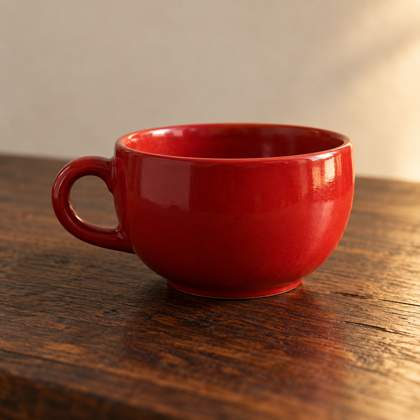
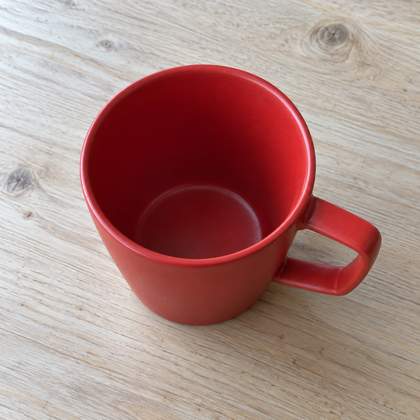
同一“红杯+木桌”条件下的三种合理样本,以及一张违反指定条件的对照。它们是条件与多样性的情境示例,不是生成方法质量对比。
先看图再判断: 哪些细节必须满足?哪些是描述没有指定的?红杯与木桌是条件;杯型、视角、光照、摆放位置仍有自由度。不同合理图像不必是同一幅图的微小扰动。
因此,训练不只是寻找唯一正确像素答案,而是学习符合条件的多种可能;采样再从这些可能性中得到具体结果。用记号写就是 x ~ pθ(x | c):c 是条件,模型参数 θ 规定条件分布,x 是一次产生的结果。
图文相似度可以为某些生成系统提供信号,但相似度函数本身不是完整采样器。MAE 的既有遮挡训练配方,也不会自动给出任意文生图能力。
8C. 从任务接口走向生成机制
图像描述已经在生成文字;前面的条件多解图又说明,同一句描述不必对应唯一像素答案。第四讲会进一步问:训练反馈怎样支持这些可能,采样又怎样得到一个结果?
GAN、VAE、Diffusion 的路线比较与原始来源,已移到第四讲:从条件多解走向生成模型。
8D. 带着三项判断结束本讲
选择本讲的一个系统,依次说清三件事:训练答案从哪里来;表示怎样被读成区域、像素或文字;哪项干预或保留评价支持它学到了所需能力。
这三项判断可以串起表示、空间输出与视觉语言,也会成为下一讲研究生成机制的起点。需要回查具体例子时,从第三讲导读的八条问题路径进入,不必重新顺读全部实验。