Lecture 03 学习讲义
正文
工具
按问题查找
视觉与语言图像怎样约束一句新生成的描述?

沿视觉条件找到下一词目标

解释、算例与证据

P51 · 图像描述:视觉内容怎样成为一句话?

先沿画面指出视觉特征进入哪里,再指出已有文字与下一词目标。连续说明展开 shifted target、EOS、PAD 和实际生成,LAB13 提供已保存的实验结果。理解本页可先把文字预测器作为输入输出模块;整数移位只演示目标构造,完整图像描述还需要图像条件与实际生成。

视觉编码器图像 → 特征两条合理描述“两个人站在一起。”“红衣人拿着篮球。”文字预测器允许看到的前文 + 视觉红衣人 拿着球下一个目标图文配对给出文字目标;页面展示训练接口与参考描述,没有展示模型生成结果。

图像先编码为视觉特征;视觉条件与已有文字一起进入文字预测器,前文从红衣人推进到红衣人拿着。

  • 视觉编码器
  • 图像 → 特征
  • 两条合理描述
  • “两个人站在一起。”
  • “红衣人拿着篮球。”
  • 文字预测器
  • 允许看到的前文 + 视觉
  • 红衣人 拿着
  • 球
  • 下一个目标
  • 图文配对给出文字目标;页面展示训练接口与参考描述,没有展示模型生成结果。
图像先编码为视觉特征;视觉条件与已有文字一起进入文字预测器,前文从红衣人推进到红衣人拿着。 查看对应图解状态
查看完整图解

课堂讲述

以图像描述为例,输出不再是固定类别,而是一段可变长度的文字。训练材料给出图像和描述,视觉特征与允许看到的前面文字一起,为后面的预测提供条件。 注意,这里用的是图文配对监督,不是图像自己自动长出文字标签。不同描述可以关注不同内容:“两个人站在一起”概括人物和位置,“红衣人拿着球”指出动作主体。两句都能从当前画面得到支持。 所以这个任务既要求视觉表示支持文字表达,也要求评价容纳多种合理描述。我们现在看完整的信息流和训练材料,不展开 RNN 或 Transformer 的内部机制。那部分留到第五讲,今天必须讲清的是:视觉信息从哪里进入,文字目标从哪里来,为什么流畅句子还要对得上画面。

图像条件怎样进入一个可变长度答案

独立阅读

图像描述要建模的是 pθ(y1,…,yT∣I)p_\theta(y_1,\ldots,y_T\mid I)。链式法则将它分解为 ∏tpθ(yt∣y<t,I)\prod_t p_\theta(y_t\mid y_{<t},I):每一步都在图像和此前文字的条件下预测后续文字。这个分解是概率关系,不要求本讲先学完一种具体文字网络。

指着 P51 的图看三个位置:图像编码器把像素变成视觉特征;文字预测器同时接收视觉条件与已有文字;目标位置从“红衣人”后的“拿着”,推进到“红衣人拿着”后的“球”。如果删除视觉路径,模型仍可能补出语法合理的句子,却失去了判断画面到底是谁拿球的信息来源。

训练图文配对提供目标句子,而不是图片自行生成唯一文字标签。一幅图可以被说成“两个人站在一起”,也可以被说成“红衣人拿着球”。前者省略衣色,后者聚焦动作主体,两句都可能真实。训练学习的是这种条件下的表达分布;教师还需要说明任务要求概括、细节描述还是完整枚举。

推理时没有参考句子可偷看。模型从开始符号出发,输出一个词,再把这个词接到自己的上下文,直到结束符号或长度上限。完整的实验必须有实际图像、可学习参数、词目标、优化和这条自由生成过程。网页上推进的参考词是教学目标示意;实际生成与视觉对照放在 LAB13。
图示条件与公式约定

两条参考描述由课程作者写出。推进展示“红衣人”之后预测“拿着”,以及“红衣人拿着”之后预测“球”;这些是监督目标示例,并非实测解码结果。

这条线索的展开与后续阅读

视觉与语言图像怎样约束一句新生成的描述?

对齐前缀、目标与有效损失位置

图像与已有文字提供条件;下一步要明确每个位置到底预测什么。

训练前缀、EOS 与 PAD:损失究竟算在哪些位置

独立阅读

假设一条参考句为 a red square,词序列写成 [BOS,a,red,square,EOS]。训练输入去掉最后一项,目标去掉第一项。两者一一对齐:

已允许看到的文字 当前目标
BOS a
BOS a red
BOS a red square
BOS a red square EOS

如果批中还有更长句子,就给短句末尾补 PAD,使张量长度一致。PAD 只是存储约定,不是要生成的文字;EOS 却是有效的停止目标。掩掉 PAD 时把 EOS 一起掩掉,会抹去何时结束的监督。

词损失可写为 L=−∑i,tmitlog⁡pθ(yit∣Ii,yi,<t)/∑i,tmitL=-\sum_{i,t}m_{it}\log p_\theta(y_{it}\mid I_i,y_{i,<t})/\sum_{i,t}m_{it},其中 mit=1m_{it}=1 表示目标不是 PAD。分母按有效词计数,不按补齐后的格数计数。LAB13 的 prefix=Y[:,:-1]、targets=Y[:,1:] 和 ignore_index=PAD 对应这三个选择。

训练时喂真实前缀叫 teacher forcing。推理时前缀来自模型自己:若先误说 blue,后续就必须在 blue 的条件下继续,不能偷偷换回 red。因此保留集的逐词交叉熵与自由生成的整句正确率要分别读;两者评价的输入条件不同。

视觉与语言图像怎样约束一句新生成的描述?

先读固定前缀下的视觉对照结果

词级损失描述训练;自由生成和视觉干预才能检查当前任务中的视觉作用。

已保存的条件生成实验:视觉输入确实改变了句子

独立阅读

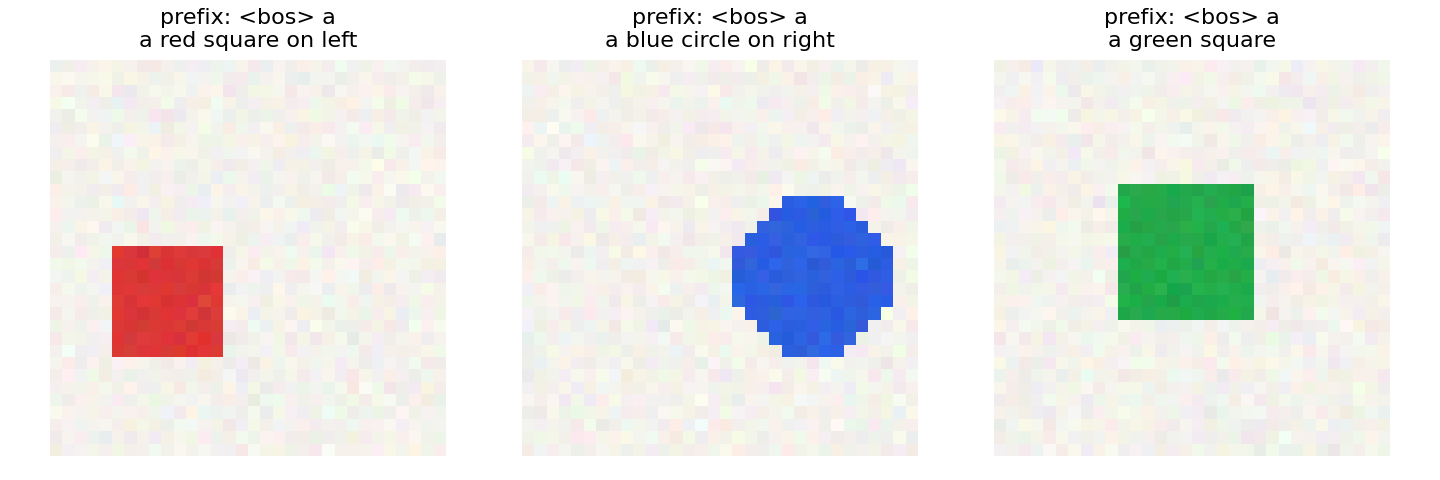
LAB13 当前保存的是 2026-09-22 本地 CPU 基准,当前整理没有重新训练。输入为真实渲染的 32×3232\times32 RGB 图像;训练 720 张,保留 180 张。颜色、形状、位置共有 18 种组合,两侧都包含这些组合,但保留图由独立随机渲染产生、像素哈希不重复。这检验新渲染泛化,不是未见组合泛化。

CNN 输出 48 维视觉向量;文字单位有 24 维嵌入;实验采用一个小型 GRU 文字模块。今天把它作为已明确输入输出的实现,内部循环状态留第五讲。视觉向量确实参与每一步预测,并用于初始化文字模块;真实颜色或位置标签只用于构造监督,不作为推理输入。

同一组 180 张保留图 整句精确匹配
正确图像,greedy 生成 100%
正确图像,beam 宽度 3 100%
同一模型,像素置零 5.56%
同一模型,图像循环错配 0%

固定前缀 BOS a,红方块左侧图生成 a red square on left,蓝圆右侧图生成 a blue circle on right。这里正面成立的判断是:这个有限任务中,训练后的输出使用了正确视觉条件。两种搜索同分,不支持 beam 比 greedy 更好;零图像是分布外条件,错配对照则进一步隔离了图像对应关系。自然图像有多种合理描述,不能把这里唯一规范句子的精确匹配直接移作通用 caption 评价。

固定前缀下的真实生成

图片与数字均来自已保存基准,不是把数据生成器的目标文字重新印成“模型回答”。

视觉与语言一个条件怎样容纳多种合理结果?

选读:比较局部选择与完整路径概率

Caption 已经使用逐词生成;这段保留为第四讲生成与第七讲搜索的预备阅读。

选读:局部最高概率为何不保证整句最高概率

独立阅读

这段作为第四讲生成和第七讲搜索的预备阅读;第三讲只需知道推理会接续自己的输出。令首词 A/B 概率为 0.6/0.4;A 后 X/Y 为 0.51/0.49;B 后 X/Y 为 0.9/0.1;下一步都以概率 1 输出 EOS。每层出边和为 1。

完整路径 AX、AY、BX、BY 的概率分别为 0.306、0.294、0.360、0.040。greedy 首先取 A,再取 X,得到 0.306;宽度 2 的 beam 首步保留 A/B,再展开并排序,能保留最终的 BX=0.36。这个可算小树解释局部选择与完整路径概率的差别。

有限 beam 仍可能在更大树里提前删掉最优前缀;更高模型概率也不保证更符合图像。如果模型把蓝杯误识成红杯,搜索更充分可能只是更坚定地输出错误描述。必须区分视觉建模错误、概率预测错误和搜索错误。

当前 LAB13 的实际模型中 greedy 与 beam=3 均为 100% 整句匹配,没有显示 beam 的经验优势。其热身代码采用另一棵归一化概率树,greedy=AZ、概率 0.3025,beam=BY、概率 0.36;两棵树各自定义自洽,不能把一棵树的首步概率与另一棵树的结果混用。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:给一张图多种描述,损失不是互相矛盾吗?

教师:它们可以是同一条件下不同合理表达。我们学习条件分布,并由任务决定哪些信息必须覆盖;不是要求逐像素唯一地对应一句话。

学生:训练时已经把前面的正确词给了模型,它会不会根本不看图?

教师:会有这种可能,所以还要从同一前缀自由生成,并交换或去掉图像。LAB13 保留的视觉消融就是在检查这一点。

沿这个问题继续

先回看本页画面并指出输入、条件和输出,再按“图像条件怎样进入一个可变长度答案 → 训练前缀、EOS 与 PAD:损失究竟算在哪些位置 → 已保存的条件生成实验:视觉输入确实改变了句子”阅读。相关实验以其已保存结果为起点,需要动手时再顺序执行 Notebook;