CLS 06 · 表示的三个检查:目标、信息与新域
按问题继续
教师软目标、坍塌、任务信息与域变化的三个不同问题
对应课堂(5 页)
可先阅读已有结果,再决定是否运行。重算时请核对各节记录的数据、参数、环境与日期。
学习路径: 表示怎样迁移到新任务
对比学习用负例阻止所有样本挤成一点。如果去掉负例,只让同图两视图接近,常量表示 对任意输入都能达到零距离。这个解完全满足“彼此一致”,却不能区分杯子和书。于是问题从“怎样产生训练目标”推进为:目标本身是否排除了我们不想要的解?本册把教师学习、表示信息和域变化连起来,是因为三者都要求分清模型容易满足的条件和我们真正需要的能力。
教师不一定是更大的模型,也不一定提供真值
传统知识蒸馏用训练好的教师给学生提供输出分布。教师 logits 对应三个类别,温度 下的软目标为 。 得到约 , 得到 。硬标签只指出第一类;软目标还表达第二类比第三类更接近教师判断。学生可用交叉熵 或等价的、忽略教师熵常数后的 KL 项拟合。
蒸馏常把软目标项与真实标签项结合,并对温度目标作 缩放以补偿典型梯度尺度变化。温度不是提高事实正确率的按钮;教师若依赖背景,软分布同样可能传递背景捷径。这里传递的是教师行为中的结构,是否有益需要在目标分布上测量。见 Hinton 等,2015:蒸馏与温度软目标。
自监督教师则可以来自学生自身的历史参数。以 EMA 教师为例,教师参数 ,目标分支停止梯度,学生去预测另一视图的教师输出。这节省人工标签,却没有凭空增加关于类别的权威来源。固定预训练教师、监督蒸馏教师和 EMA 自监督教师的来源与更新方式不同;看到“teacher”一词,先问它由什么数据训练、是否更新、哪条分支接收梯度。
| 设计 | 谁产生目标 | 目标是否随学生训练变化 | 一项必须核对的风险 |
|---|---|---|---|
| 固定教师蒸馏 | 已训练模型 | 通常不变 | 教师错误和偏差会被模仿 |
| EMA 自监督教师 | 学生参数的移动平均 | 平滑变化 | 常量解或退化解是否受到约束 |
| 人工类别监督 | 标注规则与标注者 | 数据集内通常固定 | 类别集合遗漏与标注噪声 |
先用三个量区分坍塌与无用读出
若一批表示全部为 ,协方差是零,任意两个样本距离为零;仅凭这些表示的分类器只能按先验猜类别。若表示分布有方差,仍可能仅保存背景亮度,不能因“看起来散开了”就判断语义有用。相反,线性分类失败也不必说明标签信息消失。
用四个等概率输入 ,同号标签 0,异号标签 1。这是 XOR:四点没有碰撞,每一点都唯一确定标签,但两类凸包都经过原点,不能被一条直线严格分开。加入 后,标签为 ,一维阈值就能完全分开。非线性变换没有创造标签信息,只改变了可读出形式。
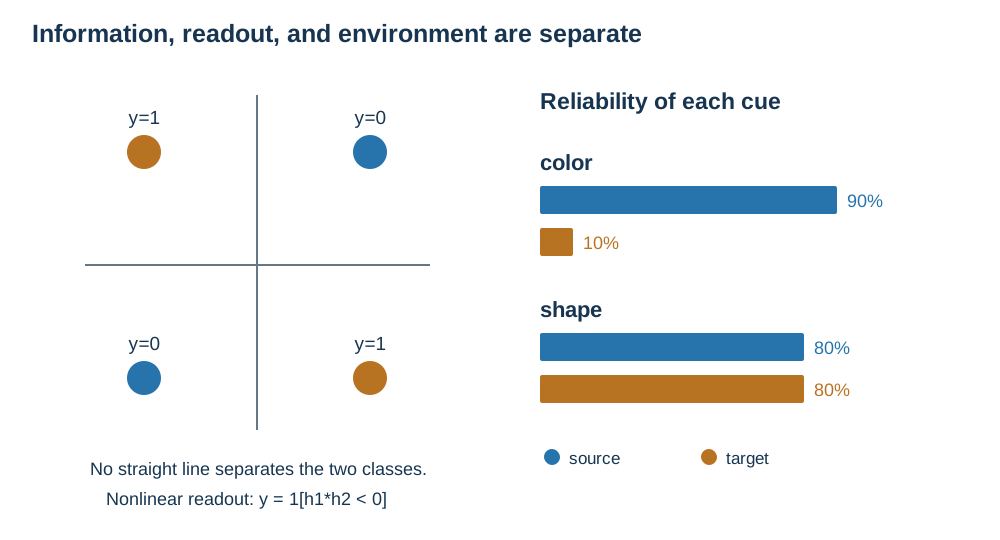
左图四点的身份与标签均完整保留,却没有线性分界;右图给出一个人为设定的环境分布:颜色线索从 90% 可靠变为 10%,形状线索保持 80%。这些是解释条件的构造数值,不是实测模型成绩。
因此值得分别检查表示方差/秩、冻结读出、允许非线性适配的成绩。每一种检查排除的解释不同。LAB 17 对照软目标和常量表示;LAB 18 则比较信息是否保留与读出是否容易。不要把前者的一次低距离当成后者的高质量表示。
数据处理不等式究竟限制哪一条链
设 为两个独立均匀 bit,标签 。固定表示 只存一个 bit,却保留全部标签信息: bit。另一个一 bit 表示 与 独立,所以 。两者维数相同、熵相同,任务信息却不同。这比“压缩越强越好”更能说明问题。
在固定的 Markov 链 中,数据处理不等式给出 :后处理不能从已经完全相同的输入状态中恢复被删除的区别。其前提是表示由给定 产生,没有额外关于 的信息通道。模型训练时参数 可从外部训练集获得规律;比较训练前后的 ,并不是在同一条固定前向链上凭空创造信息。连续变量的互信息还可能因确定性映射出现技术问题,不能拿离散 bit 算例的数值直接衡量一张连续特征图。课程采用这个例子是说明条件,而非用互信息替代实际迁移评价。
分布变了,源域最方便的线索可能最危险
考虑二分类图像:训练环境中,颜色与标签一致率为 90%,形状为 80%;新环境中颜色一致率降到 10%,形状仍为 80%。一个只用颜色的规则在源域期望准确率为 90%、目标域为 10%;只用形状则两域都为 80%。这里没有真正训练网络,因此只能证明规则在指定分布下失效,不能声称已经测得迁移带来的负收益。
要声称负迁移,需要同一目标任务、标签预算、训练和评价划分下,比较源预训练初始化与合理的目标域基线,例如从头训练或其他初始化;若前者更差,差值才是当前协议下的迁移负效应。冻结、局部微调、全量微调允许不同程度改写源线索,不能仅比较训练准确率。若目标标签很少,全量更新还可能把小样本噪声写进整个网络。
随机划分若同时把同一背景、拍摄设备或主体身份分进两侧,可能隐藏域变化。按环境或主体分组的保留集更接近“到新场景使用”的问题;验证集仍须用于选择适配强度,不能看完测试环境再挑出最好的一种方法。D2L:环境与分布偏移 给出这些假设变化的基础讨论。LAB 19 的真实逻辑回归与适配比较(输入为两维解析特征,不是照片)和 LAB 02 的实际参数迁移各承担其中一层证据。
第一条主线到这里形成一个闭环:重建规定要保留什么,对比规定哪些变化要忽略,教师规定向谁靠近,而读出与新域评价检查这些选择是否支持使用。下一册 CLS 07 改变的不是标签供给,而是输出要求:即使整图类别判断正确,网络还要交付对象在哪里。