先用三个量区分坍塌与无用读出
按问题继续
教师软目标、坍塌、任务信息与域变化的三个不同问题
先用三个量区分坍塌与无用读出
若一批表示全部为 ,协方差是零,任意两个样本距离为零;仅凭这些表示的分类器只能按先验猜类别。若表示分布有方差,仍可能仅保存背景亮度,不能因“看起来散开了”就判断语义有用。相反,线性分类失败也不必说明标签信息消失。
用四个等概率输入 ,同号标签 0,异号标签 1。这是 XOR:四点没有碰撞,每一点都唯一确定标签,但两类凸包都经过原点,不能被一条直线严格分开。加入 后,标签为 ,一维阈值就能完全分开。非线性变换没有创造标签信息,只改变了可读出形式。
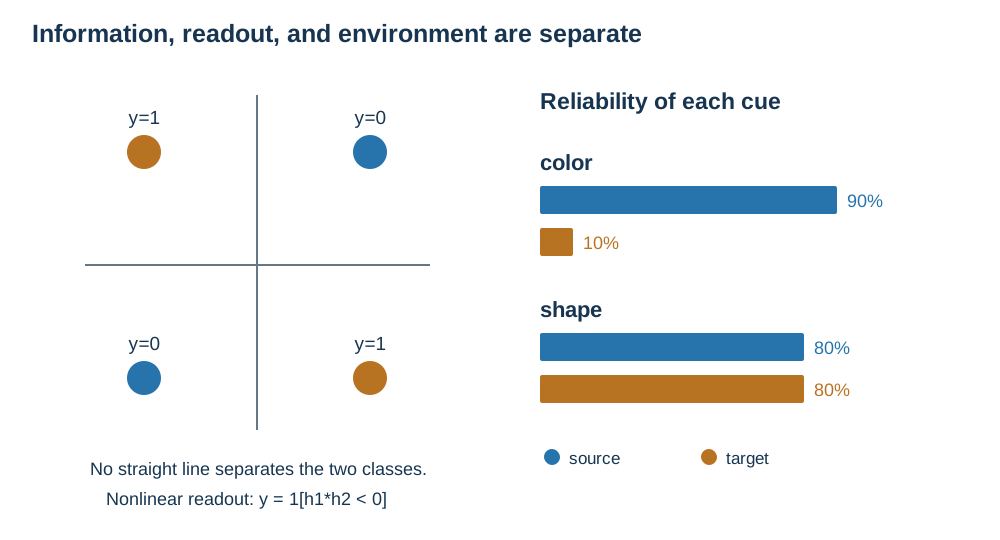
左图四点的身份与标签均完整保留,却没有线性分界;右图给出一个人为设定的环境分布:颜色线索从 90% 可靠变为 10%,形状线索保持 80%。这些是解释条件的构造数值,不是实测模型成绩。
因此值得分别检查表示方差/秩、冻结读出、允许非线性适配的成绩。每一种检查排除的解释不同。LAB 17 对照软目标和常量表示;LAB 18 则比较信息是否保留与读出是否容易。不要把前者的一次低距离当成后者的高质量表示。
数据处理不等式究竟限制哪一条链
设 为两个独立均匀 bit,标签 。固定表示 只存一个 bit,却保留全部标签信息: bit。另一个一 bit 表示 与 独立,所以 。两者维数相同、熵相同,任务信息却不同。这比“压缩越强越好”更能说明问题。
在固定的 Markov 链 中,数据处理不等式给出 :后处理不能从已经完全相同的输入状态中恢复被删除的区别。其前提是表示由给定 产生,没有额外关于 的信息通道。模型训练时参数 可从外部训练集获得规律;比较训练前后的 ,并不是在同一条固定前向链上凭空创造信息。连续变量的互信息还可能因确定性映射出现技术问题,不能拿离散 bit 算例的数值直接衡量一张连续特征图。课程采用这个例子是说明条件,而非用互信息替代实际迁移评价。