LAB 12 · CLIP延伸:缓存与检索(近似索引选读)
并入相关学习路径
同一CLIP缓存、exact/IVF搜索、延迟/扫描量、区域交互基线
对应课堂(4 页)
可先阅读已有结果,再决定是否运行。重算时请核对各节记录的数据、参数、环境与日期。
学习路径: 文字候选与图文检索
基础路线读第1节真实照片/缓存身份、第2节exact命中ID、第4节编码次数与内存。应能解释同一查询的Hit、Recall和exact重合率各在问什么,留下查询、相关集合、K及命中ID,而不只记平均分。
二维向量只是热身;主体使用2026-09-22保存的24×512图像向量与12×512查询向量。默认读取并核验缓存,不重新运行CLIP编码器。首次材料下载仍需网络;改变图片或查询文字才需重算对应编码。
第3节IVF和第5节区域加权是第八讲选读,保留完整可运行实现。阅读可按问题跳转,实际运行需按全部代码顺序,因第4节也读取第3节的索引变量。
展开完整实现代码
# 每次整册运行使用临时工作目录,保留项目旧文件与历史结果。
import os, tempfile
L03_RUN_DIR=tempfile.mkdtemp(prefix="lecture03-lab12-")
os.chdir(L03_RUN_DIR)
import numpy as np
I=np.array([[1,0],[0,1],[.8,.2]],float); T=np.array([[1,0],[0,1]],float); I/=np.linalg.norm(I,axis=1,keepdims=True); T/=np.linalg.norm(T,axis=1,keepdims=True)
S=T@I.T; print('similarity\n',S.round(3)); ranks=np.argsort(-S,axis=1); truth=[0,1]
for k in [1,2]: print('Recall@'+str(k),np.mean([truth[i] in ranks[i,:k] for i in range(2)]))热身里每个查询只有一个指定正例,truth=[0,1],因此“该正例是否进入前 K”的均值可称单正例 Recall@K。第三张向量与第一张接近,但不是指定正例;相似性与评价标注是两件事。真实图集中同一照片有四个关联裁剪,后面采用 Hit@K 和 exact 邻居重合率,避免把多正例情形继续不加说明地称为同一种 Recall。
1 · 输入、来源、编码和缓存身份
六张照片来自 scikit-image 0.25.2:Chelsea 猫(Stefan van der Walt,CC0)、宇航员(NASA,公共领域)、咖啡(Rachel Michetti,CC0)、摄影者(Lav Varshney,CC0)、火箭(SpaceX,公共领域)和星系深场(NASA,公共领域)。原始照片、授权说明、逐文件 SHA-256 均在 assets/manifest.json。每张图生成 full、center90、left90、right90 四个确定性视图,共 24 个索引项。每类有两条人工写定查询,共 12 条。
四个视图来自同一张图,彼此高度相关;这里没有训练/测试拆分,因为没有拟合视觉模型。它们用来观察索引分桶与排序,不是 24 张独立测试照片,更不是六类泛化性能评估。聚类训练只拟合无监督检索索引,不会重新训练 CLIP。
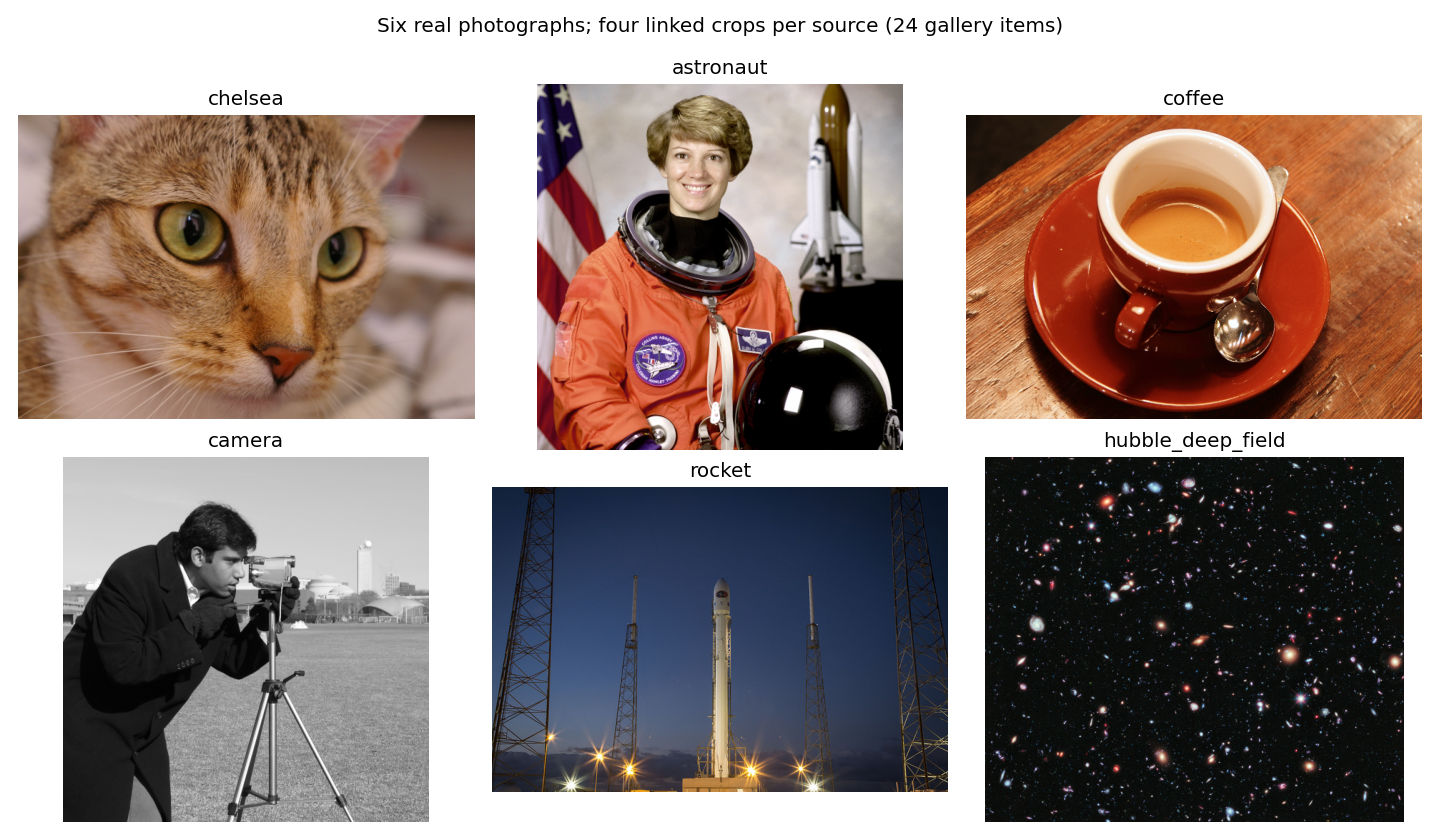
真实编码在 2026-09-22 本地 CPU 运行。图像和文字预处理、checkpoint revision 和哈希与 LAB 04 相同;512 维特征分别做 L2 归一化,缓存为 float32。gallery shape 为 [24,512],queries 为 [12,512]。直接把旧猫图四个分数拼成“图像向量”是不合法的:当前包保存的是实际编码器的完整输出。
下载独立材料。默认只需 requirements-cache.txt;完整重算编码需额外 requirements-inference.txt、python fetch_clip.py 和 python run_clip_retrieval.py --encode。缓存原始生成时间和当前读缓存的时间分开记录。
展开完整实现代码
# 独立材料,不依赖另一册 notebook 的内存;重复运行复用本项目已下载内容。
from pathlib import Path
import io, json, zipfile, requests, sys, hashlib
_candidates=[Path.cwd()/'lecture03-clip-retrieval', Path.cwd()]
RETRIEVAL_ROOT=next((p for p in _candidates if (p/'cache/clip-features.npz').exists()),None)
if RETRIEVAL_ROOT is None:
    _response=requests.get('https://codingai-lec03.pages.dev/course/materials/lecture03-clip-retrieval.zip',timeout=60)
    _response.raise_for_status()
    _data=_response.content
    print('下载材料 ZIP:',len(_data),'bytes; SHA256',hashlib.sha256(_data).hexdigest())
    with zipfile.ZipFile(io.BytesIO(_data)) as z:
        for info in z.infolist():
            target=(Path.cwd()/info.filename).resolve()
            assert target.is_relative_to(Path.cwd().resolve()), '拒绝越界路径'
            if info.is_dir():target.mkdir(parents=True,exist_ok=True)
            elif not target.exists():
                target.parent.mkdir(parents=True,exist_ok=True);target.write_bytes(z.read(info))
    RETRIEVAL_ROOT=Path.cwd()/'lecture03-clip-retrieval'
assert (RETRIEVAL_ROOT/'cache/provenance.json').is_file()
sys.path.insert(0,str(RETRIEVAL_ROOT))
import run_clip_retrieval as cr
import numpy as np
p=json.loads((RETRIEVAL_ROOT/'cache/provenance.json').read_text())
assert cr.sha(RETRIEVAL_ROOT/'cache/clip-features.npz')==p['cache_sha256']
assert cr.sha(RETRIEVAL_ROOT/'assets/manifest.json')==p['manifest_sha256']
manifest=json.loads((RETRIEVAL_ROOT/'assets/manifest.json').read_text())
for r in manifest['gallery']+manifest['relation']+manifest['holder']:
    assert cr.sha(RETRIEVAL_ROOT/r['path'])==r['sha256']
a=np.load(RETRIEVAL_ROOT/'cache/clip-features.npz')
print('已核验真实 CLIP 缓存;生成时间',p['generated_at_utc'])
print('本格只载入缓存,没有在当前 notebook 运行 CLIP 编码器。')
print('gallery, queries:',a['gallery'].shape,a['queries'].shape)
2 · 精确搜索:模型给分,评价定义相关
对于一个文本查询 ,精确检索逐个计算 并取最大的 K 项。归一化不等于校准:cosine 只是排序分数,不是“该图片正确的概率”。同一矩阵转置即可图搜文;不需要另训练一个模型,但两个方向的候选集合和评价单位不同。
本册规定:一个查询对应源类别的四个视图都算相关。语义 Hit@K 为“前 K 中至少有一个相关图”的查询比例;它不等于召回全部四个相关图的比例。ANN top-3 overlap 为 的平均值,评价近似索引是否找回精确搜索的邻居,完全不使用类别标签。这两项必须分开:模型的精确排序可能错,ANN 也可能完美复制这个错误。
当前小集 exact 文搜图 Hit@3=1.0、图搜文 Hit@1=1.0。它只能说明这些照片和查询能被本模型匹配,不能支持未知照片或复杂关系的泛化结论。LAB 04 的左右关系反例正好显示:整图对象匹配成功不自动推出关系绑定正确。
展开完整实现代码
X,Q=a['gallery'],a['queries']
assert np.allclose(np.linalg.norm(X,axis=1),1,atol=2e-6)
labels=np.array([r['label'] for r in manifest['gallery']])
truth=[r['label'] for r in manifest['queries']]
S=Q@X.T
exact=np.stack([cr.stable_rank(row,k=3) for row in S])
for i,row in enumerate(exact):
    print(manifest['queries'][i]['text'],'->',[(manifest['gallery'][j]['id'],round(float(S[i,j]),4)) for j in row])
hit3=np.mean([any(labels[j]==truth[i] for j in row) for i,row in enumerate(exact)])
print('exact semantic Hit@3:',hit3)
# 反方向:每张图对 12 条文字排序。每类有两条同义候选。
i2t=np.stack([cr.stable_rank(row,k=1) for row in S.T])
print('image-to-text Hit@1:',np.mean([truth[row[0]]==labels[i] for i,row in enumerate(i2t)]))
3 · 实际的近似索引:先路由到簇,再在簇内精排
本实验实现 IVF-Flat,而不只是打印一个标为 ANN 的 Recall。首先对归一化图像特征做固定 seed=17 的 spherical k-means,得到 8 个中心;每张图分配到 cosine 最大的中心,倒排表保存该簇内真实图片 ID。查询时先计算到 8 个中心的分数,只打开最近的 nprobe 个簇,然后对候选图片的原 float32 向量计算精确 cosine 并排序。
近似发生在“哪些簇被打开”,不是候选内部的打分。一个本来应在 exact 前三的图只要被放进未打开的簇,就可能漏检。nprobe 增大通常减少这种遗漏,但候选扫描增多;当 nprobe=8 时所有桶都打开,应恢复 exact 的相同排名。本例以图片 ID 作为相同分数的固定次序,避免把平分的排序差异误认为近似错误。
下面是真正参与当前实验的聚类代码;完整脚本还有文件核验、向量缓存和结果保存。
展开完整实现代码
unit=cr.unit
def spherical_kmeans(X,nlist=8,seed=17,iterations=40):
    rng=np.random.default_rng(seed)
    centers=X[rng.choice(len(X),nlist,replace=False)].copy()
    for _ in range(iterations):
        ids=(X@centers.T).argmax(1)
        new=np.stack([unit(X[ids==i].mean(0,keepdims=True))[0] if np.any(ids==i) else centers[i] for i in range(nlist)])
        if np.allclose(new,centers,atol=1e-7):break
        centers=new
    ids=(X@centers.T).argmax(1)
    return centers,[np.flatnonzero(ids==i) for i in range(nlist)]

centers,lists=spherical_kmeans(X,nlist=8,seed=17)
def ivf_search(q,nprobe,k=3):
    buckets=cr.stable_rank(q@centers.T,k=nprobe)
    candidates=np.concatenate([lists[int(b)] for b in buckets])
    ranked=cr.stable_rank(q@X[candidates].T,ids=candidates,k=k)
    return ranked,candidates
for nprobe in [1,2,4,8]:
    answer=[ivf_search(q,nprobe) for q in Q]
    overlap=np.mean([len(set(e)&set(r))/3 for e,(r,c) in zip(exact,answer)])
    hit=np.mean([any(labels[j]==truth[i] for j in r) for i,(r,c) in enumerate(answer)])
    print('nprobe',nprobe,'mean scanned',np.mean([len(c) for r,c in answer]),'overlap',overlap,'Hit@3',hit)
    if nprobe==8:assert all(np.array_equal(e,r) for e,(r,c) in zip(exact,answer))
# 逐项找出 nprobe=1 的遗漏,不只看一个平均分。
for i,q in enumerate(Q):
    ranked,candidates=ivf_search(q,1)
    missing=sorted(set(exact[i])-set(ranked))
    if missing:
        print('query:',manifest['queries'][i]['text'])
        print('missed exact neighbors:',[manifest['gallery'][j]['id'] for j in missing])
选读结果:近似索引,不是第三讲新增主讲段。
| 方法 | 平均扫描图片向量 | exact top-3 重合率 | 语义 Hit@3 | 12查询中位耗时 / p95,ms |
|---|---|---|---|---|
| exact | 24 | 1.0000 | 1.0000 | 0.0456 / 0.0609 |
| IVF nprobe=1 | 4.17 | 0.7778 | 1.0000 | 0.1016 / 0.1672 |
| IVF nprobe=2 | 7.67 | 1.0000 | 1.0000 | 0.1084 / 0.2591 |
| IVF nprobe=4 | 13.25 | 1.0000 | 1.0000 | 0.1185 / 0.1837 |
| IVF nprobe=8 | 24.00 | 1.0000 | 1.0000 | 0.1370 / 0.2236 |
这是2026-09-22 本地 CPU 的保存实测,不是解析复杂度。NumPy 2.3.5,单 BLAS 线程;每个样本点运行全部 12 查询,预热 20 次,测量 100 次。计时包括 Python 循环、路由、候选抽取和排序,排除磁盘读写、编码和索引构建。完整 BLAS 信息及索引构建时间见 verified/retrieval-results.json。
nprobe=1 的 exact 邻居重合率只有 0.7778,但语义 Hit@3 仍是 1:有些同源裁剪被漏掉,仍有另一个正确类别裁剪留下。这直接说明两种指标回答不同问题。nprobe=2 在这个小集恢复全部 exact 前三;它不保证其他数据也如此。
所有 ANN 配置都比 exact 慢,因为图库仅 24 项,矩阵点积太便宜,Python 桶访问和排序开销更突出。扫描数下降并不自动意味着延迟下降。共享CPU的调度也会影响这些微小耗时。大库里是否更快必须再测;不得把此处计算次数乘一个任意常数作为“毫秒”。
4 · 缓存节约什么,不能节约什么?
下表是同一 任务的解析工作量,不是把未执行的全部逐对编码写成实测。每次“样本编码”指一个图片或一条文字通过对应编码器;批处理调用可以一次处理多个样本,二者不相等。
| 组织方式 | 图像样本编码 | 文字样本编码 | 相似度计算 | 可复用内容 |
|---|---|---|---|---|
| 每对都重编码 | 288 | 288 | 288 个512维点积 | 无 |
| 双编码器缓存 | 24(入库一次) | 12 | 288 个512维点积 | 图像向量可跨查询复用 |
| 新增一条查询 | 0 | 1 | exact为24个点积 | 原图像库不变 |
| IVF nprobe=1 | 入库同上 | 查询同上 | 每查询8个中心点积+平均4.17个图片点积 | 中心、倒排表、图片向量 |
图片矩阵为 字节;8个中心另占16,384字节,倒排 ID 另占192字节(保存基准使用的 int64)。这没有计入 Python 对象、图片文件和模型权重,不能直接称整个服务的内存。
2026-09-22 的全部实测编码还包括候选与关系扩展,共 36 个图像样本和24条文字,分别以9个图像批次和1个文字批次编码;另做两对逐对重编码核验(额外2图+2文),与缓存点积最大差8.94×10⁻⁸。将CLIP按配对重复调用,算的仍然是 ,并没有出现图文联合注意力。
这次36图编码含预处理共2.726秒、24文共0.205秒,是一趟本地CPU墙钟时间,不含模型加载/下载,不能当作稳定线上延迟。代码另行测量缓存搜索分布,已经在上表展示。更换模型、revision、预处理或图片内容会使旧缓存失效;只增加候选文字不会改变已有图片向量。
展开完整实现代码
N,d=X.shape;Qn=len(Q)
print('解析样本编码次数:每对重算',N*Qn,N*Qn,';缓存',N,Qn)
print('矩阵字节:',X.nbytes,';中心字节:',centers.nbytes,';ID字节:',sum(l.nbytes for l in lists))
print('真实缓存生成记录:',p['image_count'],p['text_count'],'样本;',p['image_batch_calls'],p['text_batch_calls'],'批次')
print('另两对逐对重算与缓存的最大差:',p['pairwise_validation_max_abs_delta'])
5 · 查询依赖的交互:一个可运行的区域加权对照
“每对都调用模型”不等于“有图文交互”。我们再定义一个小而完整的 query-dependent 后期交互:先缓存左右两个照片区域的 CLIP 向量 ;对每一个查询 ,计算 ,然后用 加权,得到分数 。查询不同,区域权重和汇总表示不同,所以它确实在比较时使用了图和文的共同信息;但它是本册定义的加权规则,没有训练新的联合编码器,也不是 CLIP 官方的全图匹配分数。
在“猫左、宇航员右”拼贴上,cat 查询给左猫区94.15%的权重;astronaut 查询给右宇航员区80.08%。这是一项可观察的查询依赖变化。它的代价是每对查询与图要计算多个区域点积,缓存也从一向量变成区域集合;由于区域特征独立生成,它仍可部分预计算。
接着使用两条“谁在左/右”的关系句。交换区域顺序后,下述加权分数完全相同,因为这个公式对区域排列不敏感;它没有使用坐标。这不是代码 bug,而是设计本身丢失了顺序。如果需要真正的区域关系,需要显式位置、关系模块或经训练的联合模型。一个一般的 cross-encoder 会在内部让图文 token 相互条件化,通常不能将整次交互压成一个与查询无关的图片向量;本册只给其结构和成本解释,没有假装运行或比较某个未加载的 cross-encoder。
展开完整实现代码
R=a['relation_regions'][:,1:]  # 两图 × 两区域 × 512,丢弃full区域
# 同一图片换查询,观察权重确实变化。
atomic=R[0]@Q[[0,2]].T
weights=np.exp((atomic-atomic.max(0,keepdims=True))/.05)
weights/=weights.sum(0,keepdims=True)
print('cat / astronaut 查询的 [左区,右区] 权重:',weights.T)
# 同样两个对象交换左右;无坐标的对称聚合不可能分辨顺序。
local=np.einsum('ijd,kd->ikj',R,a['relation_text'])
w=np.exp((local-local.max(-1,keepdims=True))/.05);w/=w.sum(-1,keepdims=True)
score=(w*local).sum(-1)
print('两张交换图 × 两条关系句:',score)
assert np.allclose(score[0],score[1],atol=1e-6)
6 · 做一个有意义的改变,并解释它改变了哪层
先把 nprobe=1 改成2,固定向量、查询、真值和K,记录漏掉的具体图片ID如何变化。这只改变搜索近似程度;模型表示没有改善。再把K改为1,重新计算 Hit@1 和 top-1 overlap,不得把不同K的数直接拼在同一结论里。若改变聚类seed,先记录簇大小和对应遗漏;单次成功不等于所有划分都成功。
若想把第二条猫查询换成另一个同义模板,必须重算该文本编码,而不是在旧查询ID下改文字标题。默认缓存播放明确拒绝冒充新模型输出;在材料包副本中只修改 assets/manifest.json 的 queries[1].text,保留cat相关性定义,随后执行 python run_clip_retrieval.py --encode,才会为新文字生成真实特征和新的缓存身份。若改成“谁在左边”,需要另选同场多对象输入并定义坐标真值,不能沿用单对象类别标签;对应输入和反例已在LAB04。保留已验证的包,新实验应在一个副本目录执行,以便比较输入hash。
最后回到任务:caption 需生成新句子,检索只能返回已经入库的候选;VQA要针对问题产生答案,grounding要交付可检验区域。检索用一个独立向量换来便于缓存和索引的结构,同时未承诺词级关系、坐标或完整生成。这一取舍通过当前真实关系反例和区域加权例可亲自检验。
**保存自己的运行:**执行下面单元会在新UTC时间目录写检索结果、实际计时、环境和脚本hash;默认只复用真实CLIP缓存。verified/ 保留2026-09-22 完整编码基准,legacy/ 保留旧实验,互不改日期。
展开完整实现代码
import subprocess
completed=subprocess.run([sys.executable,str(RETRIEVAL_ROOT/'run_clip_retrieval.py')],check=True,text=True,capture_output=True)
print(completed.stdout)
print('当前运行只重做检索;完整图文编码的生成身份见cache/provenance.json。')
来源与实现边界:OpenAI CLIP 官方代码、固定 checkpoint、scikit-image 数据文档。本册的8簇 spherical k-means IVF-Flat 和区域加权是透明的教学实现;未调用FAISS,不声称复现生产规模索引,也未训练新的cross-encoder。