1 · 输入、来源、编码和缓存身份
并入相关学习路径
同一CLIP缓存、exact/IVF搜索、延迟/扫描量、区域交互基线
1 · 输入、来源、编码和缓存身份
六张照片来自 scikit-image 0.25.2:Chelsea 猫(Stefan van der Walt,CC0)、宇航员(NASA,公共领域)、咖啡(Rachel Michetti,CC0)、摄影者(Lav Varshney,CC0)、火箭(SpaceX,公共领域)和星系深场(NASA,公共领域)。原始照片、授权说明、逐文件 SHA-256 均在 assets/manifest.json。每张图生成 full、center90、left90、right90 四个确定性视图,共 24 个索引项。每类有两条人工写定查询,共 12 条。
四个视图来自同一张图,彼此高度相关;这里没有训练/测试拆分,因为没有拟合视觉模型。它们用来观察索引分桶与排序,不是 24 张独立测试照片,更不是六类泛化性能评估。聚类训练只拟合无监督检索索引,不会重新训练 CLIP。
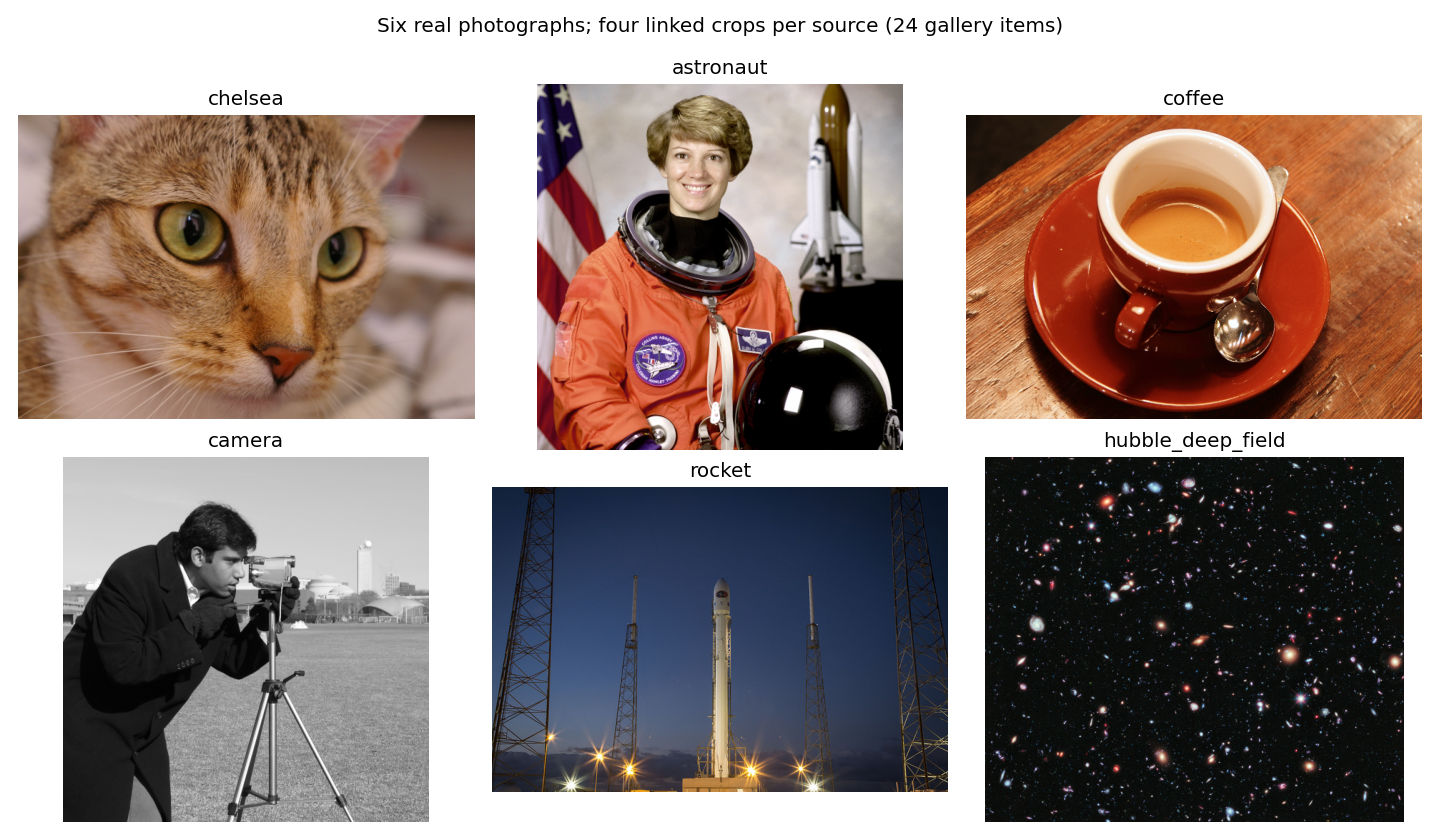
真实编码在 2026-09-22 本地 CPU 运行。图像和文字预处理、checkpoint revision 和哈希与 LAB 04 相同;512 维特征分别做 L2 归一化,缓存为 float32。gallery shape 为 [24,512],queries 为 [12,512]。直接把旧猫图四个分数拼成“图像向量”是不合法的:当前包保存的是实际编码器的完整输出。
下载独立材料。默认只需 requirements-cache.txt;完整重算编码需额外 requirements-inference.txt、python fetch_clip.py 和 python run_clip_retrieval.py --encode。缓存原始生成时间和当前读缓存的时间分开记录。