LAB 03 · 空间信息:表示、采样与掩码
按问题继续
同源场景标签、插值、信息碰撞的轻量解析代码
对应课堂(12 页)
可先阅读已有结果,再决定是否运行。重算时请核对各节记录的数据、参数、环境与日期。
1. 类别与框
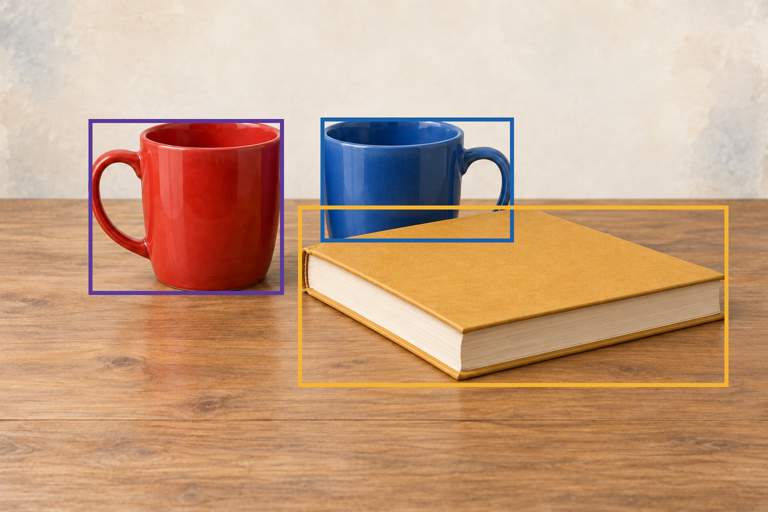
红杯框 [177,238,390,351]、蓝杯框 [641,235,386,249]、书框 [596,411,860,362]。这里按 x、y、宽、高记录,原图坐标为1536×1024。框内仍包含背景。
ImageGen 场景+代码绘制教学标注,非模型预测。
2. 语义像素
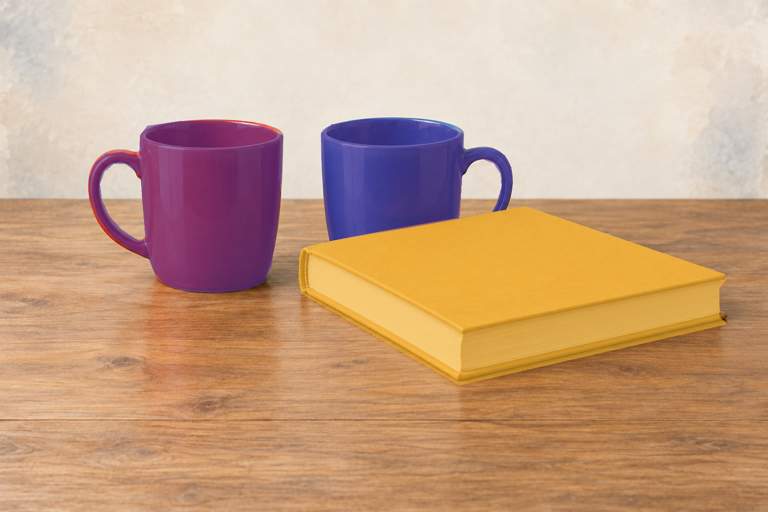
两个杯子使用同一个杯子类别;把手空洞与杯身不属于同一像素集合。
ImageGen 场景+代码绘制教学标注,非模型预测。
3. 实例掩码
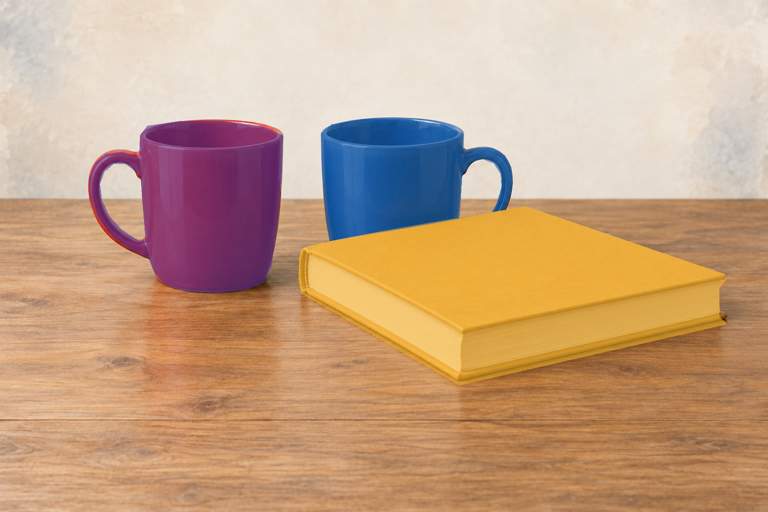
两个杯子同类,但分别保留 cup-red、cup-blue 的实例身份;书为独立对象。改变类别或实例身份不会自动改变可见轮廓。
ImageGen 场景+代码绘制教学标注,非模型预测。
展开完整实现代码
# 本册独立素材准备:内嵌预览与精确原图坐标,不下载外站,也不依赖其他 notebook 的变量。
from pathlib import Path
import base64, json
from IPython.display import SVG, display
scene_uri = 'https://codingai-lec03.pages.dev/course/knowledge-assets/46ffa1170be676ea38dfc1ee.jpg'
annotation = {'version': 'L03-r2-20260922', 'image': 'tabletop-occlusion.png', 'size': [1536, 1024], 'label': '手工教学标注:可见轮廓,非模型输出或数据集真值', 'objects': [{'id': 'cup-red', 'category': 'cup', 'polygon': [[280, 270], [295, 251], [362, 241], [448, 242], [527, 253], [565, 270], [562, 361], [554, 454], [542, 532], [526, 565], [491, 579], [432, 586], [369, 582], [329, 568], [307, 541], [297, 516], [258, 497], [224, 471], [194, 433], [179, 392], [178, 356], [190, 326], [210, 308], [242, 303], [278, 314]], 'holes': [[[280, 351], [251, 328], [227, 328], [209, 343], [200, 368], [204, 400], [219, 432], [244, 459], [276, 480], [290, 481]]], 'box': [177, 238, 390, 351]}, {'id': 'cup-blue', 'category': 'cup', 'polygon': [[642, 266], [663, 248], [732, 238], [814, 238], [888, 249], [925, 267], [925, 306], [954, 296], [985, 296], [1009, 310], [1022, 334], [1025, 366], [1018, 396], [1010, 418], [934, 435], [850, 450], [746, 466], [659, 482], [650, 414], [644, 341]], 'holes': [[[925, 348], [944, 323], [965, 318], [986, 326], [1000, 347], [1002, 373], [993, 404], [984, 424], [919, 438]]], 'box': [641, 235, 386, 249]}, {'id': 'book', 'category': 'book', 'polygon': [[602, 500], [626, 490], [1051, 412], [1450, 548], [1451, 560], [1438, 576], [1438, 633], [1454, 648], [918, 770], [602, 586], [597, 560], [598, 516]], 'holes': [], 'box': [596, 411, 860, 362]}]}
asset_dir = Path.cwd() / 'lecture03-assets-r2'
asset_dir.mkdir(exist_ok=True)
preview_file = asset_dir / 'tabletop-occlusion-preview.jpg'
if not preview_file.exists():
    preview_file.write_bytes(base64.b64decode(scene_uri.split(',',1)[1]))
(asset_dir / 'scene-annotations.json').write_text(json.dumps(annotation,ensure_ascii=False,indent=2))
print('可用材料:', preview_file.name, 'scene-annotations.json')
print('标注坐标系:', annotation['size'], ';图片预览768×512,展示时同比例映射。')
# 修改这一项为 cup-red、cup-blue 或 book,预测红框和局部窗口怎样改变。
selected_id = 'cup-blue'
obj = next(o for o in annotation['objects'] if o['id']==selected_id)
x,y,w,h = obj['box']
print('所选对象:',selected_id,'类别:',obj['category'],'框(x,y,w,h):',[x,y,w,h])
svg = f'<svg xmlns="http://www.w3.org/2000/svg" width="768" height="512" viewBox="0 0 1536 1024"><image href="{scene_uri}" width="1536" height="1024"/><rect x="{x}" y="{y}" width="{w}" height="{h}" fill="none" stroke="#431170" stroke-width="10"/></svg>'
display(SVG(svg))
# 将所选框显示在归一化的局部窗口;不把此教学裁剪称为 RoIAlign。
local_svg = f'<svg xmlns="http://www.w3.org/2000/svg" width="320" height="240" viewBox="{x} {y} {w} {h}" preserveAspectRatio="none"><image href="{scene_uri}" width="1536" height="1024"/></svg>'
display(SVG(local_svg))
展开完整实现代码
# 本格独立:先预测,再修改 x_image / 特征值,不用前格变量。
import math
feature = [0.,1.,2.,6.,7.]
def linear_at(x_image, stride, values):
    u=x_image/stride
    if not 0<=u<=len(values)-1:
        raise ValueError('采样位置超出已有特征;请一起检查坐标与特征范围')
    lo=math.floor(u); hi=min(lo+1,len(values)-1)
    a=u-lo
    return u,(1-a)*values[lo]+a*values[hi]
assert linear_at(35,16,feature)==(2.1875,2.75)
x_image, stride = 35.,16.
u,value=linear_at(x_image,stride,feature)
print('原图x / stride =',u,';线性插值 =',value)
A=[[1.,0.],[1.,0.]];B=[[0.,1.],[0.,1.]]
def encode(m):
    return sum(map(sum,m))/4, sum(r[0]-r[1] for r in m)/2
fa,fb=encode(A),encode(B)
print('只留均值:',fa[0],fb[0])
print('增加左列−右列通道:',fa,fb)
print('均值各放大为2×2:',[[fa[0]]*2]*2,[[fb[0]]*2]*2)
assert fa==(0.5,1.0) and fb==(0.5,-1.0)
读取结果,解释改动
默认蓝杯框为 [641,235,386,249];选择红杯后框换为 [177,238,390,351]。图像与标注引用同一源场景,局部窗口按该框显示。运行准备只写本课素材目录,不加载模型。
数值默认输出:原图x / stride = 2.1875;线性插值 = 2.75。这是约定 u=x/stride 的一维教学例;真实二维 RoIAlign 还包括区域分格、双线性采样及汇总。
均值编码均为 0.5;其余特征和框相同、后续不能回看原图时,放大或改采样仍没有新差别。新增“左列−右列”后,表示为 (0.5,+1) 与 (0.5,−1)。
现在作判断: 若连续位置读错了,应改采样;若表示把两种输入变成同一个值,应检查编码器留下的信息。真实 Mask R-CNN 的对齐训练对照,与这里固定同一表示的构造是两种实验。
自己改一个条件: 选蓝杯或红杯;把原图 x 改成 36;把右邻特征 6 改成 10;为甲乙保留或删去差分通道。每次先写预测,再读图/数值并解释。无需提交编码作业。
阅读位置: 本册是像素、边界与对象身份路径中的采样短练习。先解释一个坐标或一次信息碰撞;需要学习模型时再到 LAB11,不必把全部短练习顺序做完。
接下来按问题选择: 要把采样从一维扩到二维,读 四个邻点如何读出 2.5;要检验模型真能从 RGB 得到轮廓,读 LAB 11。本册的 SVG 裁剪不是调用 RoIAlign,平均值碰撞也不是分割模型训练结果,两项准确身份使它们能和完整实验互相补充。