图像、前缀、目标,三个位置分开看
按问题继续
图像条件、teacher forcing、真实生成、greedy/beam与VQA控制
学习路径: 图像怎样约束句子与回答
读完应能解释:为什么训练损失不能代替自由生成评价,为什么问题先验不能代替视觉证据。GRU/RNN 内部与 beam 搜索已移入第五讲,不是理解视觉条件的前置要求。
图像、前缀、目标,三个位置分开看
令图像为 、句子为 ,模型学习 视觉编码器把像素变成特征;文字预测器接收视觉特征和允许看到的文字;目标是下一词。课堂从“红衣人”后预测“拿着”,再从“红衣人拿着”后预测“球”。图上的目标词是人工参考,不是实测生成。
一图可以有“两人在球场”与“红衣人拿球”等不同真实描述。模型学习条件下的表达分布,任务再决定必须包含哪些内容。完整信息流与多参考解释。
训练与推理的分界发生在前缀
参考 [BOS,a,red,square,EOS] 的输入是 [BOS,a,red,square],目标是 [a,red,square,EOS]。PAD 仅为批量补齐,不计损失;EOS 是有效停止目标。损失按有效词求平均,不能把补齐格数也算入分母。
训练时看到真实前缀叫 teacher forcing;推理必须接续自己的输出。先误说 blue 后,就要在 blue 条件下继续,不能改回参考 red。保留集 teacher-forced 交叉熵因此不能代替自由生成评价。逐位置表与损失公式。
已有实验确实完成了图像条件生成
LAB 13 保存2026-09-22本地 CPU 基准:720张训练图、180张独立渲染保留图,18种语义组合两侧都出现。CNN产生48维视觉向量,文字模块采用小型GRU;本讲把它作为明确输入输出模块,内部留L05。推理不读取真实颜色/位置标签。
| 保留条件 | 整句精确匹配 |
|---|---|
| 正确图像,greedy / beam=3 | 100% / 100% |
| 同一模型,像素置零 | 5.56% |
| 同一模型,循环错配图像 | 0% |
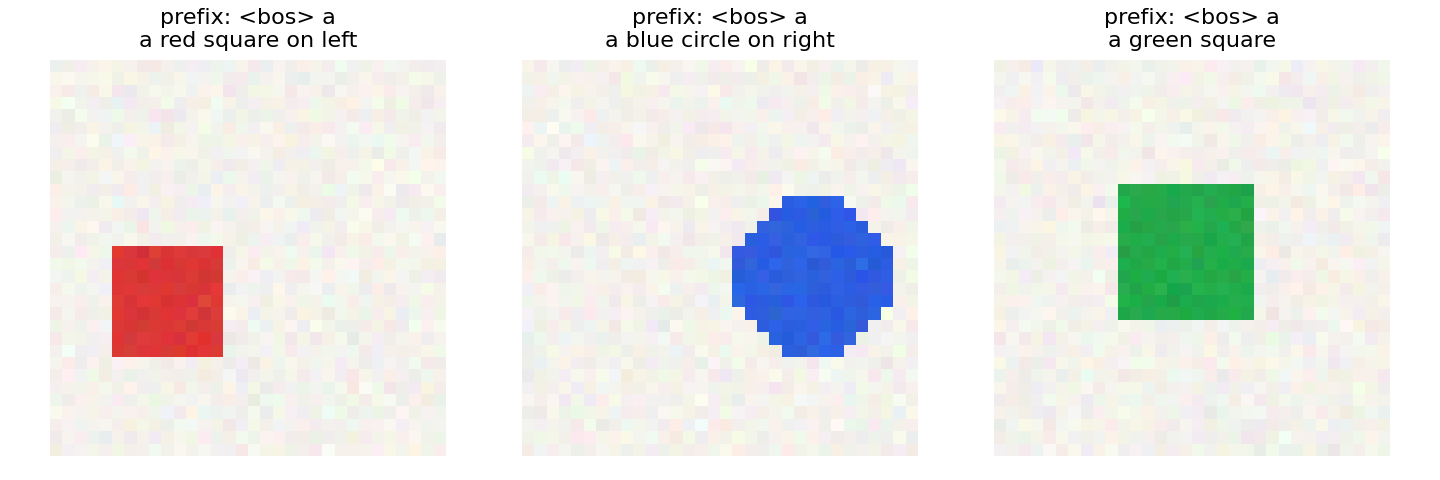
固定 BOS a,红方块左侧图生成 a red square on left,蓝圆右侧图生成 a blue circle on right。这支持当前有限任务使用正确视觉条件;不是自然照片或未见组合泛化,也没有显示 beam 优于 greedy。本轮整理未重跑训练。数据、协议与证据细节。