从两张视图到一个可微分的选择题
按问题继续
InfoNCE概率与梯度、h/z、温度、队列陈旧性、实测与评价协议
学习路径: 视图、投影头与历史字典
先把一张图的两种观察放入同一候选表,算出正例概率;再追踪梯度怎样经过z回到h,以及旧key为什么需要缓慢变化的编码器。温度的概率与梯度算例、队列身份都可以独立引用。
动手只选一个入口:想检查增强留下什么,选LAB 06;想追踪真实key、FIFO和EMA,选LAB 07。读完用一张图或一段trace指出输入、候选和两种参数更新,再用独立读出评价它是否对任务有用。后文同时保留论文迁移进展和小型实验的失败结果,二者的数据与协议分别写明。
拍同一只杯子,改变光照、裁剪和背景,类别仍然是杯子。若能把这些变化视为同一对象的不同观察,训练目标就可以来自图像自身:两次观察的表示应该接近,其他图像的表示提供区分参照。但如果下一项任务是分辨红杯和蓝杯,“改变颜色仍然算同一个”就不再无害。对比学习的正例关系,是设计者通过数据和增强作出的任务假设。 它不是无标签数据自动告诉我们的普遍相同性。
从两张视图到一个可微分的选择题
给原图 独立采样增强 ,得到 。编码器 产生表示 ;投影头 产生 ,通常再做 归一化。余弦相似度便是单位向量点积 。正例 key 来自同一原图另一视图,候选负例来自其他原图。
对一个 query 、一个正例 和若干负例 ,写出 InfoNCE 形式:
这里 是温度,分母包含正例。它把“拉近正例、推开负例”写成在当前候选集合里选中正例的交叉熵。候选身份来自采样过程,不是人工类别;两张不同原图可能都是杯子,所以负例并不保证语义类别不同。实例区分与类别聚合之间存在真实张力。
SimCLR 的一个 batch 有 张原图,生成 个视图。对其中任一视图,排除自身,余下 项中有一个正例和 个负例。自身相似度通常接近 1,若误把它留进分母,就额外加入一个不可避免的强竞争者。损失平均两个方向:视图 A 找 B,B 也找 A。可核对 SimCLR §2、式 1 与 Algorithm 1。
温度改变竞争强度,不改变这组相似度的排序
固定三项相似度:正例 0.8,两个负例 0.4、0.2。直接代入上式得到:
| 温度 | 正例概率 | 负例 0.4 的概率 | 负例 0.2 的概率 | 损失 |
|---|---|---|---|---|
| 1.0 | 0.4506 | 0.3021 | 0.2473 | 0.7971 |
| 0.5 | 0.5713 | 0.2567 | 0.1721 | 0.5599 |
| 0.1 | 0.9796 | 0.0179 | 0.0024 | 0.0206 |
因为正例已经领先,低温度放大它的优势。若把正例改成 0.3、最强负例仍为 0.4,低温度则会更强地惩罚错误排序。不能仅因降低温度使这张表的损失变小,就宣称表示更好了。
梯度把这个现象写得更精确。令 为候选 softmax 概率,则
温度既出现在 中,也改变 。所以“温度越低,所有梯度越大”不成立:本例正例梯度的绝对值在 时约 0.8575,在 0.1 时反而约 0.2037,因为预测已饱和。最相似负例会获得更多概率和更强排斥,但过度强调困难负例也可能放大假负例或噪声。
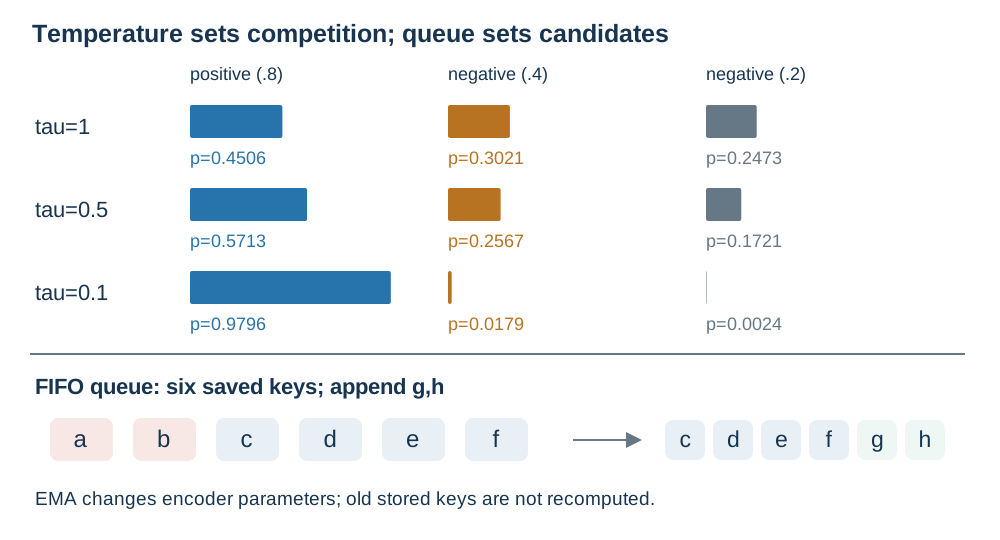
上半图按表中真实计算值画出候选概率;下半图是长度 6 的 FIFO 队列,加入两个新 key 后移出两个最老 key。温度控制一次比较,队列控制比较对象从哪里来。
为什么损失作用在 z,迁移却常读 h
假设 , 编码形状, 编码颜色。若增强经常改变颜色,两个视图可能有相同 、不同 。直接要求整个 相同,会压制颜色差异;增加投影头以后, 这样的映射可以在 中满足不变性,而 仍可能留下颜色。这是一个可行性构造,不是声称真实网络一定学成两根独立坐标。
损失计算在 不代表编码器没学:链式法则给出 。梯度穿过投影头更新编码器。SimCLR 通过实验发现非线性投影头有益,并把投影前表示用于下游;这支持区分目标空间与读出空间,不能推广成“h 永远保留全部被增强抹掉的信息”。图像已经被转成灰度时,该视图根本不含原颜色;若所有训练视图都删掉颜色,表示也没有从这些输入恢复真实颜色的依据。
在 LAB 06 中,应同时检查颜色/形状任务、增强设置和 读出。最有解释力的比较是:同一原图划分、相同模型容量与读出预算,只改变颜色增强;再看形状读出和颜色读出是否朝不同方向变化。不能用颜色损失下降代替形状泛化,也不能把随机二维向量当作实际训练出的特征。