同样是压缩,离散词典与线性子空间留下不同东西
按问题继续
词典/PCA数值、线性自编码约束、遮挡索引、masked ConvAE与MAE区别
学习路径: 从遮挡重建到表示评价
从P19—22的MAE位置图进入,本册回答:限制什么,才能使重建不只是复制输入?
先读“MAE让昂贵编码器只看少量位置”,手写可见位置、补位顺序和隐藏loss分母;再看LAB 08保存的同图重建与冻结读出。你的产出是一张对照:模型恢复了哪些像素,哪些下游能力另外测过,两者为什么不能互相代替。
PCA、去噪与词典的推导保留在前半部,遇到瓶颈或误差问题再回读。需要一个无需神经网络的实际优化入口时,选LAB 05像素词典。可直接引用隐藏loss分母或重建限制。
如果不提供“猫”“杯子”这样的类别标签,图像还有什么可以当答案?最直接的是图像自身:把它压缩、破坏或遮住一部分,再让模型恢复。困难不在于是否有监督数值,而在于我们允许模型怎样取得它。把输入原样复制到输出可以获得零误差,却没有迫使模型形成有用的表示。重建方法之间真正改变的是限制条件:代码可以取什么值、信息从哪里通过、哪些位置可见,以及误差计算在哪里。
同样是压缩,离散词典与线性子空间留下不同东西
把一个 灰度 patch 展平为 。K-means 学习 个中心 ,用最近中心的索引编码:
若词典恰为 、,它可以零误差重建左右两种明暗边,但 到两中心的平方距离都为 1,只能按约定任选其一。代码被限制为一个离散索引,约需 bit,另须存储词典;这不是任意实数向量的无损压缩。改变 会改变量化误差与存储成本。原 LAB 05 在真实 MNIST patch 上进行 Lloyd 拟合,可查看中心怎样随数据形成,而非只背“无监督”这个标签。
PCA 改用连续线性坐标。对已减去均值的 ,选列正交矩阵 ,编码 ,重建 。最小化平方重建误差等价于保留协方差最大的 个方向。
用四点 手算。均值为 0,按 计算协方差是 。只保留一维时选横轴,四点重建为 ;逐点平方误差为 ,平均 0.5。若选纵轴,平均误差为 2。被丢掉的方向方差小,不代表它对任务不重要:如果标签恰好区分纵坐标正负,PCA 的最优重建轴可能删去标签所需的差异。
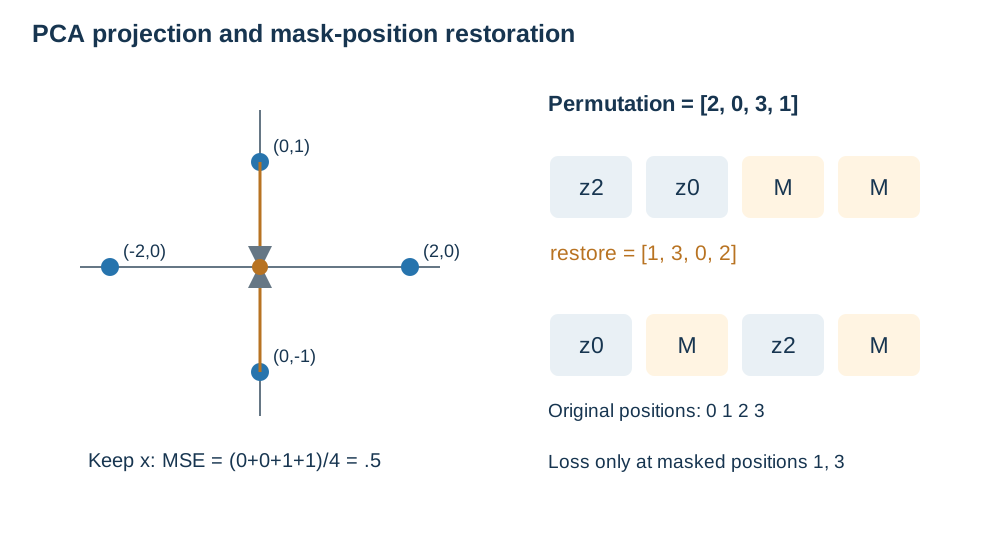
左图按真实坐标画出四点和一维投影;右图展示 patch 的乱序、可见项与恢复位置。两者都在重建,但一个限制子空间,一个限制输入可见性。
PCA 为什么可以看成受约束的线性自编码器
自编码器由 与 组成,以 等重建损失更新参数。令 并要求 ,就得到上面的 PCA 形式。一般线性、低秩、平方误差自编码器也能学到 PCA 的主子空间,尽管编码坐标不一定等于标准主成分;平移、旋转等参数化差异要与重建子空间区分。
所以 SVD 可以精确说明一种线性自编码约束,但 SVD 本身没有执行一个另行承诺的非线性网络训练。引入非线性编码器和解码器以后,表示可以适应弯曲的数据结构;也可能凭较大容量记忆训练样本。瓶颈维数、正则化、跳连是否绕过瓶颈、训练与保留误差,都影响我们能否把低损失解释为学到了结构。
去噪自编码器进一步改变训练对:先从破坏分布采样 ,再最小化 。输入是带噪图片,目标仍是干净图片。训练时不给模型干净图,不能在可视化时偷偷把目标的边缘或 mask 喂回去。Gaussian 噪声、置零像素和随机遮块提出不同恢复任务;噪声太轻会接近复制,太重可能留下不足以判断的证据。在 去噪自编码器原论文 中,破坏过程正是组织表示学习的一个关键约束。
平方误差还有一个值得记住的性质:最佳预测是给定输入后的条件均值。若一个被遮挡像素在其余条件相同下等概率为 0 或 1,输出 0.5 的平均平方误差是 0.25,而总是输出 0 或 1 的误差是 0.5。模糊有时来自目标的统计偏好,不一定只是网络没有优化好。下一讲讨论采样时会重新遇到这个问题。