NMS 与评价匹配解决两个不同的重复问题
按问题继续
坐标、锚框偏移、训练/评价匹配、NMS/AP和真实检测训练连接
NMS 与评价匹配解决两个不同的重复问题
Non-maximum suppression(NMS)是推理后处理:通常按类把预测框按分数排序,保留最高分框,删除与之重叠超过阈值的其他框,再继续。它减少同一对象的重复报告,但不知道真值;挤在一起的不同对象也可能被误删。NMS 阈值影响交付的结果,不能在测试集上追着最好 AP 挑阈值。
评价匹配则拿最终预测与真值比较。在固定类别和 IoU 阈值下,按置信度从高到低,每个预测至多匹配一个尚未被使用的真值;同一真值只能被命中一次。于是“框覆盖了对象”还不保证是真阳性,它可能是已有更高分预测的重复框。
设共有两个真值,四个预测排序后的身份依次为 TP、FP(重复)、FP(背景)、TP。累计 precision 为 ,recall 为 。若采用本册的全点插值 precision envelope 与 recall 增量积分,AP 为 。这是明确定义的简化 AP;COCO 的 101 个 recall 阈值采样、多个 IoU 阈值平均和面积分组是更具体的另一套协议,不能把一个数未经说明叫“COCO AP”。
LAB 09 可改重复框分数,观察排序如何改变 AP;也可改 IoU 阈值,使一个原先合格的框失去匹配。准确率把大量背景当作普通样本时可能很高,却无法体现检测的定位与重复问题。
沿一次真实训练追踪从图像到框
LAB 10 的主实验应按以下对象检查:RGB 图像和类别/框标注进入数据集,卷积骨干产生空间特征,输出头产生类别与偏移,匹配提供监督,损失更新参数,解码及 NMS 产生最终框,最后仅用保留图像评价。真值坐标只用于目标与评价,不能作为图像模型的输入特征。
主实验已在 2026-09-22 本地 CPU 完整运行。输入是 48×48 RGB 合成图,含红矩形、蓝椭圆、可变位置与尺度、多个对象及空图;颜色与形状相关,因此不是自然场景通用检测基准。按原始场景种子划分 768 训练、96 验证、192 保留图。45,806 参数的卷积检测器在单层网格上使用 288 个锚框,训练 28 epoch;正例阈值 0.45、忽略区间 [0.25,0.45),并保障每个真值有独立强制匹配。分类使用 hard-negative CE,位置项为正例 smooth-L1,解码后按类 NMS。
| 同一保留协议 | 两类平均 AP@IoU0.50 | 两类平均 AP@IoU0.75 |
|---|---|---|
| 随机初始化 | 0.00746 | 0.00003 |
| 训练后,原尺度 | 0.97303 | 0.70367 |
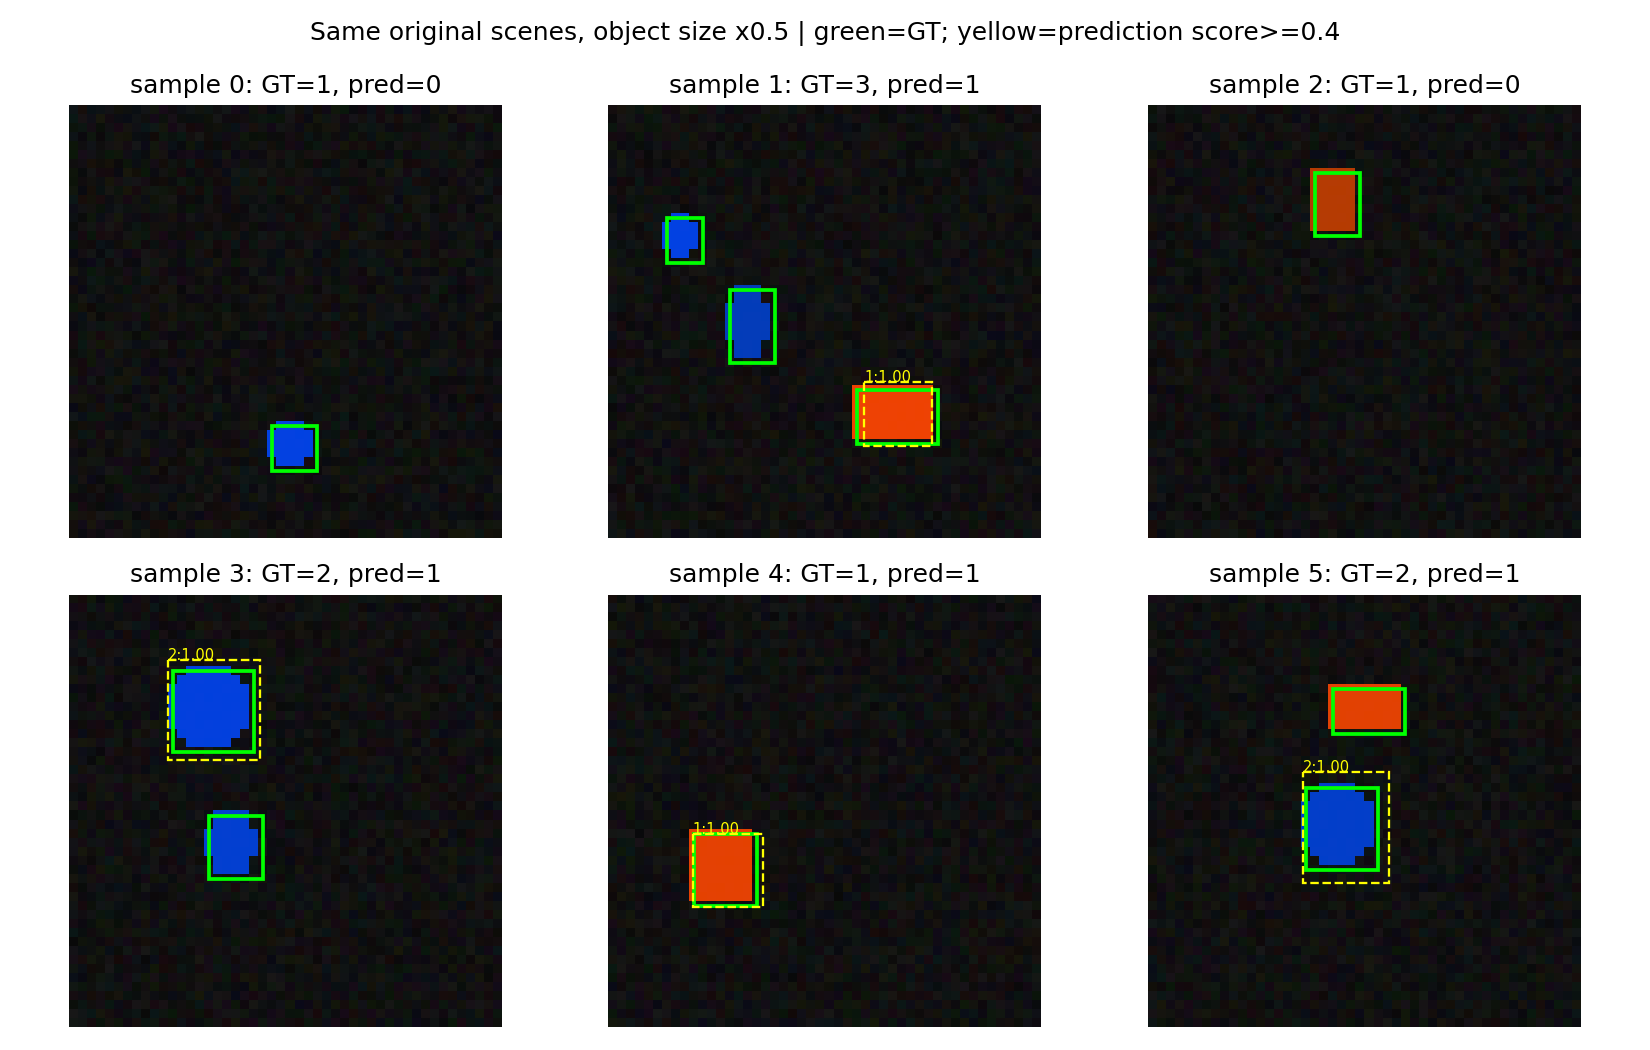
| 训练后,仅对象尺寸减半 | 0.61490 | 0.17987 |
AP 按各类全局分数排序、一个真值最多匹配一次、precision envelope 全点积分;不是 COCO 多 IoU 平均 AP。保留集有 33 张空图,展示阈值 0.4 下没有空图误报;这不代表所有阈值或所有背景都不会误报。AP50 与 AP75 的差距说明定位仍不够精细,尺度减半的下降说明训练分布外的小对象尤其困难。
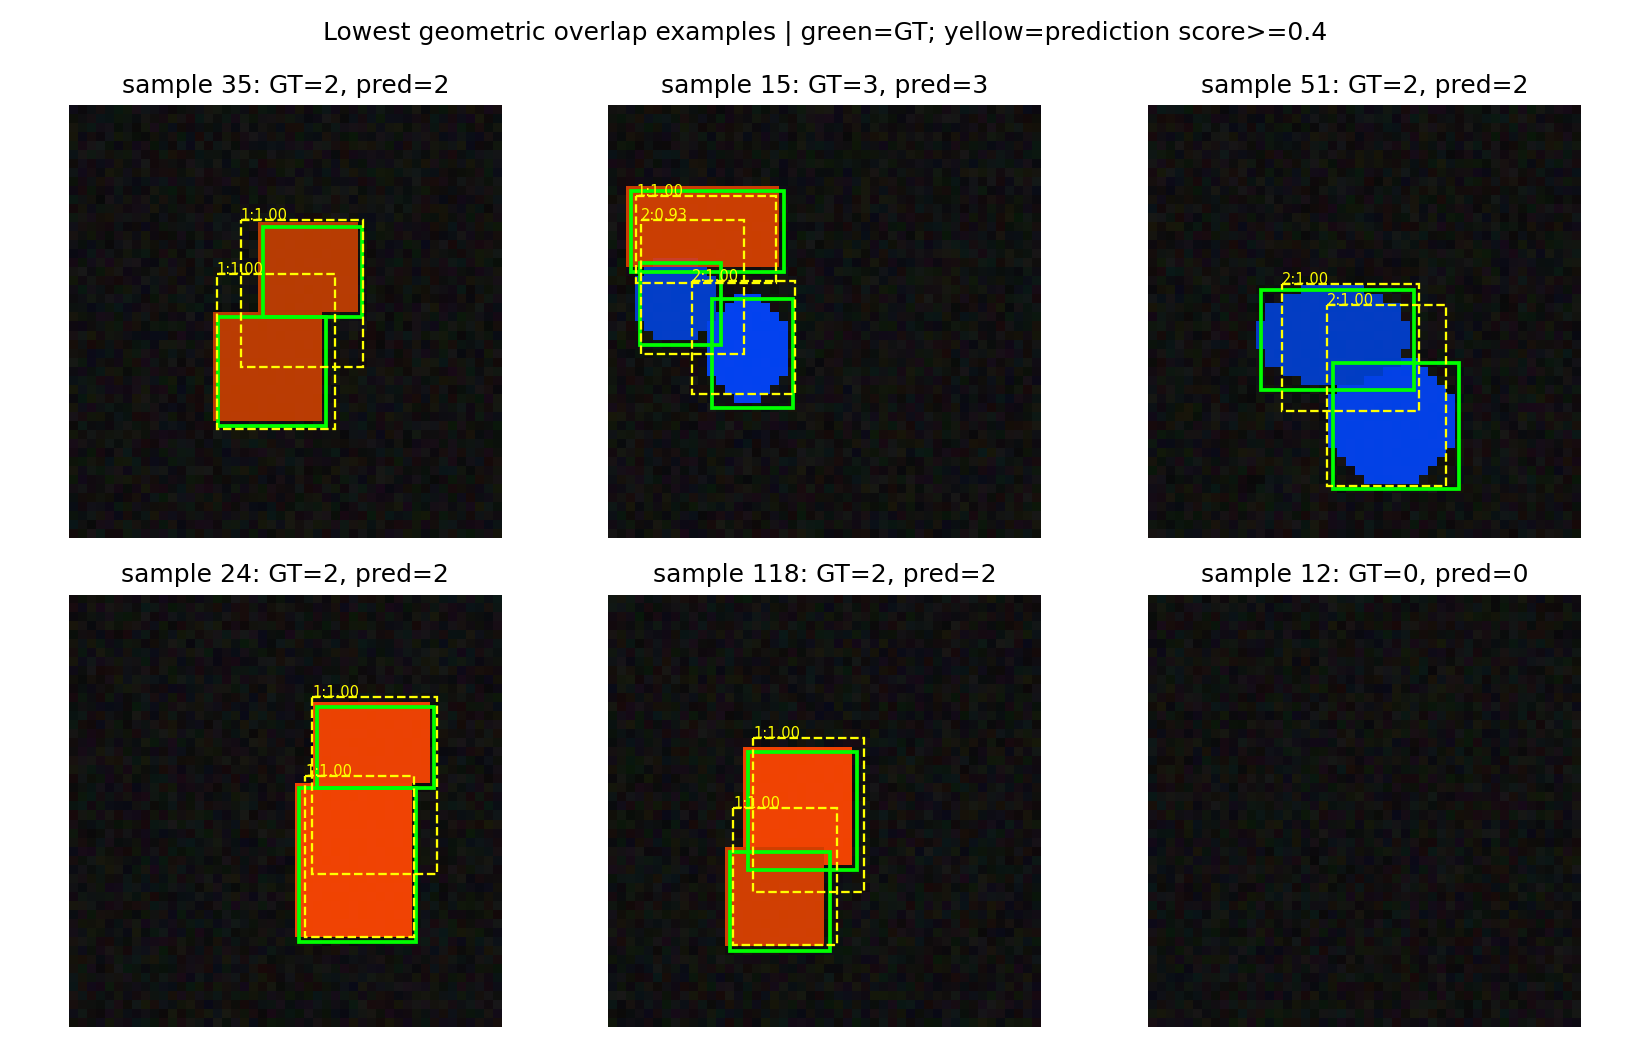
保持权重与输入不变,仅把 NMS IoU 阈值从 0.35 放宽到 0.65,AP50 变为 0.95866;展示阈值下 recall 从 0.98311 到 1.0,precision 则从 0.94175 降到 0.41926。更多预测覆盖了剩余真值,也留下大量重复框。这组结果把 NMS 的取舍落实到了同一模型,而非抽象宣称后处理总会改善成绩。
四维高斯样本上的逻辑回归仍能说明 sigmoid 分类损失和参数更新,但它没有图像和位置输出,应保留为分类热身。完整检测器给出的错误则可以进一步分解:漏检、错类、框偏、重复、空图误报、尺度外推。这些区分决定下一步该改表示、匹配、损失、解码还是数据。
即使检测框全部正确,框里的杯把空洞和两杯接触边界仍未知。下一册 CLS 08 从这个具体缺口走向逐像素和实例输出。
回看:共享卷积、RPN 与一阶段检测的计算位置
共享特征减少重复计算,但对象身份仍要保留
早期区域 CNN 为很多候选分别提特征,重复处理重叠像素。Fast R-CNN 把卷积移到整图共享阶段,再在区域内读取特征;Faster R-CNN 用 RPN 从共享特征提出候选;SSD 在多个尺度的特征图上直接预测类别和位置。这些变化围绕候选产生、特征复用和预测阶段数组织,并不意味着所有方法在任何设备或目标尺度上只有一个速度排序。Fast R-CNN · Faster R-CNN · SSD。
共享整图特征不应抹掉区域身份。同一张特征图上取左杯和右杯两个区域,仍要得到各自预测;把所有空间位置先平均成一个向量,再期待检测头重建任意细节,可能遇到表示碰撞。是否保留坐标、感受野与采样密度,应与表示的分类能力一起检查。