Lecture 03VQA:问题控制读什么,图像控制答什么
VQA:问题控制读什么,图像控制答什么
按问题继续
图像条件、teacher forcing、真实生成、greedy/beam与VQA控制
VQA:问题控制读什么,图像控制答什么
VQA建模 。同图问数量、颜色、关系,需要不同信息;同一问题换相关图像,答案也应改变。输出可为有限答案分类,也可逐词生成,二者的答案范围和评价协议不同。
图A左红右蓝:问左色答红、问右色答蓝。换成图B左蓝右红,保持左色问题则应答蓝。若“视觉”分支只读取场景字典的 left_color,它是已知属性 oracle,不是从像素感知。任务条件与VQA研究背景。
LAB 14 已有真正读取像素和问题ID的CNN问答,以及单独训练的question-only。2026-09-22本地保留180张图、每图三问共540图问对,先按图划分再扩展问题,避免同图跨切分。
| 保存条件 | 数量 | 左色 | 右形 | 全部 |
|---|---|---|---|---|
| 图像+问题 | 100% | 100% | 100% | 100% |
| question-only | 50% | 33.33% | 50% | 44.44% |
| 同模型,像素置零 | 50% | 33.33% | 50% | 44.44% |
| 同模型,循环错配图像 | 83.33% | 50% | 0% | 44.44% |
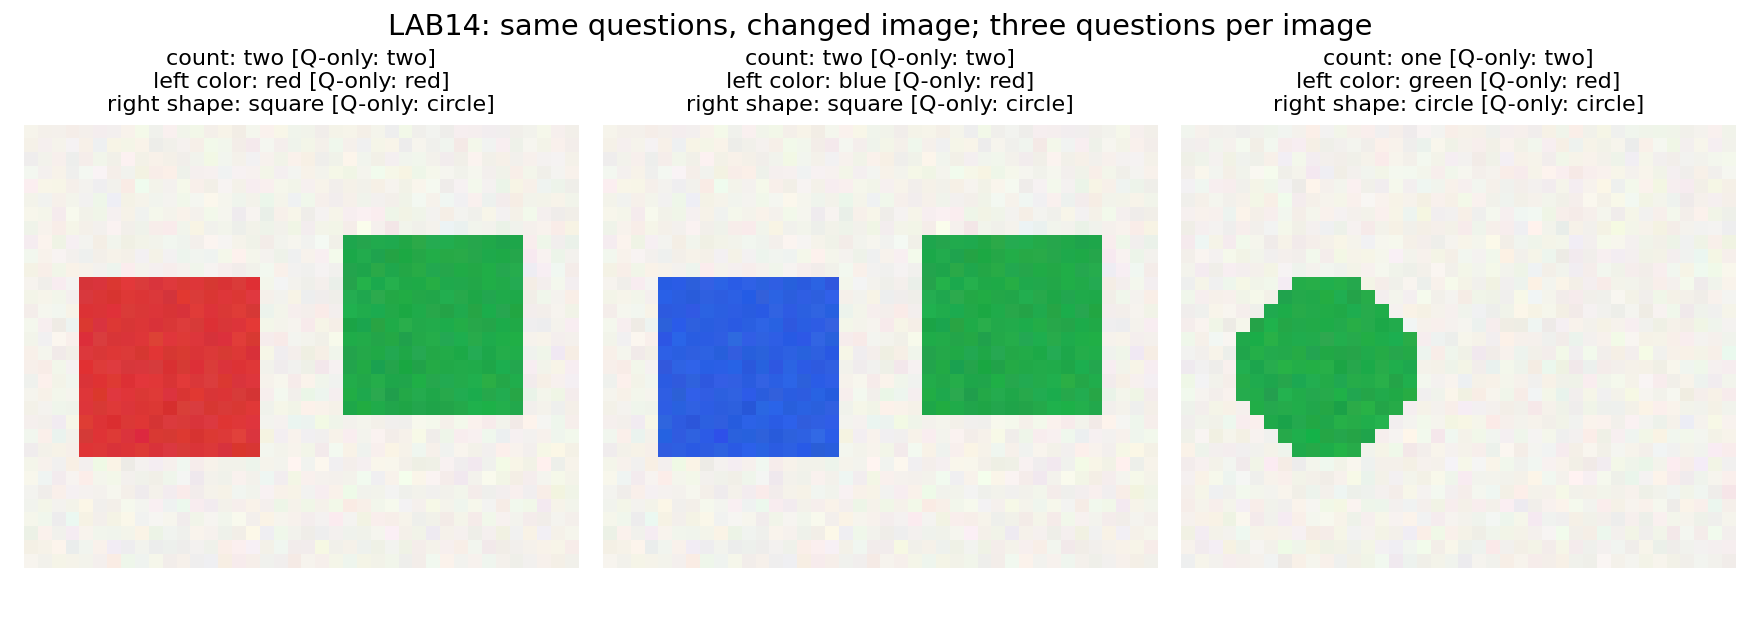
循环错配不是独立重抽,排列常保留数量却改变形状;总分相同掩盖不同错误。正确图像下的成功和干预后的下降,支持这个有限任务使用了视觉信息。问题是三个固定模板ID,不主张开放语言泛化。逐问题指标的完整解释。
备课模拟对话。 学生:“无图也有44%,图像是不是不重要?”教师:“二选一、三选一、二选一的常量率平均就是4/9;同任务视觉模型100%且错配后下降,才说明新增条件有作用。”
本轮没有重跑这些实验。Caption产生新句子,匹配返回候选分数,VQA还要根据问题选择信息。理解区别后,按需要进入CLS 10 的匹配或 CLS 11 的区域指代,不必把所有册重新读一遍。