CLS 11 · 语言定位与视觉模型接口
按问题继续
目标/参照/关系、受控图像干预、短语区域学习、分割提示及连接器
对应课堂(5 页)
可先阅读已有结果,再决定是否运行。重算时请核对各节记录的数据、参数、环境与日期。
学习路径: 一句话指向哪个对象
从P63 语言定位读到P64 视觉向量接口:语言既可以指定一个区域,也可以要求模型根据图像回答,但两者需要不同输出。
先用“蓝杯左边的杯子”分清目标、参照物和关系,再读GLIP的定位学习与原始LLaVA的两阶段连接。LAB 15是本册附属规则练习,能从像素和坐标逐步核对,不冒充预训练grounding推理。
读完应能指出错误发生在哪个接口:对象选错、区域读错,还是视觉向量未被语言模型正确使用。SAM与其他连接器按回链深入,attention内部不作为本册前置。
蓝杯是参照物,目标是它左边的杯子
cup left of blue cup 分为目标类别cup、参照物blue cup、关系left-of。左红杯框为[15,19,50,58]、中心x=32.5;右蓝杯为[109,19,144,58]、中心x=126.5;书为[60,65,90,80]。采用半开边界框,关系定义为中心x严格小于,且目标不能是参照物本身。
先找唯一蓝杯,再筛其他cup:红杯满足32.5<126.5;书虽在左但类别不符。蓝杯缺失、多义或没有唯一目标时返回无唯一目标,不用参照杯顶替。若改成“整个框都在左侧”,需另用边界比较;关系语义要先固定。完整坐标算例。
输入变化确实经过像素
LAB 15 从RGB颜色阈值和连通域提框,再执行关系规则。它读取了图像,但不是预训练神经grounding。已有2026-09-22结果如下,本轮未重跑。
| 条件 | 问句 | 目标 |
|---|---|---|
| 左红右蓝 | 蓝杯左边的杯子 | 左红 |
| 遮住左目标 | 同上 | 无唯一可见目标 |
| 只交换红蓝像素 | 同上 | 无目标,蓝参照物在最左 |
| 同一交换图改关系 | 蓝杯右边的杯子 | 右红 |
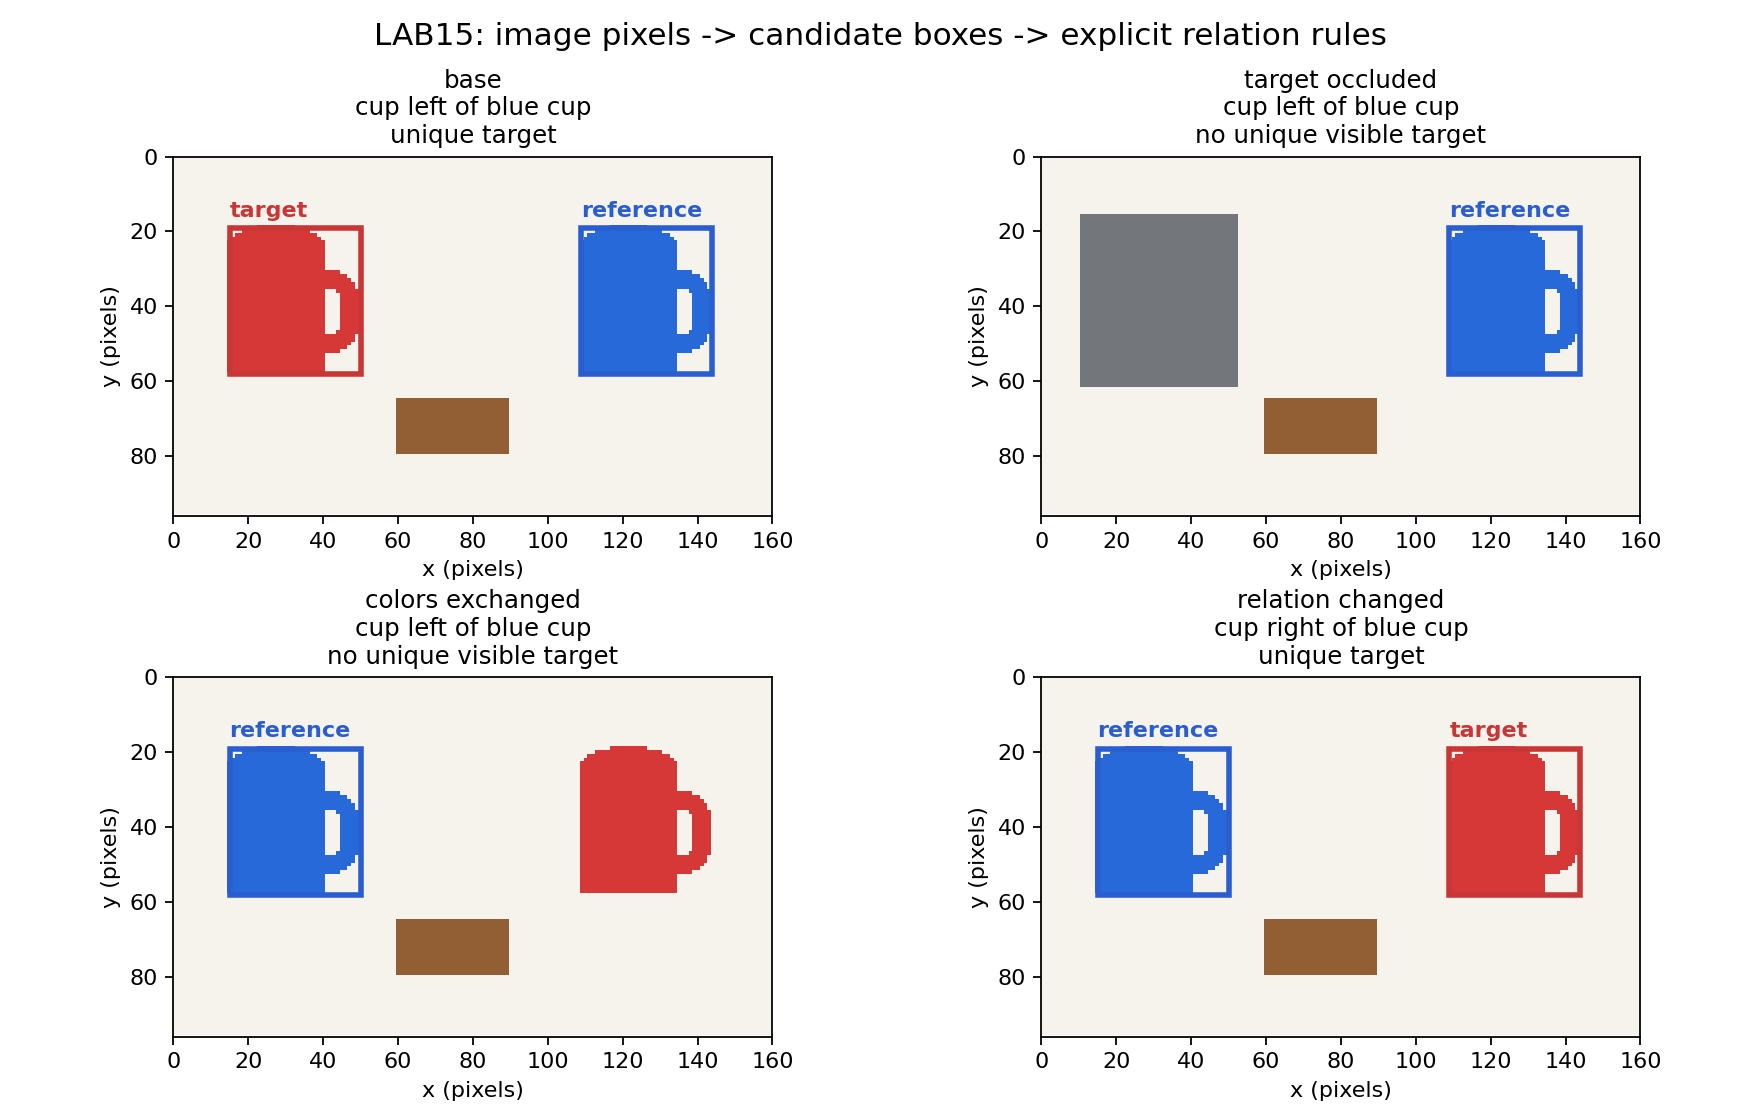
代码断言干预区域外像素不变并保存差分。旧关键词规则错选蓝杯保留为失败;颜色规则只适用于有限场景,不能扩大为任意杯子识别。干预、代码与证据身份。
GLIP 把语言接入对象级定位
GLIP 统一对象检测与短语定位,用视觉—文字交互和区域对应监督学习位置。它不是把CLIP整图分数画成框。原论文在其协议下直接评估COCO为49.8 AP、LVIS为26.9 AP,并说明预训练未使用COCO图像。这是语言感知区域表示的正面迁移证据,不是本课程图上的推理。方法、数据与论文来源。
语言定位先给框,再交分割接口时,要先核对对象身份:上游若选了蓝参照杯,后续精确分割蓝杯仍答错。目标对而边界差,才是另一段接口的问题。
原始 LLaVA 接入的是视觉向量
CLIP ViT-L/14 的网格特征经可训练线性投影接入 Vicuna,与文字指令一起预测回答。不是先压成一个对象标签,也不是将一项整图相似度输入语言模型。按行写,、,因此 。
按行堆叠 n 个视觉向量。每个向量有 d_v 个分量,因此 Z_v 是 n×d_v 矩阵;线性投影 W 是 d_v×d_l 矩阵。乘积 H_v=Z_vW 的形状是 n×d_l,视觉位置数量 n 保持不变,每个位置转换成语言模型能接收的 d_l 维向量。
CLIP的比较空间不是Vicuna的词向量空间。维度匹配保证计算合法,任务训练建立使用关系;投影不会恢复视觉前处理已丢失的小字或细节。接口的完整说明。
| 原始阶段 | 视觉编码器 | 线性投影 | 语言模型 |
|---|---|---|---|
| 特征对齐 | 冻结 | 更新 | 冻结 |
| 视觉指令 | 仍冻结 | 更新 | 更新 |
第一阶段先建立接口,第二阶段训练按图像与指令使用信息。两个阶段视觉都冻结;不能从论文“End-to-End”的标题推断视觉也更新。目标计在助手回答和停止位置,问题和图像是条件。训练范围与原论文位置。
指令中的事实仍需追溯
原始LLaVA的部分指令资料由文本GPT-4依据caption、类别和框坐标制作,该步骤没有直接看原图。随后训练LLaVA才输入原图。若记录遗漏谁接触球、杯把如何遮挡书页,长回答也不能补足监督;应补标注、改问题或承认覆盖范围。
这种数据制作能把已有图文资料转成多种交互任务,其价值不只是数量,而是定义系统练习怎样使用图像。数据来源与一个可做的检查。循环网络与attention内部留第五讲,不作为本册起步前置。
组合接口与选读边界
语言定位可以先产出框,再将框交给 SAM 一类提示式分割接口。若语言阶段把参照杯当成目标,后续 mask 可能边界很准但对象错误;若框身份正确而边界差,应检查分割与分辨率。由此把错误沿接口定位,见 提示式分割 和 语言定位到局部输出。
第五讲预备阅读。 BLIP-2 的 Q-Former、Flamingo 的视觉重采样和跨模态交互,提供与原始 LLaVA 线性投影不同的信息选择方式。它们留作接口比较,不是第三讲必须提前完成的 attention 专题。
压缩视觉向量可降低后续计算,但小字或小物体可能被丢失;提高分辨率也带来成本。判断时用同图换问、遮挡目标和关系交换等具体对照,而不把流畅回答本身当作细节保留的证明。
BLIP-2 原论文 · Flamingo 原论文。回到 三条主线的组件复用,然后进入 第四讲 · 从条件多解走向生成模型。