沿问题继续学习 CLS xx · 后续阅读:序列模型与训练资源 CLS 04 · 序列目标与规模化训练
一句描述不能像一个类别编号那样一次输出完。模型说出“红色”以后,还要决定下一个词是“杯子”还是“汽车”;说完对象,还要决定是否继续描述位置。这就把第二讲的固定输入—输出网络改造成了一个条件不断变化的预测问题。视觉课在这里需要序列模型,因为后面的 caption、VQA 和多模态接口都要交付语言;需要规模化训练,因为一种目标即使数学上成立,也必须能在给定内存和计算条件下实施。
先把三个容易混在一起的选择拆开。架构 规定如何计算,例如循环网络或 Transformer;训练目标 规定预测哪些变量、允许看到哪些条件;解码 规定拿到预测分布以后怎样产生答案。同一个循环网络可以分类一段序列,也可以逐词生成;同一个逐词目标可以用不同架构训练。换架构不等于换目标,训练时计算损失也不等于推理时搜索句子。
状态沿时间变化,参数跨时间共享
设输入词的向量为 x t x_t x t t t t h t h_t h t
h t = tanh ( W x x t + W h h t − 1 + b ) , o t = W o h t + c . h_t=\tanh(W_xx_t+W_hh_{t-1}+b),\qquad o_t=W_oh_t+c. h t = tanh ( W x x t + W h h t − 1 + b ) , o t = W o h t + c .
o t o_t o t h t h_t h t W x , W h , W o W_x,W_h,W_o W x , W h , W o
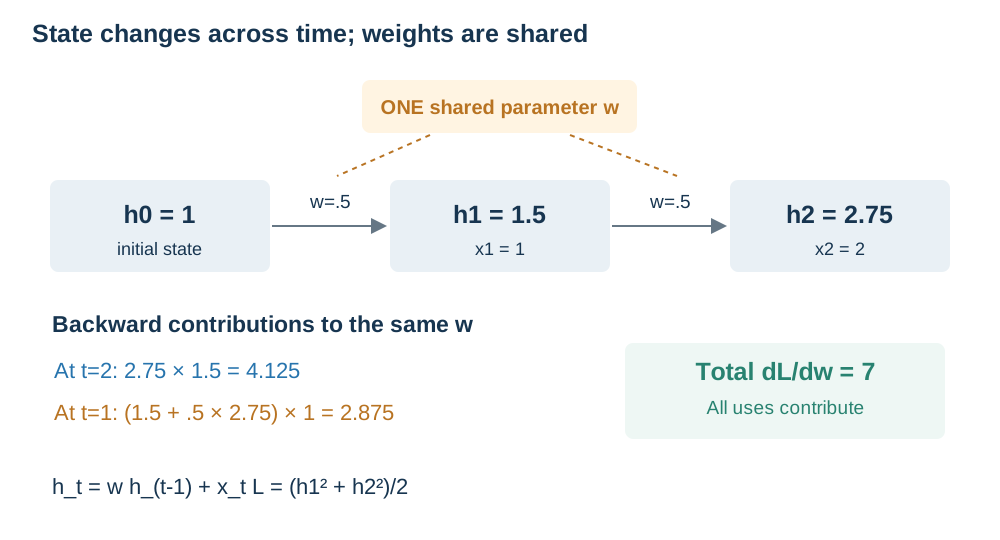
这与卷积的联系很直接:卷积核在不同空间位置 复用,RNN 的转移矩阵在不同时间位置 复用。复用减少参数,也加入归纳假设:相同局部计算规则可以跨位置应用。一个参数在计算图中出现多次,最终梯度就要把每次出现的贡献加起来。时间共享还多了一层依赖:较早状态会影响较晚状态,因此后面的损失也要沿状态链传回。
看一个完全可手算的标量 RNN,暂时去掉 tanh \tanh tanh h t = w h t − 1 + x t h_t=wh_{t-1}+x_t h t = w h t − 1 + x t h 0 = 1 , w = 0.5 , x 1 = 1 , x 2 = 2 h_0=1,w=0.5,x_1=1,x_2=2 h 0 = 1 , w = 0.5 , x 1 = 1 , x 2 = 2 h 1 = 1.5 , h 2 = 2.75 h_1=1.5,h_2=2.75 h 1 = 1.5 , h 2 = 2.75 L = ( h 1 2 + h 2 2 ) / 2 = 4.90625 L=(h_1^2+h_2^2)/2=4.90625 L = ( h 1 2 + h 2 2 ) /2 = 4.90625
∂ h 1 ∂ w = 1 , ∂ h 2 ∂ w = h 1 + w ∂ h 1 ∂ w = 2 , \frac{\partial h_1}{\partial w}=1,\qquad
\frac{\partial h_2}{\partial w}=h_1+w\frac{\partial h_1}{\partial w}=2, ∂ w ∂ h 1 = 1 , ∂ w ∂ h 2 = h 1 + w ∂ w ∂ h 1 = 2 ,
所以 ∂ L / ∂ w = 1.5 × 1 + 2.75 × 2 = 7 \partial L/\partial w=1.5\times1+2.75\times2=7 ∂ L / ∂ w = 1.5 × 1 + 2.75 × 2 = 7 2.75 × 1.5 = 4.125 2.75\times1.5=4.125 2.75 × 1.5 = 4.125 h 1 h_1 h 1
图中同一个 w w w
长序列会形成很多 Jacobian 连乘;乘积反复收缩或放大,分别造成梯度衰减或爆炸。截断 BPTT 在片段边界停止跨片段梯度,可以保留前向状态,但改变了被计算的梯度。梯度裁剪限制更新幅度;LSTM/GRU 改变状态通路。三种办法针对不同问题,不能把“记住更长上下文”全部归给显存增大。推导可对照 D2L §9.7:BPTT 的共享参数与梯度 。
数据怎样自己提供下一个预测目标
对句子“红色 杯子”,在两端加开始与结束符后得到 [BOS, 红色, 杯子, EOS]。训练输入是前三项,目标是后三项:
位置
已知前缀
要预测的词
1
BOS
红色
2
BOS 红色
杯子
3
BOS 红色 杯子
EOS
负对数似然为 − ∑ t log p θ ( y t ∣ y < t ) -\sum_t\log p_\theta(y_t\mid y_{<t}) − ∑ t log p θ ( y t ∣ y < t )
训练常把真实前缀送给模型,即 teacher forcing。推理没有真实后续词,只能把自身生成的词继续送回,错误便可能改变后续条件。这个训练—使用差异将在 CLS 10 中用真实解码展开。对于遮挡预测,条件可以同时来自被遮挡位置的左、右上下文;它仍有明确的目标,但与左到右条件分解不同,不能直接把遮挡损失当作自回归句子概率。
同一次更新分到两台设备,平均什么
令设备 r r r n r n_r n r g r g_r g r
g = ∑ r n r g r ∑ r n r . g=\frac{\sum_r n_rg_r}{\sum_r n_r}. g = ∑ r n r ∑ r n r g r .
设备甲用 2 个样本得到 g 1 = ( 2 , 4 ) g_1=(2,4) g 1 = ( 2 , 4 ) g 2 = ( 6 , 0 ) g_2=(6,0) g 2 = ( 6 , 0 ) g = ( 5 , 1 ) g=(5,1) g = ( 5 , 1 ) ( 4 , 2 ) (4,2) ( 4 , 2 ) θ = ( 1 , 2 ) \theta=(1,2) θ = ( 1 , 2 ) ( 0.5 , 1.9 ) (0.5,1.9) ( 0.5 , 1.9 )
序列任务还要问分母是什么。如果甲、乙各有两个句子,但有效目标 token 分别为 10 和 30,token 平均损失 应按 10:30 加权;按句子平均则是另一个目标。不能只看 batch 中有几行,就决定归并权重。
梯度累积使用多个 microbatch 的反向结果,在参数不更新的前提下累积到一次更新。它与大 batch 等价还需要:相同总损失归一化、相同参数、可加的样本损失,以及一致的随机性和状态处理。BatchNorm 统计会依赖 microbatch;对比学习的分母包含同批其他样本,拆批会改变负例集合。因此“累积四次就得到四倍对比 batch”通常不成立。见 D2L §13.5 数据并行计算与同步 ,并在 LAB 19 改变样本数核对。
参数装得下,训练为什么仍会溢出
以 1000 万参数、全部 FP32 的 Adam 为例:权重 40 MB,梯度 40 MB,一阶矩与二阶矩合计 80 MB,仅这四项就是 160 MB。这里 MB 按 10 6 10^6 1 0 6
激活常随 batch、分辨率、序列长度增加。纯数据并行复制训练状态,主要增加可处理数据量;状态分片减少每个设备长期持有的状态;激活检查点以重新计算换取较少保存;梯度累积改变每次前向的样本数。每种策略都把压力移到别处,可能增加通信、重计算或等待。ZeRO 原论文 讨论的正是训练状态冗余,而非只压缩 checkpoint。
本册的最短实验路径是 LAB 18:状态与预测 → LAB 19 → LAB 20:内存预算 。三者分别检验计算图、全局目标和资源假设。回到 CLS 01 ,现在可以具体回答:数据变多没有改变链式法则,却会迫使我们改变目标组织、状态保存和通信方式。
CLS 04 · 重建:约束、位置与表示评价 CLS 05 · 重建:词典、PCA、自编码器与 MAE
如果不提供“猫”“杯子”这样的类别标签,图像还有什么可以当答案?最直接的是图像自身:把它压缩、破坏或遮住一部分,再让模型恢复。困难不在于是否有监督数值,而在于我们允许模型怎样取得它。把输入原样复制到输出可以获得零误差,却没有迫使模型形成有用的表示。重建方法之间真正改变的是限制条件:代码可以取什么值、信息从哪里通过、哪些位置可见,以及误差计算在哪里。
同样是压缩,离散词典与线性子空间留下不同东西
把一个 2 × 2 2\times2 2 × 2 x ∈ R 4 x\in\mathbb R^4 x ∈ R 4 K K K c k c_k c k
a ( x ) = arg min k ∥ x − c k ∥ 2 , x ^ = c a ( x ) . a(x)=\arg\min_k\|x-c_k\|^2,\qquad \hat x=c_{a(x)}. a ( x ) = arg k min ∥ x − c k ∥ 2 , x ^ = c a ( x ) .
若词典恰为 c 1 = ( 1 , 0 , 1 , 0 ) c_1=(1,0,1,0) c 1 = ( 1 , 0 , 1 , 0 ) c 2 = ( 0 , 1 , 0 , 1 ) c_2=(0,1,0,1) c 2 = ( 0 , 1 , 0 , 1 ) ( 0.5 , 0.5 , 0.5 , 0.5 ) (0.5,0.5,0.5,0.5) ( 0.5 , 0.5 , 0.5 , 0.5 ) log 2 K \log_2 K log 2 K K K K LAB 05 在真实 MNIST patch 上进行 Lloyd 拟合,可查看中心怎样随数据形成,而非只背“无监督”这个标签。
PCA 改用连续线性坐标。对已减去均值的 x x x U ∈ R d × k U\in\mathbb R^{d\times k} U ∈ R d × k z = U T x z=U^Tx z = U T x x ^ = U z \hat x=Uz x ^ = U z k k k
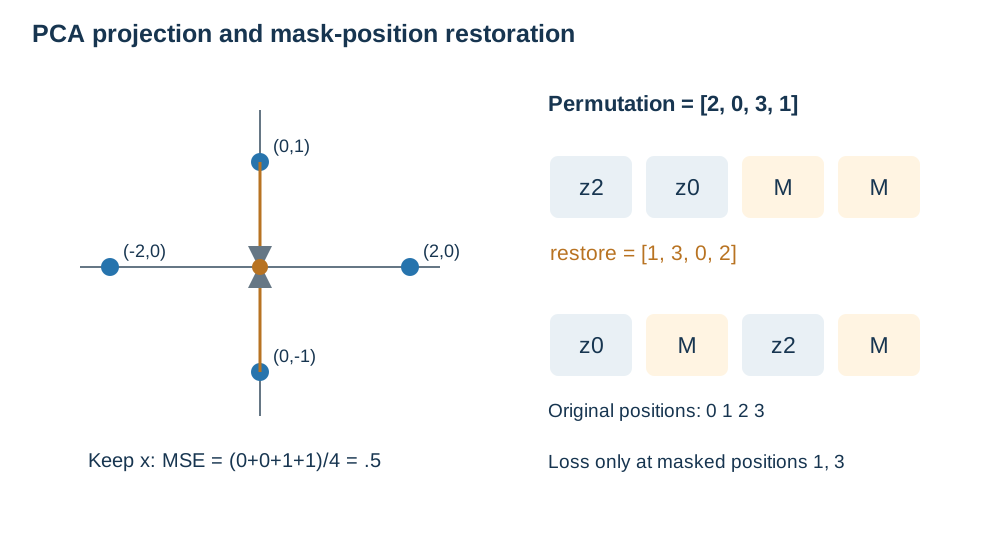
用四点 ( 2 , 0 ) , ( − 2 , 0 ) , ( 0 , 1 ) , ( 0 , − 1 ) (2,0),(-2,0),(0,1),(0,-1) ( 2 , 0 ) , ( − 2 , 0 ) , ( 0 , 1 ) , ( 0 , − 1 ) 1 / 4 1/4 1/4 d i a g ( 2 , 0.5 ) \mathrm{diag}(2,0.5) diag ( 2 , 0.5 ) ( 2 , 0 ) , ( − 2 , 0 ) , ( 0 , 0 ) , ( 0 , 0 ) (2,0),(-2,0),(0,0),(0,0) ( 2 , 0 ) , ( − 2 , 0 ) , ( 0 , 0 ) , ( 0 , 0 ) 0 , 0 , 1 , 1 0,0,1,1 0 , 0 , 1 , 1
左图按真实坐标画出四点和一维投影;右图展示 patch 的乱序、可见项与恢复位置。两者都在重建,但一个限制子空间,一个限制输入可见性。
PCA 为什么可以看成受约束的线性自编码器
自编码器由 z = f θ ( x ) z=f_\theta(x) z = f θ ( x ) x ^ = g ϕ ( z ) \hat x=g_\phi(z) x ^ = g ϕ ( z ) ∥ x − x ^ ∥ 2 \|x-\hat x\|^2 ∥ x − x ^ ∥ 2 f ( x ) = U T x , g ( z ) = U z f(x)=U^Tx,g(z)=Uz f ( x ) = U T x , g ( z ) = U z U T U = I U^TU=I U T U = I
所以 SVD 可以精确说明一种线性自编码约束,但 SVD 本身没有执行一个另行承诺的非线性网络训练。引入非线性编码器和解码器以后,表示可以适应弯曲的数据结构;也可能凭较大容量记忆训练样本。瓶颈维数、正则化、跳连是否绕过瓶颈、训练与保留误差,都影响我们能否把低损失解释为学到了结构。
去噪自编码器进一步改变训练对:先从破坏分布采样 x ~ ∼ q ( x ~ ∣ x ) \tilde x\sim q(\tilde x\mid x) x ~ ∼ q ( x ~ ∣ x ) E ∥ g ( f ( x ~ ) ) − x ∥ 2 \mathbb E\|g(f(\tilde x))-x\|^2 E ∥ g ( f ( x ~ )) − x ∥ 2 去噪自编码器原论文 中,破坏过程正是组织表示学习的一个关键约束。
平方误差还有一个值得记住的性质:最佳预测是给定输入后的条件均值。若一个被遮挡像素在其余条件相同下等概率为 0 或 1,输出 0.5 的平均平方误差是 0.25,而总是输出 0 或 1 的误差是 0.5。模糊有时来自目标的统计偏好,不一定只是网络没有优化好。下一讲讨论采样时会重新遇到这个问题。
MAE 让昂贵编码器只看少量位置
把图像切为 patch 后,MAE 随机选择可见子集,编码器只处理可见 patch 及其位置;轻量解码器补入 mask token,恢复完整位置顺序,再预测被遮挡的像素目标。原 MAE 的一个关键设计是高遮挡率与这种不对称编码—解码结构,见 MAE §3 与图 1 。这里不是先让编码器看完整图,再在输出端涂黑几块。
四个原始位置是 [0,1,2,3]。随机排列 ids_shuffle=[2,0,3,1],只保留前两项,所以编码器看到原位置 2、0。解码器先得到 [z2,z0,M,M],再用逆排列 ids_restore=[1,3,0,2] 取回 [z0,M,z2,M]。位置 1、3 的损失可以按
L = 1 ∣ M ∣ ∑ i ∈ M ∥ x ^ i − x i ∥ 2 L=\frac{1}{|\mathcal M|}\sum_{i\in\mathcal M}\|\hat x_i-x_i\|^2 L = ∣ M ∣ 1 i ∈ M ∑ ∥ x ^ i − x i ∥ 2
计算,其中 M \mathcal M M
再看计算:16 个 patch 只保留 4 个,编码器注意力的成对位置数由 16 2 = 256 16^2=256 1 6 2 = 256 4 2 = 16 4^2=16 4 2 = 16
方法
输入受什么限制
代码/表示约束
重建好能支持什么判断
K-means 词典
通常看到完整 patch
一个中心索引
该词典的量化误差小
PCA
通常看到完整向量
低维线性子空间
方差被线性子空间有效保留
去噪自编码器
看到明确破坏后的图
架构、瓶颈及正则化
对指定破坏能恢复保留图像
MAE
编码器只看可见 patch
可见位置及编码—解码设计
能利用上下文预测遮挡目标
这四行都没有自动回答“少量标签能否读出类别”“颜色是否保留”“边界是否准确”。那些是另设的评价问题。LAB 08 把索引检查与图像重建分开:先确认输入—mask—目标位置,再比较输入、重建和误差,最后冻结编码器作读出。划分必须先按原图进行,再生成破坏版本;否则同一原图的干净版和带噪版可能分居训练与测试,给出过于乐观的结果。
已运行的图像重建:恢复更好,表示评价另算
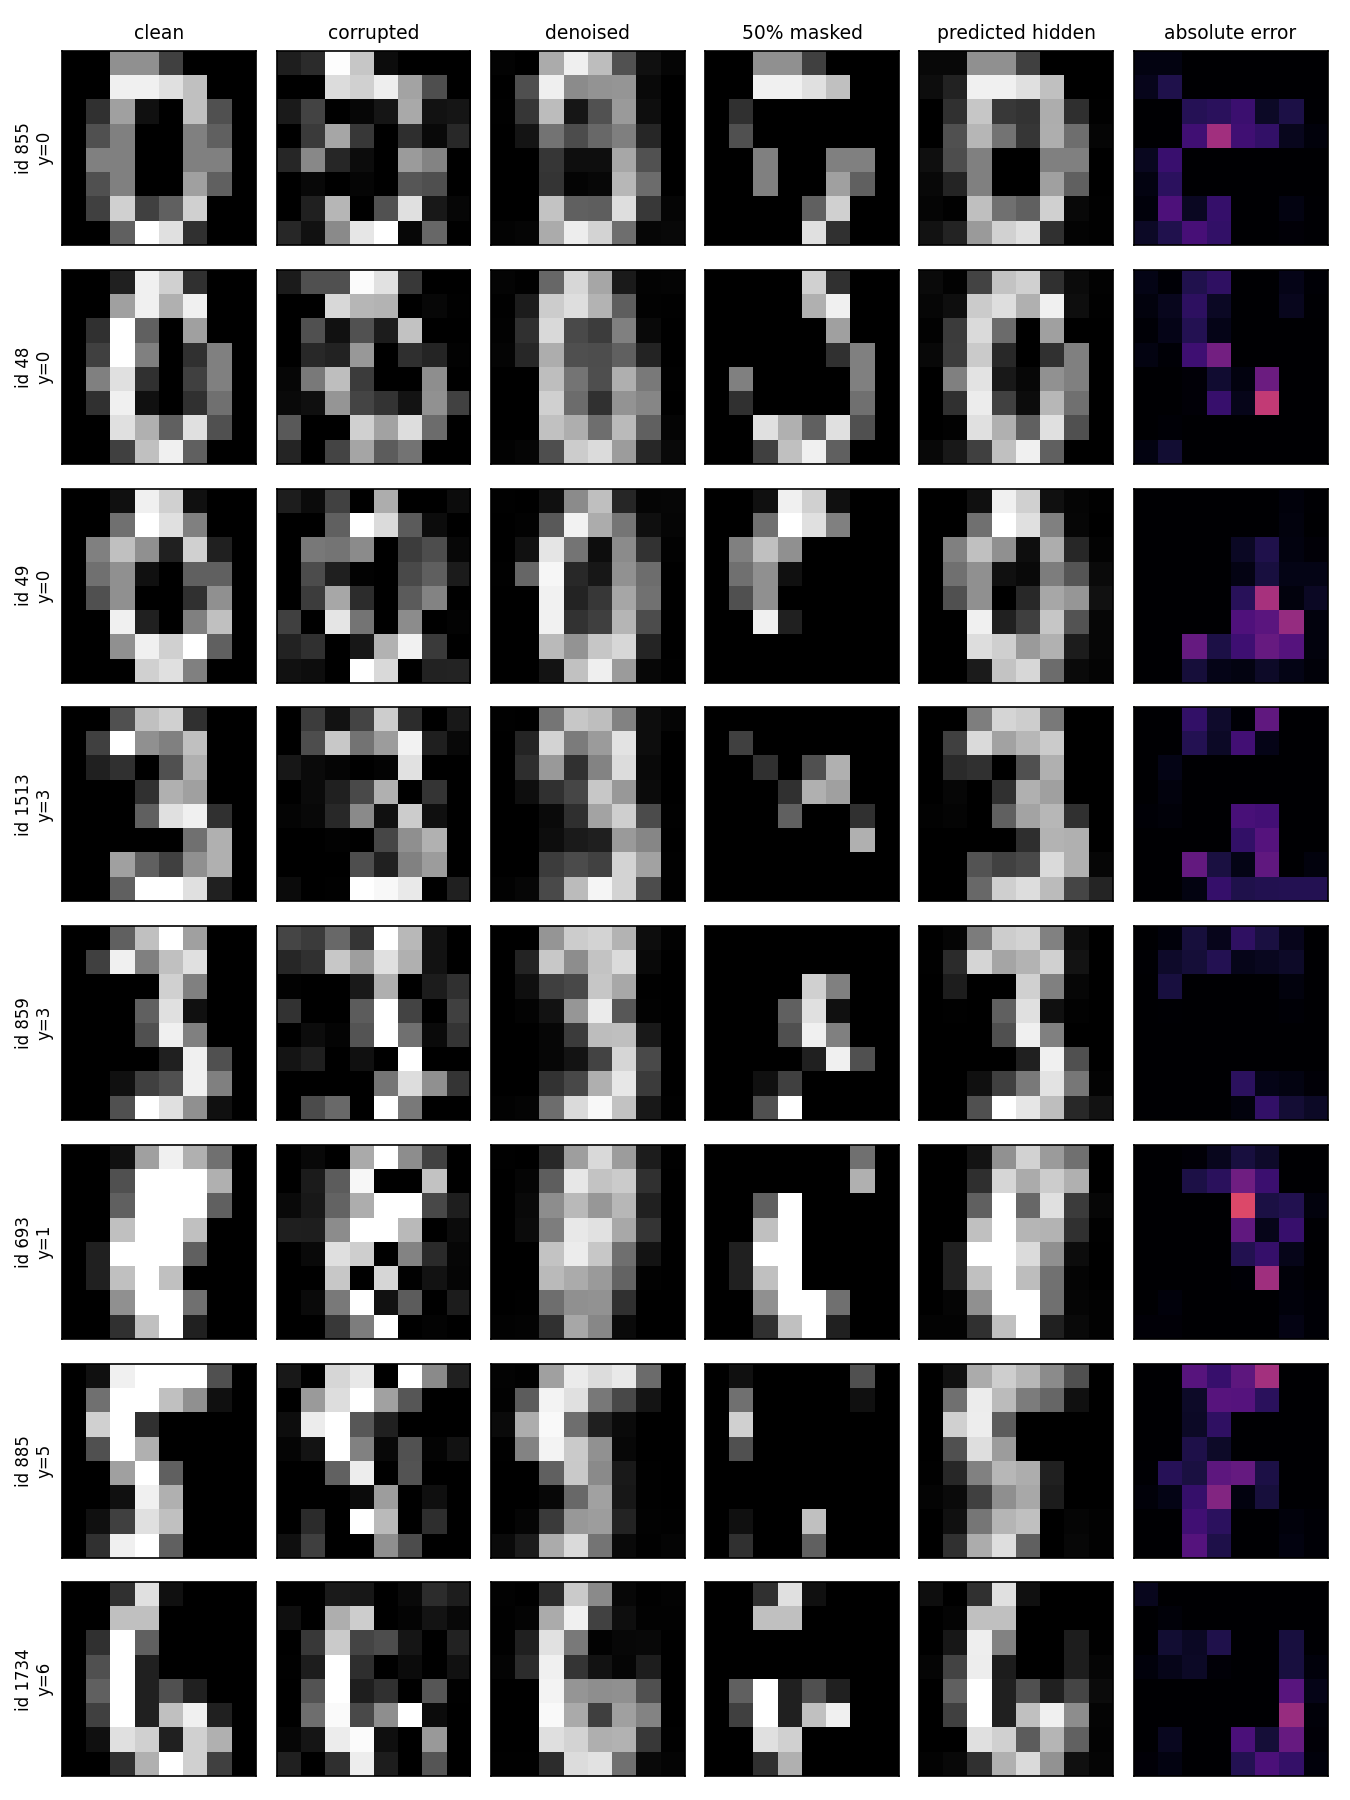
LAB 08 在 2026-09-22 本地 CPU 从头训练卷积自编码器。数据是 sklearn load_digits 的 1797 张 8×8 灰度图,先按原图分层随机划分 1257 训练、540 保留,再生成破坏;没有按书写者分组,因此结论是这个原图随机划分下的数字任务。标签只用于划分与读出,不进入重建损失。16 维瓶颈的去噪网络训练 40 epoch,破坏为 25% 像素丢弃加标准差 0.15 的高斯噪声并裁到 [0,1]。
保留集方法
与干净目标的逐像素 MSE
直接使用带噪输入
0.06244
训练集拟合的 rank-16 PCA 重建
0.04160
学到的卷积去噪自编码器
0.03217
另一个两通道卷积模型接收“被遮挡图像+可见性 mask”,在 50% 的 2×2 patch 隐藏率下训练 50 epoch。它处理整张密集网格,不是原论文只编码可见 token 的 ViT MAE 。固定每图同一排列、让隐藏集合嵌套,测试 25%/50%/75% 遮挡时,隐藏位置 MSE 分别为 0.03933/0.04341/0.05563;相应训练均值基线为 0.07420/0.07402/0.07390。遮挡增加后重建变难,但这个卷积模型并未获得 MAE 的可见 token 计算节省。
冻结编码器、输入干净保留图像作 5NN,去噪架构由随机初始化的 84.26% 到训练后的 95.00%;遮挡架构由 88.52% 到 92.04%。两种架构输入通道不同,随机基线也应分别保留,不能把它们混成同一个起点。重建改善和读出改善在这次实验中同时出现,但它们仍是两项独立测量。配置、输入 hash 与权重均在 LAB 08 对应材料中。
重建为“保存信息”提供了可计算目标;下一册 CLS 06 会主动要求某些变化在表示中不产生差异。二者的张力是具体的:准确重建颜色需要留下颜色,颜色不变的对比目标却可能鼓励忽略它。好的表示要服务什么,必须由下游问题回答。
CLS 05 · 对比学习:视图、投影与历史字典 CLS 06 · 对比学习、队列与评价协议
拍同一只杯子,改变光照、裁剪和背景,类别仍然是杯子。若能把这些变化视为同一对象的不同观察,训练目标就可以来自图像自身:两次观察的表示应该接近,其他图像的表示提供区分参照。但如果下一项任务是分辨红杯和蓝杯,“改变颜色仍然算同一个”就不再无害。对比学习的正例关系,是设计者通过数据和增强作出的任务假设。 它不是无标签数据自动告诉我们的普遍相同性。
从两张视图到一个可微分的选择题
给原图 x x x t , t ′ t,t' t , t ′ v = t ( x ) , v + = t ′ ( x ) v=t(x),v^+=t'(x) v = t ( x ) , v + = t ′ ( x ) f θ f_\theta f θ h = f θ ( v ) h=f_\theta(v) h = f θ ( v ) g ϕ g_\phi g ϕ z = g ϕ ( h ) z=g_\phi(h) z = g ϕ ( h ) ℓ 2 \ell_2 ℓ 2 s ( q , k ) = q T k s(q,k)=q^Tk s ( q , k ) = q T k
对一个 query q q q k + k^+ k + k j − k_j^- k j −
L q = − log exp ( s ( q , k + ) / τ ) exp ( s ( q , k + ) / τ ) + ∑ j exp ( s ( q , k j − ) / τ ) . L_q=-\log\frac{\exp(s(q,k^+)/\tau)}{\exp(s(q,k^+)/\tau)+\sum_j\exp(s(q,k_j^-)/\tau)}. L q = − log exp ( s ( q , k + ) / τ ) + ∑ j exp ( s ( q , k j − ) / τ ) exp ( s ( q , k + ) / τ ) .
这里 τ > 0 \tau>0 τ > 0
SimCLR 的一个 batch 有 N N N 2 N 2N 2 N 2 N − 1 2N-1 2 N − 1 2 N − 2 2N-2 2 N − 2 SimCLR §2、式 1 与 Algorithm 1 。
温度改变竞争强度,不改变这组相似度的排序
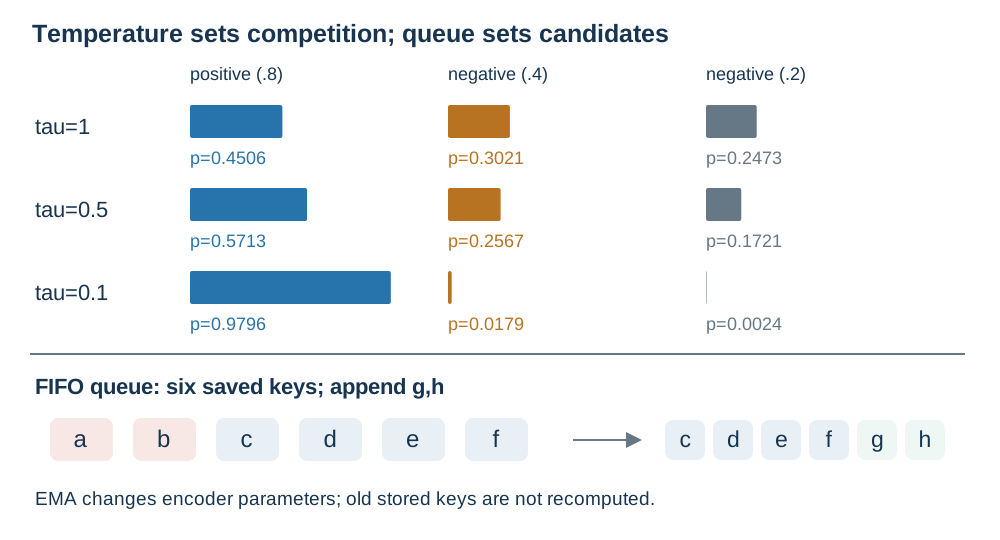
固定三项相似度:正例 0.8,两个负例 0.4、0.2。直接代入上式得到:
温度 τ \tau τ
正例概率
负例 0.4 的概率
负例 0.2 的概率
损失 − log p + -\log p_+ − log p +
1.0
0.4506
0.3021
0.2473
0.7971
0.5
0.5713
0.2567
0.1721
0.5599
0.1
0.9796
0.0179
0.0024
0.0206
因为正例已经领先,低温度放大它的优势。若把正例改成 0.3、最强负例仍为 0.4,低温度则会更强地惩罚错误排序。不能仅因降低温度使这张表的损失变小,就宣称表示更好了。
梯度把这个现象写得更精确。令 p j p_j p j
∂ L ∂ s + = p + − 1 τ , ∂ L ∂ s j − = p j τ . \frac{\partial L}{\partial s_+}=\frac{p_+-1}{\tau},\qquad
\frac{\partial L}{\partial s_j^-}=\frac{p_j}{\tau}. ∂ s + ∂ L = τ p + − 1 , ∂ s j − ∂ L = τ p j .
温度既出现在 1 / τ 1/\tau 1/ τ p p p τ = 0.5 \tau=0.5 τ = 0.5
上半图按表中真实计算值画出候选概率;下半图是长度 6 的 FIFO 队列,加入两个新 key 后移出两个最老 key。温度控制一次比较,队列控制比较对象从哪里来。
为什么损失作用在 z,迁移却常读 h
假设 h = ( u , c ) h=(u,c) h = ( u , c ) u u u c c c u u u c c c h h h g ( h ) = u g(h)=u g ( h ) = u z z z h h h 可行性构造 ,不是声称真实网络一定学成两根独立坐标。
损失计算在 z z z ∂ L / ∂ θ = ( ∂ L / ∂ z ) ( ∂ z / ∂ h ) ( ∂ h / ∂ θ ) \partial L/\partial\theta=(\partial L/\partial z)(\partial z/\partial h)(\partial h/\partial\theta) ∂ L / ∂ θ = ( ∂ L / ∂ z ) ( ∂ z / ∂ h ) ( ∂ h / ∂ θ )
在 LAB 06 中,应同时检查颜色/形状任务、增强设置和 h / z h/z h / z
队列解决候选数量,EMA 缓和特征坐标系漂移
当前 batch 较小时,每个 query 可比较的负例有限。MoCo 把近期 batch 的 key 特征保存为队列,下一批仍可使用,因而字典大小不完全受当前 batch 限制。长度 6 的队列从 [a,b,c,d,e,f] 加入 [g,h] 后成为 [c,d,e,f,g,h]。里面存的是先前编码好的向量;它不保存那些图片的完整计算图,也不在每一步重算所有旧向量。
这节省了候选编码计算,却产生一致性问题。若编码器每步剧烈变化,昨天向量的某个方向和今天向量的同一方向可能不再表达类似内容。MoCo 使用 query 编码器参数 θ q \theta_q θ q
θ k ← m θ k + ( 1 − m ) θ q . \theta_k\leftarrow m\theta_k+(1-m)\theta_q. θ k ← m θ k + ( 1 − m ) θ q .
取 m = 0.9 m=0.9 m = 0.9 θ k = ( 0 , 2 ) \theta_k=(0,2) θ k = ( 0 , 2 ) θ q = ( 2 , 4 ) \theta_q=(2,4) θ q = ( 2 , 4 ) ( 0.2 , 2.2 ) (0.2,2.2) ( 0.2 , 2.2 ) ( 0.38 , 2.38 ) (0.38,2.38) ( 0.38 , 2.38 ) 网络参数 ,不是队列向量,也不是 Adam 的梯度动量;旧 key 不会因这一步 EMA 自动刷新。m = 0 m=0 m = 0 m = 1 m=1 m = 1 MoCo §3 与 Algorithm 1 给出队列、动量编码器和停止 key 分支梯度的配合。
组织方式
候选从哪里来
是否保留旧特征
主要计算取舍
SimCLR 批内比较
当前 batch 的两视图
不需要队列
更多候选通常要求更大 batch 及其通信/激活
MoCo 字典
当前正例与历史 key 队列
是
候选数与 batch 部分解耦,需控制 key 漂移
这是计算组织的不同答案,不是一个方法必然取代另一个。扩大队列会让最旧特征更老;增大 batch 会改变优化与负例分布;调整温度则改变同一批候选如何竞争。做消融时不能三项同时改,再把收益全部归给 EMA。
训练学会区分视图以后,还要回答哪个下游问题
冻结线性评价(linear probe)先固定编码器 f f f y ^ = W h + b \hat y=Wh+b y ^ = W h + b k k k f f f
完整协议至少明确:原始样本的训练/验证/测试划分,预训练是否接触无标签测试图,冻结时的 eval/BatchNorm 状态,读 h h h z z z
同一个颜色干预,真的改变了学到的表示
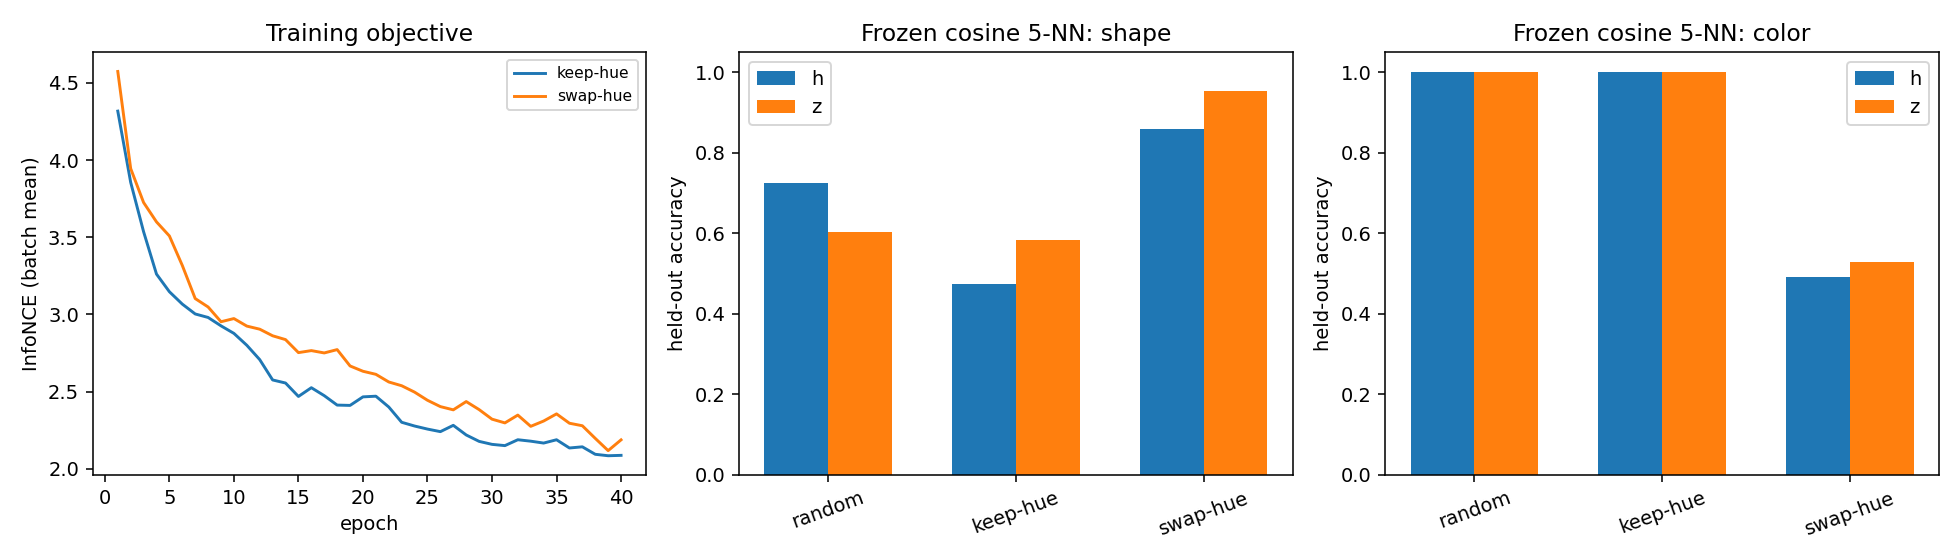
LAB 06 已在 2026-09-22 本地 CPU 完成真实两视图训练:600 张训练图、240 张保留图,RGB 16×16,卷积编码器输出 48 维 h h h z z z
表示与训练
形状 5NN
颜色 5NN
随机编码器 h h h
72.50%
100.00%
保留颜色增强,训练后 h h h
47.50%
100.00%
随机换色增强,训练后 h h h
85.83%
49.17%
随机换色增强,训练后 z z z
95.42%
52.92%
保留颜色时模型可利用容易的颜色区别,形状 5NN 甚至低于随机表示;换色使这种线索不可靠,形状读出提高、颜色读出接近二类机会水平。h h h h h h z z z z z z h h h
LAB 07 的小型 MoCo 使用同一图像来源、真实 FIFO 特征队列与 EMA key 编码器,训练 15 epoch。其 h h h
LAB 07 把队列/EMA 精确算例和图像两视图训练放在同一条学习链中。阅读训练输出时,先确认参数确实由损失更新,再比较相同协议下随机初始化与训练后表示;若小数据上的自监督结果没有领先,就讨论增强、数据量和读出限制,而不改变测试口径。
从 CLS 05 的重建 到本册,目标从恢复像素变为识别视图关系;下一册 CLS 07 再问:没有显式负例时,为什么表示没有全部变成同一个常量?这些路线共同要求我们区分训练信号、实际优化以及表示的使用证据。
CLS 06 · 表示的三个检查:目标、信息与新域 CLS 07 · 教师、信息、迁移与域变化
对比学习用负例阻止所有样本挤成一点。如果去掉负例,只让同图两视图接近,常量表示 f ( x ) = c f(x)=c f ( x ) = c 模型容易满足的条件 和我们真正需要的能力 。
教师不一定是更大的模型,也不一定提供真值
传统知识蒸馏用训练好的教师给学生提供输出分布。教师 logits a = ( 4 , 2 , 0 ) a=(4,2,0) a = ( 4 , 2 , 0 ) T T T q i = exp ( a i / T ) / ∑ j exp ( a j / T ) q_i=\exp(a_i/T)/\sum_j\exp(a_j/T) q i = exp ( a i / T ) / ∑ j exp ( a j / T ) T = 1 T=1 T = 1 ( 0.8668 , 0.1173 , 0.0159 ) (0.8668,0.1173,0.0159) ( 0.8668 , 0.1173 , 0.0159 ) T = 2 T=2 T = 2 ( 0.6652 , 0.2447 , 0.0900 ) (0.6652,0.2447,0.0900) ( 0.6652 , 0.2447 , 0.0900 ) − ∑ i q i log p i -\sum_iq_i\log p_i − ∑ i q i log p i
蒸馏常把软目标项与真实标签项结合,并对温度目标作 T 2 T^2 T 2 Hinton 等,2015:蒸馏与温度软目标 。
自监督教师则可以来自学生自身的历史参数。以 EMA 教师为例,教师参数 ξ ← m ξ + ( 1 − m ) θ \xi\leftarrow m\xi+(1-m)\theta ξ ← m ξ + ( 1 − m ) θ
设计
谁产生目标
目标是否随学生训练变化
一项必须核对的风险
固定教师蒸馏
已训练模型
通常不变
教师错误和偏差会被模仿
EMA 自监督教师
学生参数的移动平均
平滑变化
常量解或退化解是否受到约束
人工类别监督
标注规则与标注者
数据集内通常固定
类别集合遗漏与标注噪声
BYOL 使用在线/目标网络、预测器和停止梯度等不对称设计;DINO 使用教师—学生分布匹配,并结合 centering、sharpening 等机制。它们给出了不显式使用负例也能学表示的实证路线。BYOL · DINO 。不能把结果压缩成“EMA 单独保证不坍塌”:若随意删掉预测器、改变归一化或温度,系统已不是论文中的训练组合;只观察训练损失也识别不了所有退化。
先用三个量区分坍塌与无用读出
若一批表示全部为 ( 1 , 1 ) (1,1) ( 1 , 1 )
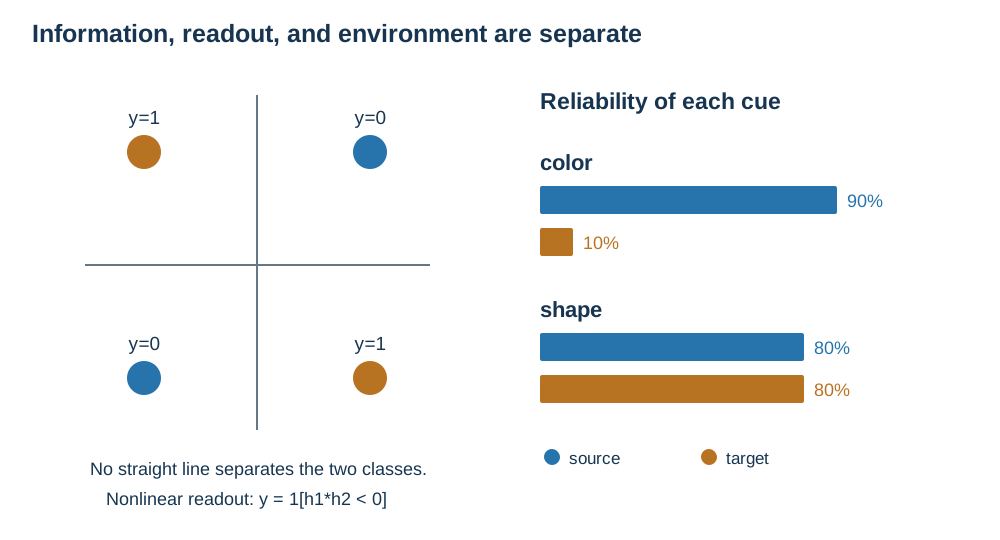
用四个等概率输入 h ∈ { ( − 1 , − 1 ) , ( − 1 , 1 ) , ( 1 , − 1 ) , ( 1 , 1 ) } h\in\{(-1,-1),(-1,1),(1,-1),(1,1)\} h ∈ {( − 1 , − 1 ) , ( − 1 , 1 ) , ( 1 , − 1 ) , ( 1 , 1 )} z = h 1 h 2 z=h_1h_2 z = h 1 h 2 1 [ z < 0 ] \mathbf1[z<0] 1 [ z < 0 ]
左图四点的身份与标签均完整保留,却没有线性分界;右图给出一个人为设定的环境分布:颜色线索从 90% 可靠变为 10%,形状线索保持 80%。这些是解释条件的构造数值,不是实测模型成绩。
因此值得分别检查表示方差/秩、冻结读出、允许非线性适配的成绩。每一种检查排除的解释不同。LAB 17 对照软目标和常量表示;LAB 21 则比较信息是否保留与读出是否容易。不要把前者的一次低距离当成后者的高质量表示。
数据处理不等式究竟限制哪一条链
设 X = ( A , B ) X=(A,B) X = ( A , B ) Y = A Y=A Y = A H 1 = A H_1=A H 1 = A I ( Y ; H 1 ) = 1 I(Y;H_1)=1 I ( Y ; H 1 ) = 1 H 2 = A ⊕ B H_2=A\oplus B H 2 = A ⊕ B Y Y Y I ( Y ; H 2 ) = 0 I(Y;H_2)=0 I ( Y ; H 2 ) = 0
在固定的 Markov 链 Y → X → H Y\to X\to H Y → X → H I ( Y ; H ) ≤ I ( Y ; X ) I(Y;H)\le I(Y;X) I ( Y ; H ) ≤ I ( Y ; X ) X X X Y Y Y θ \theta θ f θ f_\theta f θ
分布变了,源域最方便的线索可能最危险
考虑二分类图像:训练环境中,颜色与标签一致率为 90%,形状为 80%;新环境中颜色一致率降到 10%,形状仍为 80%。一个只用颜色的规则在源域期望准确率为 90%、目标域为 10%;只用形状则两域都为 80%。这里没有真正训练网络,因此只能证明规则在指定分布下失效,不能声称已经测得迁移带来的负收益。
要声称负迁移 ,需要同一目标任务、标签预算、训练和评价划分下,比较源预训练初始化与合理的目标域基线,例如从头训练或其他初始化;若前者更差,差值才是当前协议下的迁移负效应。冻结、局部微调、全量微调允许不同程度改写源线索,不能仅比较训练准确率。若目标标签很少,全量更新还可能把小样本噪声写进整个网络。
随机划分若同时把同一背景、拍摄设备或主体身份分进两侧,可能隐藏域变化。按环境或主体分组的保留集更接近“到新场景使用”的问题;验证集仍须用于选择适配强度,不能看完测试环境再挑出最好的一种方法。D2L:环境与分布偏移 给出这些假设变化的基础讨论。LAB 22 的规则翻转与 LAB 02 的实际参数迁移各承担其中一层证据。
第一条主线到这里形成一个闭环:重建规定要保留什么,对比规定哪些变化要忽略,教师规定向谁靠近,而读出与新域评价检查这些选择是否支持使用。下一册 CLS 08 改变的不是标签供给,而是输出要求:即使整图类别判断正确,网络还要交付对象在哪里。
CLS 07 · 检测几何、匹配与评价 CLS 08 · 检测几何、匹配与评价
“这张图有杯子”可以由一个整图类别分数回答;“两只杯子分别在哪里”需要对象数、类别和位置。分类器即便准确,也没有被要求把分数分配给具体区域。全局平均池化还可能把左右位置汇总掉。检测因此要改变输出参数化、训练目标和评价协议,而不是给分类结果补画一个框。
四个数怎样指向图像里的同一区域
轴对齐框可表示为 ( x min , y min , x max , y max ) (x_{\min},y_{\min},x_{\max},y_{\max}) ( x m i n , y m i n , x m a x , y m a x ) ( c x , c y , w , h ) (c_x,c_y,w,h) ( c x , c y , w , h ) [ 0 , 1 ] [0,1] [ 0 , 1 ]
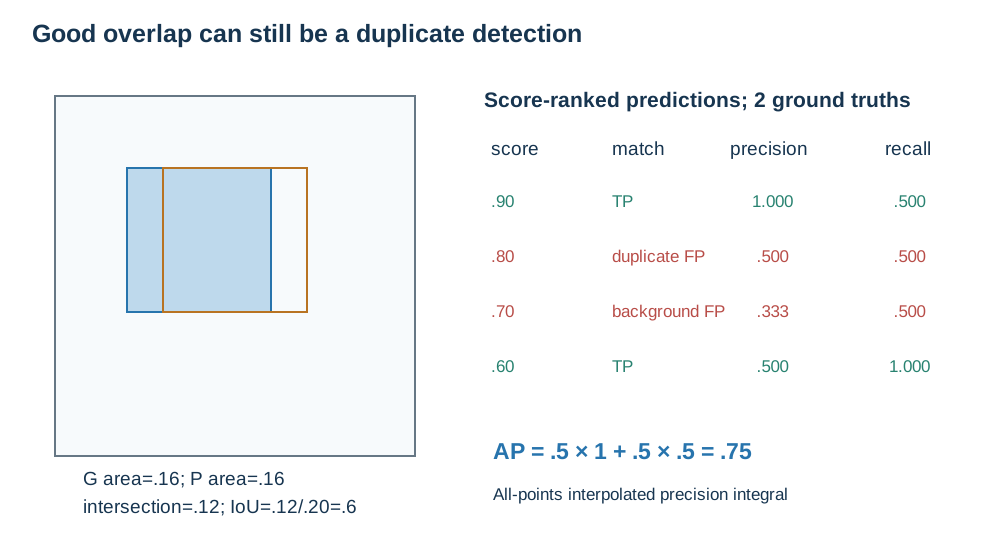
真值 G = ( 0.2 , 0.2 , 0.6 , 0.6 ) G=(0.2,0.2,0.6,0.6) G = ( 0.2 , 0.2 , 0.6 , 0.6 ) P = ( 0.3 , 0.2 , 0.7 , 0.6 ) P=(0.3,0.2,0.7,0.6) P = ( 0.3 , 0.2 , 0.7 , 0.6 ) 0.16 + 0.16 − 0.12 = 0.20 0.16+0.16-0.12=0.20 0.16 + 0.16 − 0.12 = 0.20
I o U ( P , G ) = ∣ P ∩ G ∣ ∣ P ∪ G ∣ = 0.6. \mathrm{IoU}(P,G)=\frac{|P\cap G|}{|P\cup G|}=0.6. IoU ( P , G ) = ∣ P ∪ G ∣ ∣ P ∩ G ∣ = 0.6.
IoU 对同时缩放两框不变,却对相对位移敏感。把同样 0.1 的横移施加到宽 0.2 的小框,重叠比例会比宽 0.4 的框更差。检测中“小目标难”有一部分来自几何尺度,不能只归因于类别识别。
左图以相同坐标比例展示 IoU=0.6;右表是一类、两个真值对象的排序算例,第二个预测虽也盖住对象,却因重复而算假阳性。
锚框先给坐标一个起点,匹配再赋予训练身份
锚框是预设位置、尺度和长宽比的参考框,不是模型已经检测出的结果。输出头为每个锚框预测类别或 objectness,以及相对坐标改变量。一种不加额外尺度系数的参数化是
t x = ( c x g − c x a ) / w a , t y = ( c y g − c y a ) / h a , t w = log ( w g / w a ) , t h = log ( h g / h a ) . t_x=(c_x^g-c_x^a)/w^a,\quad t_y=(c_y^g-c_y^a)/h^a,\quad
t_w=\log(w^g/w^a),\quad t_h=\log(h^g/h^a). t x = ( c x g − c x a ) / w a , t y = ( c y g − c y a ) / h a , t w = log ( w g / w a ) , t h = log ( h g / h a ) .
锚框中心 ( 0.4 , 0.4 ) (0.4,0.4) ( 0.4 , 0.4 ) ( 0.45 , 0.4 ) (0.45,0.4) ( 0.45 , 0.4 ) ( 0.125 , 0 , 0 , 0 ) (0.125,0,0,0) ( 0.125 , 0 , 0 , 0 ) c x p = c x a + w a t x c_x^p=c_x^a+w^at_x c x p = c x a + w a t x w p = w a exp ( t w ) w^p=w^a\exp(t_w) w p = w a exp ( t w )
训练时要把锚框分配为正例、负例或忽略项。常见方案先保障每个真值有匹配,再按 IoU 阈值增加正例,把远离真值的锚框设为背景,中间区域可忽略。两阈值的具体值是协议选择,不是 IoU 的定义。位置回归只对正例计损失;背景没有“应该回归到哪里”的真值。若一幅图没有对象,仍应通过负例分类损失学会不报框,回归项则安全地归零,避免除以零。
写成 L = L c l s + λ L b o x L=L_{cls}+\lambda L_{box} L = L c l s + λ L b o x D2L §14.4 锚框分配/偏移 与 §14.7 TinySSD 核对输出张量、分类标签和回归 mask。
共享特征减少重复计算,但对象身份仍要保留
早期区域 CNN 为很多候选分别提特征,重复处理重叠像素。Fast R-CNN 把卷积移到整图共享阶段,再在区域内读取特征;Faster R-CNN 用 RPN 从共享特征提出候选;SSD 在多个尺度的特征图上直接预测类别和位置。这些变化围绕候选产生、特征复用和预测阶段数组织,并不意味着所有方法在任何设备或目标尺度上只有一个速度排序。Fast R-CNN · Faster R-CNN · SSD 。
共享整图特征不应抹掉区域身份。同一张特征图上取左杯和右杯两个区域,仍要得到各自预测;把所有空间位置先平均成一个向量,再期待检测头重建任意细节,可能遇到表示碰撞。是否保留坐标、感受野与采样密度,应与表示的分类能力一起检查。
NMS 与评价匹配解决两个不同的重复问题
Non-maximum suppression(NMS)是推理后处理:通常按类把预测框按分数排序,保留最高分框,删除与之重叠超过阈值的其他框,再继续。它减少同一对象的重复报告,但不知道真值;挤在一起的不同对象也可能被误删。NMS 阈值影响交付的结果,不能在测试集上追着最好 AP 挑阈值。
评价匹配则拿最终预测与真值比较。在固定类别和 IoU 阈值下,按置信度从高到低,每个预测至多匹配一个尚未被使用的真值;同一真值只能被命中一次。于是“框覆盖了对象”还不保证是真阳性,它可能是已有更高分预测的重复框。
设共有两个真值,四个预测排序后的身份依次为 TP、FP(重复)、FP(背景)、TP。累计 precision 为 1 , 1 / 2 , 1 / 3 , 1 / 2 1,1/2,1/3,1/2 1 , 1/2 , 1/3 , 1/2 1 / 2 , 1 / 2 , 1 / 2 , 1 1/2,1/2,1/2,1 1/2 , 1/2 , 1/2 , 1 0.5 × 1 + 0.5 × 0.5 = 0.75 0.5\times1+0.5\times0.5=0.75 0.5 × 1 + 0.5 × 0.5 = 0.75
LAB 09 可改重复框分数,观察排序如何改变 AP;也可改 IoU 阈值,使一个原先合格的框失去匹配。准确率把大量背景当作普通样本时可能很高,却无法体现检测的定位与重复问题。
沿一次真实训练追踪从图像到框
LAB 10 的主实验应按以下对象检查:RGB 图像和类别/框标注进入数据集,卷积骨干产生空间特征,输出头产生类别与偏移,匹配提供监督,损失更新参数,解码及 NMS 产生最终框,最后仅用保留图像评价。真值坐标只用于目标与评价,不能作为图像模型的输入特征。
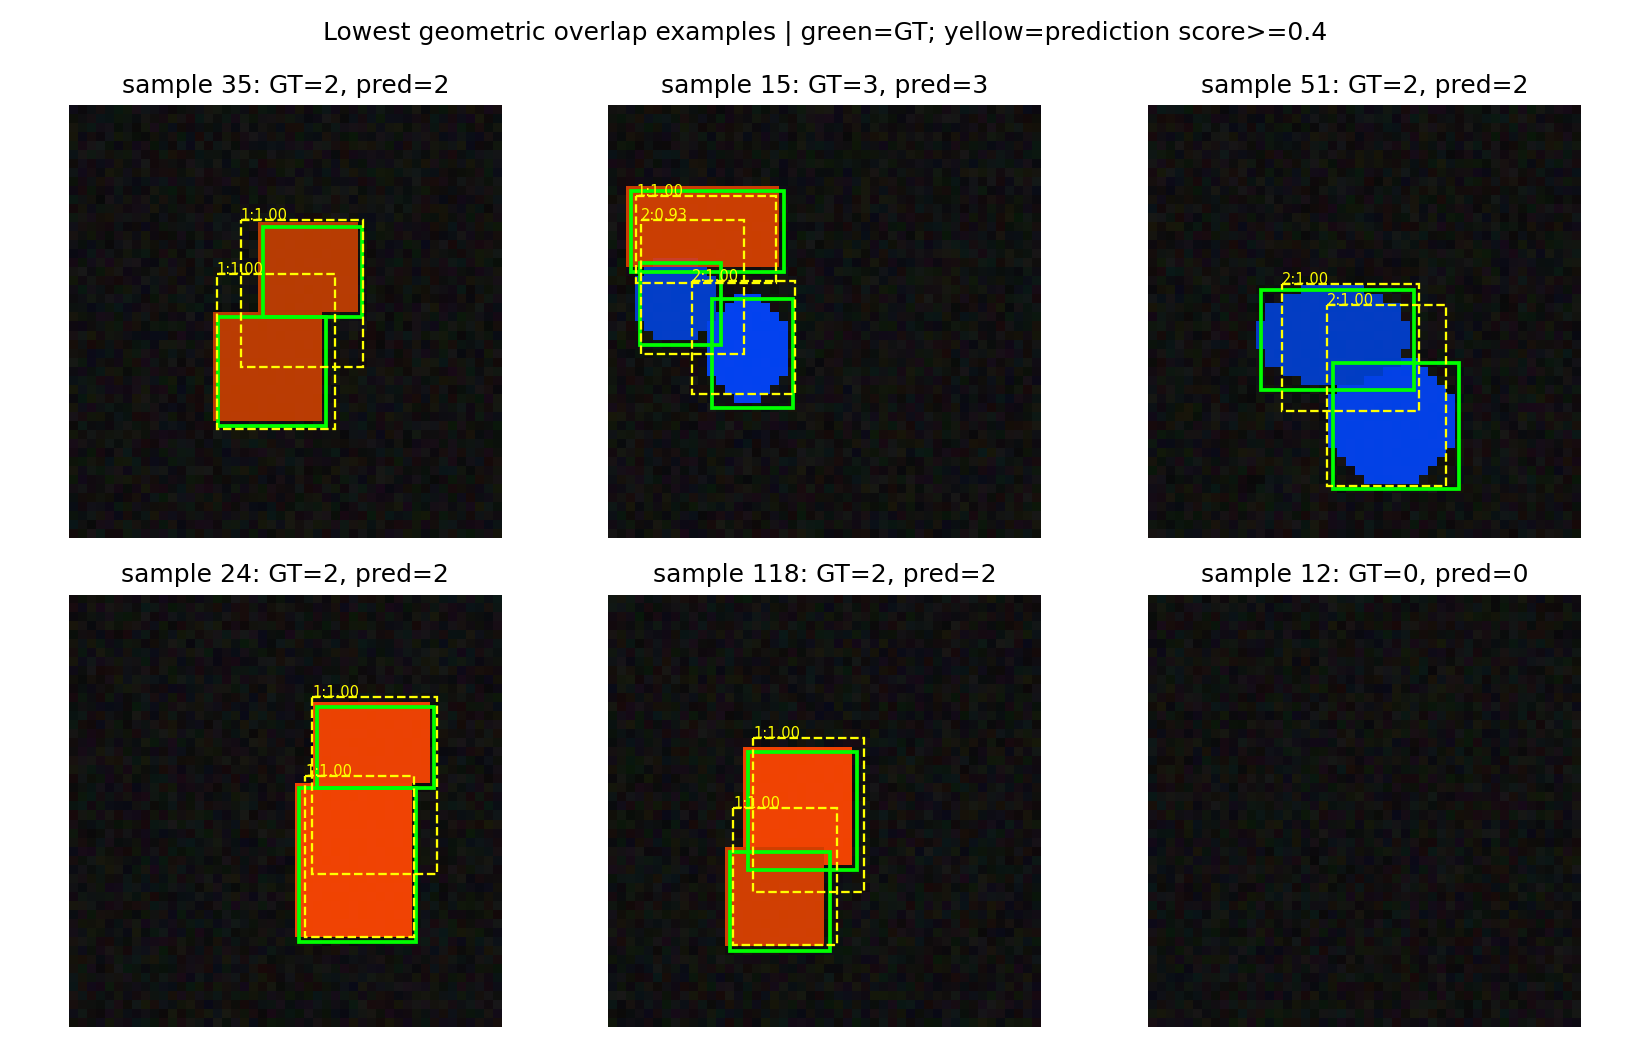
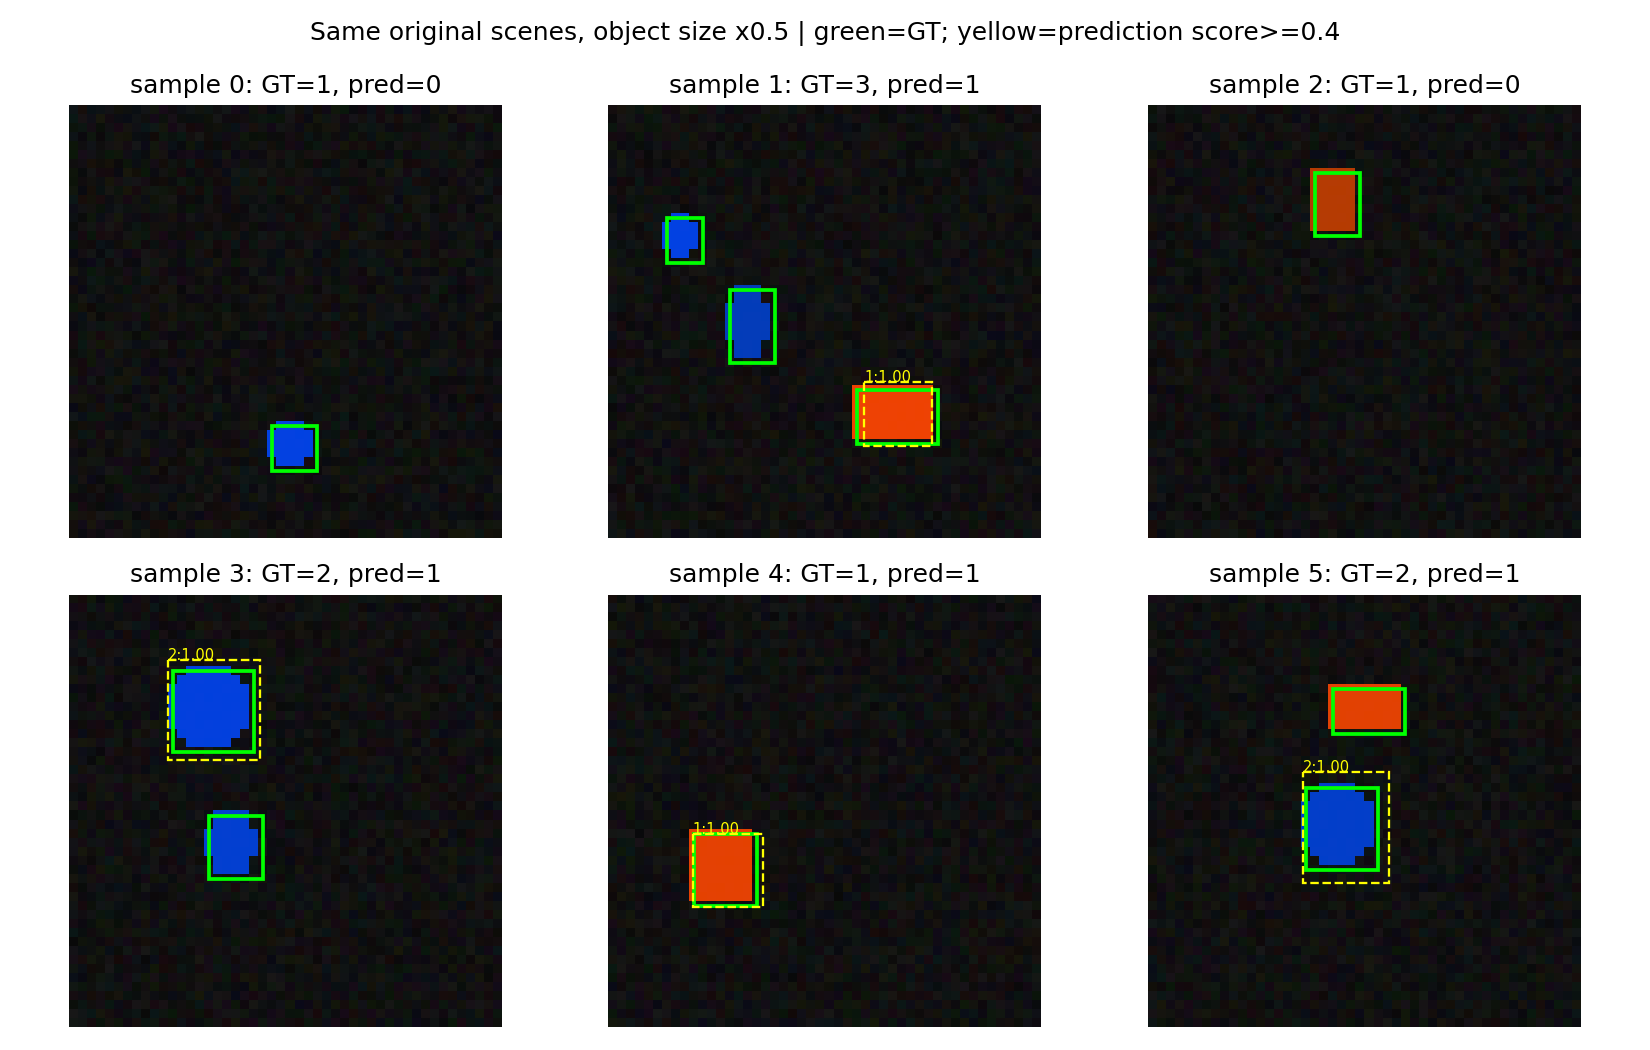
主实验已在 2026-09-22 本地 CPU 完整运行。输入是 48×48 RGB 合成图,含红矩形、蓝椭圆、可变位置与尺度、多个对象及空图;颜色与形状相关,因此不是自然场景通用检测基准。按原始场景种子划分 768 训练、96 验证、192 保留图。45,806 参数的卷积检测器在单层网格上使用 288 个锚框,训练 28 epoch;正例阈值 0.45、忽略区间 [0.25,0.45),并保障每个真值有独立强制匹配。分类使用 hard-negative CE,位置项为正例 smooth-L1,解码后按类 NMS。
同一保留协议
两类平均 AP@IoU0.50
两类平均 AP@IoU0.75
随机初始化
0.00746
0.00003
训练后,原尺度
0.97303
0.70367
训练后,仅对象尺寸减半
0.61490
0.17987
AP 按各类全局分数排序、一个真值最多匹配一次、precision envelope 全点积分;不是 COCO 多 IoU 平均 AP。保留集有 33 张空图,展示阈值 0.4 下没有空图误报;这不代表所有阈值或所有背景都不会误报。AP50 与 AP75 的差距说明定位仍不够精细,尺度减半的下降说明训练分布外的小对象尤其困难。
保持权重与输入不变,仅把 NMS IoU 阈值从 0.35 放宽到 0.65,AP50 变为 0.95866;展示阈值下 recall 从 0.98311 到 1.0,precision 则从 0.94175 降到 0.41926。更多预测覆盖了剩余真值,也留下大量重复框。这组结果把 NMS 的取舍落实到了同一模型,而非抽象宣称后处理总会改善成绩。
四维高斯样本上的逻辑回归仍能说明 sigmoid 分类损失和参数更新,但它没有图像和位置输出,应保留为分类热身。完整检测器给出的错误则可以进一步分解:漏检、错类、框偏、重复、空图误报、尺度外推。这些区分决定下一步该改表示、匹配、损失、解码还是数据。
即使检测框全部正确,框里的杯把空洞和两杯接触边界仍未知。下一册 CLS 09 从这个具体缺口走向逐像素和实例输出。
CLS 08 · 密集预测、实例与集合输出 CLS 09 · 密集预测、实例与集合输出
一个框可以同时包住杯身、杯把和杯把中的背景。框坐标全对,仍不代表我们知道每个像素属于谁。若两只杯子接触,语义分割可以把它们都标成“杯子”,但要分别计数和操作,就还需区分实例身份。这里不是同一个答案换显示颜色,而是输出空间和监督单位发生了变化。
一张类别图怎样成为可训练的输出
语义分割的输出通常为 Z ∈ R N × C × H × W Z\in\mathbb R^{N\times C\times H\times W} Z ∈ R N × C × H × W N N N C C C H , W H,W H , W Y ∈ { 0 , … , C − 1 } N × H × W Y\in\{0,\ldots,C-1\}^{N\times H\times W} Y ∈ { 0 , … , C − 1 } N × H × W
L = − 1 ∣ Ω ∣ ∑ ( n , u , v ) ∈ Ω log p n , Y n u v , u , v . L=-\frac{1}{|\Omega|}\sum_{(n,u,v)\in\Omega}\log p_{n,Y_{nuv},u,v}. L = − ∣Ω∣ 1 ( n , u , v ) ∈ Ω ∑ log p n , Y n uv , u , v .
Ω \Omega Ω
FCN 用卷积保持空间网格并输出位置相关分数,再把较粗分辨率恢复到目标大小。U-Net 的编码—解码结构把深层上下文与浅层高分辨率特征通过跳连结合;这种连接提供额外可用信息,而不仅是把同一张粗图放大。D2L §14.11 FCN · U-Net 原论文 。图像和 mask 的裁剪、翻转、缩放必须使用同一几何变换,否则网络被要求把一个位置的像素对应到另一个位置的标签。
上采样能增加格子,不能单凭格子恢复被删掉的区别
最近邻复制相邻值;双线性插值对邻域数值加权。给二维网格
F = ( 0 10 20 30 ) , F=\begin{pmatrix}0&10\\20&30\end{pmatrix}, F = ( 0 20 10 30 ) ,
在横坐标 x = 0.25 x=0.25 x = 0.25 y = 0.5 y=0.5 y = 0.5 0.375 , 0.125 , 0.375 , 0.125 0.375,0.125,0.375,0.125 0.375 , 0.125 , 0.375 , 0.125
如果两个 2 × 2 2\times2 2 × 2 LAB 03 的表示碰撞例;它解释为什么需要保留空间信息,而非只提高显示分辨率。
类别 mask 本身是离散 ID,通常用最近邻几何采样。对类别编号 1 和 3 做双线性插值,得到 2 并不意味着中间真的存在第 2 类。模型的连续 logits 或概率图则可以按适当约定插值,再 argmax/阈值。插值坐标约定也要固定,例如是否对齐端点;同样叫 bilinear 的两个设置可能在边界位置不同。
一个 8×8 反例怎样澄清四种指标
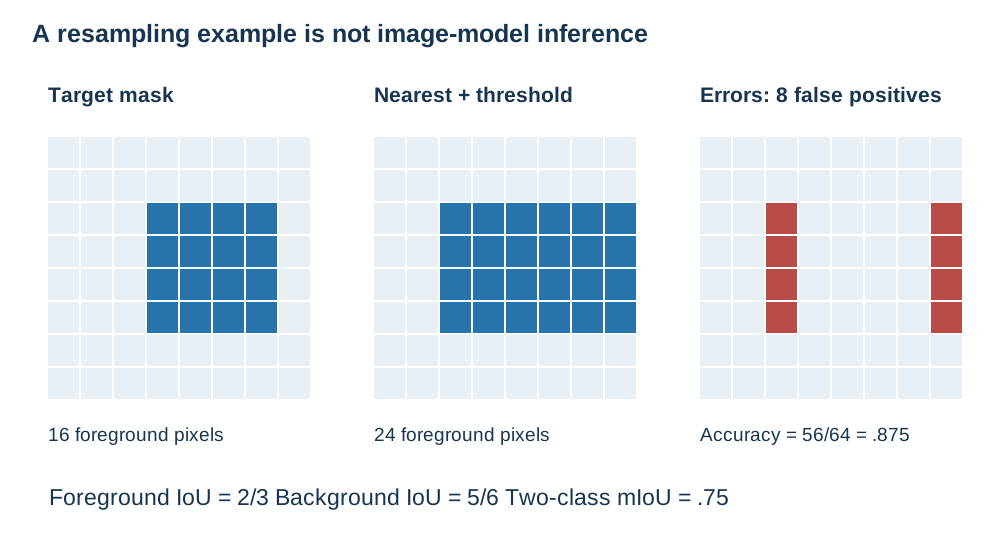
设真值前景有 16 像素,从真值 mask 平均降采样再最近邻恢复并阈值化后,预测前景有 24 像素,其中真阳性 16、假阳性 8、假阴性 0、真阴性 40。这是采样机制例,预测过程直接使用了真值 mask,不能当作看图模型的能力证据。
三张网格由同一组 8×8 数组绘制。目标矩形为行 2–5、列 3–6(从 0 计数);阈值化最近邻恢复多出了 8 个前景像素。
指标
计算
本例结果
前景 IoU
16 / ( 16 + 8 + 0 ) 16/(16+8+0) 16/ ( 16 + 8 + 0 ) 2 / 3 2/3 2/3
背景 IoU
40 / ( 40 + 0 + 8 ) 40/(40+0+8) 40/ ( 40 + 0 + 8 ) 5 / 6 5/6 5/6
两类 mIoU,含背景
( 2 / 3 + 5 / 6 ) / 2 (2/3+5/6)/2 ( 2/3 + 5/6 ) /2 0.75
像素准确率
( 16 + 40 ) / 64 (16+40)/64 ( 16 + 40 ) /64 0.875
“mIoU=0.667”在这个例子里错在名称:0.667 是单类前景 IoU。若报告不含背景的类均值,应写清类别集合;若某类真值和预测都为空,要说明是忽略该类还是采用约定值。背景占比很高时,全预测背景也可能有高像素准确率,所以要看逐类混淆和边界错误,而不只看一个总数。
真正视觉模型必须从图像推断 mask。LAB 11 先保留上述采样例及最近邻/双线性比较,再进入小型像素模型。两段实验分别检验采样损失和学习能力,结论不互相替代。
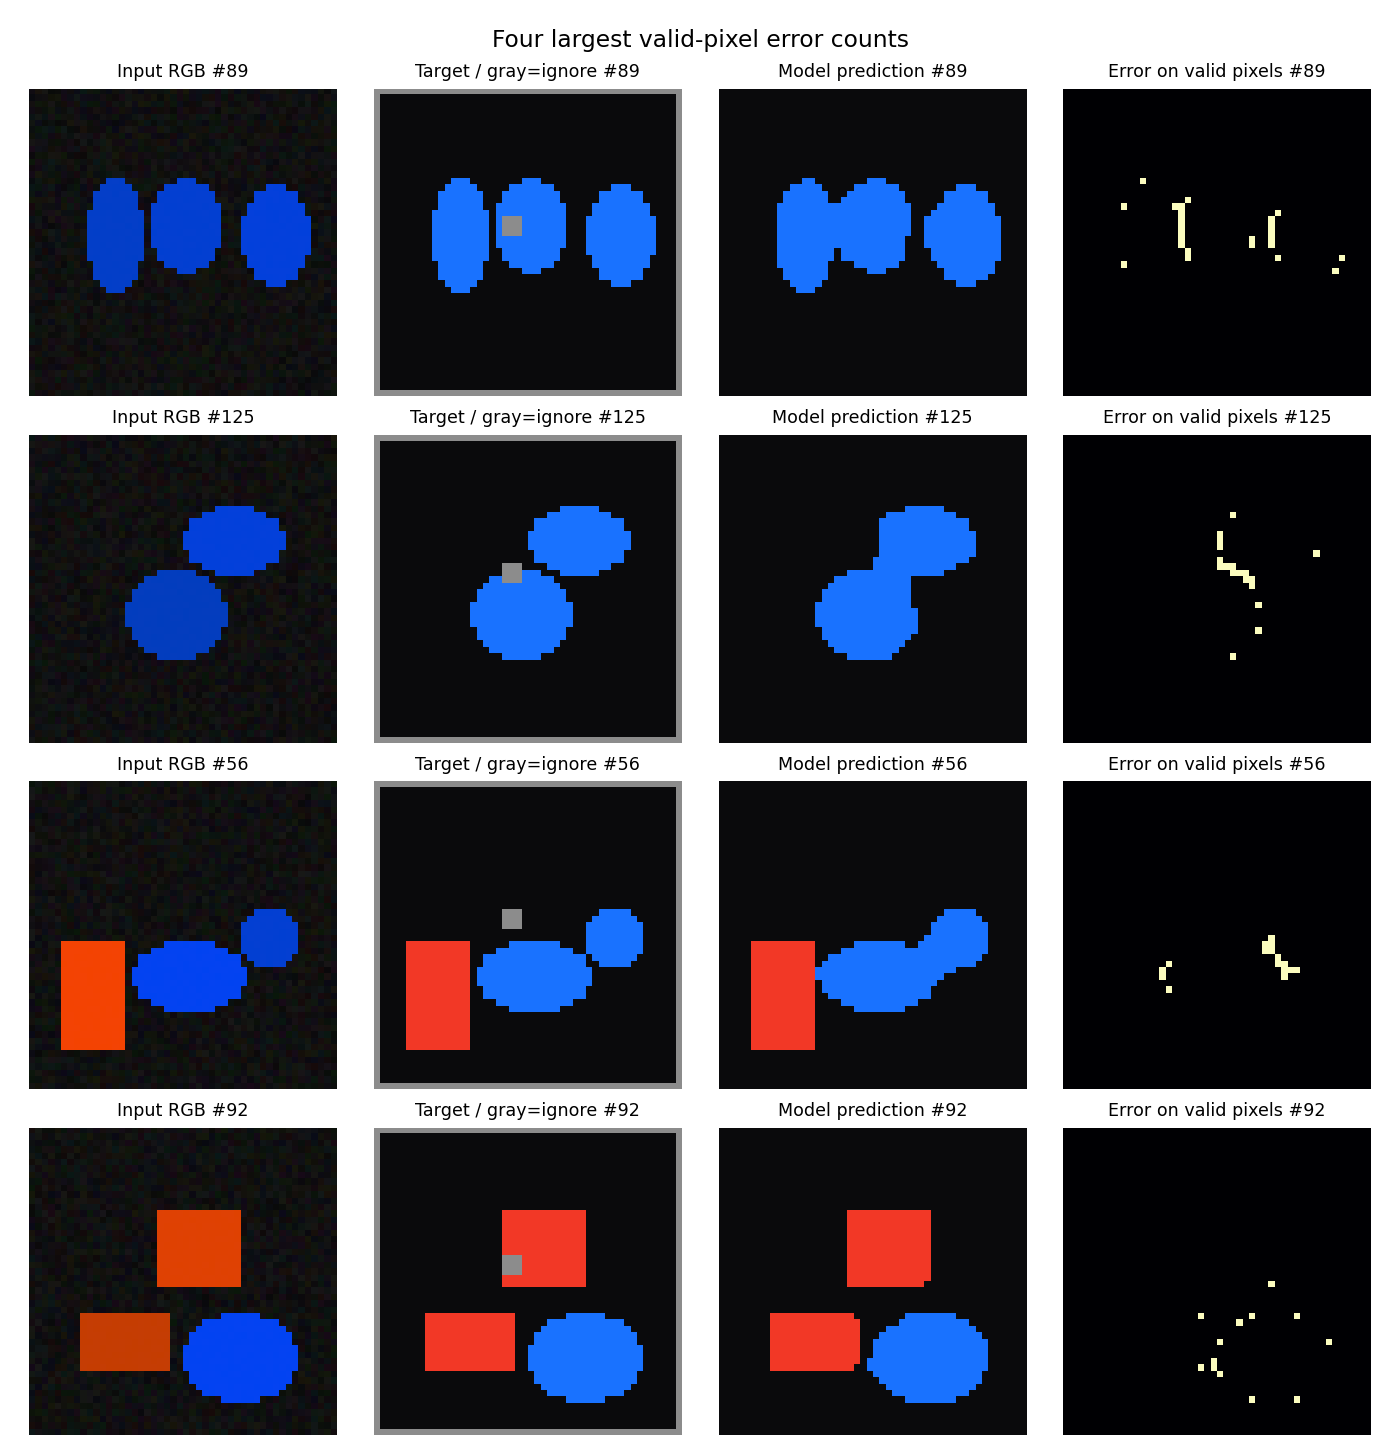
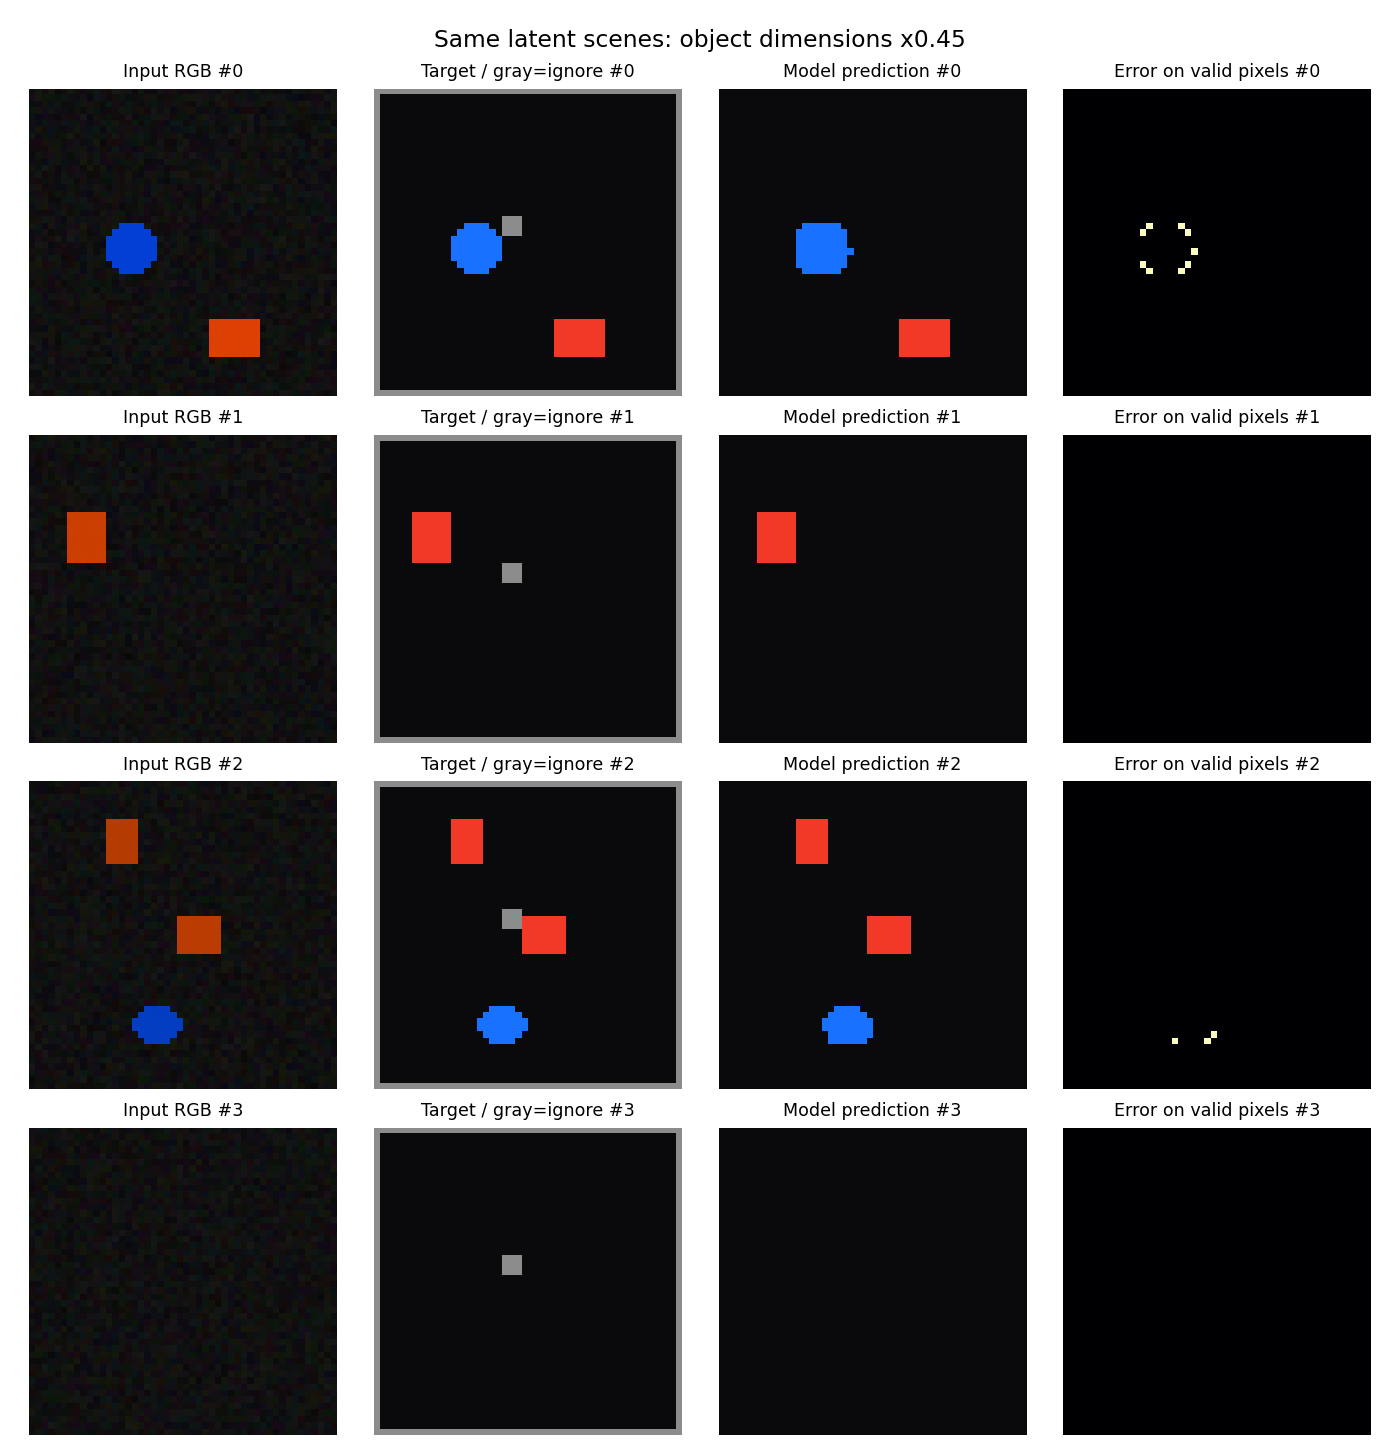
主实验在 2026-09-22 本地 CPU 完成训练,384 张训练图、128 张保留图,输入 48×48 RGB。三类为背景、红矩形、蓝椭圆,目标形状为 [B,48,48],logits 为 [B,3,48,48],ignore label 255 在损失与指标中均被排除。20,590 参数的小型 FCN 将 12×12 粗 logits 双线性上采样并融合精细跳连,训练 20 epoch;另训练只有 12 个参数的逐像素 RGB 线性读出作基线。
保留图像条件
小型 FCN 三类 mIoU
RGB 逐像素线性读出 mIoU
原始合成图
0.99041
1.00000
对象尺度变为 0.45 倍
0.94396
1.00000
RGB 图作 5×5 模糊
0.92397
0.84996
RGB 基线满分说明原数据颜色已直接泄露类别,不能据 FCN 高分宣称它学会了复杂形状或需要深层上下文。模糊后边缘颜色混合,FCN 在这个干预下更稳健;这才是当前对照支持的具体比较。原始条件下 FCN 的逐类 IoU 为背景 0.99861、矩形 0.99833、椭圆 0.97429,较细曲线边界更难。
保持已训练参数,测试时仅把粗 logits 的双线性插值改为最近邻,mIoU 降到 0.91180。这说明当前网络对训练时的采样约定敏感,不能把它读作“最近邻永远更差”,因为网络没有在两种上采样设置下分别重训。前面的已知 mask 热身中,双线性分支前景 IoU 仍为 2/3,背景 IoU 为 0.88462、两类 mIoU 为 0.77564;指标差异与模型泛化仍须分开。
小目标、区域对齐与实例身份各需要哪种结构
深层特征感受野大,适合上下文;浅层特征分辨率高,保留局部细节。FPN 通过自顶向下和横向连接组织多尺度语义特征,供不同尺度对象使用;SSD 也在多尺度图上预测,但不是同一套特征融合结构。FPN 。更密的输出位置带来大量易背景项,focal loss 用 − ( 1 − p t ) γ log p t -(1-p_t)^\gamma\log p_t − ( 1 − p t ) γ log p t γ = 2 \gamma=2 γ = 2 Focal Loss 。
Mask R-CNN 在检测区域上再预测每个实例的 mask。两个杯子类别相同,也有各自的区域和掩码。RoIAlign 用连续坐标取样,减少区域量化带来的错位;上面的双线性例说明了单个采样点怎样获得值。它能更准确读取已有特征,却不会恢复骨干早已完全删去的信息。Mask R-CNN §3 。
语义输出关注每个像素的类别,实例输出还要保存“同类中的哪一个”。若把实例 1、2 都映射为类别“杯子”,就得到语义图;逆变换一般不唯一,因为接触区域可能无法仅凭类别图分开。点或框提示分割又多了当前请求:这次分哪一个对象。它将在 CLS 12 接上语言指代。
对象没有天然顺序,损失为何要先匹配
假如真值集合为两只杯子 { A , B } \{A,B\} { A , B } { p 1 , p 2 } \{p_1,p_2\} { p 1 , p 2 } p 1 p_1 p 1
例如成本矩阵行为预测、列为真值:C = ( 0.2 1.3 1.0 0.1 ) C=\begin{pmatrix}0.2&1.3\\1.0&0.1\end{pmatrix} C = ( 0.2 1.0 1.3 0.1 ) − p ( c ) -p(c) − p ( c ) DETR §3 。
LAB 23 可以换标注顺序,验证最佳集合对应没有改变。这个小矩阵足以讲清置换问题,但不等于训练出了 DETR。至此,整图、框、像素、实例和集合的区别都落实到输出对象与损失;下一条主线将让语言规定我们要哪种答案。
CLS 09 · 图像条件输出:描述与问答 CLS 10 · 图像描述、解码与视觉问答
同一张红杯在左、蓝杯在右的图片,可以产生“桌上有两个杯子”的描述,也可以回答“左边杯子什么颜色”。前者要选择描述哪些内容并组织句子;后者还要依据问题筛选证据。两者都使用语言,却不是将图像分类的最后一个类别名改成长句。输出的条件分布、训练数据和检验方式都随任务改变。
图像特征怎样进入逐词预测
令图像编码为 v = f θ ( I ) v=f_\theta(I) v = f θ ( I ) e ( y t − 1 ) e(y_{t-1}) e ( y t − 1 ) h 0 = A v h_0=Av h 0 = A v h t = R N N ( h t − 1 , [ e ( y t − 1 ) ; v ] ) h_t=\mathrm{RNN}(h_{t-1},[e(y_{t-1});v]) h t = RNN ( h t − 1 , [ e ( y t − 1 ) ; v ]) p ( y t ∣ y < t , I ) = s o f t m a x ( W h t + b ) p(y_t\mid y_{<t},I)=\mathrm{softmax}(Wh_t+b) p ( y t ∣ y < t , I ) = softmax ( W h t + b )
句子概率由链式法则分解:
p ( y 1 , … , y T ∣ I ) = ∏ t = 1 T p ( y t ∣ y < t , I ) , p(y_1,\ldots,y_T\mid I)=\prod_{t=1}^T p(y_t\mid y_{<t},I), p ( y 1 , … , y T ∣ I ) = t = 1 ∏ T p ( y t ∣ y < t , I ) ,
其中最后一个目标通常是 EOS。训练最小化真实句子的负对数似然,图像与描述配对提供监督。Show and Tell 把视觉编码器与序列解码器结合;Show, Attend and Tell 进一步在生成时读取图像局部。这些工作连接了已有视觉识别与序列建模能力,并没有把 caption 当作无需训练的新界面。Show and Tell · Show, Attend and Tell 。
回看 CLS 04 ,共享参数和逐词交叉熵都保留,只是每项分布新增了图像条件。视觉编码器可以冻结,也可以参与反向传播;需要多少配对数据、会不会破坏原表示,取决于更新范围和任务难度。
训练时看到真实前缀,推理时承担自己的错误
目标句为 [红色, 杯子, EOS]。输入为 [BOS, 红色, 杯子],shifted targets 为 [红色, 杯子, EOS]。若批内另一句较长,就给短句补 PAD,但 PAD 位置不计词损失。EOS 是需要学习的有效目标,不能与 PAD 一起删去,否则模型没有明确的结束监督。
teacher forcing 让每个训练位置看到真实前缀;推理则从 BOS 开始,把上一步生成词继续输入,直到 EOS 或长度上限。假如模型先误说“蓝色”,后续分布是在“蓝色”这个条件下计算,不能再拿真实“红色”偷偷接续。训练 loss 低与自由生成正确相关,却不是同一测试。
图像打乱是一个特别有力的对照:保留句子前缀与网络参数,把匹配图替换为另一张图。如果生成几乎不变,语言先验可能已承担大部分任务;如果明显恶化,支持当前模型使用视觉条件,但仍要排除数据中的简单相关性。把视觉向量置零则检验对这一特定缺失输入的反应,并不等价于训练一个容量相同的纯语言模型。
Greedy 与 beam 真正在搜索什么
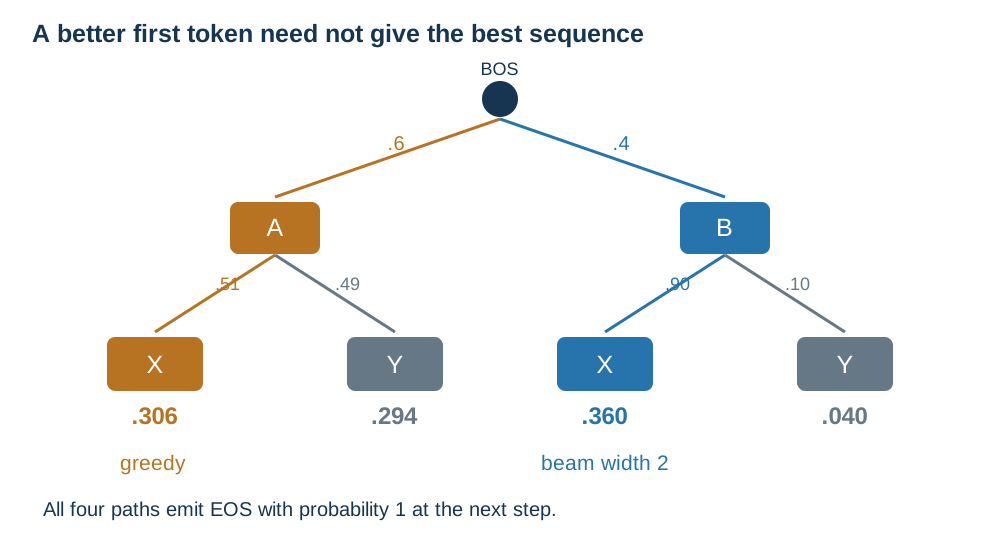
设第一步只有 A、B,概率分别为 0.6、0.4。A 之后 X、Y 的概率为 0.51、0.49;B 之后为 0.9、0.1。再下一步四条路径都以概率 1 输出 EOS,所有分布都已规范化。
完整路径
条件概率乘积
A X EOS
0.6 × 0.51 = 0.306 0.6\times0.51=0.306 0.6 × 0.51 = 0.306
A Y EOS
0.6 × 0.49 = 0.294 0.6\times0.49=0.294 0.6 × 0.49 = 0.294
B X EOS
0.4 × 0.9 = 0.360 0.4\times0.9=0.360 0.4 × 0.9 = 0.360
B Y EOS
0.4 × 0.1 = 0.040 0.4\times0.1=0.040 0.4 × 0.1 = 0.040
greedy 第一步选 A,第二步选 X,得到 0.306。beam 宽度 2 第一步保留 A、B,展开后保留 BX、AX,最终选择 BX 的 0.36。在这个小树上 beam 找到了更高概率路径;更大搜索空间里,有限 beam 仍可能提前删掉最终最优前缀。实现时通常累加 log 概率以避免下溢,并明确 EOS 完成路径怎样保留。
每个节点的出边概率和为 1。橙色路径是 greedy,蓝色路径是宽度 2 的 beam;路径联合概率由真实边概率相乘,没有用手填结果字符串冒充搜索。
更长句子的概率乘积通常更小,长度惩罚或归一化会改变搜索分数。搜索得到更高模型概率,未必更符合图片:如果模型本身高估一个幻觉句子,搜索更充分反而更坚定地输出它。必须区分搜索错误、概率模型错误和视觉证据不足。见 D2L §10.8 Beam Search 。
小型 CNN–GRU 确实从图像条件生成了词
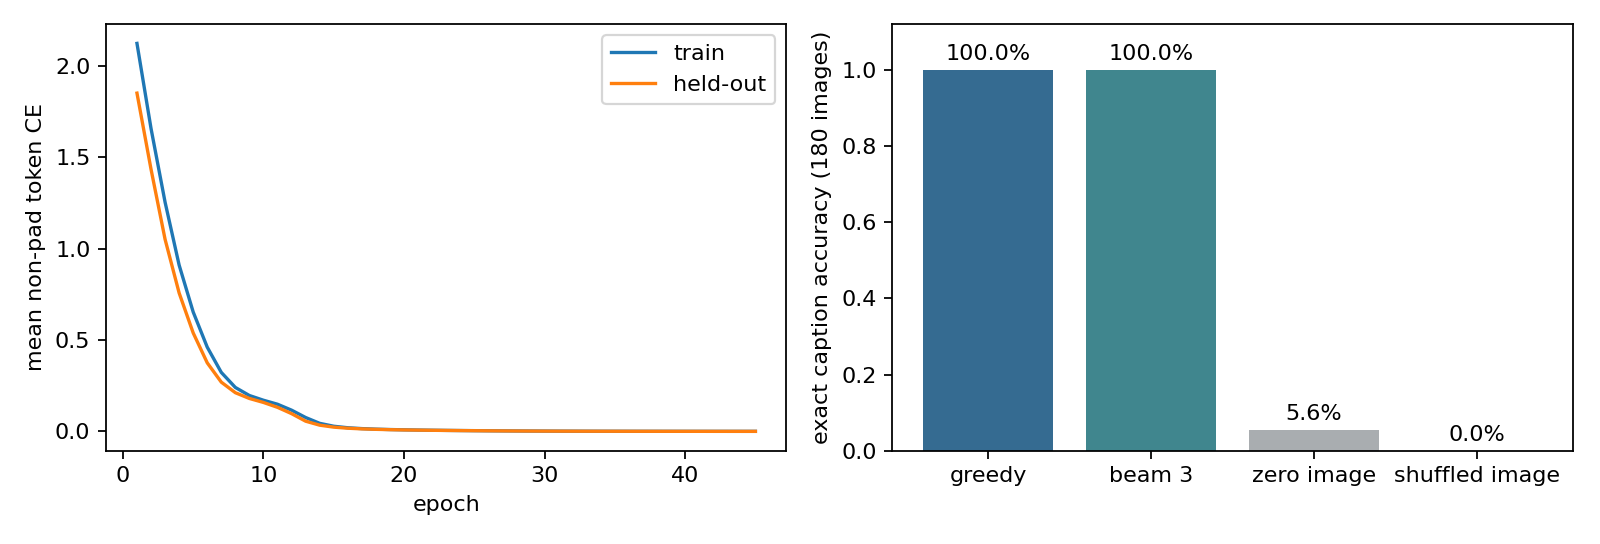
LAB 13 在 2026-09-22 本地 CPU 新进程中完成训练。720 张训练图、180 张独立渲染的保留图覆盖相同 18 种颜色×形状×位置组合;这是新渲染泛化,不是未见语义组合或自然照片泛化。CNN 把像素编码为 48 维视觉向量,词嵌入 24 维,每一步把两者拼接送入 64 维 GRU,视觉向量也用于初始化 hidden state。训练真实前缀和 shifted targets,推理实际接续模型输出。
同一批 180 张保留图
完整句精确匹配
正确图像,greedy
100.00%
正确图像,beam width 3
100.00%
像素置零
5.56%
图像按固定循环移位错配
0.00%
在固定前缀 BOS a 后,红方块左侧图生成 a red square on left,蓝圆右侧图生成 a blue circle on right。去图和错配图大幅下降,支持模型在这个有限任务上依赖正确视觉条件。greedy 和 beam 同分,说明本实验没有提供 beam 优于 greedy 的经验结果;前面的概率树解释的是搜索机制。中间位置采用较短描述模板,也有 EOS 监督,这使长度不同的真实生成可被检查。
VQA 新增的不是“一个问号”,而是条件选择
VQA 的目标为 p ( a ∣ I , q ) p(a\mid I,q) p ( a ∣ I , q ) q q q a a a VQA 。
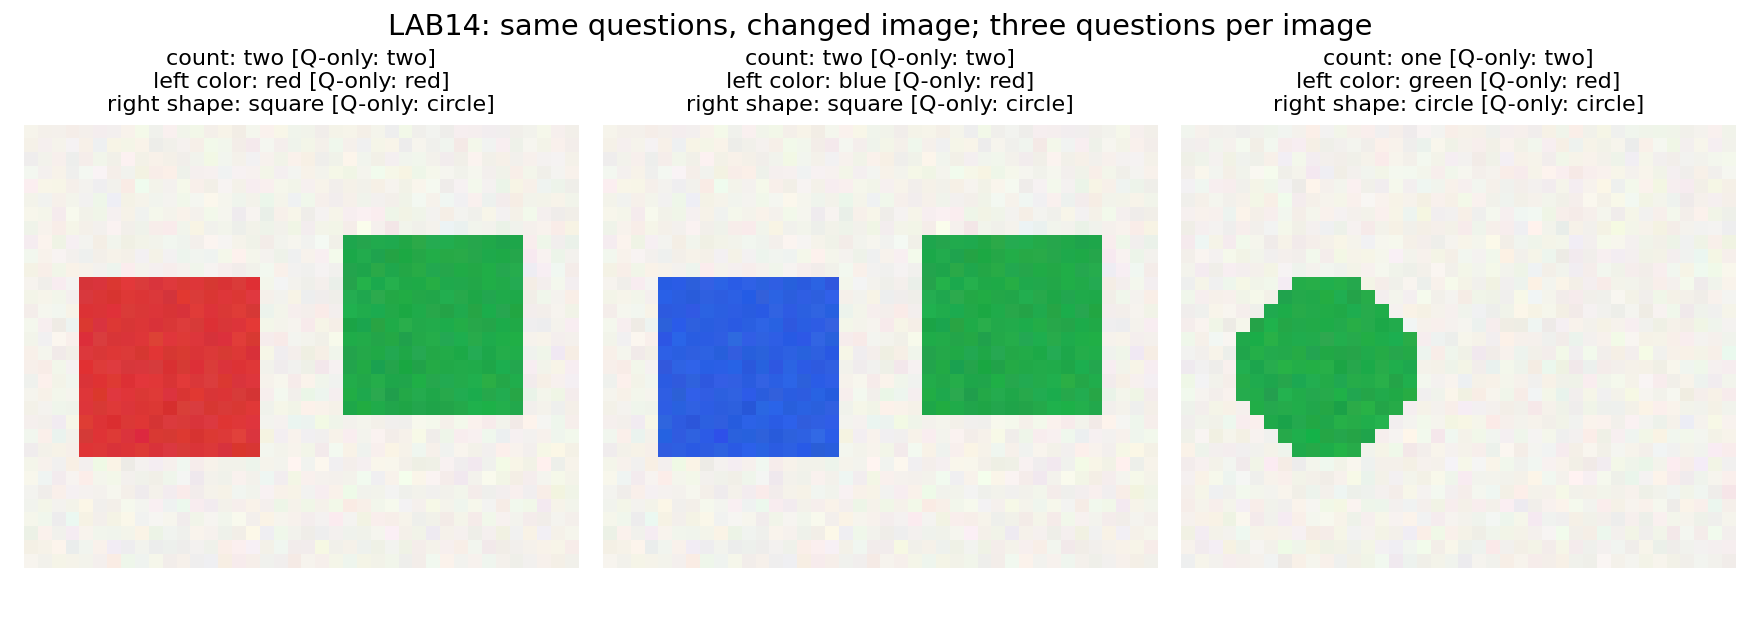
看同一对场景:图 A 左红右蓝,图 B 左蓝右红。问题“左边杯子什么颜色”在 A 的答案是红、B 是蓝;同图 A 换成“右边杯子什么颜色”,答案又变成蓝。模型必须同时随图和随问题变化。若训练集中这个问题九成回答红,question-only 模型可以靠问题先验达到看似不错的成绩;这正是需要对照的原因,而非说明它拥有视觉能力。Making the V in VQA Matter 通过成对图像与答案平衡,加强了视觉证据的作用。
对照
保持
改变
能回答的具体问题
同问题换图
问句与模型
与答案有关的像素
输出是否跟随画面?
同图换问题
画面与模型
所问属性或对象
是否按问题选取证据?
question-only
训练/评价问答协议
移去视觉分支
问题先验能做到多少?
错配图
问题、答案集合与模型
图像对应关系
成绩是否依赖正确图文配对?
若视觉分支直接读取场景字典的 color 或 count 字段,它拿到的是答案相关属性的 oracle 输入。这能检查问答规则,却没有检查像素感知。真实视觉分支至少要从图片或可追溯视觉特征取得信息,再与问题融合。LAB 14 保留这两种身份,避免把规则分支说成看图模型。
实际 VQA 对照同样已在 2026-09-22 本地 CPU 训练:720 张训练图和 180 张保留图先按图划分,再各扩展为数量、最左对象颜色、最右对象形状三个问题,保留集共 540 个图问对。训练中左侧红色比例实测 73.61%,保留颜色按构造均匀。CNN+问题模型从像素读取信息;question-only 使用同样问答任务,单独训练语言基线。
保留条件
数量
左侧颜色
右侧形状
全部问题
正确图像+问题
100%
100%
100%
100%
question-only
50%
33.33%
50%
44.44%
已训练视觉模型,像素置零
50%
33.33%
50%
44.44%
固定循环错配图像
83.33%
50%
0%
44.44%
循环错配的分项结果不等于独立随机图的理论机会率:数据排列让错配后数量仍有较强关联,而形状正好反向。总体同为 44.44% 也掩盖了不同错误来源。这个结果支持视觉模型利用正确图像,但要评估更广泛语言泛化,还需新的问句、对象和组合;三个固定模板上的满分不是开放 VQA 能力。
caption 的好句子要与画面对应,VQA 的好答案还要对应问题,而 CLS 11 的 CLIP 只需给已有图文候选评分。三个任务可复用视觉和语言表示,但输出结构和训练目标不同:一个相似度函数没有下一词分布,就不能仅靠不断调用相似度自动成为本册的条件解码器。
CLS 10 · CLIP:配对学习与可复用表示 CLS 11 · CLIP、检索与表示缓存
一张照片旁边的文字通常没有给出每个像素的标签,却能指出“狗在草地上奔跑”。这样的配对可以把语言变成学习信号:图像表示与对应描述靠近,在一批候选中识别正确配对。训练后,文字还可以临时指定候选类别,而不必为每个任务重新定义一个固定分类头。代价是评分只反映模型、输入和候选关系;它并不自动给出完整描述、区域框或校准过的真实性概率。
两个编码器怎样共享一个比较空间
图像编码器给出 v i = f ( I i ) / ∥ f ( I i ) ∥ v_i=f(I_i)/\|f(I_i)\| v i = f ( I i ) /∥ f ( I i ) ∥ u j = g ( T j ) / ∥ g ( T j ) ∥ u_j=g(T_j)/\|g(T_j)\| u j = g ( T j ) /∥ g ( T j ) ∥ B B B S i j = v i T u j S_{ij}=v_i^Tu_j S ij = v i T u j
L I → T = − 1 B ∑ i log e S i i / τ ∑ j e S i j / τ , L T → I = − 1 B ∑ j log e S j j / τ ∑ i e S i j / τ . L_{I\to T}=-\frac1B\sum_i\log\frac{e^{S_{ii}/\tau}}{\sum_j e^{S_{ij}/\tau}},\qquad
L_{T\to I}=-\frac1B\sum_j\log\frac{e^{S_{jj}/\tau}}{\sum_i e^{S_{ij}/\tau}}. L I → T = − B 1 i ∑ log ∑ j e S ij / τ e S ii / τ , L T → I = − B 1 j ∑ log ∑ i e S ij / τ e S j j / τ .
训练常取两者平均。归一化让点积成为余弦;温度或其倒数缩放 logits,但不是改变余弦本身。CLIP 学习图像与文字编码器并用图文配对训练,可在下游把类别名写入自然语言模板作为候选。CLIP §2、图 1 。批内“未配对”不保证语义无关:两张狗图的描述可能都正确,重复数据和描述遗漏都会影响目标。
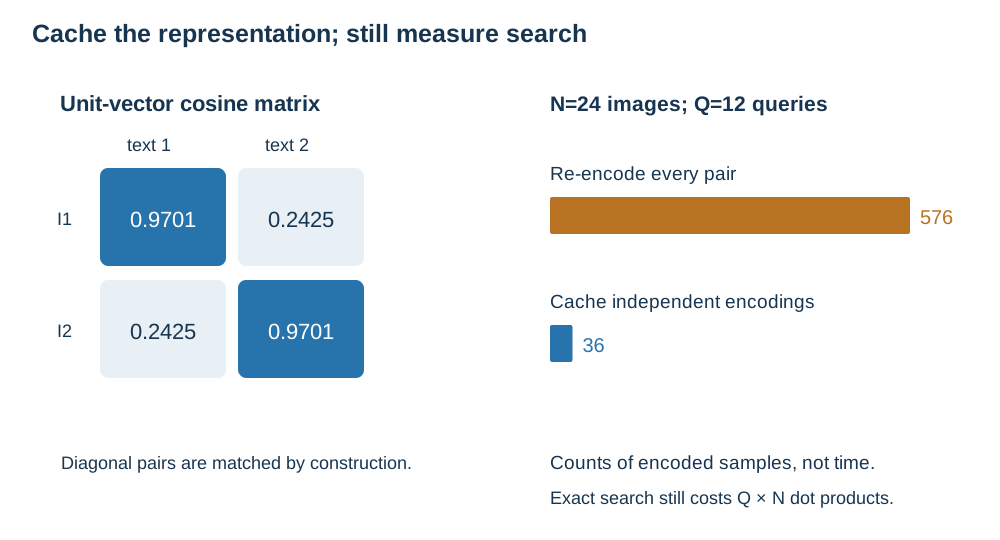
一个可手算的例子使用 v 1 = ( 1 , 0 ) , v 2 = ( 0 , 1 ) v_1=(1,0),v_2=(0,1) v 1 = ( 1 , 0 ) , v 2 = ( 0 , 1 ) u 1 = ( 4 , 1 ) / 17 , u 2 = ( 1 , 4 ) / 17 u_1=(4,1)/\sqrt{17},u_2=(1,4)/\sqrt{17} u 1 = ( 4 , 1 ) / 17 , u 2 = ( 1 , 4 ) / 17
候选分类、检索与概率是三个不同对象
对同一图像,设两个候选 logits 为猫 2、狗 1。候选 softmax 给猫 e 2 / ( e 2 + e ) = 0.7311 e^2/(e^2+e)=0.7311 e 2 / ( e 2 + e ) = 0.7311 e 2 / ( 2 e 2 + e ) = 0.4223 e^2/(2e^2+e)=0.4223 e 2 / ( 2 e 2 + e ) = 0.4223
删除正确类别后仍会出现最高分;添加近义描述会分摊 softmax;改模板则会改变文本编码向量,可能连 raw similarity 都改变。对比时分别记录图像预处理、模板、候选集合、原始余弦与 scaled logits。若要把分数解释为风险或真实性概率,需要额外校准数据与分布假设,而非只做一次 softmax。
在检索中,查询可能有多个相关结果。Hit@K 只问前 K 是否至少有一个相关项;Recall@K 按相关项数量计算召回;若每查询只有一个正例,两者数值相同。近似索引与精确索引的 Top-K overlap 则问两个算法找到的 ID 重合多少,不问这些图像是否语义相关。报告里必须先定义相关集合,不能把三个口径统称为 Recall。
为什么一个可缓存向量改变了系统成本
图库有 N N N Q Q Q N + Q N+Q N + Q 2 N Q 2NQ 2 N Q N = 24 , Q = 12 N=24,Q=12 N = 24 , Q = 12
编码后仍要搜索。精确点积计算约需 Q N d QNd QN d 4 N d 4Nd 4 N d
左侧矩阵由上述单位向量精确生成;右侧 576 与 36 是固定 N=24、Q=12 的编码样本数量。柱形高度不表示延迟。
交叉编码器在查询时让图像区域与文字 token 细粒度交互,通常每对都要进行这部分计算,不能把所有查询相关交互压成一个与查询无关的最终图库向量。late interaction 保存多个局部向量,在查询时对局部相似度做聚合;它处在缓存便利与细粒度交互之间。实践可先用双编码器召回,再对少量候选重排。增加交互提供表达机会,但不保证关系推理正确,还需训练与评价。
方案
能预计算什么
查询阶段主要工作
应付出的代价
单向量双编码
每张图一个向量
查询编码与向量搜索
全局压缩可能弱化局部关系
多向量 late interaction
图像局部向量
token/区域匹配与聚合
索引和查询计算增加
逐对交叉编码
可缓存部分独立特征
候选对的联合交互
候选数量直接影响成本
近似搜索省略了哪些比较,要付多少漏失
以 IVF 为例,先把图库向量分到若干簇;查询先选最接近的 nprobe 个簇,只在这些簇中精确算相似度。nprobe 小通常减少扫描项,却可能漏掉位于其他簇的真正近邻。固定一批查询,先计算 exact Top-K 作为对应,再记录 ANN 的 Top-K overlap、扫描量和延迟,才能知道省了什么、丢了什么。查询本身不能参与拟合图库索引的评价相关标签。
小图库常出现 ANN 更慢:簇选择、Python 循环和额外索引开销大于节省的点积计算。不能看到“近似”两字就写成实测加速。索引构建时间、首次模型加载、图片编码、缓存后的查询延迟也应分别计时。LAB 12 的真实 CLIP 图库把这些阶段分开保存。
在真实 CLIP 缓存上观察一次完整检索
2026-09-22 本地 CPU 推理使用 openai/clip-vit-base-patch32,固定 revision 3d74acf9a28c67741b2f4f2ea7635f0aaf6f0268,权重 SHA-256 为 a63082132ba4f97a80bea76823f544493bffa8082296d62d71581a4feff1576f,与旧包一致。预处理为 RGB、短边 224 双三次缩放、中心裁剪 224×224,再用 checkpoint 配置的 CLIP 均值/标准差归一化;文本用对应 tokenizer,输出归一化为 512 维向量。这是新推理,没有重新训练 CLIP。
图库是六张公开照片各四种关联裁剪,共 24 项,查询为 12 段真实文本。它们不是 24 个独立语义样本,不能用这次小库成绩估计大规模检索泛化。
缓存后搜索
Top-3 与 exact 重合率
语义 Hit@3
每查询扫描向量均值
12 查询整批中位延迟
exact
1.0000
1.0000
24.00
0.04558 ms
IVF,8 簇,nprobe=1
0.7778
1.0000
4.17
0.10159 ms
IVF,8 簇,nprobe=2
1.0000
1.0000
7.67
0.10836 ms
时延是本地单 BLAS 线程、20 次预热后 100 次测量的整批搜索,含 Python/NumPy 排序与索引遍历,不含模型编码、磁盘读取及建索引。小库上 ANN 扫描少却更慢,不能声称本次获得加速。nprobe=1 漏掉了一些 exact ID,但仍命中同一原照片的相关裁剪,因此语义 Hit@3 没有下降;这正好说明两种指标回答不同问题。
新推理也复核原猫图:基础三候选的猫余弦为 0.28691、候选 softmax 为 0.99577;加 tiger、fox 后余弦保持,softmax 降至 0.98195;删除 cat 后 tiger 成为最高项。这些候选内分数不是猫存在的校准概率。新旧猫图余弦最大差约 1.04 × 10 − 7 1.04\times10^{-7} 1.04 × 1 0 − 7
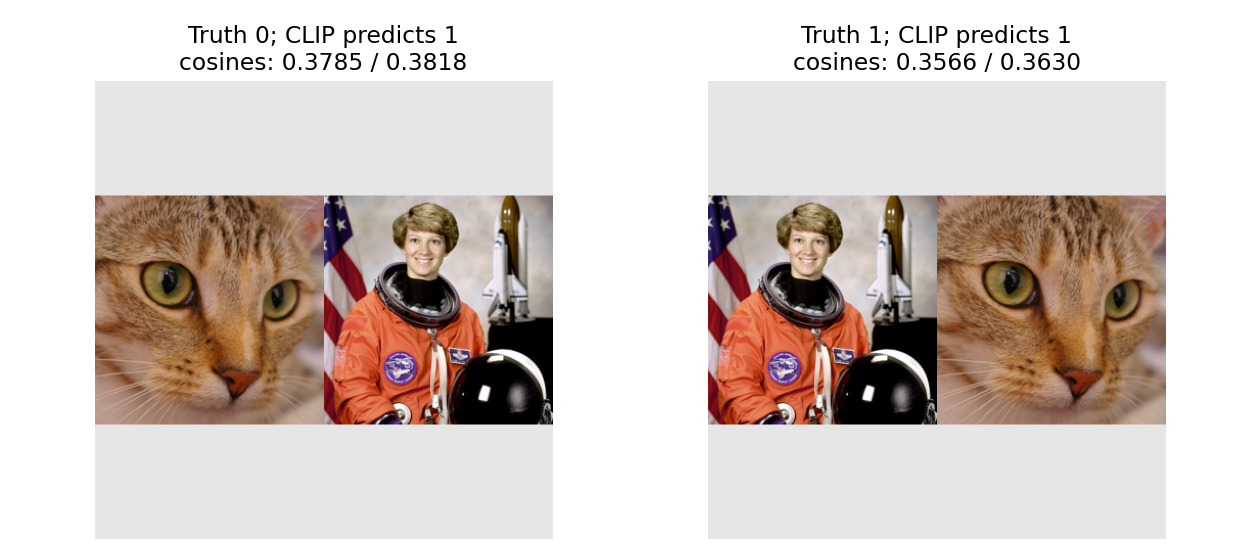
猫在左、宇航员在右时,两句关系描述余弦为 0.37850、0.38184;交换左右后为 0.35660、0.36301。两图都偏向“宇航员在左、猫在右”,所以第一张答错。另一个查询依赖的局部向量加权基线能在问猫时给猫区域较高权重,却因聚合忽略位置,交换左右后总分严格不变。多向量交互若没有保存关系结构,也不能凭“更细粒度”自动解决左右关系。
关系反例尤其重要。“红色杯子在蓝色杯子左边”与“蓝色杯子在红色杯子左边”包含几乎相同的词和对象,却要求相反对应。固定同一画布,仅交换两个对象的位置,可以让“物体都出现了”与“关系正确”产生不同预测。整图相似度若对两图都选同一句,支持的是关系区分在这个测试上失败,不代表模型从未表示位置。要更广泛判断,需要变化场景、措辞和对象,并防止模板本身成为捷径。
LAB 04 的原猫图历史推理仍保留,用于复核候选与模板变化;新增推理另有当前模型与输入身份,不能混用运行时间。下一册 CLS 12 把问题从“哪段话与整图最相似”推进为“这句话具体指哪一个区域”。
CLS 11 · 语言定位与视觉模型接口 CLS 12 · Grounding、提示与多模态接口
看见一红一蓝两只杯子后,听到“蓝杯左边的杯子”,应返回谁?句子里最显眼的颜色词是蓝,但蓝杯是参照物,目标是它左边的另一只杯子。如果规则只要看到 blue 就返回蓝杯,它完成了关键词检索,却回答错了指代问题。Grounding 把语言条件落实为区域、框或掩码,使这种错误可以用坐标核对,而不是只看回答是否流畅。
把目标、参照物与关系分别放进同一场景
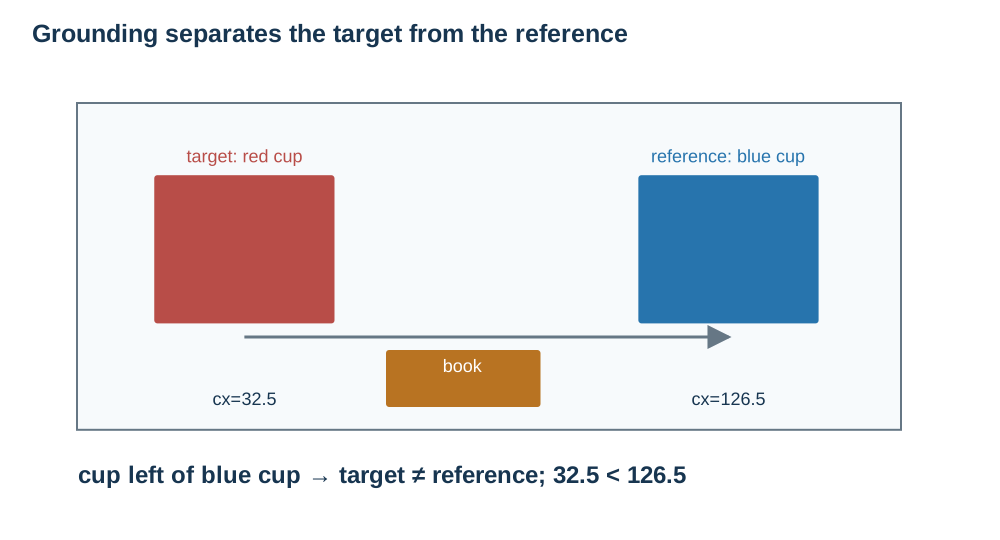
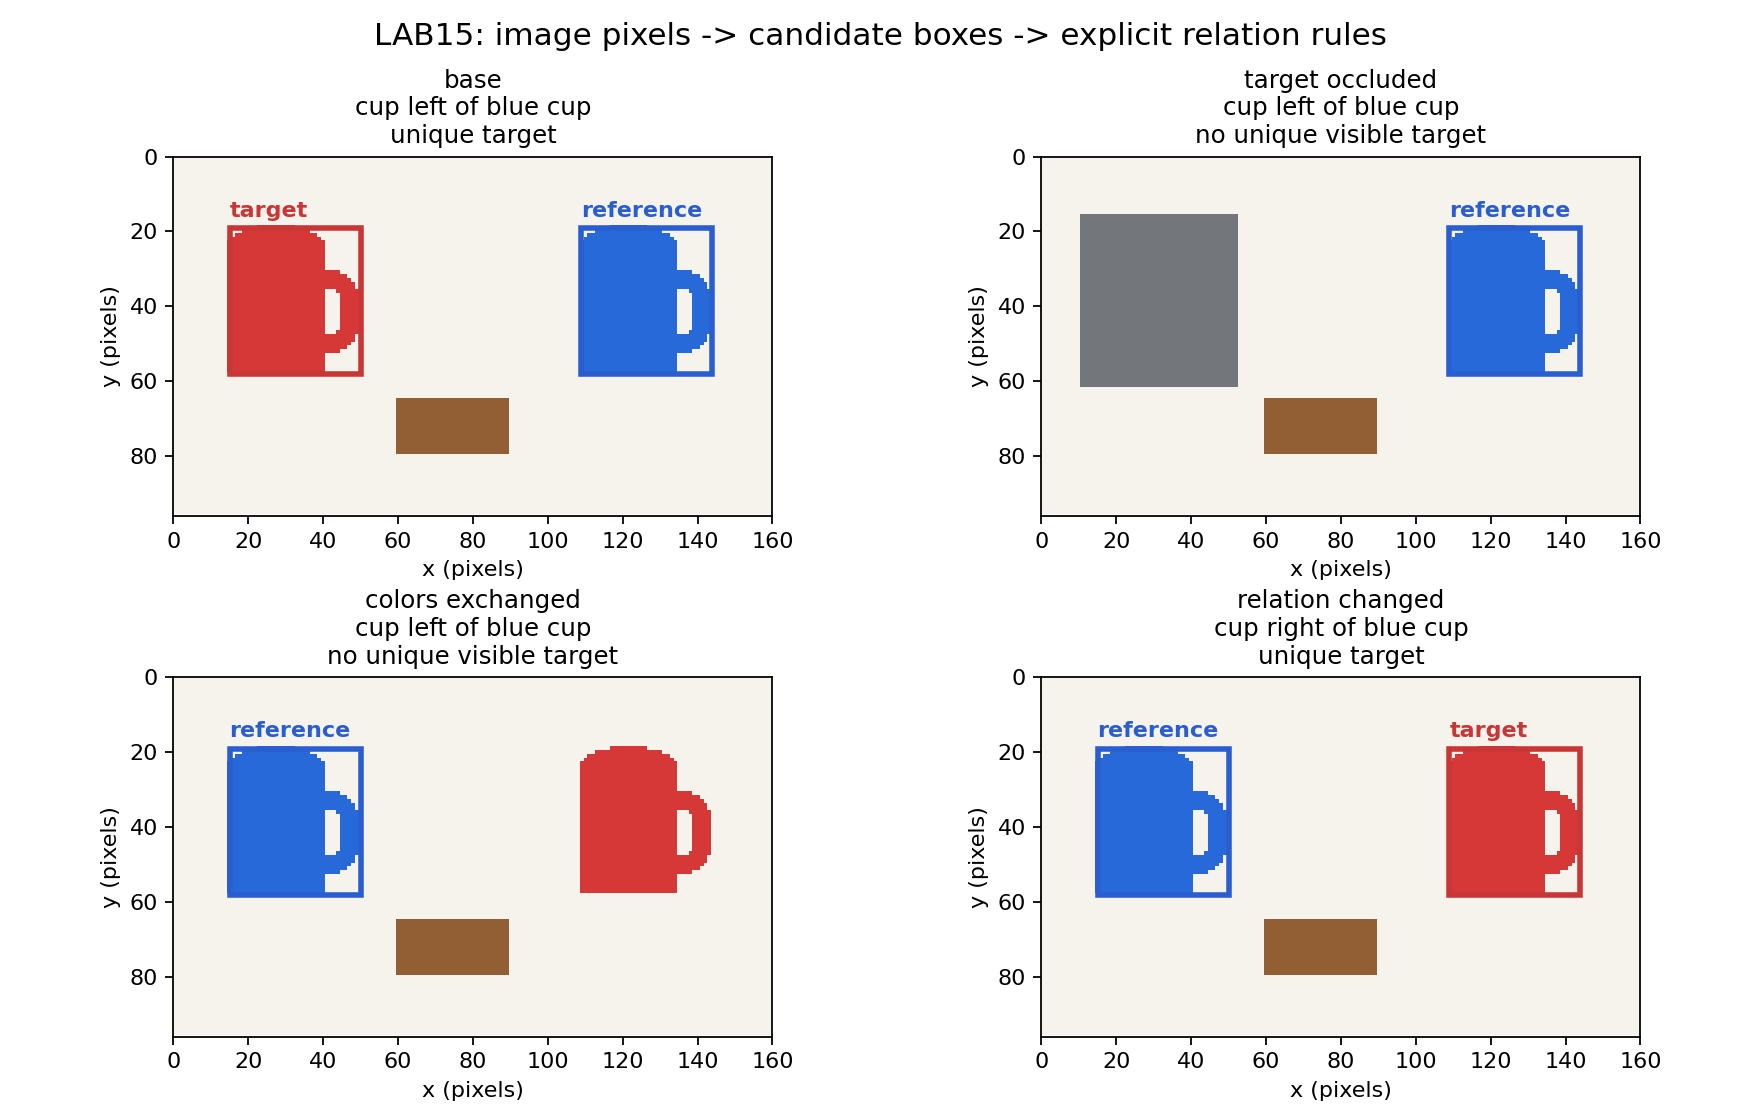
采用 LAB 15 的受控画布。左侧红杯框为 [15,19,50,58],中心横坐标 32.5;右侧蓝杯框为 [109,19,144,58],中心横坐标 126.5;书框为 [60,65,90,80]。坐标采用左上到右下的连续边界约定。
对短语 cup left of blue cup,先识别目标类别是 cup,再确定参照物是 blue cup,最后计算关系。令候选目标为 a a a r r r c x ( a ) < c x ( r ) c_x(a)<c_x(r) c x ( a ) < c x ( r ) a ≠ r a\ne r a = r 32.5 < 126.5 32.5<126.5 32.5 < 126.5
坐标和框与规则实验一致。蓝杯作为参照物先被识别,横向关系再选择红杯。图中箭头表示两者中心横坐标的比较,用来解释计算,不是模型 attention 可视化。
完整推理并不总有唯一答案:若蓝杯左侧有两只杯子,仅“左边的杯子”可能不够;若参照物不存在,则不能随便选另一个最高分对象。实验需要定义空结果、多个候选或不确定性怎样返回。中心横坐标只是本册选择的一种关系语义;“完全在左侧”可以改用 x m a x ( a ) < x m i n ( r ) x_{max}(a)<x_{min}(r) x ma x ( a ) < x min ( r )
干预不是换一张相似图,而是改变指定条件
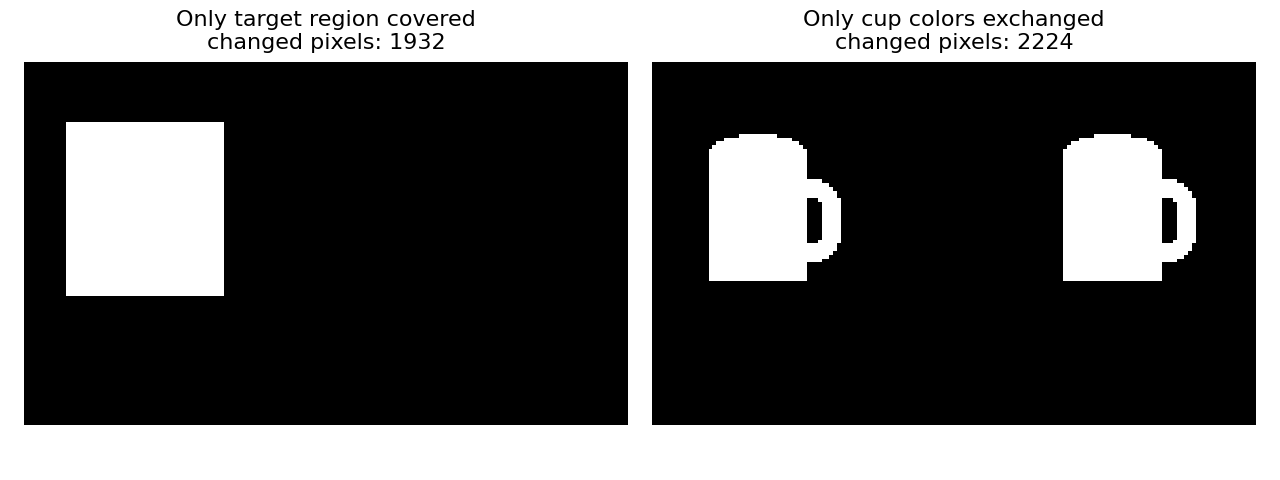
同一画布可作三个精确对照。遮住左红杯后,目标证据消失;只交换两杯颜色,蓝参照物移到左侧,它左边没有另一个杯子;在换色图上把问题改为 cup right of blue cup,目标应变为右红杯。三项分别改变可见证据、属性对应和语言关系,其余坐标保持。
如果图像分支从像素提取连通域、颜色与框,再按上述规则解析短语,它是真正接收图片的规则系统 ;它有有限词表和固定颜色阈值,不是预训练神经 grounding 模型。若直接读取生成器保存的框与类别,则是已知场景结构的 oracle 几何对照。二者都能帮助检查关系语义,但对感知的证据强度不同。
LAB 15 已在 2026-09-22 保存实际像素规则输出。原关键词规则把 cup left of blue cup 错选为右蓝杯;从图片颜色连通域提框、再作目标/参照物/关系筛选的规则返回左红杯。遮挡左目标后返回无目标;仅交换颜色后,蓝参照杯位于最左,left of 也无目标;将问题改为 right of blue cup 后返回右红杯。
像素差分图给出哪些位置确实改变,避免把独立生成的场景当作单变量干预。这条路径包含图像读取与坐标输出,但感知和短语处理仍是限定颜色/词表的规则;它修复了原关系演示,不作为 GLIP、SAM 或开放词汇 grounding 的实跑成绩。
从整图配对到 phrase–region 学习,需要新的监督位置
CLIP 给整图和整段文字一个相似度;grounding 需要短语与局部区域对应。GLIP 将目标检测与短语定位统一成语言感知的对象级学习,使类别名和描述词与区域共同参与预测。它利用检测/grounding 数据及由模型生成的区域监督扩展训练。GLIP 原论文 。这里关键变化是学习对象从 image–text 对变成带区域对应的关系,输出也明确包含位置。
把 CLIP 用在手工裁剪的候选区域上,是一种可运行的区域评分基线;它复用了真实图文编码,但候选框从外部提供,且短语中的相对关系可能依赖裁剪外的参照物。不能据此称为复现了 GLIP。相同地,论文中展示的 grounding 能力可作为方法来源,却不能当成本课程某张干预图的本轮模型输出。学生应能找到输入、模型和预测框三者对应,才有具体推理证据。
框提示怎样把“哪一个”传给分割模型
分割模型需要知道当前要分割的对象。正点可表示应属于目标的位置,负点表示不应属于目标的位置,框给出候选范围。SAM 的提示式分割将图像编码、提示编码和 mask 解码结合,使同一图像可由不同提示产生不同 mask。Segment Anything 。正点落在杯身与落在桌面提出不同请求;多义点可能对应局部部件或整个对象,返回多个候选 mask 也就有意义。
组合系统可以先用文字定位得到框,再把框交给提示式分割模型。但这个接口组合不等于后者独立理解了文字:若文字定位选中了蓝参照杯,分割模型可能非常准确地分出蓝杯,最后答案仍错。此时修 mask 边界不能修复上游的目标身份错误。反过来,框身份正确而杯把边界差,则应检查分割与图像分辨率。这就是把误差沿接口分解的价值。
LAB 16 的点/框机制例应明确输入提示如何改变输出集合。连通域或已知 mask 上的选取规则可以讲清提示身份;只有实际加载对应模型并保存结果,才证明某个提示式模型完成了推理。
视觉 token 怎样进入语言模型
视觉编码器输出一组特征,语言模型处理 token 序列,两者维数、数量和训练分布并不天然相同。LLaVA 使用视觉编码器与投影连接视觉特征和语言模型,并通过视觉指令数据训练接口;BLIP-2 用 Q-Former 从冻结视觉编码器提取可供语言模型使用的信息;Flamingo 使用视觉重采样与交叉注意力,把视觉信息接入语言生成。这些是不同的信息选择和交互方式,不是只把图像文件路径插进文本。LLaVA · BLIP-2 · Flamingo 。
压缩视觉 token 降低后续计算,但可能丢失小字、细线或小物体;提高输入分辨率与 token 数增加可用细节,也增加内存与交互成本。一个流畅地回答“红杯在左边”的模型可能使用图像,也可能依靠常见描述。判断当前接口是否保留我们关心的信息,仍要回到同图换问、同问换图、遮挡目标、交换关系等具体对照。
训练数据的来源也进入这条链。原 LLaVA 的部分指令数据由文本模型依据已有 caption、类别与框等文字信息生成,并非该数据制作步骤直接读取原图。如果描述遗漏了杯把与书的遮挡关系,后续问答目标就没有可靠依据教会这一细节。增加回答长度不会补足被遗漏的视觉监督;需要补标注、换数据或承认当前任务覆盖不到。
本册把第二条主线的区域身份接到第三条主线的语言条件。下一册 CLS 13 再改变要求:给定描述,我们不只要在已有图像中找到目标,还要产生一个符合条件的新样本。caption 已经展示条件生成;接下来要研究的是分布与采样本身。
CLS xx · 从条件多解走向生成模型 CLS 13 · 条件生成桥梁与研究实践
给定一张图片,caption 模型已经在生成文字:它按 p θ ( y t ∣ y < t , I ) p_\theta(y_t\mid y_{<t},I) p θ ( y t ∣ y < t , I )
一个条件、两个合理结果,为什么平均值可能不是合理样本
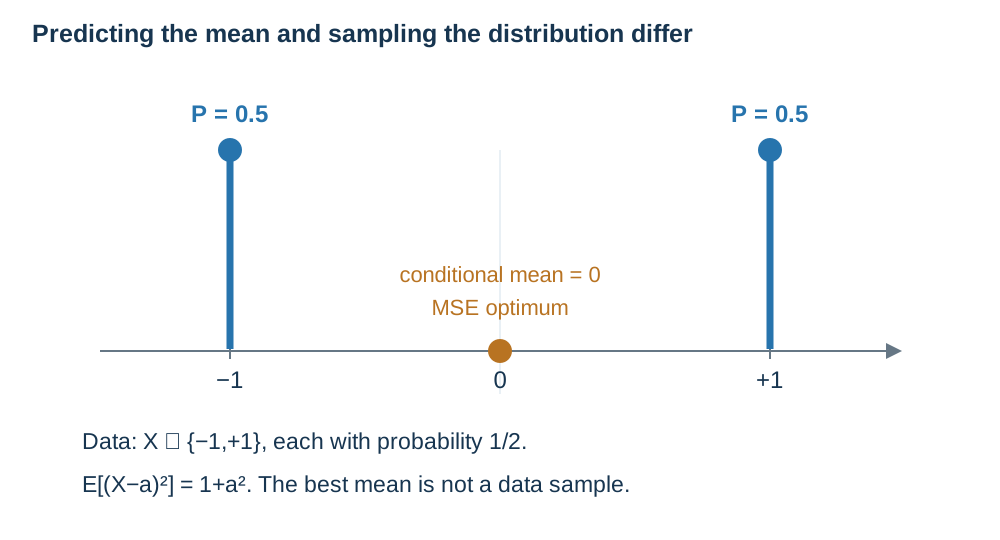
用一个最小随机变量说明多解性。给定同一条件 c c c X X X − 1 -1 − 1 + 1 +1 + 1 a a a
E [ ( X − a ) 2 ∣ c ] = 1 2 ( − 1 − a ) 2 + 1 2 ( 1 − a ) 2 = 1 + a 2 , \mathbb E[(X-a)^2\mid c]=\tfrac12(-1-a)^2+\tfrac12(1-a)^2=1+a^2, E [( X − a ) 2 ∣ c ] = 2 1 ( − 1 − a ) 2 + 2 1 ( 1 − a ) 2 = 1 + a 2 ,
最优为 a = 0 a=0 a = 0
若模型正确地随机生成 − 1 -1 − 1 + 1 +1 + 1
蓝点是等概率的两种真实结果;橙点是 MSE 最优的条件均值。图中概率质量只位于 −1 和 +1,不在 0。它是精确分布构造,不是生成模型实测。
检索、回归、补全和采样各交付什么
检索从已有图库选择 x i x_i x i p θ ( x ∣ c ) p_\theta(x\mid c) p θ ( x ∣ c ) s ( I , T ) s(I,T) s ( I , T )
对自回归文本,已训练的下一词分布可以逐步采样。greedy 取每步最大概率,不利用随机性;温度采样把 logits 除以温度后重新归一化;top-k 或 top-p 还会截断候选并再次归一化。这些策略改变实际输出分布。它们不改变训练 checkpoint,却可能影响多样性、重复和错误,因此生成报告要保存采样配置,而不是只写模型名。
三种生成目标怎样组织学习反馈
GAN 用生成器把随机变量 z z z
min G max D E x ∼ p d a t a log D ( x ) + E z ∼ p ( z ) log ( 1 − D ( G ( z ) ) ) . \min_G\max_D\ \mathbb E_{x\sim p_{data}}\log D(x)+\mathbb E_{z\sim p(z)}\log(1-D(G(z))). G min D max E x ∼ p d a t a log D ( x ) + E z ∼ p ( z ) log ( 1 − D ( G ( z ))) .
这个式子说明反馈来源是分布区分,而非为每个噪声指定唯一图片。实践还要处理训练稳定性与模式覆盖;一种看似锐利的输出集合仍可能只覆盖少数类型。GAN 原论文 。
VAE 引入潜变量生成模型 p θ ( x ∣ z ) p ( z ) p_\theta(x\mid z)p(z) p θ ( x ∣ z ) p ( z ) q ϕ ( z ∣ x ) q_\phi(z\mid x) q ϕ ( z ∣ x )
E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z ) ] − K L ( q ϕ ( z ∣ x ) ∥ p ( z ) ) . \mathbb E_{q_\phi(z\mid x)}[\log p_\theta(x\mid z)]-\mathrm{KL}(q_\phi(z\mid x)\|p(z)). E q ϕ ( z ∣ x ) [ log p θ ( x ∣ z )] − KL ( q ϕ ( z ∣ x ) ∥ p ( z )) .
第一项鼓励解释数据,第二项把编码后的分布与可采样先验联系起来。普通自编码器只把训练图映射到某些潜点,不保证从任意简单先验采样再解码得到合理图片;VAE 的概率约束针对这个缺口。Auto-Encoding Variational Bayes 。
扩散先规定逐渐破坏数据的前向过程,例如 x t = α ˉ t x 0 + 1 − α ˉ t ϵ x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\epsilon x t = α ˉ t x 0 + 1 − α ˉ t ϵ ϵ ∼ N ( 0 , I ) \epsilon\sim\mathcal N(0,I) ϵ ∼ N ( 0 , I ) t t t x t x_t x t x 0 x_0 x 0 DDPM 。
这三段给出下一讲的接口,尚不把它们排成互相淘汰的历史。数据规模、可用算力、表示与采样效率影响各自可行性;比较必须固定任务和评价。Transformer 可作为上述某些过程的预测网络,是架构选择;自回归、潜变量建模和扩散描述分布与训练/采样组织,不能把它们都叫“不同 Transformer”。
把一个研究疑问缩成真正能反驳自己的实验
以本讲已出现的疑问为例:“颜色增强能改善形状表示,又会不会破坏颜色读出?”一种可执行实验从同一组原始图像出发,先按原图划分训练/验证/测试,再训练两套相同编码器与投影头,唯一指定变化是视图生成中是否交换颜色。两边使用相同训练步数、优化器、标签预算和冻结读出;同时报告形状与颜色的保留集成绩,并保留随机初始化基线。
如果形状上升、颜色下降,支持的是这个增强与数据条件下的取舍;如果两项都下降,要检查破坏强度、优化和数据量;如果只看训练损失变小,研究问题还没有被回答。比较 h h h z z z
另一个问题是“更大输入能改善小物体边界吗?”这里至少要保留同一原始图像、相同对象尺度分组和一致评价口径。若高分辨率版本还换了更多训练样本、不同骨干和不同插值,结果不能单独归因于分辨率。可先用 LAB 11 的模型预测与真值恢复对照判断错误来自感知还是采样,再决定昂贵训练是否值得。
LAB 24 可以把自己的对象换进这条推理:先明确要排除哪一种替代解释,再选择输入、干预和输出。保存配置、代码版本、数据身份和失败样本,是让别人能重新判断证据的必要材料;它们本身不代替实验结果。一个小但闭合的系统可以给出清楚结论,一个规模很大的系统也可能因为条件混杂而无法回答原问题。
下一讲保留什么,又新增什么
本讲留下三项可以直接带走的知识:目标从数据、增强或教师怎样产生;输出从整图变成位置、像素和对象集合怎样改变损失;语言作为描述、查询和任务条件怎样进入模型。第四讲保持这些问题意识,继续研究条件分布与生成过程,并分别处理文本的离散结构、视频的时间与身份连续、3D 的几何和多视角一致性。
一张有立体感的图片不是三维表示;一组独立合理的帧也不保证视频动作连贯。输出结构再次决定约束,这与本讲“类别正确不自动给出 mask”是同一层逻辑。沿 CLS 10 的条件文本生成 走向第四讲,就能看见连续的问题变化,而无需把所有旧方法讲成通往某个单一终点的必然步骤。