Lecture 03 学习讲义
正文
工具
按问题查找
视觉与语言已知图文配对怎样变成可用的文字候选接口?

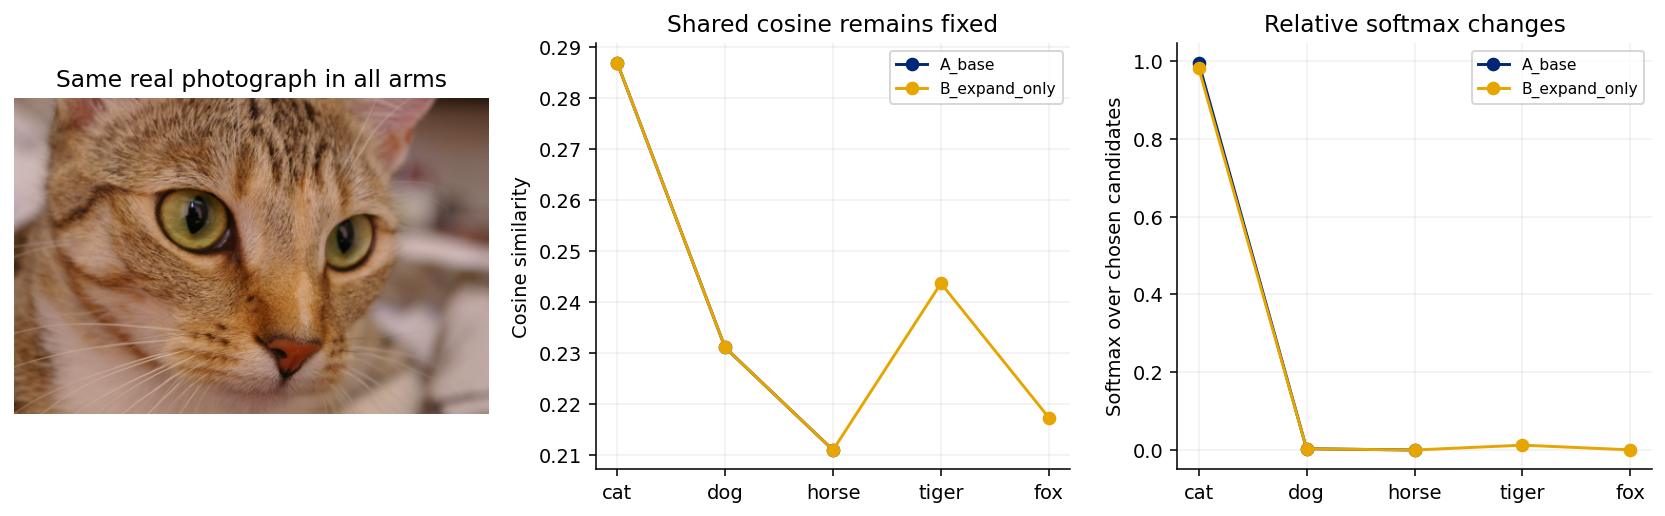
在真实猫图上核对变化的量

教学算例已经预测:共享图文的余弦可保持,而候选集合内的相对分数改变。

Chelsea 猫图的已有 CLIP 四臂候选实验结果
LAB04 已保存的真实猫图推理结果。A 为 cat/dog/horse;B 增加 tiger/fox;C 保留 A 的候选、改为 cropped 模板;D 从 B 去掉 cat。结果来自既有记录,本轮没有运行模型。

真实猫图结果:保留模型、照片与历史身份

独立阅读

当前 LAB04 保存真实 Chelsea 猫照片与 OpenAI CLIP ViT-B/32 实验。2026-09-22 的本地复核使用固定 checkpoint revision 3d74acf9a28c67741b2f4f2ea7635f0aaf6f0268,没有重新训练 CLIP;当前整理也没有重跑该推理。图片先转 RGB、缩放并中心裁剪到 224×224224\times224,再按模型配置归一化。

基础 cat/dog/horse 候选下,cat 余弦约 0.28691、候选 softmax 约 0.99577;添加 tiger 与 fox 后,共享 cat 的余弦保持不变,softmax 降至约 0.98195;再删除 cat,tiger 成为剩余候选的最高项。新旧猫图余弦最大差约 1.04×10−71.04\times10^{-7},把后来的复核与历史材料连接起来。

正面结果是模型可以在这张真实照片上把图像与合理文字对应,并且其候选接口的变化符合预期。数值 0.99577 是给定候选集合内的相对分配,不是“现实中有猫的校准概率”。一张猫图也不能替代数据集级泛化评测。

LAB04 负责模型输入、候选、模板和关系检查;LAB12 复用同一模型产生的完整 512 维向量,研究图库缓存与搜索。不要把四个候选分数拼成所谓图像表示;真正可复用的是编码器输出的向量。先在 LAB04 理解分数身份,再在 LAB12 看系统组织,就无需重复训练或建立两份同义实验。

视觉与语言检索到底复用了什么,又省去了什么?

先编码图库,再让新查询比较

解释、算例与证据

P59 · 匹配还可以变成图文检索

检索把同一个比较空间用于一组已有图片。图库向量可复用,查询只需编码一次再搜索;页面前三张结果来自已有真实缓存。工作量、相关性指标和近似索引在说明与 LAB12 中展开;检索系统的进一步组织留待第八讲。

6 张来源照片 × 4 个相关视图 = 24 项查询:“a photo of a cat.”文字编码一次与 24 个已保存图像向量比较1 chelsea-center902 chelsea-full3 chelsea-right90已有结果:精确检索的前三项都是猫图变体复用 2026-09-22 本地真实 CLIP 缓存;24 项含相关裁剪,不是 24 个独立来源。本轮未运行模型。

已有六来源照片的二十四项库,接收猫图文字查询;展示既有真实缓存的精确排序前三项。

  • 6 张来源照片 × 4 个相关视图 = 24 项
  • 查询:“a photo of a cat.”
  • 文字编码一次
  • 与 24 个已保存图像向量比较
  • 1 chelsea-center90
  • 2 chelsea-full
  • 3 chelsea-right90
  • 已有结果:精确检索的前三项都是猫图变体
  • 复用 2026-09-22 本地真实 CLIP 缓存;24 项含相关裁剪,不是 24 个独立来源。本轮未运行模型。
已有六来源照片的二十四项库,接收猫图文字查询;展示既有真实缓存的精确排序前三项。 查看对应图解状态
查看完整图解

课堂讲述

同一对编码器还可以用于检索。图片库先得到表示,新的文字查询来了,再比较相似度并返回相关图片。反过来,也可以用图片查找描述。 这里和第二部分有一个计算思想上的呼应:把可以复用的计算先完成,再让不同查询使用结果。但这只是计算组织的类比,不是说检测研究直接导致了向量检索。 分类候选和检索库也不能用同一次小演示混为一谈。检索需要一组查询和明确的相关结果来评价。今天看到任务接口即可,近似索引、重排序和完整检索工程留到后面。这样既把 CLIP 能做什么讲清,又不把第三讲变成第八讲的提前版。

检索为什么能缓存:每张图编码一次,查询再比较

独立阅读

设图库有 NN 张图,收到 QQ 条文字查询。双编码器的图像输出不依赖当前查询,所以可以先计算图库矩阵 V∈RN×dV\in\mathbb R^{N\times d},查询到来时只计算文字向量 uu,再用 VuVu 得分。这把“理解输入的深度编码”和“在现有表示中比较”分成两段。

若每个图文对都重新分别编码,需 NQNQ 次图片样本编码和 NQNQ 次文字样本编码;有缓存则是 N+QN+Q。本课程 N=24,Q=12N=24,Q=12,两者为 576 与 36 次样本编码。它是解析工作量,不是秒数;一个批次调用可以同时编码多个样本。

缓存并没有消除搜索本身。exact 查询仍要与全部 NN 向量做点积;float32 图库矩阵占 4Nd4Nd 字节。本例 24×512×4=49,15224\times512\times4=49,152 字节,不含图片、模型、ID 与索引。改变 checkpoint、预处理或图片内容需要重建对应缓存;只新增文字候选不改变旧图片向量。

P59 使用已有 24 项缓存显示猫查询的前三项:chelsea-center90、chelsea-full、chelsea-right90。24 项其实来自六张照片的四种相关裁剪,不能当成 24 张独立语义样本。它足以观察排名与缓存复用;更大的索引工程属于第八讲和 LAB12 的选读部分。

图示条件与公式约定

本页只复用前轮已存在的本地 CLIP 结果,不读取、不运行 Deepnote,不新跑模型。缓存模型 openai/clip-vit-base-patch32,查询 a photo of a cat.;已有 24 项图像库的精确排序前三项为 chelsea-center90、chelsea-full、chelsea-right90。24 项来自 6 张照片的相关裁剪,并非独立样本。协议、来源与缓存校验在已有证据包中。只展示精确小库;ANN 和缓存工程留补充。

这条线索的展开与后续阅读

视觉与语言检索到底复用了什么,又省去了什么?

让每个检索指标回答自己的问题

缓存改变计算组织;质量判断仍需明确查询、相关集合和 K。

Hit、Recall 与 exact 重合率,各自在问什么

独立阅读

固定一个查询,相关集合为 R(q)R(q),检索前 KK 个结果为 AK(q)A_K(q)。三个常见指标不是同义词:Hit@K 问是否至少命中一个相关结果;Recall@K 为 ∣AK∩R∣/∣R∣|A_K\cap R|/|R|;ANN overlap 问近似搜索是否复现精确搜索,计算 ∣AK∩EK∣/K|A_K\cap E_K|/K,其中 EKE_K 为 exact 前 K。

假设某猫查询有四个猫裁剪算相关,前三名命中两个。Hit@3 是 1,Recall@3 是 2/4=0.52/4=0.5。若 exact 的前三名是 a,b,c,ANN 找到 a,b,d,二者 overlap 是 2/32/3;d 即使仍然是猫,语义命中也可能不变。模型相关性与索引逼近的是两个不同问题。

LAB12 的历史结果正体现这个区别:exact 文搜图 Hit@3=1;IVF 只查一个簇时 exact top-3 重合率为 0.7778,语义 Hit@3 仍为 1。它漏掉部分同源裁剪,却仍保留某个相关裁剪。这不是指标互相矛盾,而是各自回答了自己的问题。

阅读结果先找查询集合、相关集合和 K,再看成绩。若一个查询只有一个正例,Hit@K 与单正例 Recall@K 恰好同值;换成多正例后必须重新写清口径。保存查询和命中 ID 比只保存平均数字更便于 AI 或同学追溯解释。

视觉与语言检索到底复用了什么,又省去了什么?

选读:省搜索与增加图文交互分别改变什么

指标已分清语义命中与 exact 复现;进一步只在关心系统成本或关系表达时阅读。

选读:省搜索和增加图文交互,是不同方向

独立阅读

这部分服务于第八讲的检索预备阅读,不是 P59 必须讲完的技术章。LAB12 的 IVF-Flat 先把图库分成 8 个簇,查询只打开 nprobe 个最近簇,再对桶内原向量精确打分。近似出现在没有打开的桶;把所有 8 个桶打开应恢复 exact 排名。

2026-09-22 保存的本地结果中,nprobe=1 平均扫描 4.17 个图像向量,exact 扫描 24 个;但整批 12 查询中位耗时为约 0.1016 ms 与 0.0456 ms。小库矩阵乘法已经很便宜,Python 路由和排序成本反而更大。扫描更少不等于实测更快。计时排除模型编码、磁盘读取和建索引。

另一个方向是让查询参与局部交互。缓存左右区域向量 rjr_j,对查询 qq 计算 uj=qTrju_j=q^Tr_j、wj=softmax(uj/.05)w_j=\mathrm{softmax}(u_j/.05),再汇总 ∑jwjuj\sum_j w_ju_j。猫查询可提高猫区域权重,宇航员查询可提高宇航员区域权重;但这个聚合对区域顺序不敏感,交换左右后总分不变。多向量并不自动保存关系。

逐对重复调用独立 CLIP 编码器仍是 f(I)Tg(T)f(I)^Tg(T),不因此变成交叉编码。联合模型把图文在内部相互条件化,通常需要更多查询相关计算。可用双编码先召回,再少量重排;要判断收益,需要固定检索库、查询和评价协议。这些机制在现有 LAB12 保留为选做,不在主讲另开一章。

沿着图解追问

以下是备课用的模拟师生对话,不是课堂实录。

学生:缓存后为什么还需要检索算法?

教师:缓存省去了重复深度编码,却还要在 N 个向量里比较和选前 K。小库精确点积可能最简单,大库才需要衡量索引省的工作与遗漏。

沿这个问题继续

先回看本页画面并指出输入、条件和输出,再按“真实猫图结果:保留模型、照片与历史身份 → 检索为什么能缓存:每张图编码一次,查询再比较 → Hit、Recall 与 exact 重合率,各自在问什么”阅读。相关实验以其已保存结果为起点,需要动手时再顺序执行 Notebook;

按问题回查的讲解与短练习(1)