队列解决候选数量,EMA 缓和特征坐标系漂移
按问题继续
InfoNCE概率与梯度、h/z、温度、队列陈旧性、实测与评价协议
队列解决候选数量,EMA 缓和特征坐标系漂移
当前 batch 较小时,每个 query 可比较的负例有限。MoCo 把近期 batch 的 key 特征保存为队列,下一批仍可使用,因而字典大小不完全受当前 batch 限制。长度 6 的队列从 [a,b,c,d,e,f] 加入 [g,h] 后成为 [c,d,e,f,g,h]。里面存的是先前编码好的向量;它不保存那些图片的完整计算图,也不在每一步重算所有旧向量。
这节省了候选编码计算,却产生一致性问题。若编码器每步剧烈变化,昨天向量的某个方向和今天向量的同一方向可能不再表达类似内容。MoCo 使用 query 编码器参数 做正常梯度更新,key 编码器则采用参数指数移动平均:
取 ,旧 ,当前 ,新 key 参数是 。若下一步 query 仍相同,新 key 为 。平均的是网络参数,不是队列向量,也不是 Adam 的梯度动量;旧 key 不会因这一步 EMA 自动刷新。 令 key 立即跟随 query, 则把 key 冻结。较慢变化让历史 key 更可比,但不能消除全部陈旧性。MoCo §3 与 Algorithm 1 给出队列、动量编码器和停止 key 分支梯度的配合。
| 组织方式 | 候选从哪里来 | 是否保留旧特征 | 主要计算取舍 |
|---|---|---|---|
| SimCLR 批内比较 | 当前 batch 的两视图 | 不需要队列 | 更多候选通常要求更大 batch 及其通信/激活 |
| MoCo 字典 | 当前正例与历史 key 队列 | 是 | 候选数与 batch 部分解耦,需控制 key 漂移 |
这是计算组织的不同答案,不是一个方法必然取代另一个。扩大队列会让最旧特征更老;增大 batch 会改变优化与负例分布;调整温度则改变同一批候选如何竞争。做消融时不能三项同时改,再把收益全部归给 EMA。
训练学会区分视图以后,还要回答哪个下游问题
冻结线性评价(linear probe)先固定编码器 ,仅训练 ;它检验标签能否用指定线性读出从表示取得。kNN 不更新编码器,用训练集表示及标签给测试点投票,结果仍依赖距离、归一化、 与支持集。微调允许 更新,检验的是初始化加适配方案。检测或分割则需要空间特征和任务头,整图线性分类成绩不能自动给出边界能力。
完整协议至少明确:原始样本的训练/验证/测试划分,预训练是否接触无标签测试图,冻结时的 eval/BatchNorm 状态,读 还是 ,标签预算,验证集选超参数的方法。两视图必须在原图划分之后生成。同一原图一张裁剪放训练、另一张放测试,会把近重复泄漏包装成泛化。
同一个颜色干预,真的改变了学到的表示
LAB 06 已在 2026-09-22 本地 CPU 完成真实两视图训练:600 张训练图、240 张保留图,RGB 16×16,卷积编码器输出 48 维 ,投影头输出 24 维 ,InfoNCE 温度 0.2,batch 60,Adam 学习率 0.002,固定种子 20260922、40 epoch。预训练不使用类别标签;标签只供冻结表示的 5NN 与线性读出使用。对照唯一指定变化是每个视图是否以 50% 概率交换红/蓝通道。
| 表示与训练 | 形状 5NN | 颜色 5NN |
|---|---|---|
| 随机编码器 | 72.50% | 100.00% |
| 保留颜色增强,训练后 | 47.50% | 100.00% |
| 随机换色增强,训练后 | 85.83% | 49.17% |
| 随机换色增强,训练后 | 95.42% | 52.92% |
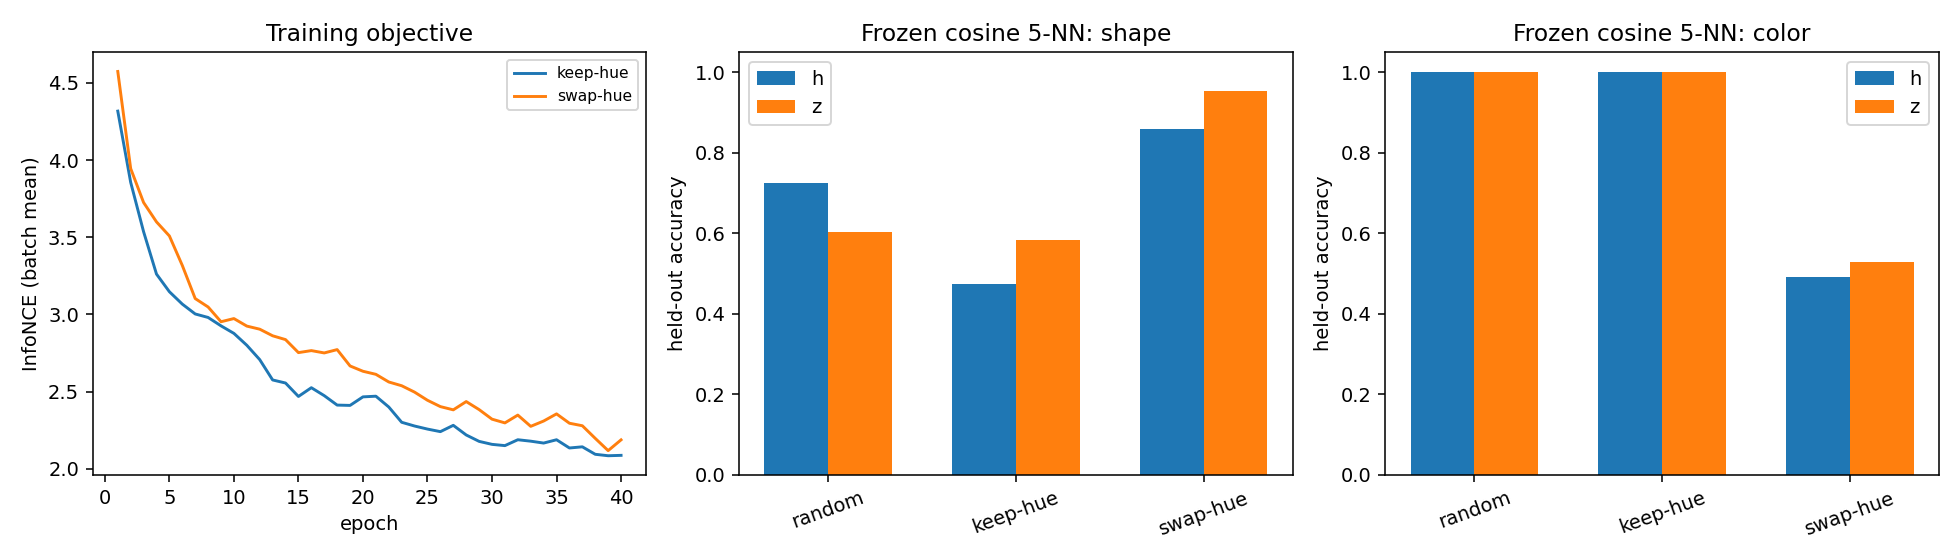
保留颜色时模型可利用容易的颜色区别,形状 5NN 甚至低于随机表示;换色使这种线索不可靠,形状读出提高、颜色读出接近二类机会水平。 也会丢失颜色, 优于 不是保证:本次 的形状 5NN 反而更高。同一换色 的线性形状读出是 98.75%,再次说明“表示质量”不能脱离读出协议。这里报告的是一个固定种子的小型受控实验,不是 SimCLR 在自然图像上的通用排名。
LAB 07 的小型 MoCo 使用同一图像来源、真实 FIFO 特征队列与 EMA key 编码器,训练 15 epoch。其 形状 5NN 为 38.33%,低于随机基线 72.50%;损失由约 4.79 变到 4.27,也没有保证目标语义变得好读。它完成了训练机制,但给出了一个失败的表示结果。MoCo 与 LAB 06 的训练轮数和组织不同,不能据这些数作方法优劣排名;可以据此检查为什么视图目标、候选和下游形状任务不一致。
LAB 07 把队列/EMA 精确算例和图像两视图训练放在同一条学习链中。阅读训练输出时,先确认参数确实由损失更新,再比较相同协议下随机初始化与训练后表示;若小数据上的自监督结果没有领先,就讨论增强、数据量和读出限制,而不改变测试口径。
从 CLS 04 的重建 到本册,目标从恢复像素变为识别视图关系;下一册 CLS 06 再问:没有显式负例时,为什么表示没有全部变成同一个常量?这些路线共同要求我们区分训练信号、实际优化以及表示的使用证据。